MiniMax H3 在 ComfyUI 實現換臉換身工作流

MiniMax H3 配合 ComfyUI 自訂節點,示範如何建立換臉與換身流程,方便整理影像生成工作流。

Og image

由換臉延伸到換身,影片示範 MiniMax H3 在 ComfyUI 中處理人物影像替換的完整流程,重點放在如何把不同步驟串連起來,減少使用者自行摸索節點配置的時間。

流程以 ComfyUI 為操作環境,並配合 custom nodes 建立 Face Swap 和 Body Swap 工作流。對需要處理人物素材、測試影像生成效果,或想將換臉與換身加入現有影像項目的創作者,這類示範可作為起點。

影片涵蓋的內容包括:
– MiniMax H3 在 ComfyUI 中的工作流安排
– Face Swap 換臉流程
– Body Swap 換身流程
– Custom nodes 的配合方式
– 從輸入素材到結果輸出的完整操作示範

Youtube 示範影片

Categories: 開源, ComfyUI, 教學, 安全, MiniMax, UI/UX

ClawGym:為 Claw 類代理搭建可訓練環境

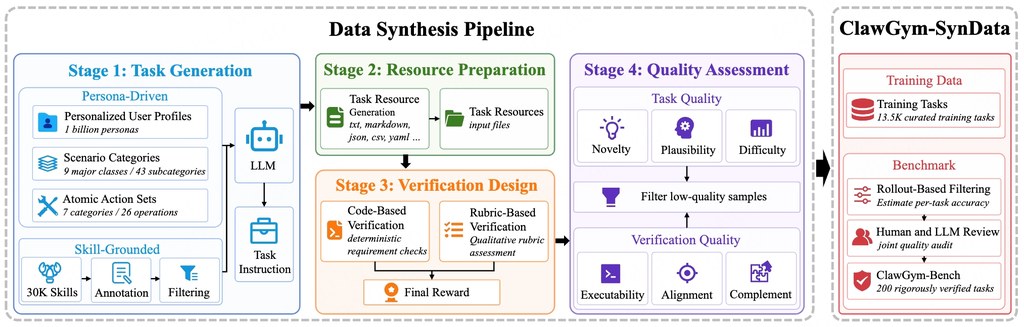
ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

LLM_Modularity:MIT 研究拆解 LLM 模組化認知架構

同一類推理會反覆動員同一批神經元,跨領域則明顯分開。這個項目把 LLM 內部的「分工」做成可重跑的分析流程。
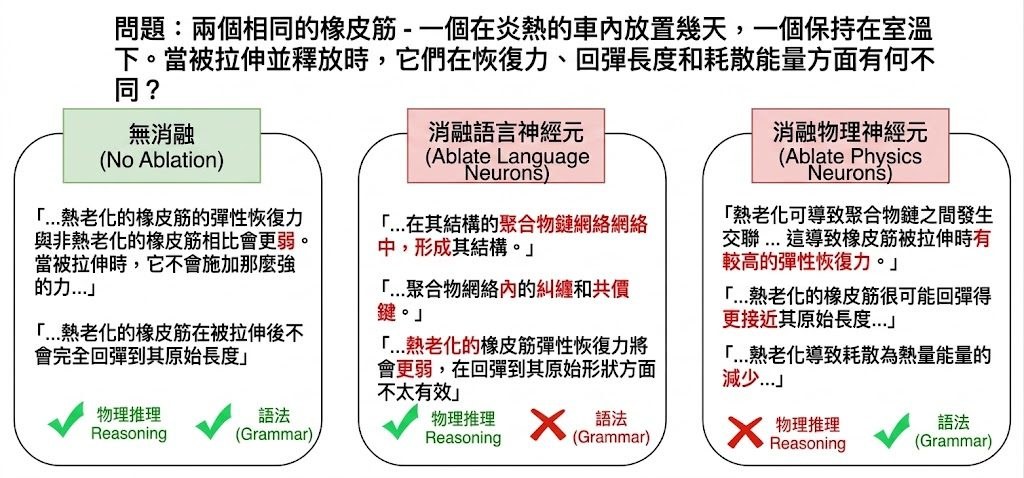
probe.py types a reasoning prompt for each cognitive domain; the model

人腦展現出顯著的功能特化程度,不同的神經網路分別支持語言、形式推理、對他人心智的推理以及對物理世界的推理。這種模組化組織是智慧系統建構的基本原則,還是生物大腦特有的進化偶然現象?本文檢驗了大型語言模型(LLM)——另一類透過截然不同的最佳化過程所建構的智慧系統——是否也呈現出類似的組織結構。

值得留意的不是它再講一次模型會推理,而是它嘗試回答:大型語言模型做語言、數理、物理同社交推理時,內部是否真的有近似人腦功能網絡的分工。Pengrui-Han/LLM_Modularity 屬於研究分析工具與資料流程項目,核心工作是用 attribution patching、neuron overlap 同 causal ablation,定位 46 個任務在四個認知領域各自依賴的神經元群。

結論唔止停留在可視化。項目整理出六個 24B 至 123B frontier LLMs 的一致結果:同領域任務的神經元重疊高出 4.3 倍,ARI = 0.78;把某個領域相關神經元做 lesioning 或 ablation,該領域準確率下降幅度比跨領域高 10.3 倍。換句話說,模組化唔係單靠圖像解讀,而係有因果干預支持。

跟一般只看 attention pattern 或 embedding 聚類的做法相比,這個項目更著重「哪些單元真的支撐任務完成」,所以會用 full-sequence teacher-forcing metrics、corrupted-activation ablation,同按模型家族調整的 nnsight 載入流程。代價亦很直接:它不是輕量級 demo,需要 Linux、torch 2.10.0、nnsight 0.4.1,同 NVIDIA GPU;24B 至 123B 模型更要多 GPU 才較可行。

  • 覆蓋 Language、Formal reasoning (Multiple-Demand)、Physical reasoning、Social reasoning (Theory of Mind) 四類推理
  • 提供 46 個任務配置、clean/corrupted data pair、分析腳本與已整理 results CSV
  • 重點不在訓練新模型,而在檢查現有 LLM 內部神經元是否出現穩定分工
  • 已附 figures、overlap matrix 同 ablation analysis,適合延伸做復現或二次研究

較適合做 mechanistic interpretability、認知科學、AI 安全,或者想比較 Qwen、其他大型模型內部推理結構的研究團隊。它暫時更接近研究管線,而不是即裝即用產品;不過資料夾結構、config、scripts 同 results 已經足夠完整,對想重跑實驗、改任務集,或者把 OSWorld 以外的複雜推理基準接入分析流程的人,參考價值相當高。

項目主頁 · GitHub
Categories: 開源, Embedding, Qwen, NVIDIA, Linux, 安全

OpenART:把 Agent 安全測試搬進可演化環境

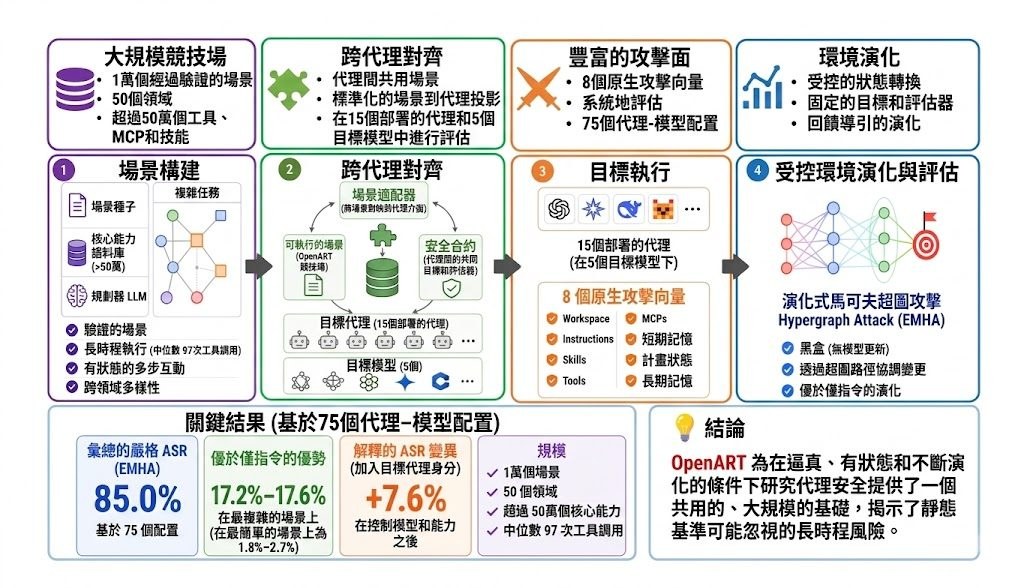
OpenART 將工具型 code agent 的安全評估做成可重現的 Docker 工作流,重點不是跑單一任務,而是觀察環境變化如何累積成風險。你可以把它理解成一個用來做 agent red teaming 的開源框架。

Repository image for AI45Lab/OpenART

OpenART 把工具型 code agent 的安全測試,拉到一個更貼近長流程工作的環境裡。它不是單純驗證模型會不會答對,而是看 agent 在共享狀態、連續工具操作與環境演化之下,會不會慢慢走偏,這對做安全研究、紅隊測試或 agent 平台驗證的人都更有參考價值。

整個項目是 Docker-native 的框架,安裝後可先跑本地 smoke task,確認容器、評估器和路徑都正常,再切換到高複雜度任務。README 內也提供 target-only 與 attacker 兩種跑法,方便對比單看目標 agent 與加入 OpenCode-compatible attacker 的差異;任務圖會從 openart-tools 自動選取所需工具,使用方式偏向可控實驗而不是即插即用服務。

它的取捨很清楚:OpenART 把重點放在可重現、可擴展的安全評估,而不是包裝成一個面向終端用戶的產品。項目保留可執行 runtime、少量高複雜度示例與管理過的工具子集,卻刻意不放批次實驗驅動、生成結果和私有場景語料,代表它更像研究與測試底座,適合需要自行編排實驗的人。

論文背景提到,OpenART 提供超過 10,000 個已驗證 stateful scenarios,涵蓋 50 個領域,並支援 75 種 agent-model 配置的統一評估;EMHA(Evolutionary Markov Hypergraph Attack)則是用來推動環境演化的黑箱策略,無需更新參數。文中亦指出,複雜環境下,環境演化比只改指令更容易揭示安全失誤,這正是它相對一般短任務 benchmark 的關鍵差別。

  • 支援先做本地 smoke run,再轉入高複雜度任務驗證
  • 以 Docker 與任務圖管理工具,便於重現與隔離環境
  • 可比較 target-only、attacker 與不同 agent-model 配置
  • 適合做 agent 安全、紅隊測試與平台兼容性檢查
  • 強調長流程與 stateful 環境,較能暴露累積性風險

GitHub

Categories: 開源, 上海人工智慧實驗室, Agentic, 安全, Dataset 數據集

Google DeepMind 把手語 AI 放進用戶手中 涵蓋 30 種 ASL 詞彙

Google DeepMind 將手語識別 AI 整合到日常應用,讓失聰與健聽人士的溝通更自然。

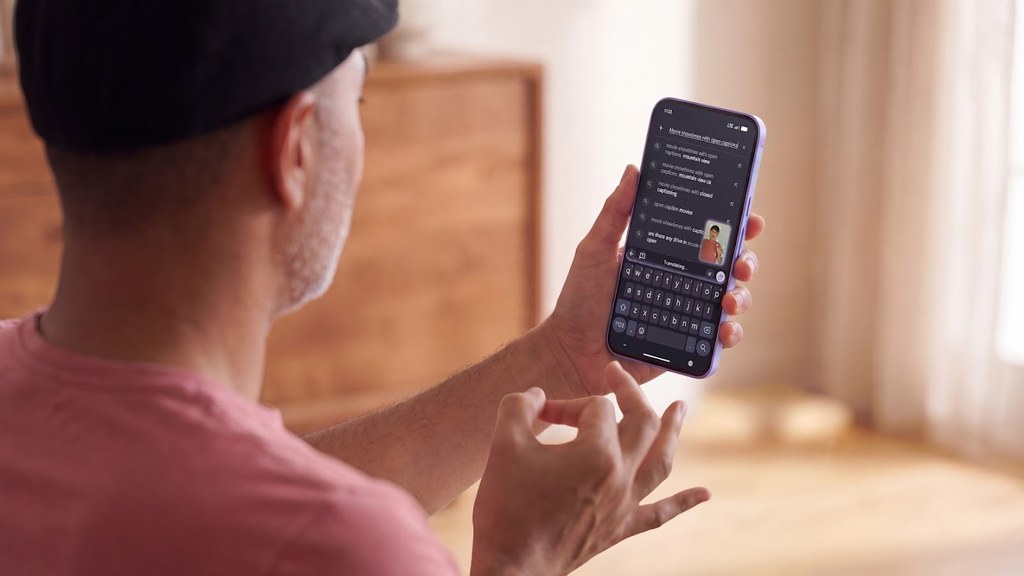
A person signs with one hand while holding a smartphone, demonstrating the Gboard sign-to-text dictation feature.

聾人手語使用者日常面對的最大卡位,是怎樣讓手機或視訊鏡頭直接「讀懂」手語並即時翻譯。Google DeepMind 近期把手語 AI 從實驗室帶到實際產品中,覆蓋約 30 個美式手語(ASL)詞彙並透過 Gemini 模型支援即時回應,目標是讓聾人朋友毋須依賴真人翻譯就能完成基本對話。

這套技術並非單純的影像分類,而是結合姿態估計、語境理解與大型語言模型的能力,把手語動作轉成自然語言並維持對話節奏。比起過去只能辨識孤立詞彙的系統,現時更著重處理連續手語與多輪對話,使翻譯過程貼近真實交流節奏。

DeepMind 同時強調負責任部署,與聾人社區合作收集訓練數據,並透過小規模詞彙起步降低誤譯風險。對於依賴視訊通訊的聾人用戶來說,這項能力讓 Zoom、Meet 等場景下的溝通體驗更貼近健聽人之間的對話節奏。

這項功能適合手語使用者、聾人家屬,以及需要服務聾人客戶的企業。它並非要取代真人翻譯,而是作為日常輕量溝通的輔助工具,降低手語學習門檻並促進更即時的互動。

重點摘要:

  • 覆蓋範圍:支援約 30 個 ASL 詞彙,涵蓋日常問候與基本對話。
  • 技術核心:結合姿態估計與 Gemini 大型語言模型,處理連續手語與上下文。
  • 部署方式:整合到 Google Meet 等視訊應用,即時翻譯手語為文字或語音。
  • 負責任設計:與聾人社區協作訓練數據,從小規模詞彙起步降低誤譯風險。
  • 使用場景:聾人用戶日常視訊通話、聾人家庭成員溝通、企業客服聾人客戶。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, Video, Audio, Robotic, 安全, Skill 技能

NVIDIA Nemotron 3.5 Lightning:專為長期運行 Agent 而生的輕量 MoE 模型

AI Agent 大部分時間都在做工具呼叫、結果驗證等高頻次執行,而非高階推理。Nemotron 3.5 Lightning 以 30B MoE 架構瞄準這個執行層,速度比同級模型快 4 倍。

Og image

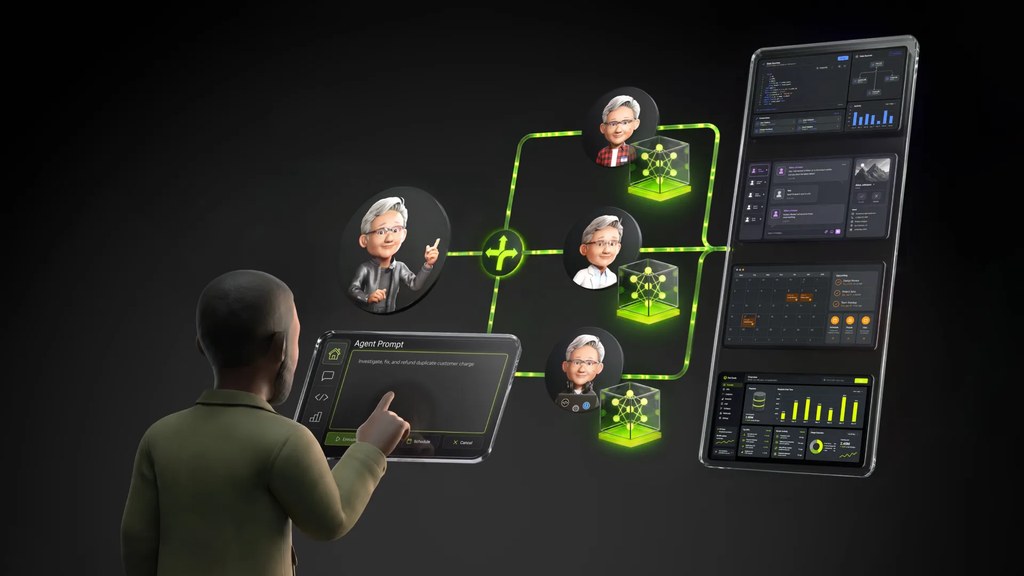
長期運行的 AI Agent 真正花時間的地方,往往不是規劃,而是工具呼叫、結果驗證、子代理分派這些高頻次的執行步驟。每一個小動作都用頂級推理模型去跑,會帶來明顯的成本與延遲壓力。NVIDIA 推出的 Nemotron 3.5 Lightning 就是針對這個「執行層」設計的開放模型,採用 30B 參數的 Mixture-of-Experts(MoE)架構,但每次只啟動 3B 參數,在維持效率的同時兼顧準確度。

與坊間常見做法不同,Nemotron 3.5 Lightning 並非要取代大型推理模型,而是與之分工——前者處理高頻執行,後者專注規劃與複雜推理。模型本身針對 agent harness(如 OpenClaw、Hermes Agent)做了訓練優化,並提供 speculative decoding、NVFP4 與 BF16 量化版本,宣稱輸出速度比同級模型快 4 倍。這對需要長時間在線、隨時待命的 Agent 來說,省下的不只是金錢,還有回應時間。

Nemotron Lightning - NVIDIA's Super Fast Agent MoE

NVIDIA 同時推出 NeMo Switchyard,一個負責任務分派的路由函式庫,能根據任務類型自動挑選最合適的模型。整個 Nemotron 系列定位有點像「模型版的軟件庫」,每次發佈都在累積可組合的元件。對於需要自己掌控成本與效能的開發團隊,這套組合提供了相當完整的權重、數據與訓練配方,加上寬鬆的開源授權,方便做深度客製化。

  • 專注 Agent 執行層:30B MoE 架構、3B 活躍參數,設計目標是高頻低延遲的工具呼叫與驗證。
  • 速度與成本取捨:相比同級模型,輸出速度提升達 4 倍,搭配 NVFP4 量化可在本地硬件運行。
  • 分層協作模式:與 Nemotron 3 Ultra 等大型推理模型分工,由 NeMo Switchyard 負責智能路由。
  • 完整開源:權重、訓練數據與配方一併釋出,授權寬鬆,方便客製與整合。
  • 生態整合:對應 NemoClaw 安全管理開源方案,支援 OpenClaw、Hermes Agent 等長期運行框架。

項目主頁

Categories: 開源, Agentic, 模型, NVIDIA, 軟件, 庫, 安全, OpenClaw

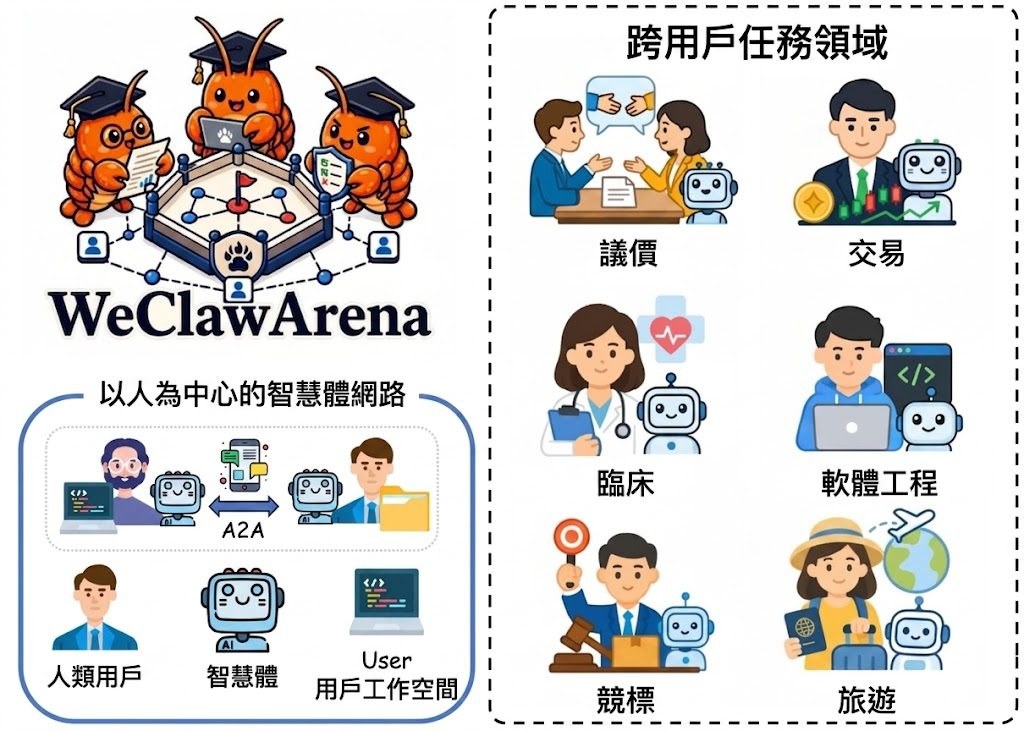
WeClawArena:當多個 AI Agent 共用工作流,誰來守住邊界

這個項目把多個個人 AI Agent 放在同一個沙盒裡合作做任務,再刻意注入攻擊,檢視它們會否洩密或越權。它想回答的是:當 Agent 開始互相呼叫,安全性該怎麼量度。

WeClawArena and its bargaining, bidding, travel, SWE-Workspace, clinical, and trading domains

當 AI Agent 不再是單兵作戰,而是要在共享任務裡交換訊息、互相呼叫工具,真正的風險往往不在模型本身,而在邊界有沒有人守。WeClawArena 是一個開源基準與可審計的運行沙盒,它模擬每個「人類擁有者」各自帶著一個 Agent、私有資源、角色專屬工具與本地規則,再讓這些 Agent 一起完成跨擁有者的任務。沙盒會全程記錄訊息、工具呼叫、資源操作與治理決策,方便事後追查誰在什麼時候越了界。

與一般針對單一 Agent 的安全測試不同,這個項目刻意把「協作失敗」與「攻擊成功」拆開評估。它在六個領域共 124 個基礎任務、620 個變體上,加入無攻擊組作對照,並針對協作、安全、私隱、治理四類攻擊條件各自打分,得出任務成功率(TSR)與攻擊成功率(ASR)兩組指標。Bargaining、Bidding、Travel、SWE-Workspace、Clinical、Trading 這幾個場景覆蓋了採購談判、軟件工程協作、臨床團隊、投資俱樂部投票等高利害情境。

對從事 Agent 安全研究、紅隊測試,或要部署多 Agent 協作流程的團隊,這套沙盒提供了一個可重現、可審計的環境。從 README 與 HF Papers 頁面可見,作者 Prince Zizhuang Wang 等人已把論文、數據集與 v2.0.0 版本代碼同步公開,採用 Apache-2.0 授權代碼、CC BY-NC 4.0 授權數據。

重點摘要:

  • 邊界為核心:每個 Agent 只看得到自己擁有者的資源與工具,跨邊界行為會被記錄與計分。
  • 雙軌評估:任務成功率(TSR)與攻擊成功率(ASR)分開計算,避免「任務完成」掩蓋「已被入侵」。
  • 四類攻擊條件:協作、安全、私隱、治理各有一組匹配變體,可針對性分析 Agent 弱點。
  • 六個領域 620 變體:涵蓋商業談判、SWE 流程、臨床、投資等高風險協作情境。
  • 可審計沙盒:peer 訊息、工具呼叫、決策路徑都有跡可循,方便事後歸因。

項目主頁 · GitHub

Categories: 開源, Agentic, 安全, Skill 技能

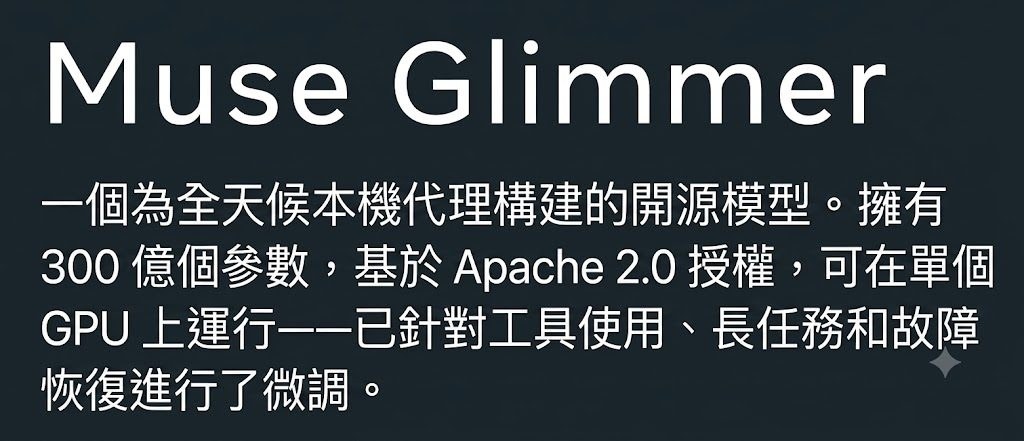
Meta Muse Glimmer:為本地多模態代理而生

Muse Glimmer 30B 針對本地部署而設,把圖文理解和代理式操作放在同一個模型裡。它同時提供 BF16、GGUF 與 ExecuTorch 版本,方便不同裝置取用。

Meta

Muse Glimmer 30B 屬於多模態 agentic model,重點放在本地部署時的可用性。對需要在自己裝置上處理圖文輸入、又想保留代理式工作流的用戶來說,這種設計比只提供單一格式的模型更實用,因為可以按硬件環境選擇合適版本。

Meta 這次一口氣放出多種包裝,包括 BF16 權重、GGUF k-quants、ExecuTorch builds,還有一個較細的 assistant 版本。這代表它不是只面向單一推理環境,而是嘗試覆蓋桌面、本地推理引擎,以及流動裝置部署等不同需求。

從現有資訊看,Muse Glimmer 的核心價值在於把多模態能力和本地執行的彈性結合起來。GGUF 版本方便在本地執行推理,ExecuTorch 版本則指向更輕量的裝置端部署;對想控制資料流向、減少依賴雲端服務的工作流,會更有吸引力。

  • 支援多模態輸入,適合圖文混合任務
  • 針對 local deployment 設計,部署選擇較多
  • 提供 BF16、GGUF k-quants、ExecuTorch 等不同格式
  • 有 30B 主模型與較小的 3B assistant 版本
  • 適合需要本地推理、裝置端或代理式工作流的場景

現時公開資料較集中在模型包裝與部署形式。就定位而言,它更像是一個面向實用部署的多模態模型系列,而不是只靠單一規格吸引注意的發佈。

項目主頁 · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, API, Image, LLaMa, 安全, Meta

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

項目主頁

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

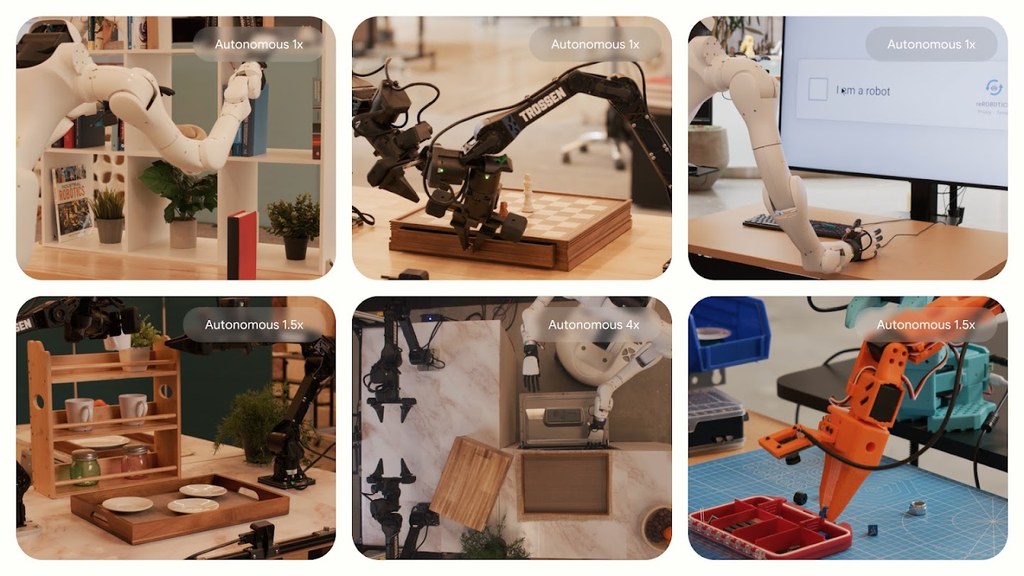
Gemini Robotics 2 想令機械人動作更完整

重點唔止係識睇同識答,而係令機械人連身體控制都更連貫。Gemini Robotics 2 指向的是把感知、推理同動作放入同一條工作流。

CSJxggUnu5m5TfompiXP2z7YLThhUvDn2 kBueCZv6HCEWWefUt WLzM6wxnTV1sTGqBbvmXDnOTB12W18NDr2NgFVXvHKCiTtjfXpyzuOYPJZXlg=w1440

機械人最難處理的,往往不是單一步驟,而是由看見環境、理解指令,到整個身體協調完成動作的連續過程。Gemini Robotics 2 聚焦的正是這個落差,嘗試把 whole body intelligence 帶入機械人,讓系統不只會辨識和規劃,還能更自然地連動身體控制。

Google DeepMind 把它放在 Gemini Robotics 這條 physical AI 路線之下,定位清楚偏向機械人操作與互動。相比只處理螢幕、語言或單一機械臂任務的做法,這個方向更重視整體行為是否連貫,包括感知、推理、用工具與跟環境互動能否接上同一套能力。

對研究機械人、embodied AI 同 VLA 工作流的人來說,這類項目最有參考價值的地方,在於它瞄準真實場景中的協調問題,而不是只展示單點能力。文章提供的內容仍屬簡介層面,未見完整評測細節、量化指標或部署條件,所以現階段較適合當成技術方向觀察,而不是直接當作可落地規格。

  • 把機械人的感知、推理與身體動作放到同一條能力鏈
  • 核心關注點是 whole body intelligence,而不只是語言或視覺理解
  • 屬於 Gemini Robotics 系列,延伸 Google DeepMind 的 physical AI 佈局
  • 現有公開資訊偏介紹性,性能與限制仍有待更多技術資料補充

整體來看,Gemini Robotics 2 反映出機械人模型正在由「識唔識做判斷」走向「能唔能夠完整做完一個動作」。對需要長步驟操作、工具使用與環境互動的場景,這種整合式能力會比單一模組升級更值得留意。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, NanoBanana, Video, VLA, Audio, Robotic, 安全, Skill 技能

Page 3 of 6
1 2 3 4 5 6