Cloudflare Clef 多模態決策模型:直接輸出分類、路由與審核概率

Clef 將文字、JSON、影像或影片轉成結構化概率,毋須生成答案再解析。

Og image

面對發票分類、服務故障分流或影像核查等工作,Clef 可以直接為每條問題的可選答案計算概率,省去生成自由文本及再解析輸出的步驟。這個 27B 多模態決策模型基於 Qwen/Qwen3.8-27B 微調而成,能同時處理文字、JSON、影像及影片,並以單次 forward pass 回傳結果。

模型保留 Qwen/Qwen3.8-27B 的語言及視覺 backbone,再接上 joint schema head。這個小型 Transformer head 會讀取 backbone 的最終 hidden states,把狀態中的證據路由到每條問題,然後聯合計算所有選項的 logits;每條問題獨立套用 softmax 後,便可取得各選項概率。輸出不是自然語言,而是 choice、score 或 noul(true/false)等結構化結果,適合交由工作流程或 API 直接使用。

  • state 可接受字串或 JSON,問題支援 choice、有序的 score 及 noul。
  • images 和 videos 可與文字資料混合,文字及多模態記錄亦可放在同一批次處理。
  • encode_record 預設 max_length 為 16,384 tokens,亦可透過 max_state_tokens 限制狀態長度。
  • 模型檔案包括分片 safetensors、joint_head.safetensors、處理器設定及 joint_schema_model.py。

官方測試環境是單張 H200,配合 torch 2.11、transformers 5.10.2 及 pillow。

Clef 的取捨在於輸出控制性高,但用途受制於預先定義的問題、選項及 criteria,並非通用聊天模型。它與原始 Qwen/Qwen3.8-27B 的差異,是加入 joint schema head、記錄編碼及 SystemOne 介面,將生成式模型改造成可批量回答固定決策問題的模型;較小、較快的 Clef-Flash 則另行提供,頁面沒有交代兩者的參數規模或精度差異。Apache-2.0 授權及 Jev/SystemOne 相容 API,令它較適合整合到分類、路由、合規檢查及多模態審核流程。
模型

Categories: 模型, 多模態模型, Qwen, Tokenize

SoL-Refiner 高解像度影片生成加速 27 倍

先完成低解像度草稿,再用一次去噪提升至高解像度,SoL-Refiner 大幅縮短影片生成時間。

Og image

高解像度影片生成往往受限於大量時空 tokens,SoL-Refiner 以影片精修模型處理這個瓶頸:先由不同基礎生成器製作較低解像度草稿,再用一次目標解像度去噪輸出最高 4K 影片,毋須進行多步精修。

NVIDIA Research 的訓練流程結合高解像度持續訓練、frame-based RL post-training,以及 one-step distribution-matching distillation,並支援 bidirectional 和 streaming inference。方案可接駁 MiniMax H3、SANA-Video、Cosmos-Nano 和 WAN 等不同生成器,令精修模組毋須綁定單一模型。

  • 一次高解像度去噪,減少第二階段採樣成本
  • 支援多個影片生成器,改善跨模型工作流程
  • 在 2K 保持具競爭力,4K 指標優於 LTX-2.3
  • WAN 和 Cosmos-Nano 測試中,平均質素亦有所提升

以五秒、1344×768、24 fps 影片測試,MiniMax H3 直接生成高解像度版本需 152.3 秒;低解像度生成加 SoL-Refiner 的兩階段流程只需 5.6354 秒,量得 27.03 倍牆鐘速度提升。測試使用 NVIDIA GB200,每個階段各佔用一張 GPU,實際速度仍會受硬件、基礎生成器和影片設定影響。

SoL-Refiner 適合需要大量高解像度影片、但又要控制推理延遲的內容製作流程。它以額外的低解像度生成階段換取更快的高解像度輸出,質素和速度之間的取捨仍取決於輸入草稿及所選生成器。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, 教學, Python, LTX, MiniMax

MiniMax H3 的雙用途 X2 Detail VAE 實驗

一個 VAE 同時處理影片 2 倍解碼與參考圖細節增強,但仍依賴指定 ComfyUI 節點。

Og image

由 MiniMaxAI/MiniMax-H3 作為 base model,呢個實驗型 video VAE 將兩條工作流程放入同一個模型:一條負責生成影片 latent 的 2 倍解碼,另一條則提升 image-reference 的空間細節,適合 ComfyUI 影片生成項目使用。

影片模式會以 MiniMax-H3-X2-Detail-v1.safetensors 解碼,再將 packed 12-channel 輸出交給 PixelShuffle ×2,產生 2 倍 RGB 影片幀。參考圖模式則透過 MiniMax H3 VAE 2X (Detailed Upscale) 節點,從 encoder 的 down.1.block.1 抽取額外 B32 空間細節;因此必須有現成 RGB 參考圖,並非只處理 latent。

檔案附有 ComfyUI 節點、workflow 及研究報告。影片解碼需要 ComfyUI-MiniMaxH3_LatentUpscaler 的 MiniMax H3 VAE Decode (fast),示範設定包括 tiling=true、tile_size=256、tile_overlap=64、output_device=cpu,以及 temporal_tiling=false;節點依賴令流程不能直接用標準 VAE Decode 取代。

  • 模型檔案:MiniMax-H3-X2-Detail-v1.safetensors
  • 定位:2X VAE Decode 加參考圖 Detail Enhancement
  • 已知取捨:B32 細節路徑只適用於 RGB 參考圖
  • 頁面未提供參數規模、上下文長度、GGUF、量化版本或 mmproj 檔案

項目作者將成果描述為一次未達預期的 HQ-VAE 實驗,但保留了可工作的 2-in-1 發布版本。適合作為實驗性 ComfyUI 工具,而非已完成全面效能驗證的通用 VAE。

模型

Categories: 開源, ComfyUI, AI productions, 模型, Video, MiniMax

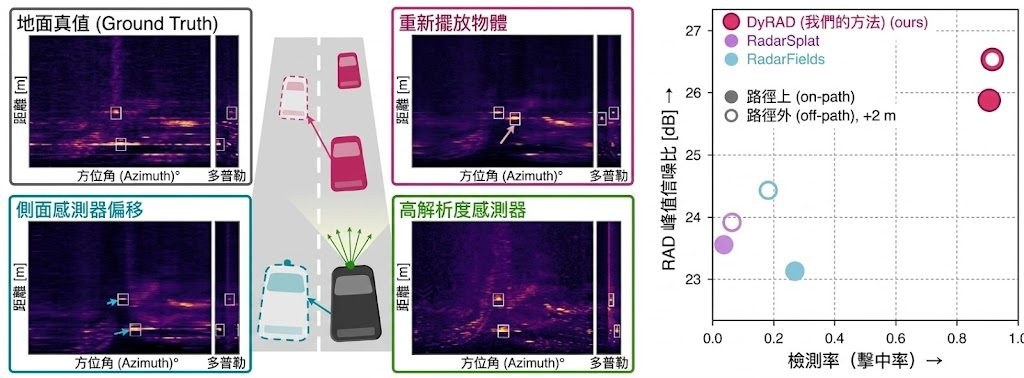
DyRAD 讓雷達透過多視覺重建動態駕駛場景

DyRAD 把錄製雷達資料轉成可重新渲染的動態場景,連感測器位置、物件動作和規格變更都能納入測試。

DyRAD re-simulation: from a measured radar frame, DyRAD renders a laterally shifted sensor, a repositioned object and a

由已錄製的雷達、感測器姿態和物件框,DyRAD 可以生成原本沒有記錄過的新視點,甚至模擬車輛橫向移動、物件重新定位或更高解析度的感測器。這個項目屬於開源雷達新視點合成模型,處理的是自動駕駛系統缺乏非原路線觀測資料的問題。

它把靜態背景反射點與跟隨剛體物件軌跡移動的動態反射點分開建模,並用 range–azimuth–Doppler (RAD) 中的 Doppler 速度約束物件追蹤。反射點不會直接吸收雷達訊號擴散,而是經由 point-spread function (PSF) 渲染;PSF 取自 Hamming-FFT 的距離及 Doppler 處理,以及 RADIal 的 beamformer response,令場景幾何與感測器特性分離。

這個取捨令同一個重建場景可以轉移到不同雷達規格,毋須重新擬合,亦較適合閉環測試和感測器配置研究;代價是需要姿態、物件框和雷達校準等資料,Boreas 更只支援 range–azimuth,未能完整利用 Doppler。項目支援 RADIal、Boreas 及具備偏移視點真值的 synthetic benchmark,可按 README 提供的設定訓練、載入 checkpoint,再以 held-out metrics 和重新擬合流程檢查結果。

• 支援完整 RAD tensor,而非只重建距離及方位
• Doppler 同時作為輸出和動態軌跡監督訊號
• 可測試 lateral sensor shift、物件編輯及高解析度感測器
• Project page 指出其 RAD PSNR 和 detection hit rate 高於 RadarSplat、RadarFields
• 適合自動駕駛、雷達感知及模擬資料團隊研究非原路線測試

對需要驗證感知模型在新路線、新感測器或場景變更下表現的團隊,DyRAD 提供比單純錄播更有彈性的資料生成方式。不過結果仍受初始標註、物件軌跡品質、雷達校準和合成視點真值限制,未能取代真實道路測試。

項目主頁 · GitHub

Categories: 開源, 模型訓練, NVIDIA, Dataset 數據集

JEV 以結構化決策加速大規模 AI 資料處理

面對海量合約、日誌或文字資料,JEV 以結構化輸出換取更快速度與較穩定的程式整合。

處理數萬份合約、系統日誌或其他非結構化資料時,逐字生成文字容易帶來延遲、格式錯誤和難以判斷的信心。JEV 是由 TypeSafe AI 開發的 System One Model(系統一模型),透過 API 直接輸出預先定義的結構化決策,針對大規模資料分類與資料抽取而設計。

JEV 不以自由文字作為主要輸出,而是採用 Parallel Sampling(平行採樣)一次產出多項結果,端到端反應時間約為 70 至 500 毫秒。Type-safe 結構可限制欄位、數值範圍和可選項目,減少傳統 Large Language Model (LLM) 常見的解析、重試及幻覺風險;輸出亦會附帶校準後的信心分數。

它採用 RLCD(Reinforcement Learning for Calibrated Decisions,機率校準決策強化學習),讓程式可按信心分數安排自動處理或人工覆核。以併購盡職調查為例,系統可批次分析 50,000 份合約,抽取控制權變更條款、司法管轄區和風險等級,再把低信心結果交由律師檢查。

• 適合批次分類、標籤及結構化資料抽取
• 輸出格式預先定義,方便接入資料流水線
• 可用信心分數設計人機協作分流
• 取捨是它不負責撰寫長篇法律意見書等自由文字內容

JEV 的輸入價格約為每百萬 Token 0.042 美元,輸出 Token 免費;速度、成本和格式穩定性仍需按資料類型及 API 工作量驗證,不能直接視為所有 LLM 工作的替代品。

項目主頁

Categories: 模型, 模型訓練, 工具

Physis-Lang 讓影片模型理解物理因果

影片畫面看似合理,動態卻可能違反物理規律。Physis-Lang 以可演化的物理語言,改善影片資料整理、訓練與生成。

Physis

當影片模型能生成融化中的牛油,卻未必理解升溫、重力與形變之間的關係,Physis-Lang 便嘗試補上這個落差。這個由 NVIDIA、MIT 與 University of Oxford 研究團隊提出的 Video World Model 研究項目,把物理因果、相互作用、支配原理與結果寫進共享語言表示,協助模型生成更合理的世界演化過程。

Physis-Lang 不只描述畫面發生了甚麼,還要求字幕交代事情為何發生。例如牛油融化的描述會進一步指出升高的溫度提供熱力,熱力促成融化,而重力令牛油向下塌成淺層液體。物理概念會經由 Physics-aware critic 找出遺漏或缺乏視覺證據的說法,再由 agent 修訂共同的 captioning guidelines,captioner 本身則維持不變。

整套方法連接資料整理、模型訓練與推理:模型失敗會轉化成物理領域查詢,再透過 language-guided retrieval 找出能補足缺口、而且視覺內容多樣的影片;演化後的語言會重新製作訓練字幕,並擴展 inference prompts,同時加入針對場景的 negative descriptions,減少不合理動態。

  • PhysCapBench 收錄 246 段經審核的物理影片及 3,794 個人工驗證 assertions
  • 評估字幕對物理細節的 precision、recall 與 F1
  • Physis-Lang · Cosmos3-Super 在 Physics-IQ 公開排行榜列第一,平均分數為 48.2 ± 1.4
  • Physis-Lang · Cosmos3-Nano 列第二,平均分數為 43.3 ± 1.5

這項研究適合關注 Video World Models、物理推理和影片生成可靠性的讀者。排行榜結果顯示,加入可演化的物理語言後,Cosmos3 系列模型在相關評測中取得進展,但分數只反映指定基準,並不代表所有影片場景都能避免物理錯誤。

項目主頁

Categories: Agentic, 世界模型, 模型訓練, NVIDIA, Video, 框架

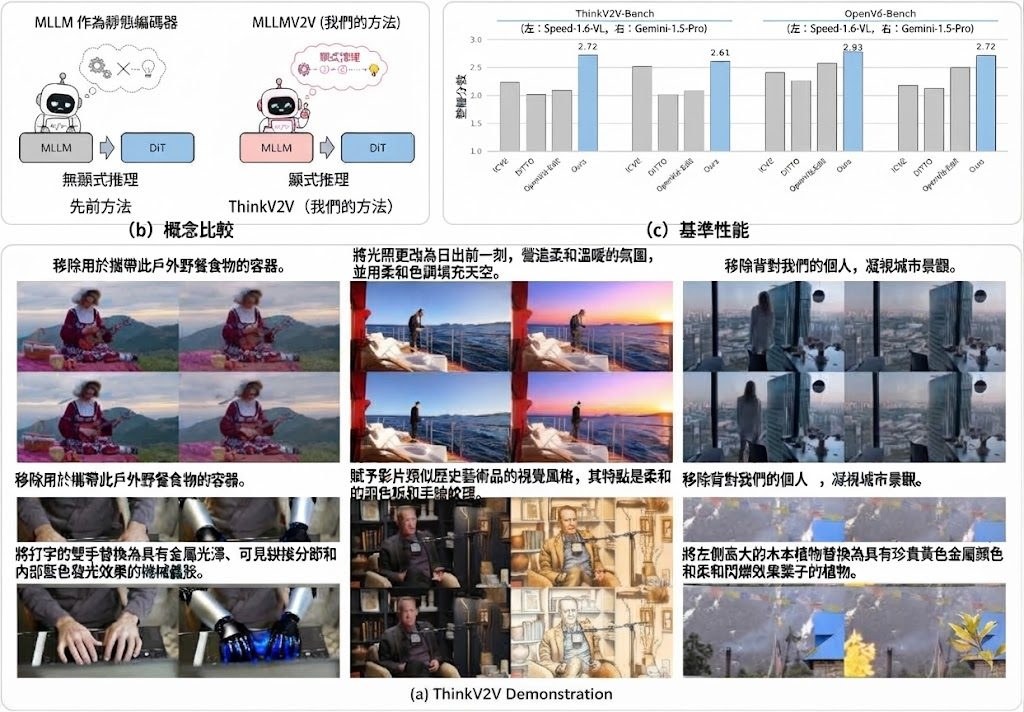
ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

RSIGame:生成遊戲及自行測試與進化

RSIGame 讓 AI 由遊戲構想開始反覆遊玩、找錯和改寫程式,直到品質提升飽和,再保留最佳版本。

RSIGame

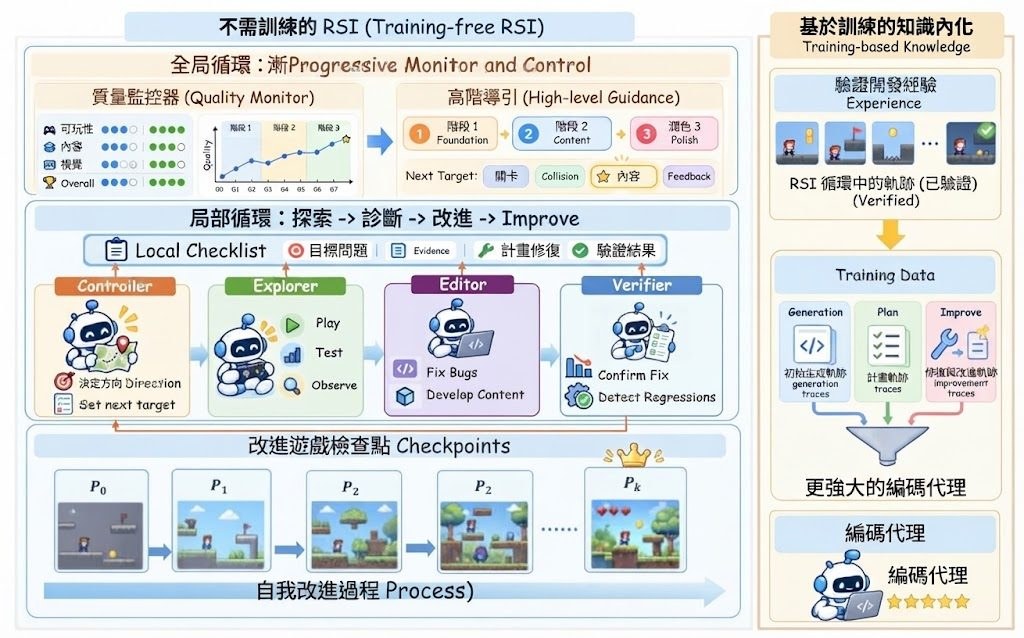
由一句高層遊戲構想開始,系統會自行產生可玩的版本,透過 AI agents 反覆遊玩、檢查問題,再改寫遊戲程式。RSIGame 屬於 autonomous agentic game development framework,實際處理的是生成遊戲難以持續修正、容易只迎合少量測試案例的問題。

RSIGame 把流程分成 local loop 和 global loop:前者執行 explore-diagnose-improve,廣泛探索遊戲、整理問題優先次序,再按證據修改;後者追蹤整體品質、保存最佳 checkpoint,並在長時間開發中識別停滯或回退。測試指引亦會逐步累積,令後續檢查不只依賴原本的提示。

透過 Hugging Face Space 輸入基本遊戲概念或設計方向,查看 agents 如何自動遊玩及產生較高評分版本。GitHub 項目要求 Python >=3.11,並以每次提交執行的測試檢查憑證外洩和內部 import 解析;自行研究或部署時,仍要留意所需模型、遊戲引擎及執行環境未在提供資料中完整列明。

在 140 個 GameCraft-Bench 任務、兩個遊戲引擎及五個生成器的相同開發預算下,RSIGame 持續提升遊戲品質。經驗內化後,Qwen3.8-27B 在 Godot 取得 61.38、在 Phaser 取得 58.53,超過 GPT-5.5 一次生成的分數,同時把 Qwen 的生成 token 減少 11 倍;結果仍屬基準測試,不能直接等同於所有遊戲類型的穩定表現。

  • 由高層構想生成遊戲,再自行遊玩、診斷和修正
  • local loop 負責局部問題,global loop 負責品質與版本選擇
  • 支援 Godot 和 Phaser 等遊戲引擎評估
  • 透過訓練內化成功的開發經驗,減少後續生成成本

RSIGame 適合研究 agentic coding、遊戲生成及長流程自我改進的團隊,也適合作為檢驗 AI 是否能處理多輪程式修正的研究框架。它的代價是流程需要較多執行時間、模型及遊戲環境配合,評分提升亦受測試任務和開發預算影響。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, Qwen, 框架, Python, 編程

EngiWorld 把工程代理接入真實軟件工作流

EngiWorld 不只測試代理人能否操作介面,更檢查它能否交付合乎工程規範的成果。

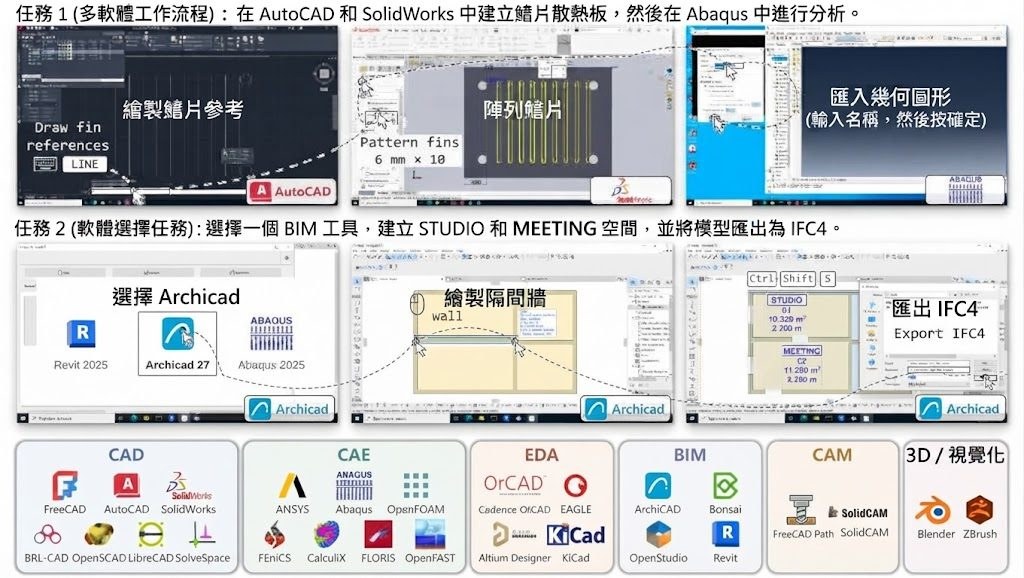
EngiWorld task examples and engineering software coverage

代理人要在 CAD、CAE、CAM、BIM、EDA 和 3D 視覺化軟件中完成工作,難點不只是點擊按鈕,而是要維持幾何、物理條件及跨軟件流程的正確性。EngiWorld 屬於工程代理人評測基準,實際處理的是「能否由指令一路產出可驗證工程成果」這個問題。

項目收錄 1,301 個專家編寫任務,涵蓋 26 個軟件平台、6 個工程領域及 6 類任務,支援 GUI 和 CLI。評測會檢查最終及中間工程文件的幾何有效性、物理可行性和規則符合度,數值設計任務亦會按規格達成程度連續計分,而非只分成功或失敗。

  • 提供完整任務、驗證器及 GUI/CLI 評測執行環境
  • 主實驗採用 300 個任務,清單位於 task/splits/main-300.txt
  • 本地環境以 Linux、Docker 及虛擬機器執行,預設每個環境使用 4 個 CPU 和 16 GB RAM
  • 七個前沿模型中,最高 EngiScore 只有 44.3;多軟件嘗試成功率為 3.6%

同類 Computer-use agents 評測多集中於一般桌面操作,EngiWorld 把判斷標準推到可交付的工程 artifact,因此更能揭示模型在長流程、跨軟件依賴及專業規範上的不足。代價是執行門檻較高:需要 x86_64 Linux、Python 3.10、Docker Engine 和環境映像,沒有 /dev/kvm 時亦可運行,但軟件模擬會較慢。

研究團隊、工程軟件開發商,以及想比較 GUI agent、CLI agent 或多模態模型能力的團隊,都可以用它重現測試並保存評測結果。它目前更適合作為嚴格的研究及模型比較工具,而非即插即用的生產自動化方案;最高分數與多軟件成功率反映,代理人距離穩定完成專業工程流程仍有明顯距離。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, 多模態模型, 軟件, 工具, 3D, Python, Dataset 數據集

VoxMem 測試音訊模型的記憶盲點

VoxMem 不只測模型記得講過甚麼,還檢查能否辨認說話者、語氣與背景聲音,直面多輪語音記憶的缺口。

VoxMem logo

當語音助手要回想幾次對話之前的內容,答案未必藏在文字轉錄稿內:誰說過一句話、當時的語氣,以及背景傳來甚麼聲音,同樣可能決定答案。VoxMem 屬於語音記憶評測基準,透過多次會話測試 Large Audio Language Models(LALMs)能否保留及運用這些非文字資訊。

項目把測試拆成兩條軸線:需要找回的聲音證據包括 speech semantics、speaker identity、paralinguistic cues 和 environmental sound;記憶操作則涵蓋 information extraction(IE)、multi-session reasoning(MSR)、temporal evolution tracking(TET)及 answer refusal(AR)。這個安排比只問模型能否找回一句原話更接近長期語音助手的工作情境。

VoxMem 提供 3,196 個評測實例,涵蓋 34,743 段、共 177小時的語音會話,並固定問題及證據,只改變8K、16K、32K 和 64K tokens的上下文長度。測試者可從 GitHub 項目取得程式碼,再配合 Hugging Face上的資料集重現評測;Python 3.9 或以上是已列出的基本環境,但不同 LALM仍可能需要各自的模型存取設定。

結果指出,15個 LALMs 在 32K 上下文下沒有模型達到 40% 整體準確率;模型記住文字內容的能力明顯高於辨認說話者、語氣及環境聲音,而且歷史越長,差距越大。這令VoxMem 更適合用來找出語音記憶系統的失效位置,而非單純作為模型排名工具。

• 同時測試聲音證據與記憶操作,涵蓋15個有效組合
• 以多會話歷史取代單一錄音,檢查跨場景整合能力
• 包含證據不足時拒絕回答,能檢視模型是否過度猜測
• 非文字聲音資訊在長上下文下明顯較難保留

研究語音代理、會話記憶、音訊模型或長上下文系統的團隊,能用這套基準分辨問題究竟出在聲音理解、跨會話推理、狀態追蹤,還是拒答判斷。資料採用 CC BY-NC 4.0,程式碼則使用MIT授權,商業產品整合前仍要獨立檢查資料使用條件。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, Audio, 工具, Python, 語音, Dataset 數據集

Page 22 of 183
1 … 20 21 22 23 24 … 183