Qwen-Image-Bench:難分高下的是細節

生成圖像模型愈做愈靚,真正難分高下的是細節表現。Qwen-Image-Bench 把評分拆得更細,較容易看清模型在哪些創作場景會失手。

Qwen-Image-Bench dimension framework and representative model outputs

只看一張圖夠唔夠靚,已經不足以判斷 text-to-image (T2I) 模型值唔值得放入創作流程。Qwen-Image-Bench 把焦點放到更貼近創作工作的檢查方式:它屬於評測工具包,同時連同 benchmark dataset 同 judge model,一併處理生成圖像模型難以客觀比較的問題。

這個項目的可取之處,在於它唔係只計語意對齊或整體畫質,而是用 fine-tuned 的 Q-Judger(Qwen3.6-27B)按 5 個階層維度評分,包括 Quality、Aesthetics、Alignment、Real-world Fidelity、Creative Generation,並細分到 56 個 facets。對做品牌視覺、遊戲美術、漫畫分鏡或者要處理文字渲染的人來說,呢種拆法比單一總分更有參考價值,因為你會直接見到模型係構圖、真實感、創意約束,定係文字生成出問題。

部署理解上,它唔係即開即用的網頁服務,而是偏研究與團隊驗證流程的 Python 工具。你要準備好虛擬環境、PyTorch,同埋包含 prompt、image_path、ID 的 CSV/JSON/JSONL 輸入,再透過 judge.py 跑 Qwen/Qwen-Image-Bench;另一條路線是直接用已公開的 benchmark responses 重現排行榜分數。底層推理沿用 ms-swift,跟釋出 benchmark 結果時的設定一致,這點有助減少評測流程前後不一。

  • 支援替任何 T2I 模型打分,較適合做橫向比較
  • 分數結構比一般 benchmark 細,方便定位失誤位置
  • 可重現公開資料集結果,適合研究或團隊內部驗證
  • 使用門檻偏技術向,需要本地推理環境與整理輸入格式

它的取向也很清楚:重點不是提供生成能力,而是提供一把較細緻的尺。代價是評測仍依賴 judge model,本身並不是人手審稿,也未必完全等同最終用戶審美;但對需要批量比較模型、整理回歸測試、追蹤版本變化的團隊,這種一致而可重跑的框架反而更實用。相關模型與資源包括 Q-Judger(Qwen3.6-27B)、Hugging Face 上的 Qwen/Qwen-Image-Bench,以及配套 benchmark dataset。
項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Qwen, Image, txt2img, 工具, Python, Dataset 數據集

Rank-Then-Act 點樣用影片學出獎勵

想像你只得示範影片、冇現成 reward function,Rank-Then-Act 就係針對呢個卡位而來。它先學會判斷進度,再把次序感轉成強化學習可用的訊號。

Screenshot

做強化學習最麻煩的地方,往往不是訓練本身,而是根本冇一個好用的 reward function。Rank-Then-Act 針對的正正是這個缺口:它屬於一個以 Vision-Language Model (VLM) 為核心的強化學習框架,目標是在沒有環境獎勵的情況下,從示範影片推回任務進度,再把這種進度感變成 agent 可學習的 dense reward。

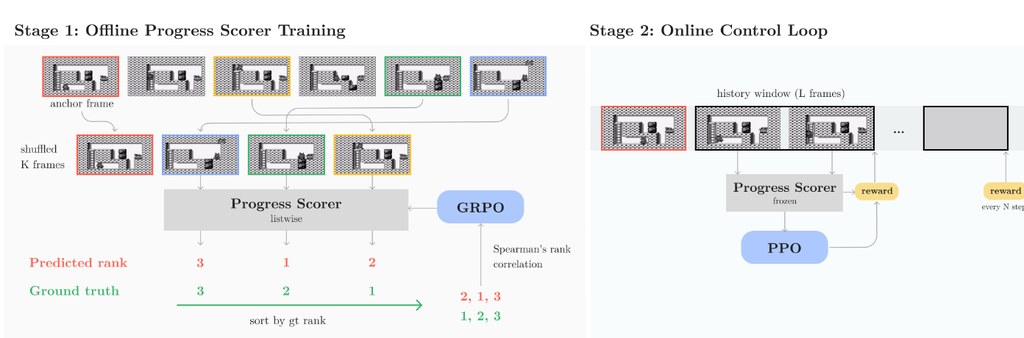
同類方法很多時會直接學一個 scalar reward,或者預測成功與否,但作者刻意避開這條路。RTA 先用 GRPO 微調 VLM,要求模型在打亂次序的畫面序列中估計 task-completion 百分比與排序,再用 VOC 這個 rank-correlation reward 去約束模型真的理解時間進展,而不是偷看絕對時間線索;之後在第二階段,系統不是直接輸出分數當 reward,而是用 Spearman rank correlation 比較預測進度排序與真實時間索引,得到一個 bounded、scale-invariant 的學習訊號。

這種取向的好處,是 reward 較不容易因尺度漂移而失真,亦較有機會跨任務重用同一個 progress scorer。現有資料指出,它在離散環境如 PyBoy 上的 Catrap、Kirby,以及連續控制環境如 MetaWorld、PointMaze 都有不錯表現,對 unseen tasks 亦有泛化能力;不過這仍然是研究型項目,重點在方法驗證,未算是即裝即用的成品工具。

  • 重點不是直接預測分數,而是先學會判斷畫面進度排序
  • 第一階段用 GRPO 訓練 VLM,第二階段用 PPO 訓練策略
  • reward 來自 VOC 與 Spearman rank correlation,訊號範圍固定在可控區間
  • 已覆蓋 Game Boy 模擬器 PyBoy 與 MetaWorld 這類不同控制場景
  • 需要 Python 3.10+、CUDA GPU,第二階段還要 xvfb、ROM 與 save state

理解和測試這個項目,最合理的方式不是把它當普通套件安裝,而是當成兩階段實驗流程來看:先在 stage1 用 gameplay videos 訓練 progress scorer,再到 stage2 把該模型凍結成 reward model,放進 PPO 訓練流程。儲存庫已把資料處理、Hydra 設定、多 GPU 配置、PyBoy 包裝器與 VOC 計算分開整理好,適合研究團隊、做 video-based RL 的人,或者想比較 ordinal reward 與 scalar reward 差異的讀者深入追蹤。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Python

[技術文章] Gemma 4:更快更慳算力的多模態開放模型

Gemma 4 想解決的,不只是模型夠唔夠大,而是點樣同時兼顧推理、多模態同部署效率。你可以把它理解成一組更貼近開發與裝置落地需要的 Gemma 新世代模型。

Hero image preview

Google 正式發佈 Gemma 4 技術報告文章:

當模型要同時處理文字、圖片同音訊,常見做法多數靠獨立 encoder 加上大型語言模型組合;能力雖然完整,但記憶體佔用、推理速度同長上下文成本都容易變重。Gemma 4 Technical Report 針對的正是呢個矛盾:唔只追求更強表現,亦想把多模態理解、推理能力同計算效率放到同一條路線上處理。

Gemma 4 屬於 open-weight、natively multimodal language models,涵蓋 dense 同 Mixture-of-Experts(MoE)架構,規模由 2.3B 到 31B。報告最值得留意的對比,在於作者唔再只沿用「更大模型加外掛模組」呢種固定範式,而是加入 thinking mode,令模型先產生 reasoning trace 再回答;同時用長上下文優化、KV cache sharing,以及在 12B 版本引入 unified, encoder-free architecture,把 raw audio 同 image patches 直接投影到 LLM embedding space。

呢種設計帶來的好處幾實際:一方面,長上下文下的記憶體壓力有機會減輕,報告提到 global KV cache footprint 最多可減 37.5%;另一方面,模型亦提供用 quantization-aware training(QAT)訓練的量化版本,盡量在不明顯犧牲品質下減少參數記憶體佔用同延遲。另有 autoregressive multi-token prediction(MTP)drafter head,配合 speculative decoding 提升解碼速度。

  • 支援文字、圖片、音訊,多個型號覆蓋不同硬件需求
  • 以 thinking mode 加強數學、編程等重推理任務
  • 透過 p-RoPE、KV cache sharing 等方法改善長上下文效率
  • 12B 型號採用 encoder-free 路線,減少獨立 encoder 帶來的記憶體碎片化

性能方面,報告指 Gemma 4 在 STEM、多模態同長上下文 benchmark 有明顯進步,亦在 Arena 等 human-rated tasks 接近更大型的 frontier open models。原始資料未提供安裝步驟或完整使用流程,但已清楚交代模型系列的核心取向:用較可控的成本,換取更接近前沿水準的多模態推理能力,並以 Apache 2.0 授權開放。

Paper

Categories: Embedding, 模型, 多模態模型, 模型訓練, Google, Gemini, Image, Audio, Dataset 數據集

SenseNova-Vision 把視覺任務收進同一模型

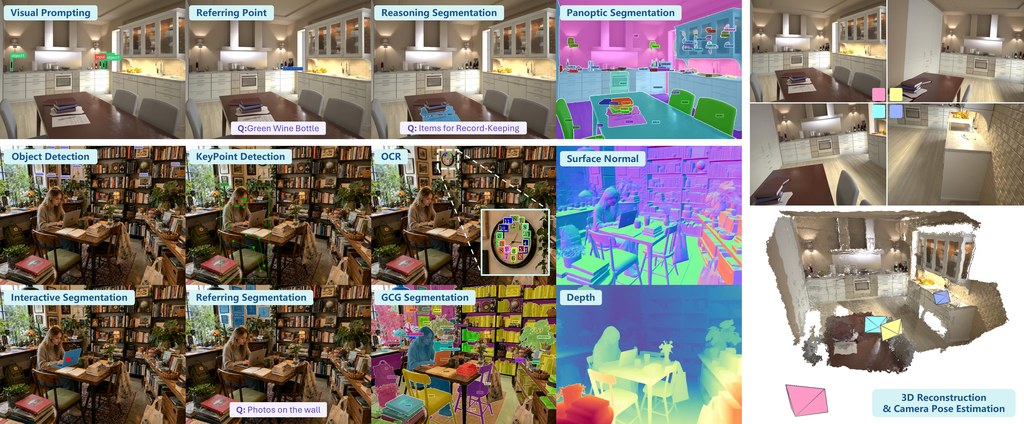
同一個模型同時處理框、點、OCR、分割同深度圖,SenseNova-Vision想解決的正是視覺流程太分散的老問題。你可以把它理解成一個用生成方式統一多種電腦視覺輸出的模型項目。

SenseNova-Vision handles diverse vision tasks in a unified model

做視覺項目最麻煩的,往往不是單一任務做不到,而是偵測、OCR、分割、深度估計同多視角幾何各有各套輸出格式。SenseNova-Vision把這些工作收斂到 unified multimodal model(UMM)的生成介面之內,屬於多模態模型項目,重點是用自然語言指令加可選視覺提示,統一處理結構化理解與密集預測。

它的取向幾明確:不再為每類視覺任務各自設計頭部與輸出器,而是把 boxes、points、OCR strings、keypoints、camera parameters 交由文字生成,把 segmentation masks、depth maps、surface normals、multi-view point maps 交由影像生成,亦支援文字加影像混合回應。這種做法的好處是工作流一致,代價則是推理解碼與評測轉換要做得夠穩,否則通用性未必等於每一項都最強。

目前公開內容包括推理程式、模型權重 SenseNova-Vision-7B-MoT、資料集 SenseNova-Vision-Corpus-50M,以及可試用的 Demo。要理解它點樣測試,最直接是先用 Demo 看同一張圖在不同指令下可否輸出可解碼結果,再配合倉庫的 Evaluation Guide 對標準 benchmark 檢查文字、影像或混合輸出的還原能力。

  • 同一模型覆蓋 結構化視覺理解、分割、dense geometric prediction 與 multi-view visual geometry
  • 輸出形式統一:文字、影像、混合文字影像都可作為回應
  • 已公開資源完整:inference code、SenseNova-Vision-7B-MoT、SenseNova-Vision-Corpus-50M、Demo
  • 適合場景明確:研究團隊、視覺產品原型、要整合多任務流程的工程工作

這個項目最適合不想為每個任務維護一套模型堆疊的團隊,尤其是同時要做偵測、文字辨識、分割與幾何估計的組合型流程。現有資料指出它在多類視覺任務上有不錯結果,但倉庫摘要未列出完整數字;現階段更值得留意的,是它用可解碼生成格式統一 benchmark 輸出的能力,這比單看某一項分數更能反映其定位。

GitHub · 模型

Categories: 開源, 模型, 多模態模型, Image, 影像處理, 香港, Dataset 數據集

MuseBench 用藝術理解考驗 MLLMs

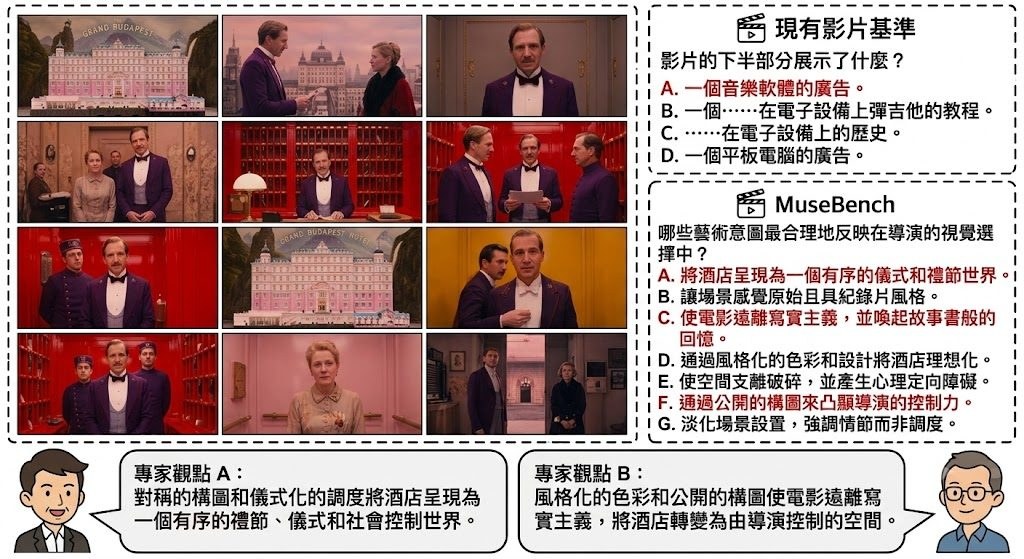
MuseBench唔係測模型見到咩,而係追問點解作品要咁表達。呢套 benchmark 把多模態理解拉到藝術語境,難度明顯高過一般視聽問答。

Repository image for musebench/musebench-code

見到畫面、聽到聲音,未必等於真係明白作品想點講。MuseBench 把焦點放到 artistic intent,專門測 multimodal large language models(MLLMs)能否由視聽證據推斷創作選擇背後的意思;它屬於 benchmark/數據集型項目,處理的是現有評測多數只停留在 perceptual recognition,未能反映藝術理解深度的問題。

現有做法常用一般視覺問答或影片理解題,模型只要辨認物件、情節或表面事件就有機會得分;作者認為這種 fixed paradigm 忽略 stylistic vocabulary、cultural priors 同 grounded audiovisual inference,所以改用 narrator-removed video clip,並配合可選 audio transcript,迫使模型直接由鏡頭、聲音、節奏與敘事線索作判斷。題目覆蓋 Cinematic Arts、Static Visual Arts、Stage Performing Arts 同 Game Arts,合共 4,016 條問答。

同類 benchmark 多數著重「睇到乜」,MuseBench 則更在意「點解要咁呈現」。它亦唔只用單一選擇題,仲有 single-select 同 multi-select 兩種格式,並加入 Chance-Adjusted Accuracy(CAA)處理選項數量不同帶來的偏差,令比較 28 個 MLLMs 時較公平。

  • 涵蓋 4 個藝術領域、11 個細分類,題材比一般影片 QA 更闊
  • 評測 28 個 MLLMs,包含 proprietary、open source 同 video-specific 路線
  • 最佳模型準確率 48.29%,明顯低於 human expert 的 87.18%
  • 已整合 VLMEvalKit,方便把新模型接入同一套流程測試

部署同測試理解上,這個 code repository 主要唔係提供訓練模型,而是把 MuseBench 接到 VLMEvalKit 的評測流程,較適合研究團隊、模型評估人員、做 video understanding 或多模態推理的項目直接比較新舊模型。已公開的結果提到 Claude-4.6-Opus、Qwen-3.5-Plus、Doubao-Seed、GPT-5.4、Gemini-3.1-Pro、Grok-4.1 等都測過,分數整體仍與專家有大段距離;換句話說,這個項目最有價值的地方,在於它清楚指出現時 MLLMs 在藝術判讀仍未算接近可靠。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, 字節跳動, 多模態模型, Qwen, OpenAI, Gemini, Video, Audio, 香港, Anthropic, Dataset 數據集

NVIDIA 用單一影片模型兼顧連貫與速度

想要影片生成既連貫又夠快,往往要在畫質、全局一致性同串流效率之間取捨。Flex-Forcing 嘗試用同一個 Video Diffusion Model,同時處理呢個矛盾。

Og image

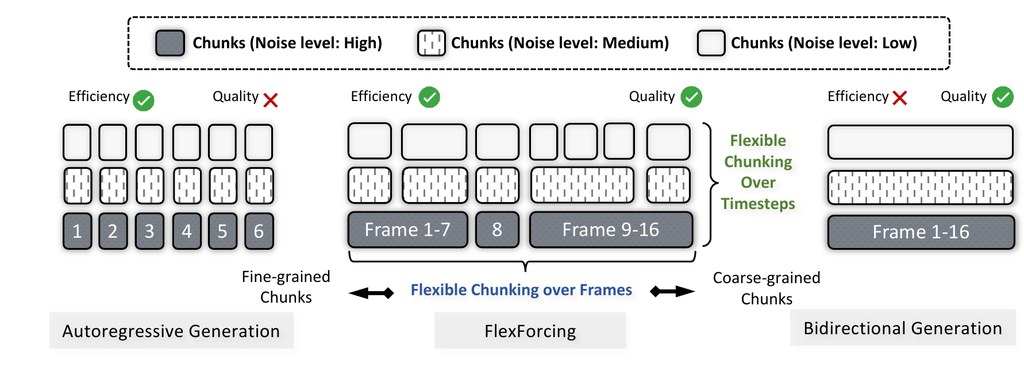
做影片生成時,最常見的卡位係:Bidirectional diffusion 生成得穩,前後鏡頭更一致,但速度慢;Autoregressive 方式可以逐段輸出,較適合串流,不過長片段容易失去連貫。Flex-Forcing 針對的正正係呢個兩難,屬於影片模型方向,目標係用同一個 Video Diffusion Model 橫跨兩種生成模式。

它的做法不是把兩套系統硬拼在一起,而是用一個較靈活的 chunking 機制,同時沿時間軸同 denoising steps 去切分。咁樣模型可以在 chunk 之間做 bidirectional 的全局規劃,又能在 chunk 之內用 autoregressive 方式逐步生成,兼顧整體一致性同推理效率。網頁用一句話概括得很清楚:one model, two generation regimes。

對內容創作、長影片生成同需要邊生成邊輸出的工作流來說,呢種設計幾有吸引力。它不是單純追求最快,亦不是只追求最完整的全局建模,而係嘗試將「先看全局」同「逐段出片」放入同一套推理框架,減少以往要為不同場景分開選模型的麻煩。

  • 統一 Bidirectional 與 Autoregressive 兩種影片生成路線
  • 以 temporal axis 配合 denoising steps 的 chunking 作核心設計
  • chunk 之間強調全局規劃,chunk 之內保留串流生成能力
  • 目標是改善長距離一致性、速度與 exposure bias 之間的取捨

現有資料顯示,Flex-Forcing 的核心價值在於統一訓練與推理框架,而不是只做單一生成模式的微調優化。公開內容暫時未完整列出具體評測細節,但方向已很明確:希望用一個模型覆蓋更多影片生成場景,特別適合重視長片段敘事連貫,同時又需要較靈活輸出節奏的項目。

項目主頁 · Paper

Categories: 視頻模型, 模型訓練, NVIDIA, Video, 框架

Light-Omni 想把長影片 Agent 變得更快

面對長影片互動,Light-Omni唔再靠一輪輪搜尋同推理。它把記憶、檢索同回應壓縮成較輕量流程,重點放在速度同連續互動。

Light-Omni

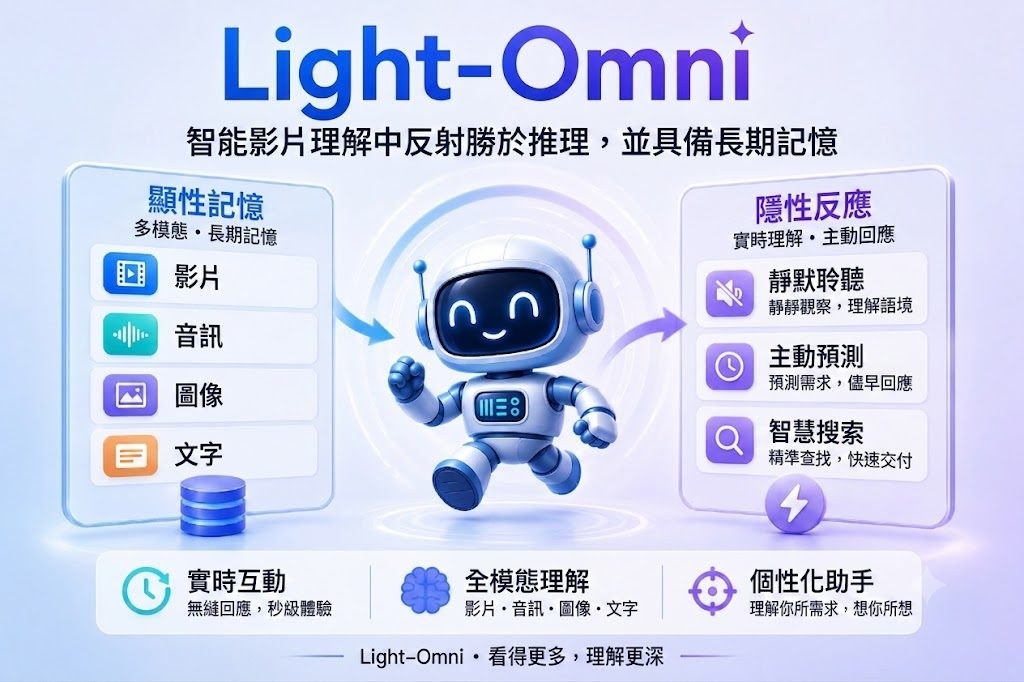
長影片互動最易卡住的位,不是模型看不懂,而是每次都要重新搜尋線索、反覆推理,回應自然會慢。Light-Omni把這件事改寫成一個Agentic video understanding研究項目:用長期多模態記憶處理視覺、語音與文字串流,目標是讓代理在連續對話中更快決定要直接回答、提取記憶,還是補足證據。

現有做法常採用作者所說的 detective-style iterative reasoning,一邊規劃、一邊搜尋、一邊聚合證據;好處是步驟清楚,代價是延遲高、計算開銷大。Light-Omni提出 reflexive video understanding,核心不是拉長 reasoning loop,而是以單次 forward pass 產生全域脈絡與 retrieval embeddings,再配合 Generation Adapter、Memory Adapter、Reaction Adapter 三個模組,分別負責回應、長期記憶整理,以及預測何時檢索。

這個取向的價值很直接:它不是追求最繁複的推理鏈,而是優先解決互動代理在長影片場景的反應速度。項目建基於 Qwen2.5-Omni,示範則用 Qwen3-Omni-30B-A3B-Instruct;記憶設計包含 identity profiles、semantic memory、episodic memory,並加入 sleep-time memory consolidation,把較長時段的觀察壓成緊湊全域狀態,同時保留近期細節。

  • 相比 M3-Agent,平均準確率提升 2.4%
  • 速度達 12.1x,加強長影片互動的即時性
  • GPU 記憶體效率提升 2.6x,較適合資源有限的部署
  • 倉庫附有 eval.py、Flask/Socket.IO demo、Hugging Face 模型與訓練資料

想驗證這個項目,現時可沿三條路理解:先看 web demo 感受反應方式,再用倉庫內的 eval.py 配合 logs/ 檢查長影片 benchmark 結果,最後參考 thirdparty/ 內已修補的 transformers 與 ms-swift 組件做訓練或推理環境配置。較受用的讀者會是做多模態代理、長影片理解、記憶檢索,或者需要低延遲互動系統的研究團隊;它仍屬研究原型,效能數字主要來自項目提供的 benchmark 與示範,部署前仍要按自己的影片長度、硬件條件與任務形式再核實。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, Embedding, 模型, 多模態模型, Video, Dataset 數據集

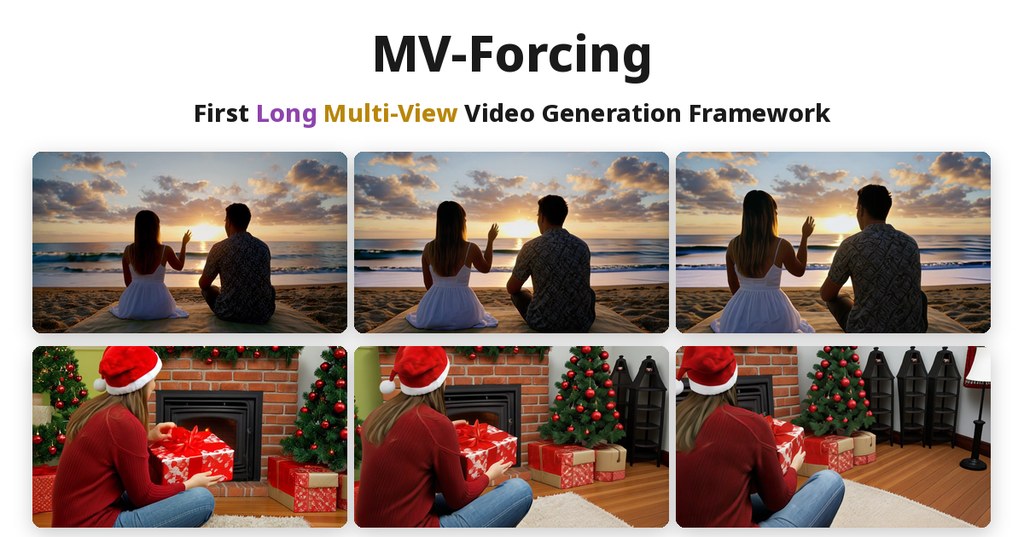
MV-Forcing 讓長時多視角影片更一致

同一段動態場景,要由多個角度連續生成而且唔穿崩,一直都好難。MV-Forcing想解決的,正正是長片段、多視角與幾何一致性三件事同時成立。

Og image

想像同一個人物動作,要由三個鏡頭角度一路接住生成,畫面不但要連戲,視角之間的位置關係都要講得通。MV-Forcing 屬於多視角影片生成框架,處理的正是長時段 dynamic scenes 在不同 viewpoint 下容易失真、跳位、前後不一致的問題。

它的取向,不是只顧單一視角拉長影片,也不是只做短片式多視角同步,而是把 temporal autoregression 同 view-wise autoregression 放入同一個 diffusion model。中間再加上一個 4D geometric prior 作橋樑:先從已生成的 source view 重建 3D 結構,再渲染出下一個 target view 的幾何先驗,最後交由模型細化成高質影片。

另一個關鍵在訓練方式。MV-Forcing 用 joint denoising,令兩個 view slots 訓練時都可由雜訊起步,避免模型只依賴固定 teacher temporal window,從而支援更長的生成。它亦加入 Distribution Matching Distillation 與 Spatio-Temporal Self-Forcing,盡量縮窄訓練與推理之間的 exposure bias,讓時間與視角兩條自回歸鏈接得更穩。

  • 能同時處理長影片與多視角一致性,而唔係二選一
  • 以 3D reconstruction 連接相鄰視角,補上幾何關係
  • 支援 arbitrary lengths 與 viewpoint counts,彈性較高
  • 用單一 few-step student model 完成生成,推理路徑較集中

現有資料提到,它已在 synthetic 與 real-world data 做大量實驗,重點成果是能生成幾何一致的多視角動態影片。不過公開內容暫時較像研究展示,Code 仍標示 coming soon;對內容創作、視覺敘事、虛擬攝影機規劃有興趣的人,會較容易看出這個項目的價值。

項目主頁 · Paper

Categories: 視頻模型, 模型訓練, Video, 框架, 3D

SaMer 壓縮視覺檢索成本

想保留圖像檢索的細節判斷,又不想被海量 visual tokens 拖慢,SaMer正正處理這個矛盾。它用較聰明的合併方式壓縮 token,同時盡量守住檢索準確度。

SaMer overview

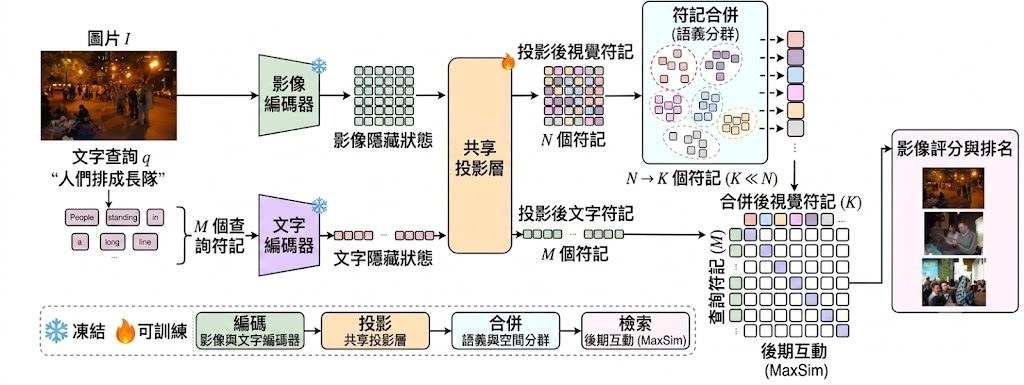
圖文檢索做得細緻,往往要保留大量 image-side tokens,但儲存與比對成本也會跟住升。SaMer屬於開源框架/研究原型,針對 ColPali-style multi-vector retrievers 的 token 壓縮問題而來,重點不是單純刪減,而是盡量保住之後查詢仍可能用得着的 object-level evidence。

現有壓縮做法多數偏向 pruning、pooling,或者只按 feature 合併,代價是物件與區域證據容易被混在一起,令 MaxSim late interaction 原本可選取的細節訊號流失。SaMer的取向明確:保留原本 MaxSim retrieval objective,不改 late-interaction 介面,只在 image side 做 object-aware merge,修正「壓縮後證據變鈍」這個問題。

它的方法有三個關鍵步驟:先用 feature similarity 加 spatial proximity 做 Feature-Spatial Merging,再在訓練階段利用 Flickr30k-Entities 的框標註加入 Object-Aware Assignment,避免不同實例被錯誤合併,最後採用 Projection-Only Adaptation,只訓練 shared projection layer,vision encoder 同 language backbone 都維持 frozen。到 inference 時就不再依賴 bbox,這點令部署比一些需要 detector 或額外 grounding loss 的做法簡潔。

  • 以 ColPali-style multi-vector retrieval 為核心場景,重點是減 storage 與 scoring 成本
  • K=64 時可移除超過 93% image-side tokens,ColPali 儲存量下降 16.09×
  • 在 Flickr30K 與 MSCOCO,README 與項目頁指出 R@1 有提升
  • 相關模型權重包括 vidore/colpali-v1.3-hf,另有 Hugging Face 的 SaMer models 集合

測試與重現路線算清楚:資料要先準備 Flickr30k-Entities,之後訓練 adapter、建立 compressed retrieval cache,再做 inference。原始資料列出 Python 3.10+、CUDA-enabled PyTorch,以及單 GPU/多 GPU 腳本流程,但 evaluation 章節在提供內容中未完整展開,所以更細的 benchmark 設定與完整數字仍要以論文與項目頁為準。

這類做法最適合需要多向量圖文檢索、又在意記憶體與延遲的團隊,例如做 large-scale image retrieval、phrase-level grounding,或者要把 ColPali 類系統壓到較可部署規模的研究與工程項目。它的取捨亦很清晰:不是追求最少 token,而是用較低成本保留日後查詢仍有機會選中的視覺證據。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, Qwen, NVIDIA, Image, Python, Dataset 數據集

Deform360 補上可變形物體世界模型短板

做布料、繩索、海綿這類可變形物體研究,最缺的往往不是模型,而是夠完整的真實數據。Deform360把多視角影像、觸覺與3D標註放在同一套資料流程內,定位相當清晰。

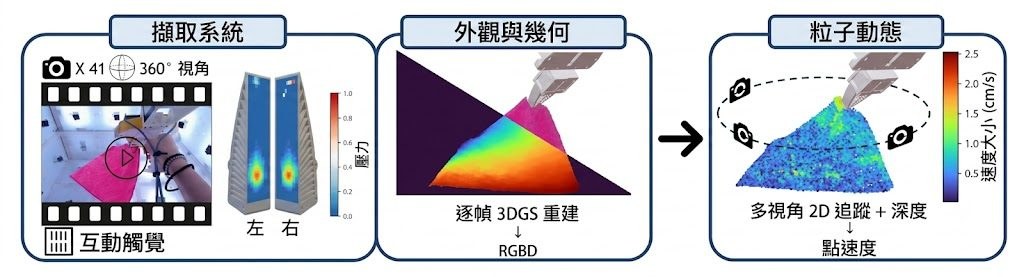
Deform360: per-frame 3D reconstruction alongside 360-degree multi-view capture.

一遇到布料、線材或柔軟玩具,很多世界模型很快就會暴露盲點:畫面看得到表面變化,卻未必掌握形變本身。Deform360屬於Dataset 數據集項目,集中處理的正是可變形物體研究長期缺少的真實多模態資料,讓2D video world models與3D particle world models可以放在同一基準下比較。

它的吸引力不只在於量大,還在於資料結構相當完整。項目收錄198件日常可變形物體、1,980段機械人互動、215.7小時累積錄製內容,配合41部同步720p RGB相機做360°拍攝,另有雙手UMI-based tactile grippers的四組16×32觸覺串流。對研究團隊來說,這代表不只是「有影片可看」,而是可以對齊視覺、觸覺、相機幾何與3D粒子標註去做分析。

跟不少只提供單視角影片、少量物件,或者只放最終標註的資料集相比,Deform360更重視重建與對齊流程。作者採用markerless visuotactile tracking pipeline,把ArUco calibration、3D Gaussian Splatting、CoTracker3與physics-informed refinement串起來,目的不是包裝成一鍵訓練工具,而是把可重用的資料契約、幾何工具、annotation I/O與multimodal alignment utilities公開。

  • 針對198件可變形物體,涵蓋多視角影像、觸覺與dense 3D particle annotations
  • 適合比較2D video world models與3D particle world models在真實形變上的差異
  • GitHub 目前主要釋出資料存取、preprocessing、geometry與對齊工具
  • 未附world-model baselines、training code、pretrained checkpoints或一鍵端到端流程

部署與測試的理解方式也要先講清楚:這不是拿來即刻訓練完整模型的全包框架。現有儲存庫提供Python 3.10以上的安裝入口,並連到 Hugging Face 資料集;你可以把它當成研究資料管線與讀取工具,用來下載資料、做相機去畸變、處理觸覺對齊、載入標註與幾何資訊。原始資料沒有提供完整基線訓練流程,因此較適合已有world model、tracking或robot learning流程的團隊接入。

性能方面,項目頁面有交代基準結論:ParticleFormer在held-out episodes預測較好,pretrained Cosmos在unseen objects的視覺指標領先,但可能偏離指令動作。這種結果也反映Deform360的價值不在於替某一類模型背書,而是把可變形動態、視覺觀測與觸覺證據放回同一個較公平的測試場。相關模型與方法脈絡包括2D video world models、3D particle world models、ParticleFormer、Cosmos,以及資料製備中用到的 CoTracker3 與 3D Gaussian Splatting。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 世界模型, 模型訓練, Video, Robotic, 3D, Python, Dataset 數據集

Page 41 of 55
1 … 39 40 41 42 43 … 55