Krea 2 Outpaint:外擴 LoRA 補畫面

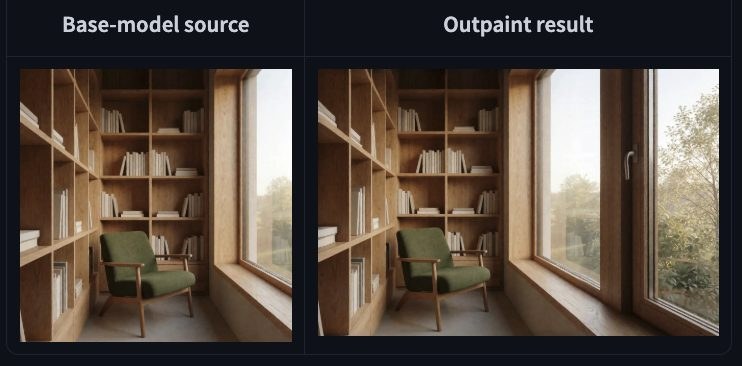
想將圖片自然延伸到更大畫布,又唔想主體走位,呢個 Krea 2 Outpaint 就係針對呢個卡位而來。它唔只做補邊,重點係知道原圖應該擺喺新畫布邊個位置。

Og image

畫面外擴最怕兩件事:原圖內容被改壞,或者延伸後透視、光線同結構接唔上。呢個項目明確建立在 Krea/Krea-2-Turbo 之上,並以 Krea 2 Raw 作訓練目標,形式係一個 rank-32 的 LoRA,用嚟做 image-to-image outpainting,重點唔係單純參考原圖,而係連原圖要放喺新畫布邊個區域都一併編碼。

它的做法是把來源 latent tokens 加上來自目標 bounding box 的 rotary coordinates,令 denoiser 能理解「已知畫面屬於整張新圖的哪個位置」。所以它比一般 image-reference adapter 更適合做左貼右擴、上貼下擴,甚至置中後向兩邊延伸,對透視、光照、紋理連續性的控制更直接。

檔案資訊相當清楚,但重點不在量化版本。頁面列出 krea2_outpaint_rank32.safetensors、pipeline.py、outpaint.py、example.py,另有授權與雜湊檔;同時明確說明 Hugging Face 自動產生的 Diffusers snippet 及一般 LoRA importer 不相容,要用隨附腳本與自訂 pipeline。這代表它不是即插即用型 LoRA,而係帶有功能性介面的適配器。

  • 基礎模型已指明為 Krea/Krea-2-Turbo,並針對 distilled 8-step inference 設計。
  • 核心差異在 registered reference_placements,可指定原圖在目標畫布的位置。
  • 已測試寫實、水彩、stylized 3D 等場景,涵蓋橫向、縱向與置中延伸。
  • 頁面沒有提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio 或量化等資訊。

使用取向上,它更像為 Krea 2 編輯流程補上一個 UI 版的外擴能力,而唔係通用本地推理模型。由於依賴 diffusers 與自訂程式碼,適合已經在 Python 圖像流程中工作、需要穩定控制構圖位置的人。
項目主頁 · 模型

Categories: 開源, 視覺模型, Image, 影像模型, 影像處理, Ollama

MobileWan 把 5B 影片生成壓進手機

想在手機級硬件跑到接近伺服器級的影片生成,MobileWan正面回應了這個難題。它不是再縮細模型,而是重組Wan2.2-5B的推理方式,換取畫質與記憶體之間較少妥協。

MobileWan logo

手機影片生成常見的痛點,不是能不能出片,而是畫質、動作連貫性與記憶體限制往往只能三選二。MobileWan屬於模型推理工具加輕量化模型方案,核心是在保留Wan2.2-5B基礎能力的前提下,讓單一提示詞影片生成更接近流動裝置可承受的範圍。

目前只支援 Snapdragon®
8 Gen. 5 NPU:不走細模型路線,而是把 Wan2.2-5B 改寫成更節省記憶體的推理形式。項目公開的是 inference-only sampler,會先做 hybrid-attention surgery,再套用已封裝的 self-attention head-pruning 計劃,之後才載入 MobileWan transformer 權重;換句話說,重點不是訓練流程,而是怎樣把既有大模型壓到可部署狀態。

資料顯示,MobileWan 以 recurrent distillation、causal linear attention 同記憶體優化解碼去支撐流動裝置生成,官方亦給出 5 秒、480×832、16 FPS、端到端約 20 秒延遲,以及 VBench 83.79 的成績。這些數字反映它追求的是「手機可跑,同時畫質不要跌得太明顯」,而不是只用極低參數換取能執行便算。

  • 支援單一提示詞影片生成,重點放在推理與部署而非訓練
  • 基於 Wan2.2-5B,透過 hybrid-attention surgery 與 head pruning 減低負擔
  • 可選 scheduler,包括 flow euler、unipcm 或 pipeline 預設方案
  • 生成流程提供 seed、略過既有輸出、較高品質 MP4 輸出等控制項目

這個項目的參考價值高;但它目前聚焦單一提示詞輸出,亦未見完整訓練鏈公開,適合拿來驗證推理路線,未必等同即插即用的產品方案。

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, Video

Netflix 正式納入 AI 製作流程:300 部作品已使用生成式AI

Netflix 透露今年約有300部作品用到生成式 AI,顯示它已走入實際製作流程,不再只是試驗。這反映串流平台正把 AI 由概念設計一路用到後期製作。

Og image

Netflix 在這段影片裡拋出的訊號很直接:生成式 AI 已經進入它的製作流程,而且不是少量試水溫。今年大約有 300 部作品用到這類工具,範圍由概念發想、前期視覺化到後期製作都涵蓋在內。這代表影視團隊處理畫面與內容時,開始把 AI 當成日常工具,而不只是額外加上的噱頭。

它最值得留意的地方,在於改變了內容製作的分工方式。傳統流程裡,很多視覺探索和素材整理都要靠人手反覆試,時間和成本都不輕;AI 介入後,團隊可以更快做出草稿、比較方向,再把資源集中在真正要打磨的部分。

  • 生成式 AI 已進入 Netflix 的實際製作流程
  • 應用範圍不只一個環節,而是橫跨前期與後期
  • 主要價值是加快探索速度,減少重複勞動
  • 反映串流內容工業化製作正進一步自動化
  • 對內容團隊、後期製作和視覺開發最有參考價值

這種做法和單純把 AI 當展示工具不同,重點在於它已經被放進正式工作流,變成可持續使用的製作手段。對做影像、廣告、預告片或大量內容開發的人來說,這類變化會直接影響交付速度、試錯成本和團隊分工。

項目主頁

Categories: AI productions, Video

Film space:用 iPhone 走出 AI 鏡頭路徑

想為 AI 影片保留真人運鏡感,Film space 提供一個幾直接的方法。你可以先喺 3D 場景排位,再用 iPhone 把走位同鏡頭移動錄成參考片段。

Film space

拍 AI 風格化影片時,最難控制的往往唔係畫風,而係鏡頭點樣郁、人物點樣企。Film space 把呢個問題拆得幾務實:它屬於 3D 預演工具,用 iPhone ARKit 把你真實行走時的裝置移動,轉成可錄製的虛擬鏡頭路徑,之後再交畀 Seedance 2.0 呢類工具做 AI style transfer 參考。

它的定位唔係直接生成影片,也唔係完整剪接系統,而係補上 AI video workflow 入面最易失真的一段:先用虛擬 studio 做 blocking,再用手機走一次鏡頭。相比純文字提示詞或者只靠模型自己猜運鏡,Film space 換來的是更清楚的鏡頭方向感;代價是你需要親身拿住 iPhone 進行錄製,而且目前明顯偏向單機、裝置端流程。

部署方式:整個流程在裝置上完成,建議橫向畫面使用,錄好的片段會存入相簿,再帶去後續生成工具。場景編排包括棋盤地板、格線、座標軸,亦可加入 human stand-ins 來模擬人物站位;去到 Camera mode,手機的移動、轉向與傾斜會直接變成鏡頭運動,配合 35mm、50mm、75mm、200mm 焦段預覽,對做分鏡、音樂錄像、短片測鏡頭的人尤其有幫助。

  • 把 blocking、走位同運鏡參考集中在同一個 iPhone 流程處理
  • 重點唔在生成畫面,而在為 Seedance 2.0 等模型提供更穩定的鏡頭參考
  • 以 ARKit 驅動 Camera mode,保留真人手持鏡頭的節奏感
  • 有基本 lens simulation 同 stand-ins,足夠做前期預演,但未見到進階場景製作能力

效能數據同正式 benchmark 目前未有公開,因此較難量化追蹤精度或錄製穩定性;現有資訊較能確認的是工作流設計,而唔係模型級指標。Film space 最適合用來做前期測試、概念驗證同低成本鏡頭預演,尤其當你想保留真人運鏡感,但又準備把最終畫面交畀 AI 重新風格化,這個項目的價值就會幾明顯。

GitHub

Categories: 開源, AI productions, Video, 工具, 3D, Dataset 數據集

VIABench 視覺模型如何協助失明應用

不少影片模型識描述畫面,未必識幫人做決定。VIABench 把測試搬到視障人士日常片段,重點睇模型能否提供真正有用的協助。

VIABench cover

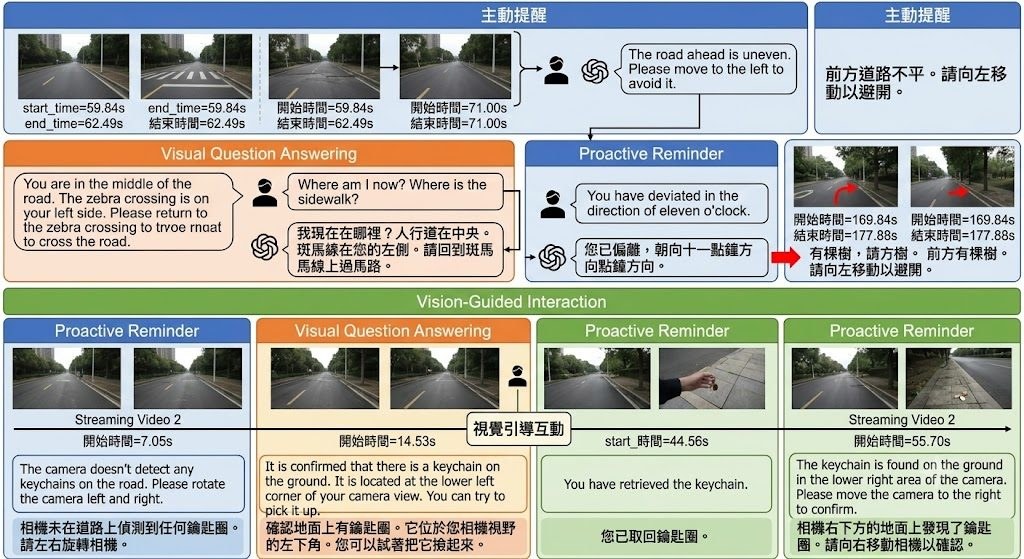
講到視覺模型,很多測試仍然停留在「見到乜、答到乜」;VIABench 把焦點轉去更貼身的助盲情境,直接檢查多模態大型語言模型可否在日常片段中作出提醒、回答環境問題,甚至按目標提供引導。它屬於Dataset 數據集兼評測基準,處理的是視障協助場景長期缺乏貼地測試標準這個問題。

VIABench 不再只量度被動理解,而是把影片 Multimodal Large Language Models 與真實任務綁在一起。資料來自盲人錄製或分享的第一身影片,包含 761 段影片、46.9 小時內容,以及 14,526 筆人工整理標註,圍繞 Proactive Reminder、Visual Question Answering、Vision-Guided Interaction 三類任務,測試模型會否在合適時間講合適內容。

和常見視覺問答基準相比,VIABench 的分野在於它重視「協助能力」多過一般描述能力。這意味模型不單要看懂畫面,還要判斷何時提醒、如何回應環境細節,以及怎樣支援使用者完成目標;取捨是任務更接近真實世界,但評測難度也更高,單靠表面語意對齊未必夠。

  • 核心價值在於測試影片 MLLMs 能否提供可行協助,而非只做畫面解說
  • 任務覆蓋主動提醒、視覺問答、互動引導三種助盲場景
  • 數據來自真實第一身影片,場景代表性比通用影片基準更強

較適合關注無障礙 AI、assistive technology、video MLLMs 評測的研究團隊,也適合想比較不同模型在真實互動場景表現的人。現有資料已足夠理解它作為基準的定位;使用前較合理的做法,是先查閱論文與 Hugging Face 資料集頁面,再確認支援哪些相關模型與評測設定。

GitHub

Categories: 開源, 南京大學, 視覺模型, 多模態模型, Video, Dataset 數據集

UniVR:視覺推理訓練變成可控工作流

UniVR 把 Emu3.5 的視覺推理訓練拆成 SFT 與 GRPO 兩段,讓團隊可用自己的資料同獎勵函數接上去。它更像一個面向視覺任務的訓練骨架,而唔係單一模型。

UniVR Overview

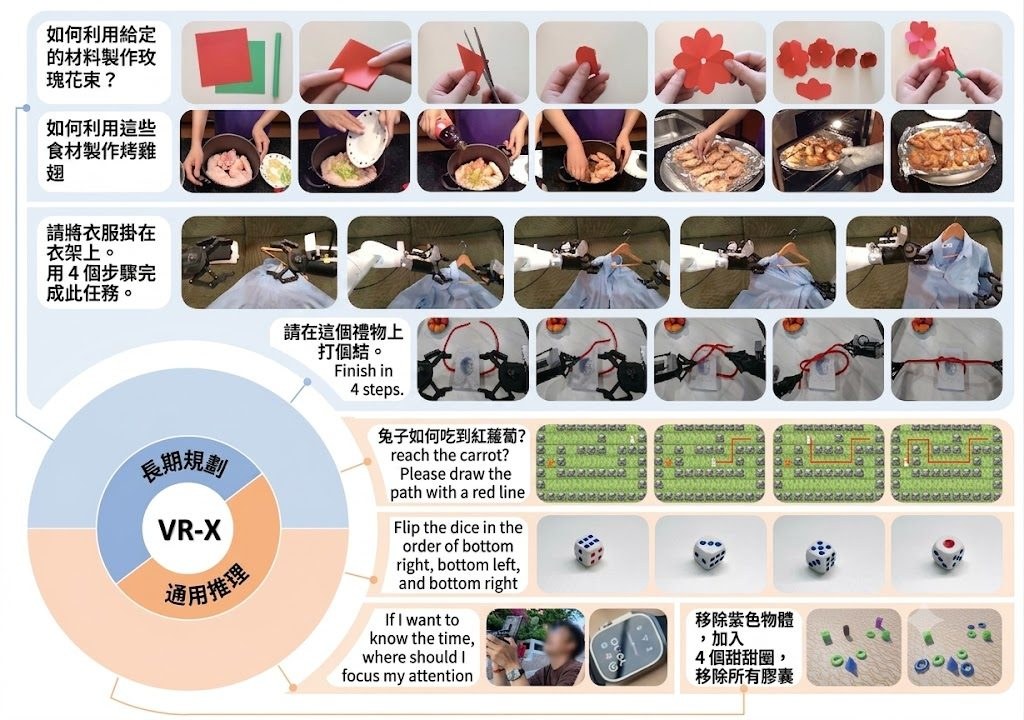
UniVR 係一個能理解我們視覺空間中的思考方式及其在統一視覺推理中的應用,它針對 Emu3.5 unified generative models 的訓練框架,處理的是視覺推理、長程規劃同結果判斷點樣一齊學。它唔係拿來直接做推理展示,而係俾你用自己的資料同獎勵訊號,去微調一個已經懂得處理圖像與文字的底座模型。

SFT(supervised fine-tuning)階段要提供統一格式的樣本:query image、textual instruction、visual reasoning trajectory;RL(reinforcement learning)階段則改成透過 HTTP reward server 送回分數。原始資料沒有提供完整安裝流程,所以目前可確定的只有要把自定義 PyTorch Dataset 接入 UniVR_SFT/train.py,以及把 reward function 換成自己的服務。

和一般只做單次微調的做法相比,UniVR 的取向更偏向「先教格式,再用獎勵修正推理」。它在 RL 端用 GRPO,並配合 HybridEngine 與 Emu3.5 的 vLLM patch,強調 rollout 效率;同時保留 LoRA 同 full-parameter training,適合資源與改動幅度唔同的團隊。

  • 支援多節點 SFT,兼容 LoRA 同 full-parameter training
  • RL 端基於 verl,同 GRPO 搭配自訂 HybridEngine
  • Emu3.5 的 vLLM no-CFG parallel inference 可做到約 2 倍 throughput
  • 獎勵設計分成 format reward、global reward,同 step-level 的視覺推理約束
  • 相關模型包括 Emu3.5 同作為評分器的 Qwen3-VL-30B

較容易受惠的情境包括做視覺代理、機械臂/操作規劃、長程任務推理,或者想將現成視覺模型轉成自己工作流的團隊。它的價值在於把「資料格式、推理軌跡、獎勵判斷」串成同一條訓練路線,令視覺任務唔再只靠靜態標註去學。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Gemini, Image, Python, Dataset 數據集

VideoChat3 一個睇得耐又睇得準的影片模型

要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

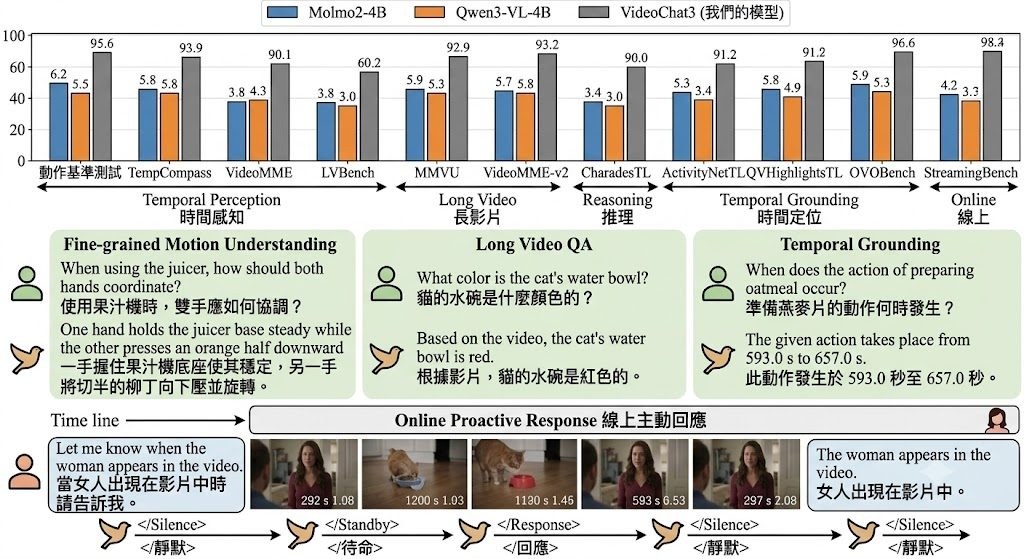
影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

Wan Streamer v0.3:讓 AI 學懂「世界不變,只有事件在流動」

Wan Streamer v0.3 把影片拆成「持續存在的世界」和「持續發生的事件」,讓即時音視頻對話支援自由動作描述,延遲仍維持約 200ms。你可以把它理解成:一個會記得場景、然後跟著時間線即興演下去的 AI 對手。

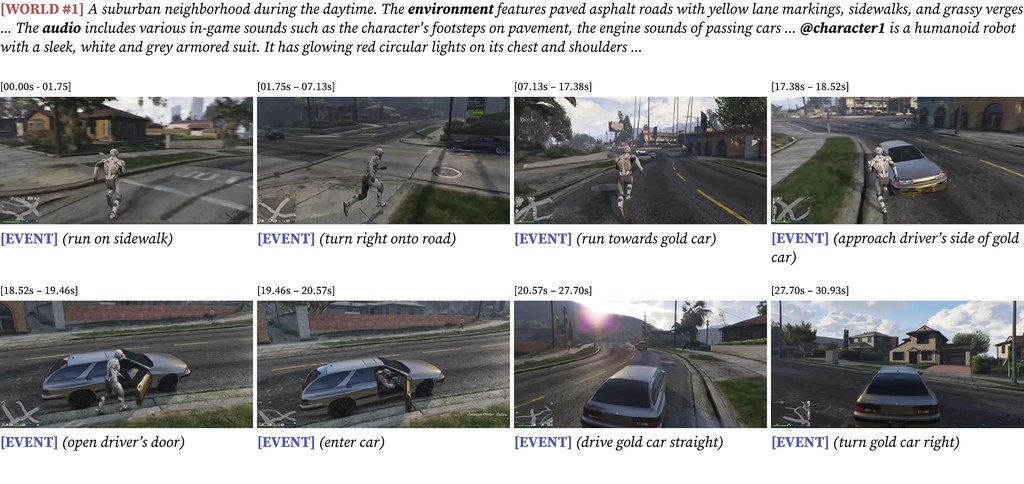
A robot navigates a suburban neighborhood and drives a car through a sequence of events

玩過 AI 影片對話工具的人都會發現一個矛盾:模型可以跟你聊天,但一旦想做動作,畫面就容易卡頓、失憶,甚至換了一張臉。Wan Streamer v0.3 想解決的就是這個問題——它把影片分成兩件事來學,一件是「世界設定」(場景、角色、畫風、聲音這些要長期保持一致的東西),另一件是「事件流」(說話、動作、鏡頭移動、環境變化這些隨時間發生的事)。

這個拆法聽起來抽象,但對使用者來說,最直接的差別就是角色終於可以做自然語言描述的動作了。你打開鏡頭,模型會一邊跟你說話,一邊伸手拿起眼前的物件、轉向聲音來源、或者露出驚訝的表情,而且動作和對嘴的時序是學出來的,不是後製對齊的。延遲仍然維持在約 200 毫秒,解析度 640×368、幀率 25fps,即時互動不會被打斷。

從工作流角度看,這個版本最大的價值是把普通影片變成訓練素材:先建立世界,再沿時間軸學接下來會發生什麼。同一套能力日後可以遷移到漫遊探索、機器人控制等場景,而這次發佈聚焦在即時音視頻對話。

重點摘要:

  • 拆解式學習:將「持續世界」與「事件流」分開建模,避免長對話中場景漂移
  • 自由動作描述:支援用自然語言寫出動作(如拿取物件、轉向、變換姿勢),並與對話同步渲染
  • 即時互動規格:640×368、25fps、約 200ms 模型側延遲,支援全雙工音視頻
  • 普通影片即訓練素材:不需特殊標註,現成影片就能用於學習時間軸上的因果事件
  • 可遷移架構:同一套預訓練能力可延伸至具身導航、漫遊等場景

對於做數位人、虛擬主播、互動敘事或即時陪聊的團隊,這個方向值得留意;對於只是想試試看的個人,現有 demo 已經足夠展示「角色真的在過日子,而不只是在回話」的差異。

項目主頁

Categories: 多模態模型, 世界模型, 模型訓練, Video, Audio, Robotic, 語音, Skill 技能

KeyFrame-Compass:關鍵幀尺度評測

想知道影片生成有沒有跟住關鍵畫面,KeyFrame-Compass 就把這個矛盾拆開量度。它同時看畫面有沒有到位、順序有沒有跟足,還會檢查整體影片質感。

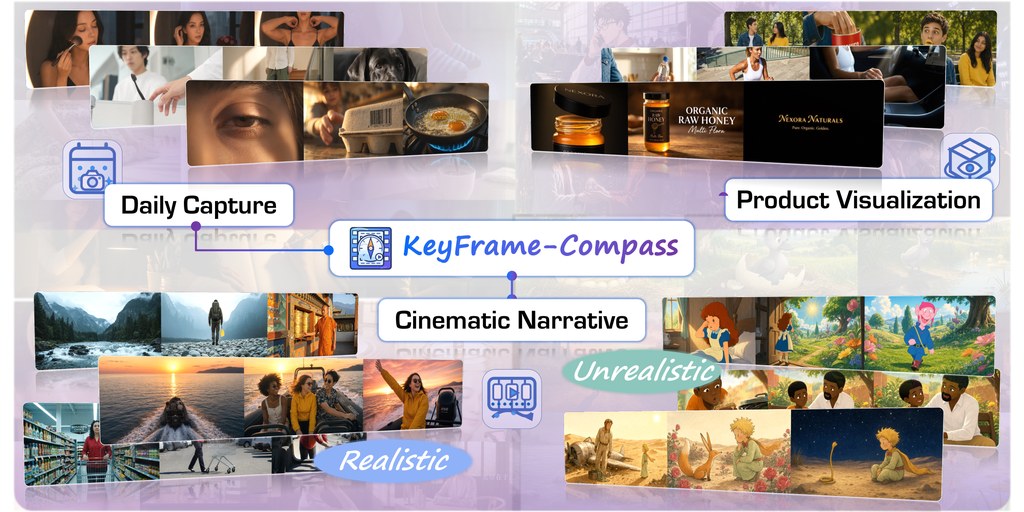
KeyFrame-Compass benchmark domains and examples

KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。

這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。

官方提供 386 個案例,涵蓋三個應用領域,亦分有 multi-shot 同 one-take 片段,配合四種 keyframe 密度。安裝上需要 Linux、Conda 或 Mamba、NVIDIA GPU,同埋可用的 VLM API;倉庫亦提供 envs、assets 同 all 三種設定模式,方便只建環境、只拉資產,或者一次過做完整驗證。

  • 把影片生成的「跟畫面」同「成片質感」分開量度,結果較容易解讀
  • 支援不同 keyframe 密度,較適合比較模型對控制力的穩定度
  • 適合做影片生成模型、研究原型或產品 demo 的質量驗證
  • 需要 GPU 同外部 VLM API,部署門檻唔算低
  • 相關模型類別可歸到 Video、視覺模型、多模態模型、模型、工具

GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Gemini, API, Video, 工具, Linux

MultiRef-Compass:多模態影片不再各自為政

做多模態影片生成,最難往往唔係出片,而係點樣公平比較結果。MultiRef-Compass 把文字、影像參考同音訊參考放入同一套評測流程。

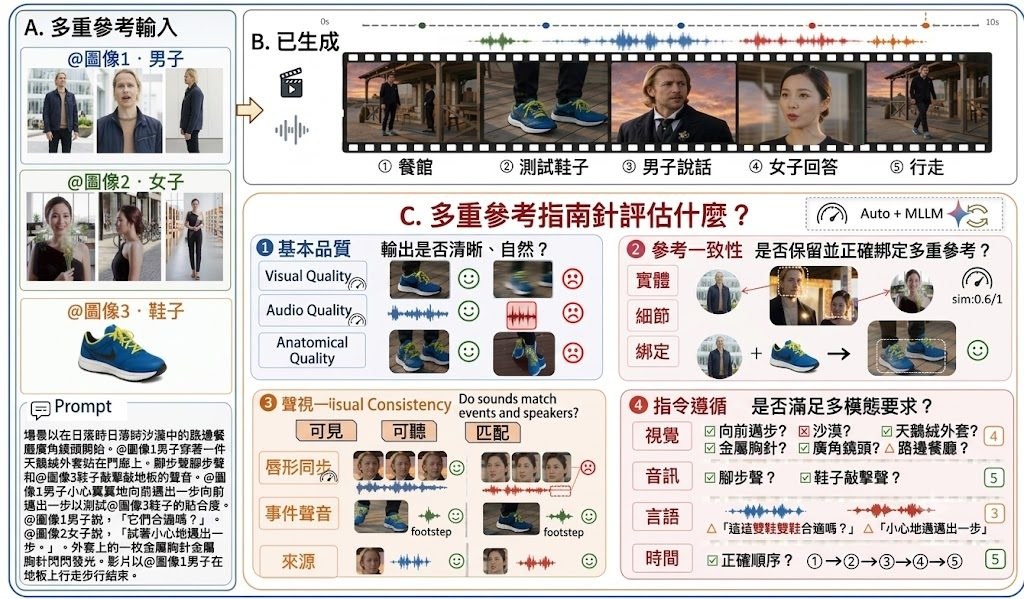
MultiRef-Compass overview

同一段生成影片,畫面可能順眼、聲畫卻唔對位;角色外觀接近參考圖,指令跟從又未必準。MultiRef-Compass 抓住呢種常見落差,定位成一個開源評測工具包,處理 multi-reference multimodal video generation 的比較問題,重點唔係逐條片人手睇,而係用可重現的方法把不同模型放到同一把尺上量度。

它的取向相當明確:偏向研究比較,而唔係臨時檢查作品。項目用固定的 CSV 輸入欄位,接收文字、視覺參考、音訊參考同生成影片,再輸出 per_sample.csv、model_summary.csv、ranking.md 同 details.json。這種設計的好處,是團隊可以用同一批樣本反覆測不同模型;代價是流程較講究資料整理,較適合已有實驗管線的人。

跟只看單一分數的做法相比,MultiRef-Compass 把結果拆成四組共 14 個公開指標,包括 Basic Quality、Entity Fidelity、Audio-Video Consistency 同 Instruction Following。它同時混合 classical media-analysis pipelines、learned quality models、speaker embeddings,以及 multimodal language model judges,所以看到的不只是整體高低,仲會知道問題出在 anatomy、reference fidelity、voice timbre similarity,定係 temporal order。

  • 用統一 schema 比較不同影片生成模型,較容易做橫向排名
  • 保留 sample-level diagnosis,同時支援 model-level ranking
  • 支援 text、visual-reference、audio-reference 三種條件一齊評測
  • 著重公開 metric taxonomy,同類研究較易重現結果

現有資訊未見到完整安裝細節,但理解方式已很清楚:先準備符合欄位要求的 CSV manifest,再按指標群組跑評測後端。受益最大的,會是做多模態影片生成、聲畫對齊、角色一致性與指令跟從研究的團隊。相關能力圍繞 Visual Quality、Audio Quality、Entity Fidelity、Speech-Lip Synchronization、Voice Timbre Similarity 等指標展開;它未必幫你直接提升模型質素,卻能先把模型到底差在哪一環講清楚。

GitHub · 模型

Categories: 開源, Embedding, 多模態模型, 視頻模型, Video, Audio, 語音

Page 37 of 55
1 … 35 36 37 38 39 … 55