Wonder:Adobe 把影片變成可探索世界

輸入一張圖或一段片,Wonder會延伸出可持續探索的互動場景。重點不只係生成畫面,而係鏡頭移動之後,世界仍然記得之前見過嘅內容。

huggingface logo

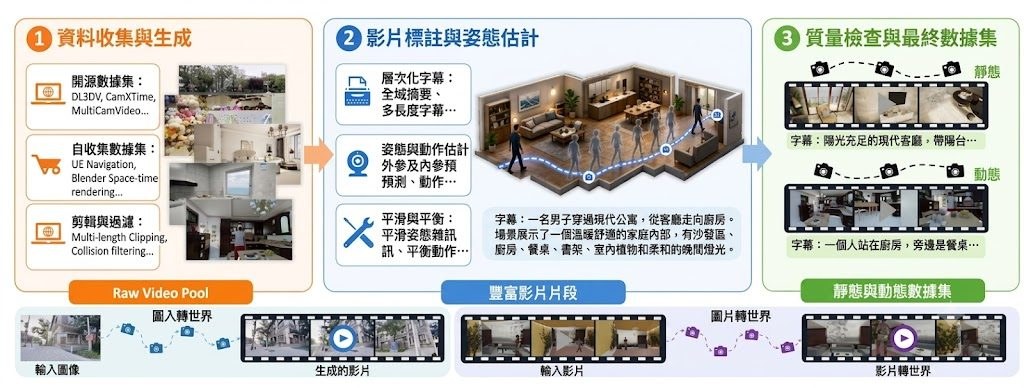
由一張圖片或一段影片出發,Wonder會建立一個可以邊走邊看的互動式 Video World Model,處理的是「鏡頭一直移動,但場景仍要連貫」這個難題。你向前推、左右轉,甚至回到之前看過的位置,畫面都要盡量保持幾何、外觀同動態一致,而唔係每一格重新幻想一次。

呢個項目吸引的地方,在於它兼顧了互動感同穩定性。官方資料指出,Wonder支援 image-to-video 同 video-conditioned generation,提供 6-DoF camera control,並以接近固定延遲維持最長一分鐘的探索;對想做可遊走場景、遊戲世界原型、動畫預覽,或者互動式視覺敘事的人來講,呢種體驗比單次生成短片更有用。

為咗令鏡頭控制唔只停留喺抽象指令,Wonder把相機平移與旋轉轉成可對齊畫面的密集視覺證據,再配合 3D scaffold 同 environment map 去建立可導航空間。它亦保留完整歷史的 KV caches,再用 sparse attention 抽取相關記憶,令系統可以在不明顯拖慢回應下,維持較長距離的一致性。

  • 支援 I2V+V2V multimodality,可由圖片或影片開始生成互動世界
  • 提供 6-DoF camera control,重點是可探索而唔係只看固定鏡頭片段
  • 以 sparse attention 配合完整歷史記憶,改善長時段連貫性
  • 官方展示為 16 FPS rollout,頁面上的 32 FPS 影片屬線性插幀後處理

訓練部分用了 Mixture-of-Students 設計,並以 GAN Control Regularization 處理蒸餾時的 camera drift,目標是同時保住控制能力同長期一致性。現階段公開資訊以示範與技術報告為主,Code 同 HuggingFace 尚未釋出;不過單看定位,Wonder已經清楚指向一類更接近「可互動世界」而唔係「一次性影片生成」的世界模型方向。
項目主頁

Categories: 開源, 視頻模型, 世界模型, 模型訓練, Video, Image, 3D

Sol-Attn:免訓練稀疏注意力 影片生成加速達 2.1 倍

Sol-Attn 用一套即時運作的稀疏注意力機制,讓預訓練好的影片與圖像生成模型無須重新訓練,就能跑得更快兼保留畫質。對本地部署或自建生成管線的人來說,等於多了一個現成的加速選項。

Og image

影片生成模型愈來愈強,但推理速度依然是開發者和創作團隊最常卡住的地方。NVIDIA Research 提出的 Sol-Attn,正正針對這個矛盾:它把「訓練用嘅成本」同「推理時嘅效率」分開處理,讓預訓練模型無須重新訓練就可以直接加速。

Sol-Attn 屬於免訓練(training-free)嘅稀疏注意力機制,做法是動態計算一個 query 相關嘅閾值,即場篩走低貢獻嘅注意力區塊,同時把未選中嘅分數重用做近似補償,整個過程喺一次 online-softmax 內完成。換句話講,它毋須事先計好一張路由表,亦唔會直接丟棄被跳過嘅區塊,因此能保留長尾分佈對最終畫面嘅影響。

喺 Wan 2.1、Hunyuan 1.5、LTX 2.3、Bernini 等多個主流模型上,Sol-Attn 都做到約 2 倍嘅速度提升,同時畫質幾乎唔受影響。若配合 Sol-Engine 中其他加速技巧,仲可以推到 5 倍嘅端到端加速。對於要跑長影片、做後製編輯,或者本地有限顯示卡環境嘅使用者來說,呢個幅度算係幾實用嘅改進。

對比以往「離線先揀一次、再丟棄」嘅做法,Sol-Attn 最大嘅差異在於即場判斷同重用機制。讀者如果本身就喺度搵方法縮短生成等待時間,又唔想額外花資源微調模型,呢套方案值得留意。

項目主頁 · GitHub

Categories: 視頻模型, 模型訓練, NVIDIA, Video, Image, LTX

ViMax 把影片生成變成多代理流程

想由一句想法走到完整影片,卡位往往唔係生成本身,而係分鏡、節奏同角色一致性。ViMax把呢條流程拆成多個 Agent 協作,重點放在先規劃、再生成。

Repository image for hkuds/vimax

直接由文字生成影片,最易出問題的通常不是畫面夠不夠靚,而是故事走向會散、鏡頭難連貫、角色設定前後不一。ViMax把這些環節拉回工作流處理:它屬於 Agentic Video Generation 類型的開源項目,用多個 Agent 分別扮演 Director、Screenwriter、Producer 與 Video Generator,目標是把影片生成由單次出圖,變成可規劃的多步驟流程。

這種取向的分別,在於它不只追求「一句提示詞出片」,而是先把敘事、鏡頭與製作安排拆開,再交回生成模組執行。對內容創作者、想做短片原型的團隊,或者研究多代理協作點樣落地到視頻模型工作流的人,這個項目會較有參考價值;但儲存庫提供的資訊目前偏簡短,未見完整測試結果、部署細節或清晰的安裝流程。

從名稱與描述判斷,ViMax較像一個協調層或框架,而不只是單一視頻模型。它想補的是影片生成裡最難靠單一模型穩定完成的前置規劃,因此價值未必在最終某一幀畫質,而在於整段片能否保持節奏與結構。不過,原始資料未交代它串接哪些底層模型、怎樣處理角色一致性,亦未提供性能指標,現階段較適合先當成研究方向與工作流設計來理解。

  • 把影片生成拆成 Director、Screenwriter、Producer、Video Generator 多個 Agent
  • 重點放在規劃與協作,不只是單次提示詞生成
  • 適合研究多代理、多步驟視頻製作流程的人參考
  • 儲存庫描述很短,暫時未見完整安裝、部署與評測資訊

ViMax最吸引人的地方,是它把「生成影片」理解成一條需要分工的製作鏈,而不是單一模型一次完成所有事。現有資訊仍不足以判斷成品穩定性或生產可用度,但作為開源方向,它清楚對準了多模態模型在長段影片敘事上的核心難題。

GitHub

Categories: 開源, 香港大學, Agentic, AI productions, Video

ClinFusion 把醫療影像讀懂再回答

ClinFusion瞄準的不是一般聊天,而是把2D與3D醫療影像連同文字指令一併理解。它想解決的重點,是醫療多模態模型常見的看得多、答得快,卻未必貼近臨床判讀。

radar chart

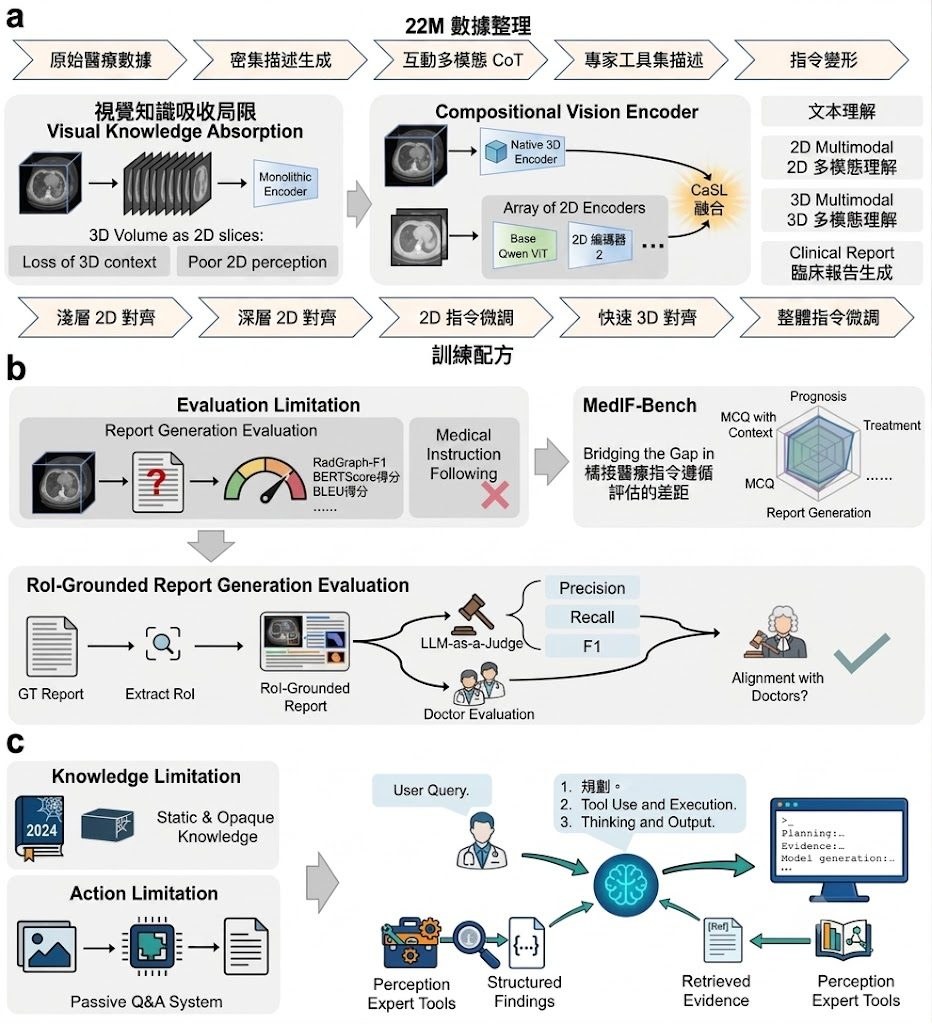
醫療多模態模型最易失準的位置,往往不是會不會答,而是有沒有真正對準影像內容。ClinFusion屬於模型,更準確地說是面向臨床理解的 vision-centric Multimodal large language models (MLLMs) 系統,重點放在同時處理 2D 圖像、原生 3D NIfTI 影像與文字任務,減少只靠文字對齊時常見的臨床細節流失。

現有做法常把醫療問題當成一般多模態問答處理,但作者認為這種範式忽略了 3D 影像與放射科判讀流程,因此用 compositional and cascaded vision encoder 配合 Cascade Spatial-Aware Locality Fusion,把 2D 與 native 3D 醫療影像放進同一個 fused encoder。另一個關鍵不是只換模型,而是連評測也改寫:加入 MedIF-Bench 檢查 instruction following,並用 region-of-interest-grounded 方法評估報告生成的 factualness。

論文給出的成績相當進取:ClinFusion 在 24 個基準中有 20 個超過 Hulu-Med、Lingshu 等開源醫療 MLLMs,也在 16 個比較裡有 13 個勝過 GPT-5.2 與 Gemini-3-Flash。盲測部分由 board-certified radiologists 進行,報告排名亦拿到最佳,RoI-grounded metric 與專家判斷的相關性也最高,這點比單看自動分數更有說服力。

  • 可接受文字 prompt、2D 圖像路徑,以及 3D NIfTI volumes(.nii.gz)
  • 定位不是通用聊天,而是臨床導向的整體醫療理解
  • 核心取向是把 2D/3D 視覺編碼與臨床一致的評測一併重做
  • 已公開模型推理方向,但儲存庫資訊未完整交代部署流程與完整安裝細節

較適合留意這個項目的,會是做醫療 AI、放射影像、多模態研究或醫療報告生成評測的團隊。它的亮點在於把「模型看見了什麼」與「臨床上是否講得準」放到同一條線上;限制亦很清楚,現有 GitHub 資訊主要集中在作者主張與推理輸入格式,真正要落地到醫院工作流,仍要再看公開模型、硬件需求與後續工具鏈是否齊備。

GitHub · 模型

Categories: 開源, 清華大學, 阿里巴巴, 模型, 多模態模型, Qwen, Image, Medical醫學, 3D, 中國, Dataset 數據集

CrossView 用 3D 數值控制鏡頭:LTX-Video 跨視角生成

同一段影片想換個拍攝角度,通常最難是保住人物一致性與空間感。這個 IC-LoRA 用深度 warp 加原片雙參考,讓跨視角生成更可控。

Og image

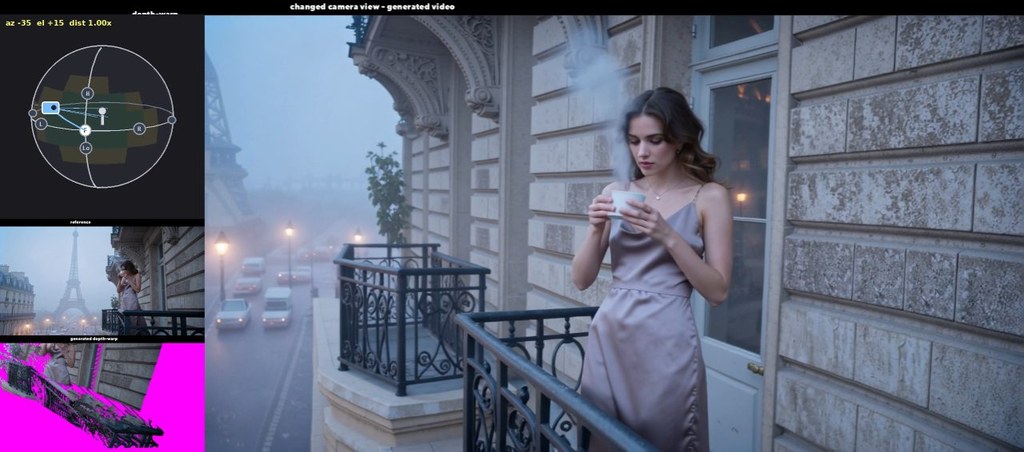
想將一段現成影片改成另一個鏡頭角度,又唔想主體變樣或空間關係散掉,這正是此模型處理的問題。它明確基於 Lightricks/LTX-2.3,屬於 LTX-Video 2.3 22B 的 IC-LoRA 微調,重點不是純文字改鏡頭,而是用輸入影片加相機偏移數值,重建同一場景的新視角。

頁面提供的做法幾清楚:模型同時接收兩段參考影片,一段是由 CrossViewWarp ComfyUI node 產生的 depth-warp 影片,用來保留幾何結構;另一段是原始影片,用來維持主體 identity。這種雙參考分工,反映它優先解決「換角度後仍要似原片」的取捨,比單靠 prompt 描述鏡頭更穩定。

它與同作者的 CrossView Prompt LoRA 差異亦很直接:後者由文字提示選鏡頭角度,這個版本改為輸入 azimuth / elevation / distance 等數值,所以鏡頭控制更精確。頁面亦提到可以在 3D orbit picker 加 keyframes,逐幀插值相機姿態,代表不只可做固定新視角,也可做繞拍式 camera move。

  • 基礎模型已標明為 Lightricks/LTX-2.3,授權為 Apache-2.0。
  • 主要檔案是 LTX2.3-22B_IC-LoRA-CrossView-Warp_v0.9_18000.safetensors。
  • 依賴 ComfyUI-CrossViewWarp 與 Depth Anything V2 節點提供 depth 輸入。
  • 示例包含固定視角偏移與 keyframed 軌道鏡頭,並說明輸出來自真實影片而非合成訓練片段。

這個項目目前仍是 PoC,它較偏向 ComfyUI 工作流驗證,而不是通用本地大語言模型部署。

模型

Categories: 開源, ComfyUI, AI productions, 視覺模型, 視頻模型, Video, 3D, LTX

TBSM 想把一步生成變得更實用

想要快,但又唔想靠冗長採樣或額外教師模型,TBSM正正瞄準呢個矛盾。它用一步生成處理影像與 text-to-image,取向相當鮮明。

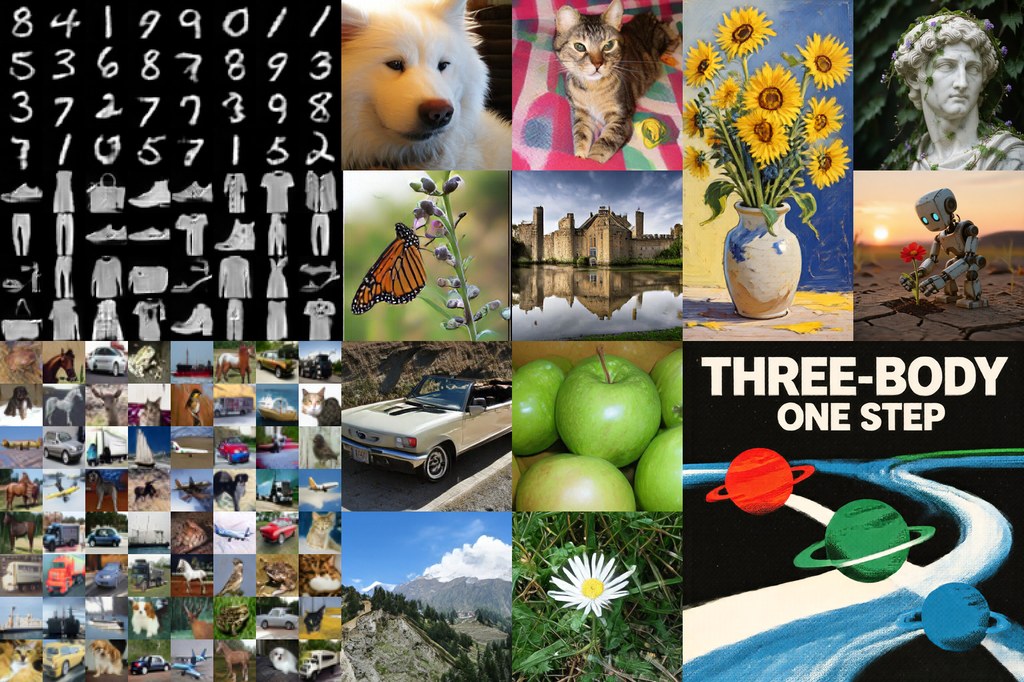
TBSM one-step samples across handwritten digits, fashion items, CIFAR-10, ImageNet, and text-to-image generation.

生成模型一路追求更快出圖,但速度一提升,訓練往往就變得更複雜。TBSM 把焦點放在one-step generation,而且唔係靠 adversarial critic、teacher queries,亦唔需要 batch-wide all-pairs field 去撐住整個流程;它屬於生成模型方法,處理的是怎樣用較直接的監督,把一次生成做得可訓練又可擴展。

這個項目的判斷重點,在於它不只是講快,而係試圖避開幾條常見路線的代價:GANs 容易受 adversarial min-max objective 影響,AR / Diffusion 要逐步解碼或反覆採樣,Drifting Models 會受 batch 規模拖高成本,diffusion distillation 又常常連帶額外模型、loss 或訓練技巧。TBSM 用 three-body scattering 連到 distributional energy,目標是把分佈層面的學習,壓成 sample-level supervision,令一步生成唔使再背住咁重的系統負擔。

它已展示多種資料與輸出空間,包括 handwritten digits、fashion items、CIFAR-10、ImageNet,以及 1024×1024 的 text-to-image。這代表它較像研究型項目而唔係即裝即用產品:你會先從 paper、示意圖與 quick start 去理解訓練與生成流程,再按資料集或任務類型測試效果,較適合有模型訓練環境的研究團隊、影像生成項目,或者想研究 one-step generation 取捨的人。

  • 核心賣點是一跳生成,不靠多步採樣換品質
  • 設計上避開 adversarial critic、teacher model 同 batch 全配對成本
  • 已展示多個資料集與 text-to-image,覆蓋面比純玩具示範更廣
  • 現階段更接近研究實驗框架,部署前要先消化方法與訓練設定

它吸引人的地方,在於把「生成速度」同「訓練系統複雜度」一齊拉入取捨表,而不只是追某個指標。現有資訊未見完整效能數字與部署細節,表示讀者現階段應把它看成值得追蹤的生成模型研究方向:概念清晰、定位明確,但要判斷是否適合生產環境,仍然要等更完整的評測與開源內容。

GitHub

Categories: 開源, Qwen, Image, txt2img

Qwen Image 3 Studio 一站式玩轉文字、影像與工具

想一次過處理聊天、讀圖、生成內容同文件分析,Qwen Studio 提供咗一個整合入口。你可以把它理解成把多種 AI 能力放入同一個工作台。

Og image

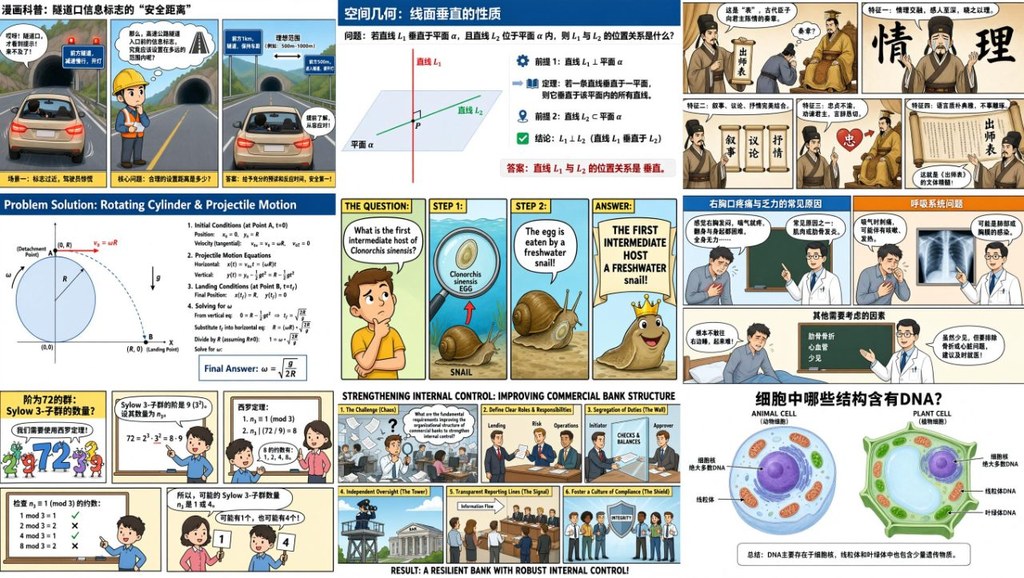
想喺同一個介面完成對話、睇圖、生成影像、處理文件,同時再配合網頁搜尋同工具調用,Qwen Studio 走的是整合式 AI 工作台路線。對一般用家而言,重點唔係逐個模型切換,而係可以較順手地喺同一流程內完成理解、生成同操作。

現有資料顯示,Qwen Studio 涵蓋 chatbot、image and video understanding、image generation、document processing、web search integration、tool utilization 同 artifacts。這種組合對內容整理、資料查找、讀圖問答,以至需要一邊對話一邊調用工具的工作流較有吸引力,因為中間少咗介面切換同上下文斷裂。

  • 把聊天、讀圖、影片理解同生成能力集中喺同一入口
  • 支援 document processing,適合處理文件內容同資料整理
  • 結合 web search integration,可補充即時或外部資訊
  • 包含 tool utilization 同 artifacts,方便延伸到更完整操作流程

目前公開內容偏向功能層面的簡介,未見更詳細的模型結構、效能指標或評測結果,所以較適合先將它理解為 Qwen 生態入面的一個綜合使用介面,而唔係單一模型發表。對想快速試用多模態模型、工具調用同線上服務整合的人,呢類入口通常更容易上手。

項目主頁

Categories: 阿里巴巴, Qwen, Video, Image, 影像模型

JoyAI-Image 想做懂空間的影像模型

JoyAI-Image唔只想生圖,仲想令模型真正理解畫面入面物件點擺位、點互相關聯。對要做指令修圖、排版生圖同多視角內容的人,呢個方向幾有參考價值。

Repository image for jd-opensource/JoyAI-Image

改圖最怕模型聽得明文字,卻改壞原本場景結構;生圖亦常見字排得唔準、物件關係走位。JoyAI-Image就係朝住呢個痛點落手,定位屬於多模態基礎模型,把影像理解、text-to-image 生成同指令式編輯放入同一個模型家族,重點處理空間理解不足帶來的失真與失控。

唔係把理解模型同生成模型鬆散拼埋,而係用 8B Multimodal Large Language Model (MLLM) 配 16B Multimodal Diffusion Transformer (MMDiT),強調理解、生成、編輯之間的閉環協作。換句話說,模型唔只讀圖後再畫圖,仲會利用視角變換等生成結果反過來補強空間推理,呢點令它在 grounded generation、關係定位同可控編輯上有更鮮明方向。

現有公開內容顯示,部署路線算完整,已提供 Hugging Face 權重、Diffusers 版本、ComfyUI 原生支援,同埋可直接參考的 workflow;另外亦有 Spatial Edit 同 General Edit 示範空間。對內容製作、電商視覺、設計流程或者研究多模態編輯的人,較值得留意的是它不只處理單次修圖,仲想處理長文字排版、版面忠實度、多視角生成,以及「指定物件移去指定位置」呢類容易出錯的操作。

JoyAI Image Edit Plus in ComfyUI - How Does it Compare?
  • 把理解、生成、編輯整合到同一條多模態流程
  • 核心賣點係較強的 spatial intelligence,而不只是畫面更靚
  • 已有 Diffusers 與 ComfyUI 兩條使用路線,測試門檻較研究原型低
  • 延伸到 OpenSpatial data engine 同 OpenSpatial-3M dataset,反映它連資料與訓練配方都一併公開

效能方面,儲存庫描述集中在能力展示與訓練設計,現階段較適合把它理解成一個方向清晰、工具鏈逐步成熟的開源影像模型項目。最吸引之處唔係單一指標,而係它把空間理解當成生成與編輯的核心能力,對需要更穩定版面、關係同位置控制的工作流,確實比單講畫質更實用。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, 視覺模型, 多模態模型, Qwen, Image, txt2img, Dataset 數據集

Sana 把高解像生成壓到快 100 倍

想做高解像圖片或影片生成,又唔想計算成本高得難以落地,Sana 提供了一條幾實際的路。它把訓練、推理到不同變體放在同一套代碼庫,重點放在速度與畫質之間的平衡。

logo

高解像圖片同影片生成最常見的卡位,不是效果做不到,而是算力、延遲同部署成本太難接受。NVlabs/Sana 屬於生成模型代碼庫,集中處理這個矛盾:在維持高解析輸出的前提下,把訓練與推理做得更省、更快,並且一路延伸到圖片、影片、世界模型等多條分支。

這個項目唔係單一模型,而是一個家族。SANA 主打最高到 4K 的 text-to-image,README 直接給出「比 Flux-12B 細 20 倍、快 100 倍」的定位;SANA-1.5 進一步處理訓練期與推理期的 compute scaling;SANA-Sprint 則把重點放在 one/few-step 生成,官方數字提到 H100 上 1024px 圖片可做到 0.1 秒級。取向很清楚:不是一味追最大模型,而是用效率換取更可部署的生成流程。

影片部分同樣值得留意。SANA-Video 與 SANA-Video 2.0 把焦點放在 720p 長序列生成,做法上用 hybrid linear attention 配合 Attention Residuals,目的是減少 full-softmax attention 的成本,同時盡量保住畫質與長序列表達能力。公開資料提到 SANA-Video 2.0 在單張 H100 上,720p/5 秒影片可做到 13.06 秒,VBench 總分 84.30,也強調比 Wan 2.2 14B 有大幅速度優勢,但這類數字仍要連同硬件、步數與設定一齊理解。

  • 同一庫內含 SANA、SANA-1.5、SANA-Sprint、SANA-Video、SANA-WM、SANA-Streaming、Sol-RL
  • 提供完整 training 與 inference pipeline,唔止展示模型效果
  • 可透過官方 demo、Hugging Face、ComfyUI 整合去理解生成表現與部署方向
  • 重點不是極限參數量,而是高解像生成的速度、成本同可擴展性

部署與測試路線相對清晰:已有官方文件、網頁 demo、Hugging Face 集合,亦見到 ComfyUI、SGLang、Replicate 等接點,代表它較適合研究團隊、影像工作流開發者,以及想把高解像生成放進產品流程的人。 SANA-WM 的 2.6B controllable world model、6-DoF camera control,同 Sol-RL 的加速收斂能力,則顯示這個項目不只做靜態出圖,而是朝更完整的生成系統推進。

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 世界模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, txt2img

SoulX-Singer 把零樣本歌聲合成

想快速試一把未見過的歌手聲線,SoulX-Singer提供咗幾近成品級嘅路線。它唔只唱得準,連跨語言同改詞後的人聲一致性都放埋入同一套流程。

SoulX-Logo

做歌聲生成,最難往往唔係「唱到」,而係未見過的聲線仍然要自然、準音、像本人。SoulX-Singer正是朝住呢個矛盾而來的開源模型項目,重點放在 zero-shot singing voice synthesis:唔使為每位歌手再微調,都可以用參考聲線配合旋律或樂譜生成歌聲。

它的定位幾清楚:一邊照顧創作控制,一邊盡量保住音色身份。你可以用 melody-conditioned 的 F0 contour 控制音高走向,亦可以用 score-conditioned 的 MIDI notes 對齊節奏與音符;對於需要改詞、換語言、保留同一把聲去做 demo、作曲草稿或虛擬歌手內容的人,這種控制方式比只靠文字描述更實際。README 亦提供 Hugging Face 模型與線上示範,部署理解上屬於下載預訓練權重後做推理的典型流程。

同類做法常見取捨,是控制愈細,聲線就愈易散;複製音色愈強,跨語言和改詞後又可能變得生硬。SoulX-Singer把 timbre 與 content 盡量拆開處理,目標是讓 Cantonese、Mandarin、English 之間仍能維持歌手辨識度,這點比單純追求「像真」更有產品意味。項目另外還有從 SoulX-Singer 微調而來的 SoulX-Singer-SVC,處理 singing voice conversion,直接由原始歌聲音訊轉換成目標歌手風格,連歌詞或 MIDI 標註都可省去。

  • 支援 F0 contour 與 MIDI 兩種控制,適合作曲草稿與精修流程
  • 主打 zero-shot,未見過的歌手聲線都可生成,減少逐人微調成本
  • 42,000+ 小時對齊人聲資料覆蓋 Mandarin、English、Cantonese
  • 可做改詞編修與跨語言合成,同時維持音色一致性
  • 另設 SoulX-Singer-SVC,補上 audio-to-audio 轉換場景

現有資料未完整列出量化指標細節,但項目已公開技術報告、arXiv 與示範頁,代表它不只停在概念展示。對音樂 AI 團隊、虛擬歌手內容製作、語音與歌聲研究者而言,SoulX-Singer吸引之處在於它把可控性、跨語言與免微調三件事放入同一條生成鏈,而限制則仍要留意倫理風險、聲線授權,以及最終作品是否需要後期混音補足細節。

GitHub · 模型

Categories: 開源, 模型, Audio, 聲效, 音樂

Page 35 of 55
1 … 33 34 35 36 37 … 55