MBM:跨類別動作轉移突破

你可以把它理解成一套跨類別影片動作轉移框架,重點是外形差很多時仍保住動作與身份。

Framework

想把一段動作搬到另一個角色或畫面,最怕形態差太遠時連身份都一併扭曲。MBM 走的是一套 motion transfer 研究框架,重點是把跨類別動作轉移做得更穩,讓 reference video 的動作可以連同 text,必要時再加一張 reference image,一起驅動生成。

它分兩段處理:Stage I 先學 heterogeneous abstract motion conditions,再 bootstrap cross-category motion pairs;Stage II 再用 raw reference videos 把這套監督內化。推理時直接靠 reference video、text 和 optional reference image,不需要 explicit motion extraction 或 test-time optimization。

它和只在相近外形之間搬動作的做法不同,目標是連 same-category、near-category 到 far-category 都盡量維持 motion fidelity 與 target preservation。資料同時提到 OpenVMT-Dataset 和 OpenVMT-Bench,前者是 instance-level motion-equivalent cross-content pairs,後者則用逐步拉大的 category gap 去測。

  • 兩階段框架先學抽象動作,再把監督內化到生成流程
  • 推理端直接吃 reference video、text、optional reference image,流程較短
  • 主打跨類別動作轉移,適合影片生成、角色動作遷移、動畫合成
  • 在大形態差距下仍可維持較好的動作保真與目標保留

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, Video, Image, 框架

LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRA、audio_proj_step_*.pt、wav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • 用 Brownian bridge 同 Bridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGE、AUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。

項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

Poplar 把人像數據集生成變成可追溯流水線

想建立可重現的人像圖文數據集,難處往往唔係生成,而係點樣保留規格、來源同質檢。Poplar正正將呢三步串成可審核流程。

Poplar teaser

生成人像圖文數據集最易失控的地方,不在於出圖本身,而在於之後很難追查提示詞有冇被改動、畫面為何被淘汰、覆蓋範圍是否足夠。Poplar把呢件事做成一條開源流水線兼框架,專注處理 human-centric image-text dataset synthesis,將 Specify、Render、Inspect 三段分開,又用 append-only JSONL 記錄每一步。

它的做法幾務實:先抽樣人物、服裝、活動、場景、取景與光線等結構化屬性,再由 Qwen3.5-27B-FP8 把規格寫成攝影導向提示詞;之後用 Krea 2 Turbo 配合 Krea2-realism-V2 生成,每個規格只出一張圖,最後再由同一個 Qwen3.5-27B-FP8 檢查圖文是否一致、是否有明顯缺陷。重點不只是「生成到」,而是連 prompt hash、seed、重試紀錄、缺陷標記同審核時間都留底。

  • 適合研究團隊、數據工程、訓練視覺模型前的數據建設工作
  • 差異在於把語意覆蓋、渲染來源與質檢決策全部做成可追溯紀錄
  • 部署門檻不算低,已發佈排程要四張 NVIDIA GPU,並需相容 CUDA 12.6 的 PyTorch 環境
  • 質量控制包含保守式 deterministic prefilter,會重試近灰階、嚴重模糊、低細節或損壞輸出

跟只看單張生成效果的做法相比,Poplar更重視整批數據集能否重現與審核,取捨是硬件需求較高,流程亦偏向資料生產而非互動創作。現有資料未見完整基準分數,但它把審核 rubric、prompt mismatch severity、evidence 與 confidence 都納入 review records,對要建立可交付數據資產的團隊,價值相當直接。

項目主頁 · GitHub

Categories: 開源, Qwen, NVIDIA, Image, Python, Dataset 數據集

UEmbed:單一模型同時做稠密與稀疏檢索

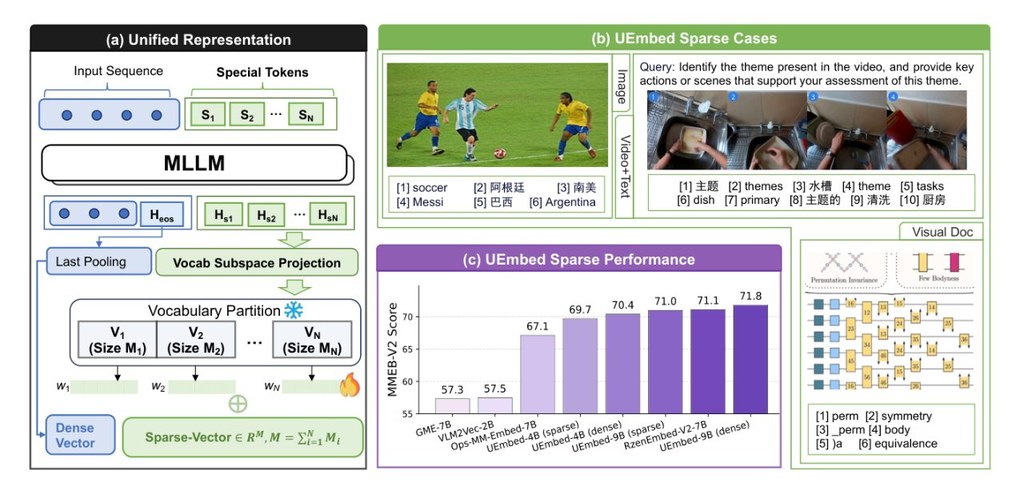
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

SwanTale 以場景佈局生成

SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

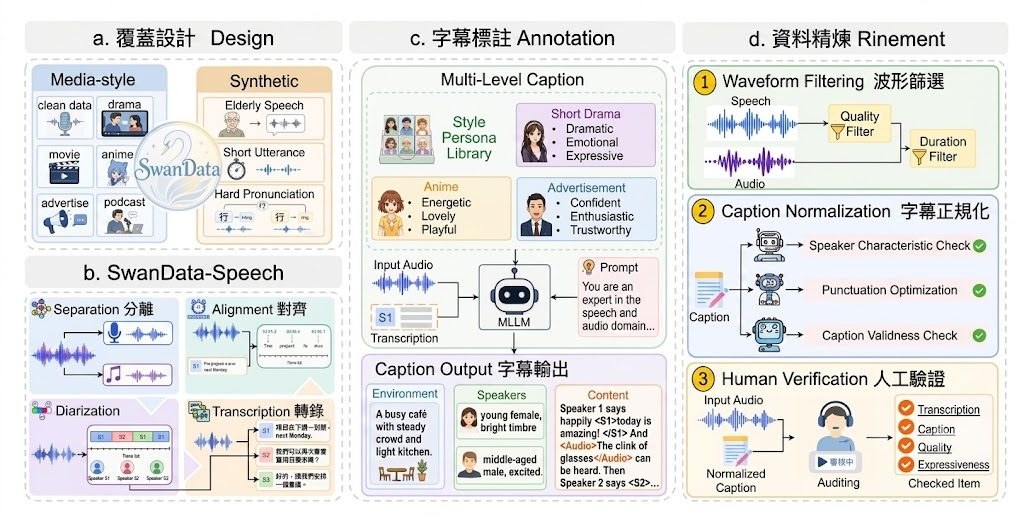
比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audio、speech 與 multi-speaker generation
  • 由 ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。

項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based on、base model 或 fine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

N0-TWAM 把觸覺帶進機械人決策

鏡頭睇到嘅畫面未必足夠,N0-TWAM連觸覺一齊預測,再生成動作。對接觸密集操作來說,這個方向比只看影像更貼近現場需要。

teaser

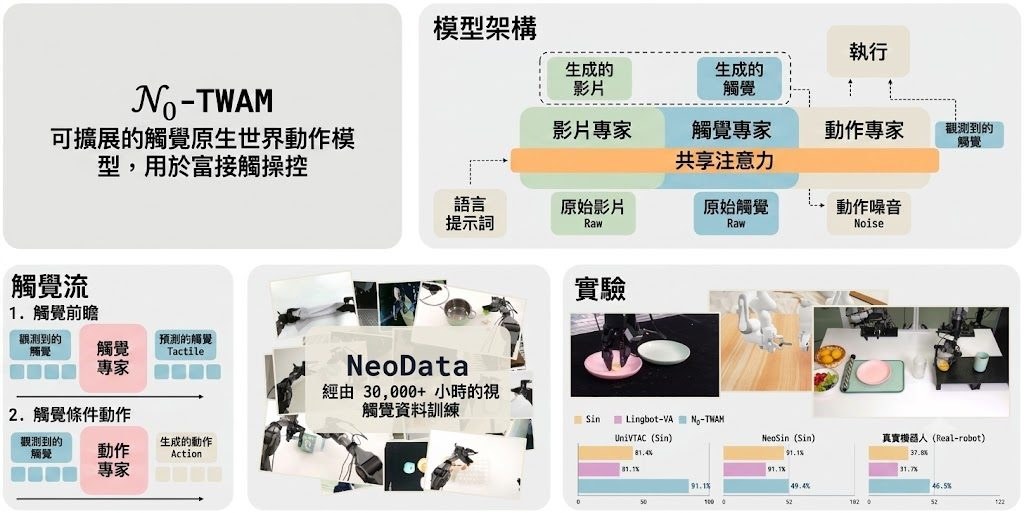
插頭有冇卡住、夾爪有冇真係受力,單靠畫面往往判斷唔完整。N0-TWAM放喺呢個空缺上處理問題:它屬於世界動作模型,將 vision、tactile 同 action 一齊建模,先推進未來會見到乜、摸到乜,再輸出低層動作,目標直指 contact-rich manipulation。

它吸引之處不只是多加一種感測,而係把觸覺當成未來狀態的一部分,而唔係事後補充訊號。相比只預測影片的 world-action model,或者直接由當前觀察回歸動作的 VLA policy,N0-TWAM更著重「預測之後再行動」;代價是系統更重,儲存庫亦只釋出 pretrained checkpoint、inference server 同 post-training toolkit,未包含大規模預訓練流程。

  • 可直接載入 pretrained checkpoint,再用自家 demonstrations 做 post-training
  • 可經 websocket 部署,由 observation 持續取回動作,也可接到自家 robot 或 simulator 做 closed-loop 控制
  • 支援 NeoSim 的 closed-loop benchmark,方便用 vision–tactile 場景驗證表現
  • 核心做法是 Mixture-of-Transformers (MoT),分開 video、tactile、action 三個 experts,再共享注意力交換資訊

模型背後沿用 WAN2.2 TI2V-5B video diffusion transformer 作 backbone,重組成三個 experts,並用 rectified-flow / flow-matching 目標聯合學習。readme 亦交代 action space 是 20-dim dual-arm end-effector,配合 tactile-aware execution,明顯不是聊天式 agent,而是面向機械臂操作與接觸控制的研究模型。

它在 UniVTAC、NeoSim 與八個 real-robot tasks 的平均成功率分別達到 84.5%、49.4% 和 46.3%。這些結果說明觸覺對高接觸操作有實質幫助;同時也要留意,部署門檻仍然偏研究導向,較適合機械人團隊、模擬環境開發者,以及已經有 demonstrations 與感測資料流的項目直接接入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 模型訓練, Video, VLA, Robotic, Dataset 數據集

Montara 本地優先影片工作台

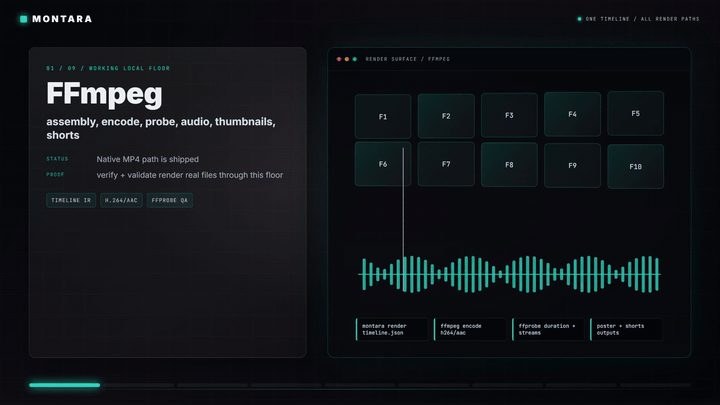
想用同一套時間軸管理生成、剪接同輸出影片,Montara 提供咗一條幾務實嘅路。它唔靠單一雲端服務,先確保你能穩定產出真正可播放嘅 MP4。

Montara engine matrix demo preview

做影片流程最麻煩,往往唔係生成一段畫面,而係素材、剪接決定、旁白、輸出格式同後續修改散落喺唔同工具。

Montara 就係朝住呢個痛點而來:一個本地優先嘅開源影片製作工具/框架,用 Timeline IR 做唯一時間軸來源,將規劃、編輯、渲染同交接串返埋。

它吸引嘅地方,在於先處理「冇雲端都要交到片」呢個現實限制。就算零 API keys,仍可經 FFmpeg 走本地 fallback 輸出可觀看 MP4,連字幕卡、語音路徑同部分媒體都預留咗本地方案;有裝 Remotion 就做 native smoke,冇裝亦會退回 FFmpeg,呢種設計比起只展示理想雲端流程嘅項目踏實得多。

同類做法常見係綁死某個生成服務或者某款剪片介面,Montara 反而把 provider 放成可插拔層,會建立 request、做 redaction、支援 dry-run 同 live-audit,但付費雲端呼叫要明確開啟。代價亦好清楚:它而家最成熟嘅係時間軸驗證、編輯操作、渲染路徑、editor bridge 匯入匯出,同埋真實 MP4 渲染與 post-render QA;README 亦講明長片規模仍屬 roadmap,唔係所有電影級工作流都已全面驗證。

  • Timeline IR 把場景計劃、剪接決定、匯入 editor cut 同生成素材收斂成一份 JSON
  • 本地路線完整,FFmpeg 係通用底線,部分 video/image/speech/music 有 fallback
  • 可匯出 EDL、OTIO、FCPXML,方便轉去 Premiere、Resolve、Final Cut 繼續做
  • provider 機制重視審計與可驗證性,適合要保留流程紀錄嘅團隊 較受惠嘅會係想把 AI 生成同傳統後期接埋嘅內容團隊、要保留本地控制權嘅創作者,或者打算讓 agent 參與影片流水線嘅開發者。

Montara 已經唔止係 demo 級拼裝,因為它把「可編輯來源」、「真實渲染結果」同「可交畀剪輯軟件接手」放埋同一條線;不過想追求高度成熟嘅長篇製作,仍要留意目前覆蓋範圍主要集中喺已測試嘅 renderer 同橋接能力。

GitHub

Categories: 開源, Agentic, API, Video, 影像處理, 框架, LTX

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

項目主頁

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

VideoCoCo 先用代碼演物理再出片

想要影片動得合理,又唔想一開始就靠像素生成碰運氣,VideoCoCo提供咗另一條路。它先把物理過程寫成可執行草稿,再交畀影像模型做寫實化。

cot paradigm

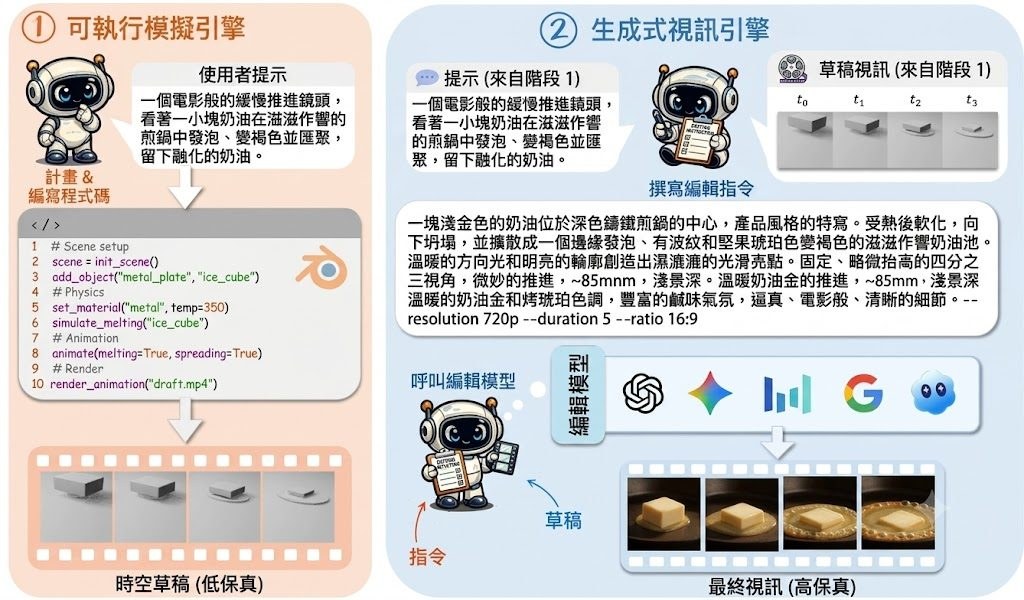
一段影片要做到「似真」並不只靠畫面細緻,動作因果同物理變化站唔站得住腳更關鍵。VideoCoCo屬於視頻生成管線,處理的正是這個問題:先用 code as a chain-of-thought 寫出物理草稿,再把中性白模影片轉成寫實結果,減少模型直接由像素猜測運動時常見的失真。

VideoCoCo 不是一步生成最終影片,而是先由 code agent 產生 Blender 可執行模擬,輸出灰白、近似 clay render 的 proxy video,讓形狀、透明度、變形、遮擋與運動先承載物理意義,之後再檢查這段草稿是否符合 physical plan,最後才用編輯指令把 proxy restyle 成 photorealistic video。這種雙階段流程換來較強的可控性,但也代表整體鏈路比單段式生成更長,對中間草稿品質有依賴。

目前 GitHub 已放出五個 Agent Skills、batch inference 腳本、對上游 OmniWeaving 的 patch,以及 Hugging Face 上的 tuned transformer;另有 8 組 hand-checked 的 video-to-video triplets 可用來理解資料格式與輸入輸出關係。README 停在 Inference 章節開頭,未見完整安裝與執行細節,所以現階段較適合把它視為可檢查流程設計與推理組件的研究型項目,而不是即裝即用的成品。

  • 先做物理草稿,再做寫實化,把運動因果同畫面風格拆開處理
  • 以 Blender 可執行代碼承載 process-level CoT,重點不在文字解釋,而在可驗證的模擬結果
  • toy dataset 只有 8 個案例,涵蓋 buoyancy、melting、surface tension、boiling 等現象,較像格式樣本
  • 已提供 tuned transformer、inference 腳本與 OmniWeaving patch,但公開資訊未足以完整重建部署流程

受益最大的會是研究 Agentic video generation、多步驟 controllable generation,或者想把物理先驗帶入視頻模型工作流的團隊。現有資料未見完整量化指標或大規模評測結果,優勢主要來自方法設計與中介表示的可檢查性;想判斷生成穩定度與泛化能力,仍要等更完整實驗或自行測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 視頻模型, Video, Dataset 數據集, Skill 技能

Page 33 of 55
1 … 31 32 33 34 35 … 55