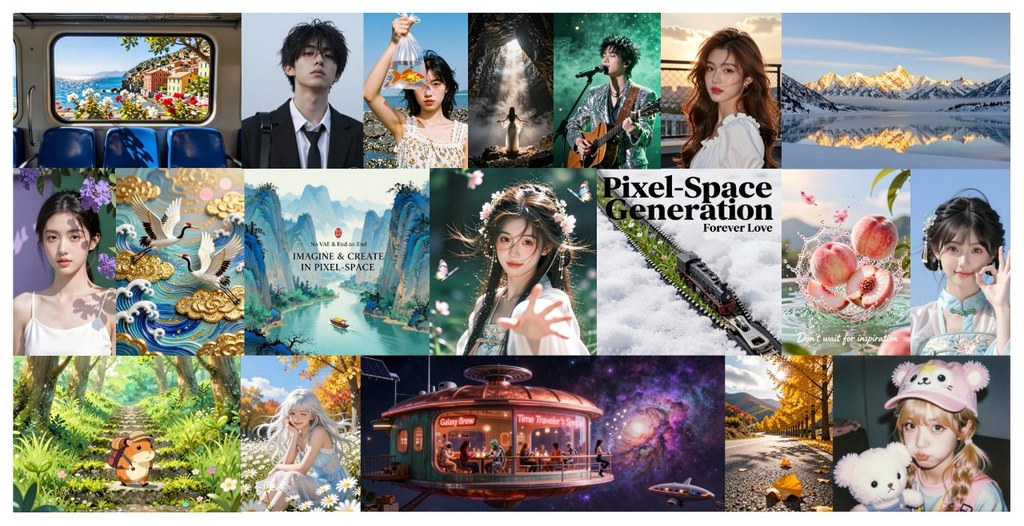
[技術文章] pixel-space 模型可以追平甚至超過 latent-space 對應模型

研究聚焦 pixel-space text-to-image diffusion models 的訓練卡位,找出點樣喺大規模條件下兼顧畫質同速度。作者用 latent-to-pixel 策略,令 pixel-space 模型更接近甚至超過 latent-space 表現。

Hero image preview

上圖是透過 pixel-space text-to-image diffusion models 的方法訓練的 Z-Image-Turbo (Pixel) 產生的圖像。在企業級 H800 GPU 上,推理延遲僅約 0.2 秒。

Pixel-space text-to-image diffusion models 一直有兩個吸引位:直接生成像素,唔受 VAE 壓縮上限限制,亦可以省去解碼步驟。但喺大規模訓練下,佢哋收斂速度明顯慢過 latent-space 模型,令「畫質、效率、可訓練性」三者之間嘅平衡一直唔夠成熟。

呢篇工作針對嘅正係呢個落差。作者先比較 pixel-space 同 latent-space 喺大規模 pre-training 下嘅行為,再提出 latent-to-pixel 策略:先喺 latent space 學到生成先驗,再轉去 pixel space 做 post-training,避免一開始就喺難度更高嘅像素空間硬推。

佢哋亦系統研究咗多個轉換設計,包括 weight initialization、data composition、prediction target、decoder architecture 同 noise schedule,整理出一套可行做法。結果顯示,做法調整得當之後,pixel-space 模型可以追平甚至超過 latent-space 對應模型,推理端仲有 3.18 到 4.75 倍嘅速度提升。

  • 直接處理 pixel-space diffusion models 喺大規模訓練時收斂慢嘅問題
  • 用 latent-to-pixel 路線,先學先驗,再轉入像素空間微調
  • 檢視多個關鍵訓練選項,搵出實用 recipe
  • 在畫質不退讓之下,換取更快的 end-to-end inference
  • 對想做高效文生圖系統、又在意生成細節保留嘅團隊最有參考價值

Paper

Categories: 香港科技大學, 南京大學, 阿里巴巴, 模型, 模型訓練, Image, txt2img, 香港

GenRouter AI 圖像生成變成會分流的工作流

它把 agentic image generation 由單一路徑改成可分流的工作流,按任務難度配對不同執行方案。對要兼顧畫質、文字準確度同運算成本的團隊,這種做法比硬套同一套流程更有彈性。

Figure1 00

安裝方式偏向研究原型工作流,先建立 environment.yml 對應的 Conda 環境,再按 scripts/services/scripts/serve.sh 需要下載本地模型。README 亦提到 OneIG 同 WISE 有獨立環境,代表它不是單一命令就能完整跑通的輕量工具,而是要跟着項目內的服務配置同基準測試流程去部署。

GenRouter 處理的不是單純「生成得靚唔靚」,而是把不同提示詞導向不同算力配置。當任務涉及多步空間推理、精準文字渲染,或者需要較高視覺質素時,GenRouter 會揀更合適的執行計劃;較簡單的請求則不必走沉重流程,這種取捨直接針對延遲同成本問題。

  • GenCanvas 將 agentic image generation 拆成通用原語,方便重用工作流
  • GenRouter 以需求分析、記憶輔助匹配同 Pareto filtering 做路由
  • 目標是減少「一刀切」流程造成的算力浪費
  • 比較適合做圖像代理、生成管線同研究型系統的團隊
  • README 未見完整公開的數值結果摘要,較適合當作框架型項目理解

GitHub

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, Qwen, Image, 影像模型

NaviDC-OCR:1.2B 參數文檔 VLM,統一處理相機與數碼文件

NaviDC-OCR 把文件理解收斂到一個輕量 Vision-Language Model(VLM)流程,對掃描件和手機拍攝文件都能一起處理。它的重點不只在識別文字,還在版面、表格與公式之間的結構還原。

icon

NaviDC-OCR 是一個輕量級 Vision-Language Model(VLM),專門處理 document understanding,也就是把文件內容、版面和結構一併讀出來。它最實際的價值,在於同時應付 digital documents 和 camera-captured documents,尤其適合文件拍攝角度不正、透視變形或版面較複雜的情境。

這個項目已釋出模型權重與 technical report,使用方式偏向直接載入 Hugging Face 上的模型做推理或再訓練,而不是一套獨立應用程式。它的訓練流程結合 Multi-node Consensus Voting(MCV)、Image-to-Image Self-Verification,以及 progressive four-stage training,顯示作者把大量標註成本轉移到自動化資料整理與驗證。

  • 1.2B 參數,定位是輕量部署而非堆大模型。
  • 同時面向掃描文件與相機拍攝文件,覆蓋範圍比只做單一路徑的做法更廣。
  • Geometry-aware Document Modeling 與 Curvature-Guided Douglas-Peucker Sampling(CGDP)主要針對彎曲、傾斜和變形頁面。
  • Content-Structure Decoupled Learning 令表格與公式的內容和結構分開學,較適合複雜文件。
  • 作者聲稱在多個 benchmark 上有強表現,但具體部署成本仍要視推理框架與硬件而定。

和不少只偏重 OCR 文字抽取的做法相比,NaviDC-OCR 更像是把「看懂文件」放在第一位:它不只要讀字,還要保留版面關係與幾何資訊。這會令它在企業文件處理、票據整理、表格抽取、學術文件解析,或者手機拍照掃描的工作流裡更有用,但它仍然是研究型模型,落地時要留意速度、記憶體與實際文件分佈是否接近訓練資料。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, Dataset 數據集

S²VOPD 讓小模型看少一點,Qwen3.5-4B 反而看得更準

S²VOPD 透過削弱學生模型的視覺資訊,在零標註下提升細粒度感知與數學推理表現。

UC San Diego

小模型面對圖片時,減少它能看到的資訊,竟然可以帶來更好的學習訊號。Self-Supervised Visual On-Policy Distillation(S²VOPD)是一種視覺模型訓練方法,透過讓學生模型觀看低解析度、加入隨機 Gaussian noise 的圖片,處理沒有標註、獎勵或更強教師模型可用的限制。

訓練期間,學生模型會根據受干擾的圖片產生回答;採用 Exponential Moving Average(EMA)的教師模型則以原始圖片評分相同的生成前綴,再利用 top-k generalized Jensen-Shannon divergence(JSD)把較完整的 token 分佈傳給學生。教師與學生之間的資訊差異,來自學生少看一點,而不是額外加入 privileged information。

• Qwen3.5-4B 在六項細粒度感知基準的平均準確率,由 70.7% 升至 77.4%
• 4B 模型表現高於 Qwen3-VL-Instruct-235B 的 75.8% 和 GPT-5.4 的 72.8%
• 不需要 labels、rewards、region annotations 或更強教師模型
• 4B 同時提升感知表現 5.7% 和數學推理 3.7%

S²VOPD 使用學生視角縮放至原圖 0.3 至 0.6 倍,並加入 stochastic Gaussian noise。結果顯示,這種做法不只改善視覺感知,也能避免部分 privileged-information 方法在數學推理上的退步;例如 Oₚₛd 和 ZwZ 在部分 MathVision、MathVerse 測試中出現明顯下降。

這項方法較適合研究小型多模態模型訓練、視覺推理和自監督學習的讀者。現有結果集中於六項細粒度感知基準及數學推理測試,能否穩定延伸至其他資料、模型架構和更複雜影像任務,仍需要進一步驗證。

項目主頁

Categories: 開源, 模型訓練, Qwen, Image, Dataset 數據集

S2R 用物理模擬解決影片反光

隔住玻璃拍片常見嘅反光,會令畫面難睇又影響後續辨識。S2R 把合成、去反光同評測串成一條流程,重點是先補足可信訓練資料。

Og image

隔住玻璃拍攝時,反光往往唔只影響觀感,仲會干擾偵測、辨識同追蹤等後續視覺工作。S2R 屬於影片去反光項目,重點唔係單靠清理單幀畫面,而是同時處理資料不足、時間連貫性同評測基準缺位三個卡位。

呢個項目用一個閉環流程連接 S2R-Synthesis、S2R-Removal 同 S2R-Benchmark。前段先以 Physics-Grounded Augmentation 與影片擴散生成方法合成成對影片,控制玻璃粗糙度、反射率、厚度等性質;後段再把 pretrained video diffusion prior 調整成適合去反光的模型,加入 reflection-aware latent adaptation 同 one-step pixel-geometric refinement,減少殘影並維持時序一致。

它跟常見做法最大分別,在於先把反光結構同外觀拆開處理。S2R-Synthesis 會從 FLUX-generated pseudo videos 學習較真實的反光外觀,再把兩段乾淨影片經 Physics-Grounded Augmentation 融合,生成可配對訓練資料,避免只靠傳統合成或少量真實資料,令模型較難學到穩定的影片反光模式。

  • 用物理約束方式合成反光影片,補足 paired video data 不足
  • 以 diffusion-based video dereflection 處理影片,強調跨幀一致性
  • 提供 S2R-Benchmark,兼顧 full-reference 評估同真實場景人類感知評估
  • 在 OpenRR-1k 的結果中,加入完整 PGA 後,PSNR 與 SSIM 都比基線再提升

現有資料顯示,S2R 特別適合需要穿玻璃拍攝的內容整理、監控視覺流程,或者任何重視畫面可讀性與後續分析品質的工作流。項目亦反映一個明確取捨:先花力氣建立可信的反光合成與評測系統,再用 diffusion-based 方法做移除,換來較完整的訓練閉環,但最終表現仍會受真實場景複雜反射型態影響。

項目主頁

Categories: Stable Diffusion, Video, Image, 框架, Dataset 數據集, 小米-Xiaomi

LTX-2.5 原生多鏡頭、4K HDR,一次看懂升級重點

LTX 最新開源基礎模型 LTX-2.5,主打原生多鏡頭銜接、4K HDR,並降低重試與算力成本,繼續走開放權重路線。

LTX-2.3 Examples Video

如果你是用開源模型做影片生成的開發者,LTX-2.5 這次更新解決的卡位頗明確:人物、環境、光線與聲音在多鏡頭之間斷裂的問題。它把多鏡頭生成變成原生能力,並加入自動時長預測,模型會按指令動作自行決定片段長度,省下人手剪接的麻煩。

對比起多數只能透過後製拼接的同類方案,LTX-2.5 在 prompt 跟隨度上也有明顯進步,能夠處理更複雜的創作指示,而且只需要更短的提示詞就能產生穩定結果。配合新的擴散影片解碼器,動態假影更少,畫面在高解析度與 HDR 下仍能逐格保持質感。

本地部署與微調是這次版本延續的核心承諾:開源權重可直接下載,預訓練基礎模型可在自家做 LoRA 微調,產出與後製則支援原生 RAW workflow,貼近專業調色與剪接流程。

從官方比較表來看,目前維持開放權重且不受地區限制的開源視頻生成選擇仍然有限,這也是 LTX-2.5 在定位上最值得留意的差異化。不過實際表現仍需視本地硬件配置與工作流整合程度而定。

重點摘要

  • 原生多鏡頭生成:人物、環境、光線與聲音在不同鏡頭間保持一致。
  • 自動時長預測:依據動作需要自動決定片段長度。
  • 4K HDR 與原生 RAW:支援專業調色與後製 pipeline。
  • Gemma 4 12B 文字編碼器:搭配自研提示詞增強器,提升 prompt 跟隨度。
  • 開源權重可下載:可在本地硬件運行,並支援 LoRA 微調。

項目主頁

Categories: 開源, AI productions, 數字人, 多模態模型, 視頻模型, 模型訓練, Video, Image, LTX

Meta Muse Glimmer:為本地多模態代理而生

Muse Glimmer 30B 針對本地部署而設,把圖文理解和代理式操作放在同一個模型裡。它同時提供 BF16、GGUF 與 ExecuTorch 版本,方便不同裝置取用。

Meta

Muse Glimmer 30B 屬於多模態 agentic model,重點放在本地部署時的可用性。對需要在自己裝置上處理圖文輸入、又想保留代理式工作流的用戶來說,這種設計比只提供單一格式的模型更實用,因為可以按硬件環境選擇合適版本。

Meta 這次一口氣放出多種包裝,包括 BF16 權重、GGUF k-quants、ExecuTorch builds,還有一個較細的 assistant 版本。這代表它不是只面向單一推理環境,而是嘗試覆蓋桌面、本地推理引擎,以及流動裝置部署等不同需求。

從現有資訊看,Muse Glimmer 的核心價值在於把多模態能力和本地執行的彈性結合起來。GGUF 版本方便在本地執行推理,ExecuTorch 版本則指向更輕量的裝置端部署;對想控制資料流向、減少依賴雲端服務的工作流,會更有吸引力。

  • 支援多模態輸入,適合圖文混合任務
  • 針對 local deployment 設計,部署選擇較多
  • 提供 BF16、GGUF k-quants、ExecuTorch 等不同格式
  • 有 30B 主模型與較小的 3B assistant 版本
  • 適合需要本地推理、裝置端或代理式工作流的場景

現時公開資料較集中在模型包裝與部署形式。就定位而言,它更像是一個面向實用部署的多模態模型系列,而不是只靠單一規格吸引注意的發佈。

項目主頁 · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, API, Image, LLaMa, 安全, Meta

MiniMax H3 Turbo:4 步加速的影音生成 LoRA

MiniMax H3 的 ComfyUI 加速 LoRA,把 10 秒影片生成壓到固定 4 步。它適合要在速度、畫質和可控性之間取平衡的 T2V 與 I2V 工作流。

Og image

MiniMax H3 Turbo 走的是 ComfyUI 用途的加速路線,核心價值在於把 MiniMax H3 的文本生成影片(Text-to-Video, T2V)和圖像轉影片(Image-to-Video, I2V)流程固定到 4-step Euler 推理。它不是獨立模型,而是要配合 Comfy-Org/MiniMax-H3 的 BF16 base model 使用;頁面未提供更完整的 base model 參數規模或訓練細節,所以不能再往下猜。

這種設計的取捨很直接:步數少,生成時間通常更短,但對動作細節和穩定性的容錯也會更窄。頁面列出的比較都在同一個 BF16 base model、同一輸入與 10 秒、約 0.9MP 解析度條件下做,LoRA strength 固定 1.0;不同場景下,時間大概落在 174 到 190 秒之間,速度提升存在,但不是壓倒性。

重點摘要:
– 支援 T2V 與 I2V,I2V 走第一幀路徑,亦可用最後一幀收尾
– 固定 4-step Euler,重點是縮短推理流程而非擴大模型能力
– 需要配對 Comfy-Org/MiniMax-H3 的 BF16 base model
– 頁面未列出 GGUF、mmproj、上下文長度或量化檔案資訊
– 與 lightx2v LoRA 的比較屬同級加速方案,差距主要體現在時間與輸出取向

從檔案描述看,這個項目是 LoRA,不是完整 diffusion checkpoint,所以它的定位比較像「推理策略補丁」而不是全新模型。頁面也沒有提供 llama.cpp、Ollama 或 LM Studio 的支援資訊,顯示它主要面向 ComfyUI 工作流,而不是通用本地推理框架。

檔案命名上,頁面強調這是 v2 類型的更新版本脈絡;因此可確認的只有它圍繞 H3 的 joint audio-video diffusion path,並以固定 4 步作為加速契約。若要和原始 base model 比,差別不在功能範圍,而在於把生成速度和步數控制收緊,換取更快的工作流回饋。

模型

Categories: 開源, ComfyUI, 數字人, 視覺模型, 視頻模型, Video, Image, Audio, MiniMax

UA-NWM 不確定性無人機導航

無人機朝目標圖片飛行,最難唔係預測一條路,而係判斷目標畫面是否仍屬合理路徑。UA-NWM 解決「模型解釋唔到」的誤差。

Repository image for DurYi/UA-NWM

戶外無人機導航最易出錯的位置,在於前方畫面未必只有一種合理變化。UA-NWM 把這個問題當成 world model 的評分工作處理,面向 aerial image-goal navigation,唔再只估一個未來畫面再同目標硬碰硬,而係判斷目標圖片是否落在模型預測的未來狀態分佈之內。

它最值得留意的技術點,是用 Hierarchical Error Projection(HEP)把預測與目標之間的差距拆成可由不確定性子空間解釋的部分,同埋解釋唔到的殘差,最後只用後者作為 trajectory cost。呢種做法同單點預測式 ranker 的分別很直接:同樣見到偏差,UA-NWM 會先問偏差是否屬於合理未來變化,而唔係一概當成走錯路。

模型本身會預測未來的 DINO latent features,配合 deterministic future feature map 同 uncertainty subspace 做單次 forward scoring,避免靠隨機抽樣多個未來狀態先完成比較。同一個 checkpoint 可配合兩種 inference strategy,包括 uncertainty-aware 的 UA-NWM 與 deterministic baseline,適合研究團隊直接比較兩種評分邏輯帶來的差異。

  • 適合 UAV 導航、戶外機械人感知,以及要由目標圖片反推行進路線的團隊
  • 重點唔係生成最像的未來畫面,而係判斷目標是否仍在合理未來分佈內
  • 提供 AirGoal-10k 的 training、evaluation、trajectory ranking、CEM/MPC planning 與 visualization workflow
  • deploy/ 內有真實部署用的 server-side policy wrapper,但原始資料未完整交代整套部署步驟

它已對應 AirGoal-10k,並包含真機 UAV demo、資料集連結與 pretrained checkpoints;受益最大的是需要處理大範圍戶外場景、多解未來觀測,以及想把 world model 直接接到規劃器如 CEM/MPC 的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 世界模型, 模型訓練, Image, Dataset 數據集, 百度

Wan-Animate-2 把角色動畫推向即時互動

同一張角色圖,已經可以跟住驅動影片做出更穩定動作,連鏡頭角度都可另外控制。Wan-Animate-2想解決的,不只是畫面靚唔靚,仲包括直播同數字人能否即時用。

Og image

一張角色圖片配合一段驅動影片,便可以生成動作自然、表情細緻的角色動畫,這正是 Wan-Animate-2 想處理的核心場景。它屬於角色動畫生成框架,重點不只放在畫質,還試圖解決身份容易走樣、動作細節流失,以及難以支援即時互動這幾個長期卡位。

跟不少依賴中間動作表示的方法不同,Wan-Animate-2 直接把 driving video 餵入重新設計的 Diffusion Transformer,避開 motion extractor 帶來的誤差與 identity drift。這種端到端做法的好處,是角色外觀保持得更穩,細微表情、複雜肢體動作,甚至角色與場景之間較合理的互動,都更容易保留下來。

它另一個值得留意的能力,是加入 text-driven viewpoint control,令輸出鏡頭角度可以跟驅動影片分開控制。對數字人、直播主持、虛擬角色演出這類互動工作流來說,這代表同一段驅動內容不一定要綁死原本視角,使用時更容易配合不同畫面需求。

  • 直接使用 driving video,而不是先抽取中間動作表示
  • 主打更穩定的 identity preservation 與 motion fidelity
  • 支援 text-driven viewpoint control,可分離鏡頭視角與驅動動作
  • 推出 Wan-Animate-2-Lite,目標是把推理延遲壓到即時門檻
  • 預告公開 Wan-Animate-2-Base 權重,方便社群延伸研究

為了走向即時應用,團隊亦提出 Wan-Animate-2-Lite,並用三階段訓練流程去降低 inference latency,包括 teacher forcing pretraining、error buffer mechanism,以及 Self-Forcing distillation 配合 chunk-wise backpropagation。現有結果與使用者研究顯示,它在多種角色和動作模式下都有不錯的高保真表現;不過目前公開資訊仍以研究展示為主,部署成本、硬件需求與長時間串流穩定性,仍要等更多公開細節驗證。

項目主頁

Categories: 阿里巴巴, 視覺模型, Video, Image, 動畫

Page 5 of 16
1 3 4 5 6 7 16