ComfyUI-MiniMaxH3-Easy:幫 H3 補回可用性

把 MiniMax H3 放進 ComfyUI 後,最麻煩的接線、引用同提示編排,被整理成較順手的一套介面。

Mixed media input

做影片生成時,最阻手往往唔係模型能力,而係節點圖愈接愈亂、參考素材愈加愈難管理。ComfyUI-MiniMaxH3-Easy 屬於 ComfyUI 自訂節點工具,集中處理 MiniMax H3 的 text-to-video、image-to-video 同 reference-to-video 工作流,將原本分散嘅媒體接線、參考標記同提示編輯收埋到同一個操作面。

呢個項目最實際嘅改動,在於保留 ComfyUI 彈性之餘,減少你每次都要手動整理素材順序。主節點用一個 Media 輸入口同時接收圖片、影片同音訊,仲會分開追蹤各自次序;一張圖會走 image-to-video,兩張圖就可用作 first/last-frame generation。做 reference-to-video 時,提示編輯器支援 @ 揀選已連接素材,執行時再自動轉成 MiniMax 建議嘅 <Picture N><Video N><Audio N> 格式,唔使自己逐個標籤維護。

  • 將多種媒體收進單一 Media 入口,節點圖會乾淨得多
  • @ 參考編輯器有預覽,較適合需要反覆改 prompt 嘅影片生成流程
  • # 對話區塊可直接寫成可編輯 block,送出時自動轉成 <d>...</d>
  • 可接 model-only LoRASage Attention patch,亦可直接連到模型相關節點

同類做法通常要求使用者自己記住引用格式、接線順序同素材對應,ComfyUI-MiniMaxH3-Easy 選擇用較重介面包裝,換來較低出錯率同較高可讀性。代價亦明顯:它改善嘅係 MiniMax H3 在 ComfyUI 入面嘅操作層,不是另起一個新模型,也未見提供生成品質、速度或資源佔用測試數字,因此價值主要落在工作流整理,而唔係模型性能突破。

較受惠嘅會係已經用開 ComfyUI、但又嫌 MiniMax H3 節點圖太碎太亂嘅創作者、影片實驗團隊同需要反覆比對參考素材嘅人。部署方式亦唔複雜,理解上可以當成安裝到 ComfyUI 內嘅一組工作流節點:接好模型或 LoRA、把圖片或影片餵入 Media、再用內建編輯器整理引用同對話內容,就可以直接進入生成流程。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

MiniMax H3:全模態影音生成說明書

MiniMax H3 把文字、圖片、影片與聲音整合到同一套生成流程,並支援同步影音輸出。

Og image

MiniMax H3 面向需要由多種媒體素材生成影片的場景,輸入可包括文字、圖片、影片及聲音,輸出則涵蓋影片與同步音訊。它屬於通用 omni-modal generative system,並非只處理 text-to-video,亦標示支援 image-to-video、video-to-video、audio-to-audio-video 等流程。提供的內容未載明它基於哪個 base model,亦無法確認是否由其他模型 fine-tuned from。

這種統一處理方式適合將參考圖片、動態片段或聲音一併納入生成條件,減少工作流程需要分拆成多個模型的情況。metadata 指向 Diffusers,並列出 multimodal、synchronized-audio-video 及 reference-to-audio-video 等能力;不過目前資料未交代模型架構、參數規模、上下文長度、訓練方法或效能指標。

可留意的使用重點包括:
– 支援 text-to-video、image-to-video、image-text-to-video 及 video-to-video。
– 可處理文字、圖片、影片與音訊,並生成 audio-video 組合內容。
– 提供 Global 與中國地區的 Online API,以及 Hailuo AI 網頁和桌面 App。
– 標示使用 MiniMax H3 Community License Agreement,部署前應查閱 LICENSE。

項目主頁

Categories: 開源, 多模態模型, 視頻模型, Video, Image, Audio, 3D, Ollama, MiniMax

ComfyTV 把 ComfyUI 拉進完整媒體工作流

想用 ComfyUI 做圖、剪片同整理素材,通常要在多個介面之間跳來跳去。ComfyTV 把這些步驟收進同一個畫布,重點不只生成,仲包括挑選、編修同輸出。

ComfyTV canvas overview

做生成內容唔少人最怕流程一長就難改、難追版本,ComfyTV 針對的正是這個卡位。它屬於建基於 ComfyUI 的畫布式媒體工作台,將生成、挑圖、編輯、合成到輸出串成同一條流程,處理範圍橫跨 image、video、audio、music、panorama、2D layers 同 3D,而唔係停留喺單次出圖。

跟一般要靠 ComfyUI 全域 queue 推整條鏈不同,ComfyTV 採用 per-node run,每個 stage 可以獨立重跑,下游只會接住上游最近一次輸出的 snapshot。這種做法減少反覆測一小步時牽動全流程的等待,代價是你要更清楚每個節點當下吃的是哪個版本輸出,但對長流程調整明顯更順手。

它的另一個重點是以項目為中心管理素材與歷史。每個 stage 都掛在同一個項目內,輸出會連同歷史保留,重新載入後可還原;再加上 asset library、resource library 同 prompt fragments,可直接在提示詞用 @ 引用。README 亦提到可匯入任何 ComfyUI workflow JSON,在側邊欄綁定輸入、保存 stage preset,並透過 Bridge nodes 接第三方插件,甚至登記遠端 ComfyUI 機器做 runner。

內容深度比一般前端殼再走前一步,現時提供約 190 個 stages,而且不少節點內置真正編輯器,例如 layer editor、storyboard workbench、piano rolls、3D viewports 同 scopes,部分 video effects 亦有 live preview。2D 編輯一段還延伸到 PSD import/export、Fountain script import 這類偏製作流程的功能,顯示它瞄準的是需要持續迭代的創作項目,而唔係一次性玩效果。

  • 把 ComfyUI 擴展成完整媒體工作台,覆蓋生成、編修、合成與輸出
  • per-node run 減少重跑整條流程的等待,適合長鏈路反覆微調
  • 以項目保存 stage 歷史、素材與資源,較方便追版本同回復狀態
  • 可匯入 ComfyUI workflow JSON,兼容 subgraphs、第三方 plugins 同遠端 runners
  • 約 190 個 stages,加上節點內編輯器,定位比純工作流編排器更完整

它依賴你現有的 ComfyUI 生態與本地模型,較像建在 ComfyUI 之上的創作界面層,而唔係獨立模型服務。適合已經有一批 workflows、想將 image、video、audio 放入同一項目管理的團隊或創作者;純粹只求最快出一張圖的人,未必需要它這麼重的工作台結構。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, 3D,

free-claude-code:一個代理層打通 Claude Code 與 Codex

想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。

用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。

它的價值在於工作流幾乎唔使重學。你可以照用 fcc-claudefcc-codexfcc-pi 啟動對應代理,Windows 同 macOS 亦可放在背景執行,再到本地 Admin UI 揀選並驗證供應商。可在 31 個 cloud 與本地 providers 之間切換,亦可把 Fable、Opus、Sonnet、Haiku 同 fallback 流量分別導向不同模型,這點對想控制成本、速度同能力分工的團隊幾實用。

跟直接綁死單一 API 的做法相比,這個項目押注在「保留原生客戶端體驗,再用 proxy 抽換後端」。代價是相容性要靠代理層維持,所以它明確強調只會在兼容模型上保留 streaming、tool use、reasoning 同 image input;換句話說,模型可揀得更自由,但不是每個後端都保證功能完全一致。

  • 支援 Claude Code、Codex、Pi,同時保留各自原生 model picker
  • 透過本地 Admin UI 管理與驗證 31 個 cloud/本地 providers
  • 可把不同流量類型分流到不同模型,方便平衡成本與能力
  • 適合想用本地模型、付費模型或免費模型混搭的開發團隊

安裝與測試方式偏向開發者工具鏈:項目以 Python 3.14、uv、Pytest、Ruff、Ty 組成,部署重點不是雲端託管,而是先在本機跑起 proxy,再讓代理客戶端經它連線。現階段最適合已經在用 Claude Code 或 Codex、又想統一管理模型入口的人;追求零設定即用的讀者,會覺得它比較像一層需要自己維護的基建。

GitHub

Categories: 開源, NVIDIA, API, Image, 工具, IDE, Mac, Python, 編程, Anthropic, UI/UX

MBM:跨類別動作轉移突破

你可以把它理解成一套跨類別影片動作轉移框架,重點是外形差很多時仍保住動作與身份。

Framework

想把一段動作搬到另一個角色或畫面,最怕形態差太遠時連身份都一併扭曲。MBM 走的是一套 motion transfer 研究框架,重點是把跨類別動作轉移做得更穩,讓 reference video 的動作可以連同 text,必要時再加一張 reference image,一起驅動生成。

它分兩段處理:Stage I 先學 heterogeneous abstract motion conditions,再 bootstrap cross-category motion pairs;Stage II 再用 raw reference videos 把這套監督內化。推理時直接靠 reference video、text 和 optional reference image,不需要 explicit motion extraction 或 test-time optimization。

它和只在相近外形之間搬動作的做法不同,目標是連 same-category、near-category 到 far-category 都盡量維持 motion fidelity 與 target preservation。資料同時提到 OpenVMT-Dataset 和 OpenVMT-Bench,前者是 instance-level motion-equivalent cross-content pairs,後者則用逐步拉大的 category gap 去測。

  • 兩階段框架先學抽象動作,再把監督內化到生成流程
  • 推理端直接吃 reference video、text、optional reference image,流程較短
  • 主打跨類別動作轉移,適合影片生成、角色動作遷移、動畫合成
  • 在大形態差距下仍可維持較好的動作保真與目標保留

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, Video, Image, 框架

Poplar 把人像數據集生成變成可追溯流水線

想建立可重現的人像圖文數據集,難處往往唔係生成,而係點樣保留規格、來源同質檢。Poplar正正將呢三步串成可審核流程。

Poplar teaser

生成人像圖文數據集最易失控的地方,不在於出圖本身,而在於之後很難追查提示詞有冇被改動、畫面為何被淘汰、覆蓋範圍是否足夠。Poplar把呢件事做成一條開源流水線兼框架,專注處理 human-centric image-text dataset synthesis,將 Specify、Render、Inspect 三段分開,又用 append-only JSONL 記錄每一步。

它的做法幾務實:先抽樣人物、服裝、活動、場景、取景與光線等結構化屬性,再由 Qwen3.5-27B-FP8 把規格寫成攝影導向提示詞;之後用 Krea 2 Turbo 配合 Krea2-realism-V2 生成,每個規格只出一張圖,最後再由同一個 Qwen3.5-27B-FP8 檢查圖文是否一致、是否有明顯缺陷。重點不只是「生成到」,而是連 prompt hash、seed、重試紀錄、缺陷標記同審核時間都留底。

  • 適合研究團隊、數據工程、訓練視覺模型前的數據建設工作
  • 差異在於把語意覆蓋、渲染來源與質檢決策全部做成可追溯紀錄
  • 部署門檻不算低,已發佈排程要四張 NVIDIA GPU,並需相容 CUDA 12.6 的 PyTorch 環境
  • 質量控制包含保守式 deterministic prefilter,會重試近灰階、嚴重模糊、低細節或損壞輸出

跟只看單張生成效果的做法相比,Poplar更重視整批數據集能否重現與審核,取捨是硬件需求較高,流程亦偏向資料生產而非互動創作。現有資料未見完整基準分數,但它把審核 rubric、prompt mismatch severity、evidence 與 confidence 都納入 review records,對要建立可交付數據資產的團隊,價值相當直接。

項目主頁 · GitHub

Categories: 開源, Qwen, NVIDIA, Image, Python, Dataset 數據集

UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

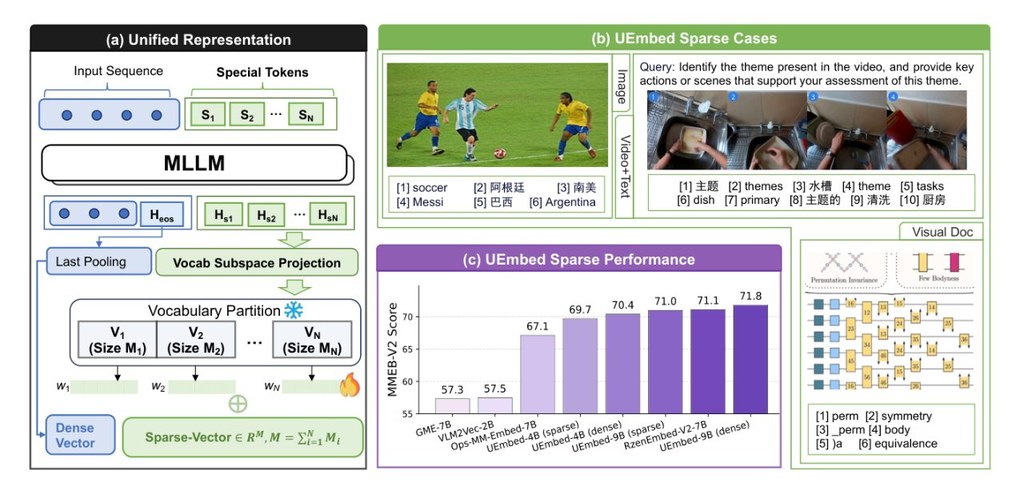
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based onbase modelfine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

RefCaptioner:參考圖綁定對應影片字幕

RefCaptioner唔只寫影片字幕,仲會清楚標示句中描述對應邊張參考圖。對要處理多視角人物或混入干擾圖的情境,呢種做法實用得多。

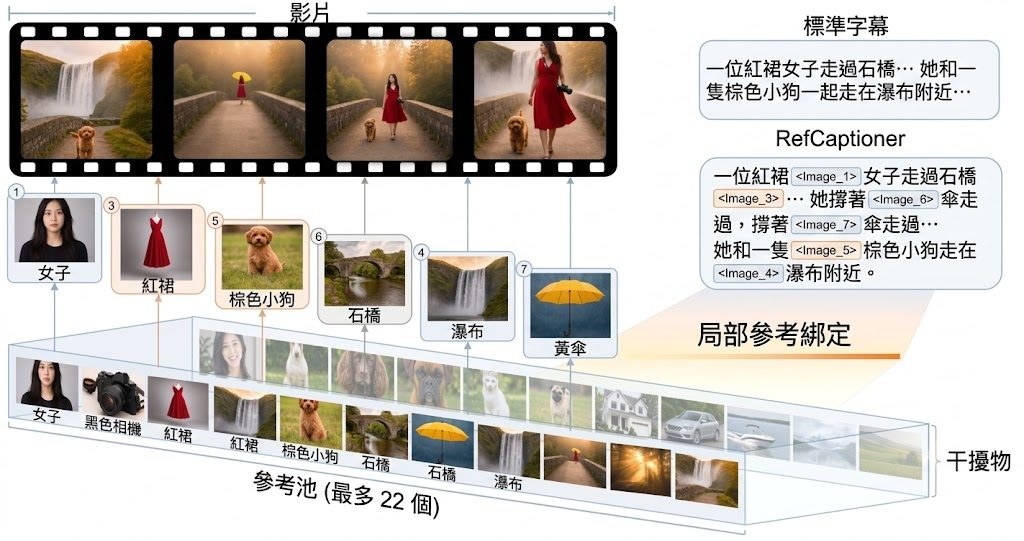
RefCaptioner grounds local caption phrases to relevant reference images while rejecting distractors.

做影片描述時,最易出錯唔係句子寫得唔夠長,而係講到某個人、物件或角度時,無法交代文字究竟對應邊張參考圖。RefCaptioner屬於影片字幕生成模型項目,集中處理 multi-reference image-grounded video captioning:一邊保留細節與事實準確度,一邊將局部描述同候選參考圖明確綁定。

RefCaptioner 不只是把所有參考圖塞入輸出,而係會挑選真正有用的圖,將對應片語加上 <Image_N> 標籤,遇到同一主體的不同視角又會做分組,影片根本無出現的內容就直接略過。呢種設計減少錯配同誤導,比起只追求流暢字幕,更著重可核對性。

技術上,RefCaptioner用兩段式 post-training。先以 capability-preserving SFT 學會 grounded caption 格式,同時盡量保留一般 captioning 能力;之後再用 Hierarchical Coverage-Discounted GRPO(HCD-GRPO)同時優化 factual-caption 分支與 multi-reference grounding 分支,並加入 deterministic guards,避免產生格式錯誤或指向不存在圖片的標籤。

  • 提供官方 inference pipeline、SFT 資料準備、HCD-GRPO 訓練同 MRVBench evaluation pipeline
  • 已公開論文與模型權重,亦有 Data Format、Training、Evaluation 文件可跟進
  • 環境分成主環境與 GRPO 專用 veRL/vLLM 環境,代表訓練流程較完整但配置亦較講究
  • 適合做影片理解、資料標註、多鏡頭人物敘述同需要檢查圖文對應的研究團隊

部署與測試:推理、SFT、評估共用主環境,GRPO 另設一套環境,並且要對指定 veRL 版本套用 patch,反映佢較偏研究型工作流,而唔係下載即用的小工具。效能數字在提供的內容未見完整展開,但既然已附 MRVBench evaluation pipeline,至少表示作者有把「字幕寫得對」同「圖文對得準」分開檢驗,較適合重視可解釋輸出的團隊採用。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Video, Image, 影像模型

NVIDIA FastGen 平行解碼的加速擴散生成訓練

NVIDIA 團隊把擴散模型加速訓練與蒸餾流程整理成同一套框架,重點不止是跑得快,亦方便跨影像與影片任務重用方法。

Watch the video

由 NVIDIA 團隊主導,Weili Nie、Julius Berner、Chao Liu 與 Arash Vahdat 是署名作者,核心貢獻者亦包括 Weili Nie、Julius Berner、Chao Liu。這個項目放在 NVlabs 名下,定位很明確:它不是單一生成模型,而是用 PyTorch 建成的訓練框架,集中處理 diffusion models 的加速與蒸餾,讓影像與影片生成可以用較少步數完成推理,同時保留大規模訓練能力。

與一般只提供某一種加速技巧的研究代碼不同,FastGen 把 consistency models、distribution matching distillation、self-forcing、KD 等方法放進同一套結構,並且覆蓋 T2I、I2V、V2V 多種任務。這種設計的價值,在於研究團隊可以在相近配置與資料流程下比較不同蒸餾路線,而不是每試一種方法就重砌整套訓練管線。

基本理解方式:代碼庫包含 datasets、methods、networks、trainer 與 scripts,顯然以訓練、推理、評測三部分分開整理;環境方面建議用 Docker,也保留 conda 安裝路線,並支援 W&B 記錄。不過公開資訊未有列出完整 quick start 細節、現成模型清單或基準成績,現階段較像面向研究與工程團隊的基礎框架,而不是開箱即用的消費級生成工具。

Prompt:
4 NFE PDD on Wan2.1 14B: A joyful child, 
with a big smile and arms spread wide, 
swings energetically on a rusty old swing set in a sunlit backyard. The swing set, with peeling paint and creaking chains, 
contrasts against the vibrant green grass and blooming flowers surrounding it. 

The child's laughter echoes as they swing higher and higher, 
their feet barely touching the ground at the bottom of each arc.
 
The scene is captured from a low angle, 
emphasizing the height of the swings, 
with the sun casting a warm glow over everything.
Medium shot focusing on the child and the swing set.
  • 屬於框架型項目,處理的是 diffusion models 如何更快生成,而不只是再訓練一個新模型
  • 支援 ≥10B 參數的大規模訓練,較適合有多卡資源的團隊
  • 任務涵蓋 T2I、I2V、V2V,對跨模態生成研究較有吸引力
  • 方法層同時納入 consistency models、distribution matching distillation、self-forcing 等路線,方便做橫向比較

配合 NVIDIA 研究頁面的 FastGen-PDD 脈絡來看,這個項目也像是承載後續加速生成方法的底座,尤其面向 image 和 video generation 的 parallel decoding distillation。對想建立自家快速生成訓練流程、測試不同蒸餾策略,或者需要把大型 diffusion 項目整理成可維護代碼庫的團隊,FastGen 的參考價值高;但想直接下載即用、立刻看到完整評測結論的人,現有公開資料仍然偏少。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, NVIDIA, Video, Image, txt2img, Python, 語音

Page 6 of 16
1 4 5 6 7 8 16