KATok 教影片 VAE 自己丟 Token 減運算量

Kakao 開源 KATok,一個會根據內容自動決定保留多少 token 的影片 VAE,靜態畫面用得少,動態場景留得多,省下的算力直接交給下游擴散模型。

Repository image for kakao/KATok

KATok 處理嘅係影片生成入面一個常見但少有人拆開嚟解決嘅問題:傳統影片 VAE 用固定壓縮比,無論係一張幾乎唔郁嘅定鏡,或者主體快速移動嘅場面,每段都會被切成同一個 token 數。呢種做法喺靜態片段上明顯浪費頻寬,令擴散模型要做好多無意義嘅工作。

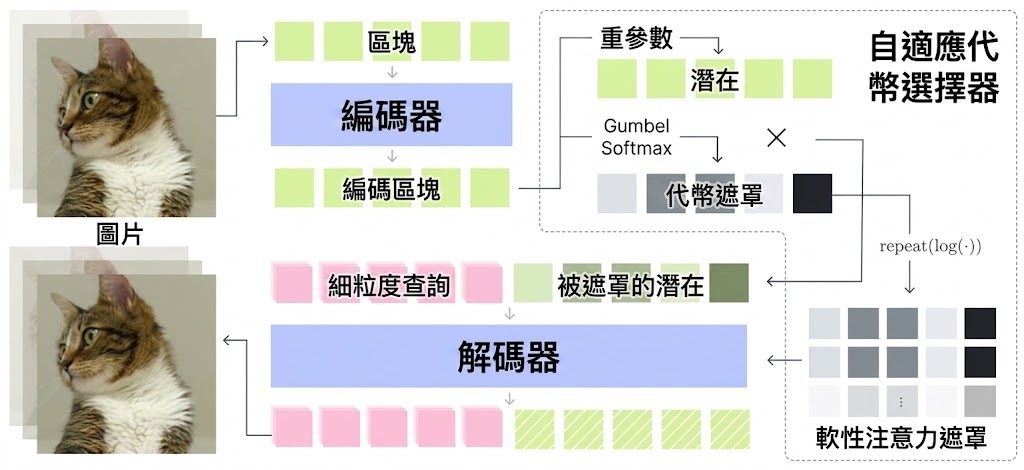
佢嘅做法係喺 transformer VAE 嘅 latent bottleneck 加一個可學習嘅 keep-or-drop 決策,對每個 token 估計要唔要保留,仲會一齊學 latent 表示。遮罩同時控制 latent 值同 decoder 嘅注意力,decoder 用 coarse-to-fine 結構由稀疏 token 重建細節,因此 token 數變成內容嘅結果,而唔係預設參數,亦唔需要推理時搜索。

喺 Panda-70M 256²×16 設定下,平均 366 個 token 就可以達到 31.24 PSNR 同 5.12 rFVD;喺 UCF-101 嘅稀疏生成實驗中達到 61.53 gFVD,比 dense transformer tokenizer 訓練快 6.9 倍。代價係當 token 被丟棄後空間佈局會被打亂,所以佢哋仲設計咗 cascaded mask prior 同 joint content–position 變體,幫下游擴散模型補返結構。

值得留意嘅重點:

  • 自適應 token 化,內容決定 token 數,無需推理時搜索或人手調參
  • 喺 Panda-70M 用 366 個 token 達到 31.24 PSNR / 5.12 rFVD
  • UCF-101 稀疏生成快 6.9 倍訓練速度,質素達 61.53 gFVD
  • 提供 inference code 同權重(仍在內部審核),訓練碼暫未開源
  • 直接用 PyTorch SDPA 即可行,安裝簡單

如果你嘅團隊需要處理大量冗餘嘅影片片段,又想慳運算量畀下游生成模型,呢種由內容決定 token 數嘅做法比起單純壓解像度更貼近問題本質。
項目主頁 · GitHub

Categories: 開源, Image, 推理引擎

Lucida:用「解析、生成、放置」三步把實景變成可編輯的模擬場景

字節跳動 Seed 團隊把真實室內環境拆解成獨立物件資產,透過閉環姿態修正讓重建結果能直接用於模擬。

Og image

從一段真實拍攝的室內影片,要還原成可以模擬、可逐個編輯嘅場景,一直都係 3D 重建嘅痛點:擺位、遮擋同殘缺幾何往往令資產難以重用。Lucida 就係針對呢個矛盾提出嘅方案,屬於實景到模擬(real-to-sim)類嘅場景建模系統。

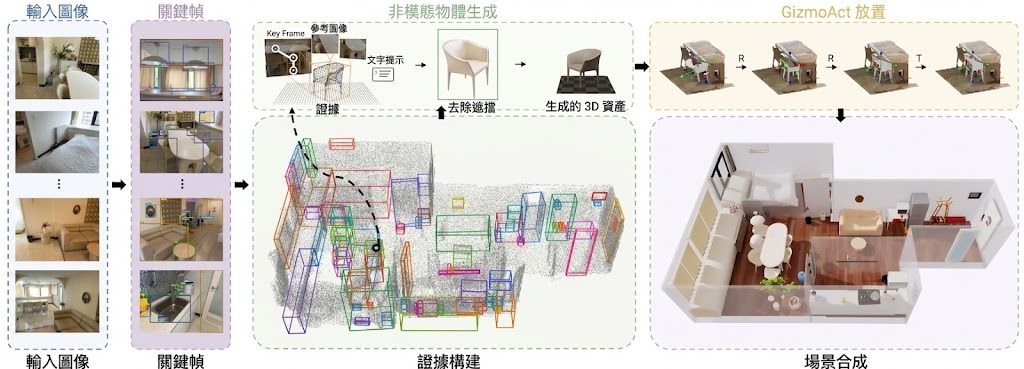
整個流程分成三步。第一步 Parse 揀選有用嘅關鍵幀,跨視角對應實例並建立場景圖,輸出遮擋、局部點雲同參考視圖等證據。第二步 Generate 利用每組證據合成無遮擋嘅物件影像,再提升成完整、可編輯嘅 3D 資產。第三步 Place 先粗略初始化,再用 GizmoAct 喺閉環中反覆執行姿態編輯,直到渲染結果同觀察對齊。

GizmoAct 係呢套系統嘅核心控制器,由視覺語言模型(VLM)操作 3D 編輯器,每一步根據渲染觀察、點雲疊加同正交視圖等線索,落一個可執行嘅姿態修正。同一條策略可應付由 Boxer、Any6D* 到 SAM 3D 等不同初始化,並以最多 4 個視圖同 12 步修正完成對齊。

Lucida 喺 R2S、CA-1M 同 Aria Digital Twin 數據集上都提升咗場景級 3D 物件檢測、姿態估計同完整場景重建指標。重建出嚟嘅場景以一組獨立、可編輯嘅 mesh 呈現,每件物件都準備好進入模擬階段。

對從事機器人模擬、室內數據合成或場景理解嘅團隊,呢套閉環做法比起傳統單次擬合更能容忍幾何誤差同遮擋問題,令實景資產更易直接落落去模擬器使用。

重點摘要

  • 三步流程:Parse、Generate、Place 把實景拆解成可重用物件資產
  • GizmoAct 閉環修正:VLM 操作 3D 編輯器,反覆落姿態編輯直到對齊
  • 初始化容忍度高:同一策略兼容 Boxer、Any6D*、SAM 3D 等不同起點
  • 輸出可直接模擬:每件物件係獨立、可編輯 mesh
  • 多數據集提升:喺 R2S、CA-1M、Aria Digital Twin 都有指標改進

項目主頁

Categories: 北京大學, 字節跳動, 視覺模型, Video, Image, 3D

ComfyUI-FL-MiniMaxH3 時間軸節點

這套 ComfyUI 節點把 MiniMax H3 的提示詞、音訊與影片生成整理成可重拍、可分鏡及可組裝的時間軸工作流。

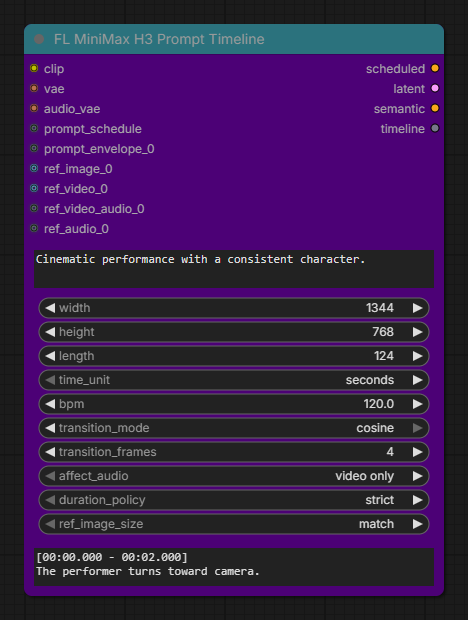
想控制影片每一秒出現甚麼畫面、配合節拍切分鏡頭,或者只重做其中一段而保留其餘內容,FL MiniMax H3 提供的是一套 ComfyUI workflow nodes,實際處理 MiniMax H3 影片與音訊 latent 的時間軸編排、取樣和合成問題。

核心節點會建立原生的 nested H3 video/audio latent 及 prompt conditioning。你可以手動設定 timeline,亦可接入 FL PROMPT SCHEDULE;系統支援以秒、frame 或 beat 安排提示詞,並把 H3 image、video、video audio、soundtrack 及獨立 audio reference 編碼到同一條可重用時間軸。

FL MiniMax H3 Prompt Timeline

與先將資料攤平再處理的流程相比,項目保留 MiniMax H3 原有的巢狀影片及音訊結構,並提供 native latent upscaling,調整影片 latent 的高度和寬度時毋須經過 VAE 往返。需要更細緻修整時,pixel-space refinement 才會執行 decode、resize、re-encode,再於指定 sampling-step window 內細化結果。

  • 可按節拍規劃獨立或明確分組的 shots
  • 支援 frame-exact temporal reshots,只重生成指定區間
  • 可把上一個 render 的 authored tail 作為 hard-cut motion context
  • 內置 sampler previews,並可按時間軸組裝最終影片

使用者需要已有節點所需的 H3 text encoder、video VAE 和 audio VAE;適合需要精確控制分鏡、重拍範圍和聲畫結構的 ComfyUI 創作者及影片工作流程,而非用作性能比較。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, MiniMax

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

write-then-publish:自動 .md 排版成為圖文卡

寫完文章後,毋須再分別排版圖片、卡片和長文格式,這個項目把發布前的整理工作集中在同一個工作區。

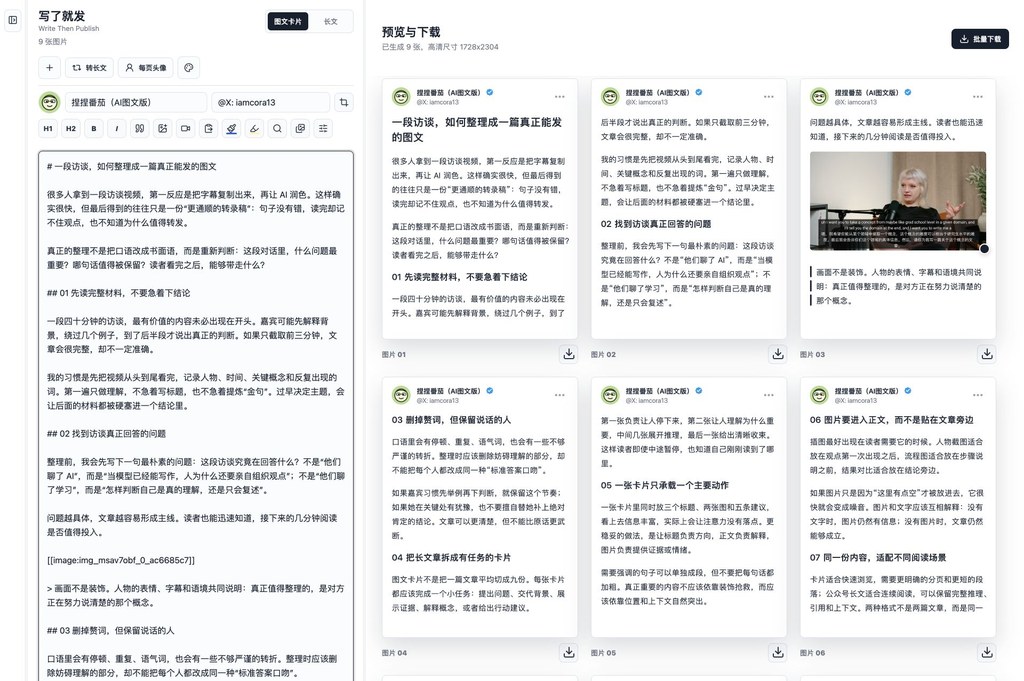
写了就发全屏工作区,左侧是长篇文章编辑框,右侧是三列并排的九张图文卡片,第三张卡片包含真实视频截图

由寫作到發布,最花時間往往不是產生內容,而是重新分頁、整理圖片和適配不同平台格式。這個項目屬於內容製作工具,讓同一份 Markdown 正文同步輸出圖文卡片與公眾號長文,並保留原有結構,不會因為切換模式而改寫內容。

項目採用 Vanilla HTML/CSS/JS,亦提供本地運行方式。圖片支援上傳、貼上、拖放和批量導入,Wiki 圖片引用則可讀取 Obsidian 的 ![[圖片.png]]、![[附件/圖片.png]] 及標準 Markdown 圖片語法。瀏覽器獲得目錄權限後,Markdown 會寫回「寫了就發」,新增圖片則放到「寫了就發/附件/」;未能寫入時會降級為 Markdown 加附件 ZIP。

圖文卡片會自動分頁,標準輸出為 1728 × 2304 PNG;公眾號模式保留標題、列表、引用、程式碼、表格和正文圖片,亦可調整主題、字體、字號與主題色。Live Photo 透過 WebCodecs 處理,可按小紅書或公眾號設定片段時長、比例、裁剪及聲音,並按原始頁序批量下載。

  • 同一份正文切換兩種發布格式
  • 支援 Obsidian 雙向同步及附件整理
  • Live Photo 可剪輯、預覽及批量打包
  • 未授權目錄時提供 ZIP 降級方案
  • Supabase 登入模式以 Row Level Security 按 auth.uid() 隔離資料

項目不涉及生成模型,因此不會替作者寫稿或改寫內容,價值集中在發布前的排版與素材整理。內容創作者、經常維護 Obsidian Vault 的作者,以及需要同時經營公眾號和圖文平台的小型團隊會較容易受益;macOS 本地版另可在配置完成後同步到公眾號草稿箱,但跨平台發布能力仍受瀏覽器權限和平台整合限制影響。

GitHub

Categories: 開源, Image, Mac, 安全

WeMM-Embedding:對齊文字、圖片、影片的多模態檢索

騰訊微信視覺團隊把文字、圖片、影片、視覺文件等多種輸入收進同一個嵌入空間,推出涵蓋 2B/4B/9B 三個尺寸的 WeMM-Embedding 系列,主打檢索與多模態理解一條龍。

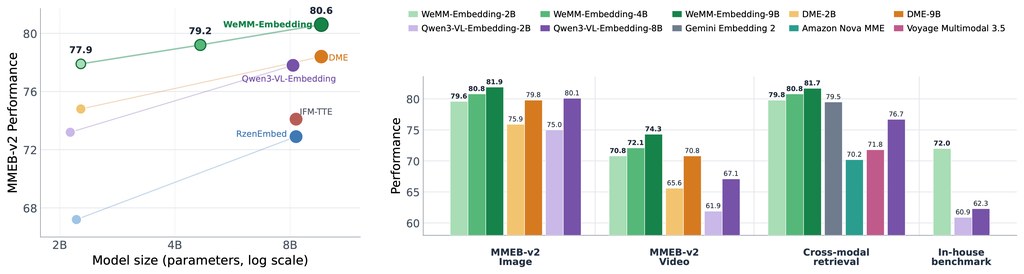
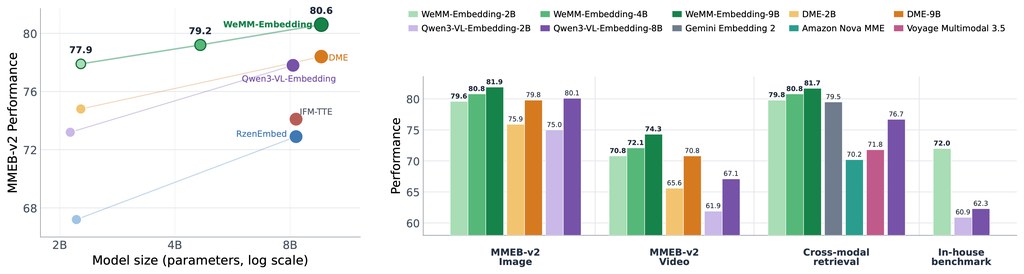
WeMM-Embedding Performance Overview

把文字、圖片、短影片、文件截圖一次過丟進同一個嵌入空間做檢索,一直是多模態團隊頭痛的工程難題。WeMM-Embedding 系列由騰訊微信視覺團隊開源,正是針對這個場景而來:三個規模(2B/4B/9B)都用同一套介面,輸出可直接比對的向量,免卻多模型串接的麻煩。

向量從模型最後一層的 <embedding> token 位置取出,再做 L2 正規化,方便直接接入既有向量資料庫。對想做跨模態檢索或 RAG 的團隊而言,這類統一模型比起同時維護 CLIP 系、BGE 系、影片模型幾套 pipeline,部署成本明顯較低。

官方推薦 transformers==5.2.0 以保證預處理一致性,亦支援 SentenceTransformer 直接載入 Hugging Face 模型 ID。比較有彈性的是 Matryoshka Representation Learning(MRL):例如 9B 版本支援 64 到 4096 多段維度,開發階段可以用低維度快速迭代,再逐步切到高維度;2B 與 4B 版同樣提供 64 至 2048 左右的選項。已驗證 vLLM 0.27.0 與 SGLang 0.5.9 兩套推理引擎,兩者都以 pooling runner 啟動,搭配專屬的 chat template 即可提供 embedding 服務。

與同類開源嵌入模型相比,WeMM-Embedding 強調「影片與視覺文件也在同一個向量空間」,而不是只覆蓋到圖文。短影片摘要、PDF 截圖理解、社交媒體(X Demo)多模態內容推薦等場景,會比純圖文模型更貼地。音訊輸入目前不在支援範圍內,是規劃時要留意的限制。受惠對象包括做多模態 RAG、跨模態檢索、商品搜尋及內容審核的中小團隊,因為他們通常缺乏同時訓練多個專門模型的資源。

重點:

  • 統一嵌入空間:文字、圖片、影片、視覺文件、交錯輸入共用同一向量表示,免除多模型串接。
  • 三種規模:2B、4B、9B 同步開源,可在準確度與成本之間靈活取捨。
  • Matryoshka 維度彈性:支援 64 至 4096 多段可選維度,平衡儲存與效果。
  • 生態友善:兼容 transformersSentenceTransformer,並已驗證 vLLM 與 SGLang 部署。
  • 目前限制:音訊輸入未支援,預處理對 Transformers 版本敏感,需固定在 5.2.0。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, RAG, Embedding, 模型, Video, Image, Dataset 數據集

Ox Alpha 百萬 Token 上下文免費試用

Z.ai 最新模型 Ox Alpha 提供 1M-token context window,讓大型程式碼庫、圖像與影片可在同一個推理流程中處理。

Og image

面對大型程式碼庫、長篇規格文件或連續多步工作,Ox Alpha reasoning model(推理模型)可把最多 1M-token context window 的內容放在同一個脈絡中處理,減少反覆切分資料或遺失前文。它亦支援文字、圖像和影片輸入,適合除錯、重構及分析截圖或介面流程。

Ox Alpha 會先規劃和自我檢查,再產生答案,並以 visible thinking 展示推理過程。模型同時提供原生 tool calling、tool_choice,以及配合 response_format 的結構化 JSON 輸出,方便用於長時間運行的 agentic 工作流程。

網站列出的獨立測試涵蓋 10 項真實編程任務,Ox Alpha 完成 8 項,得分 80%;同一比較中,Fable 為 65%,GLM-5 為 62%,GPT-5 和 Grok 4 均為 52%。樣本只有 10 項任務,結果較適合作為參考,未足以代表所有編程場景。

• 1M-token context window,最高 131K tokens 輸出
• 支援文字、圖像和影片三種輸入
• 適合大型程式碼庫的 debugging 和 refactoring
• 原生 tool calling 與結構化輸出
• 免費試用、毋須登入,網站表示不會把聊天儲存在伺服器

項目主頁

Categories: Agentic, 模型, 多模態模型, Video, Image, 軟件, Python, 編程, 免費試用, UI/UX

[影片教學] 利用開源探索 3D 世界

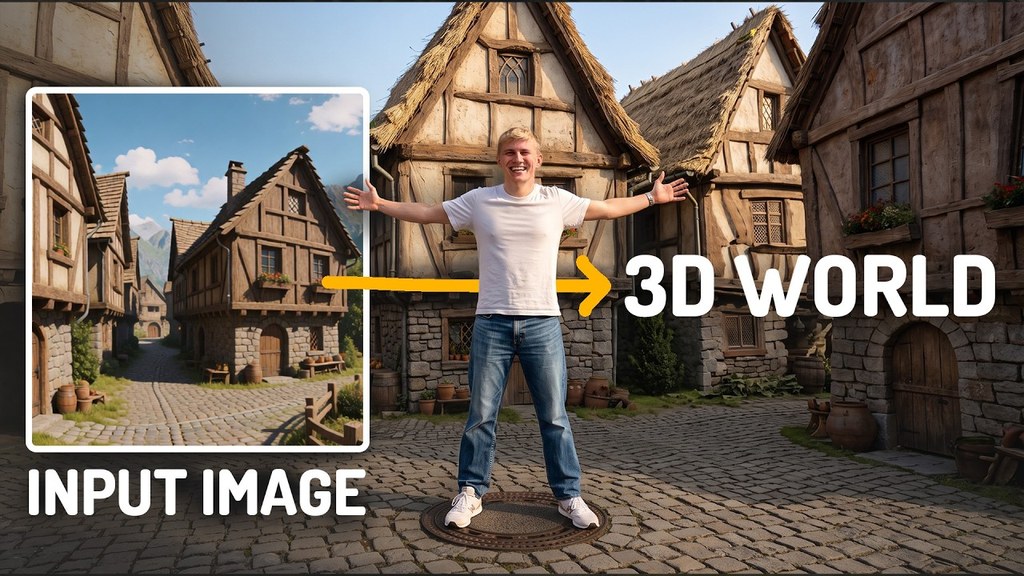
這個開源項目讓你用一張圖或一段文字 prompt,在本地免費生成可自由行走的 3D 世界,毋須依賴雲端服務。

Og image

過往要把一張圖變成可探索嘅 3D 場景,往往需要動用雲端 GPU 或者封閉式商業工具。一個新開源嘅世界生成項目反其道而行,主打「本地、免費、完全開源」,用家只需要餵一張圖片,或者寫一段文字 prompt,就可以產出一個可以行入去慢慢逛嘅 3D 場景。對遊戲開發、空間設計或者 VR 內容創作嚟講,呢種「零門檻起手」嘅流程可以省卻大量建模時間。

同一般文生圖或者文生影片模型唔同,呢類世界生成系統要處理嘅唔係單一畫面,而係保持視點一致嘅連續空間。背後通常會結合影像生成、深度估計同體積渲染(volumetric rendering)等幾組技術,再用 NeRF(Neural Radiance Fields,神經輻射場)或類近嘅 3D 表徵方式重建場景,等用家可以即時改變視角行入去睇。

對玩家嚟講,最直接嘅體驗係輸入一張京都街景相或者一句「霧夜嘅科幻實驗室」,幾分鐘之後就有一個可以操控角色行入去嘅小型世界;對開發者嚟講,由於整套工具鏈都係本地行得通,唔使擔心 prompt 或者素材被上傳到第三方伺服器,私隱同成本都較易掌控。

不過本地跑呢類模型對 GPU 仍然有要求,視訊記憶體唔夠嘅話生成時間會明顯拉長;另外世界嘅規模同互動深度仲未去到遊戲引擎嗰種水平,比較適合作為概念驗證或者素材起手稿,而唔係完整場景嘅最終方案。

以下係幾個值得留意嘅重點:

  • 支援圖生世界(image-to-world)同文生世界(text-to-world)兩種入口
  • 完全開源,可在本地離線運行
  • 採用神經輻射場或類近技術做 3D 重建,保持視角一致
  • 私隱同成本上比雲端方案更具優勢
  • 對 GPU 仍有要求,目前較適合做概念驗證階段

項目主頁

Categories: AI productions, 世界模型, Image, 影像處理, 教學, 3D

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

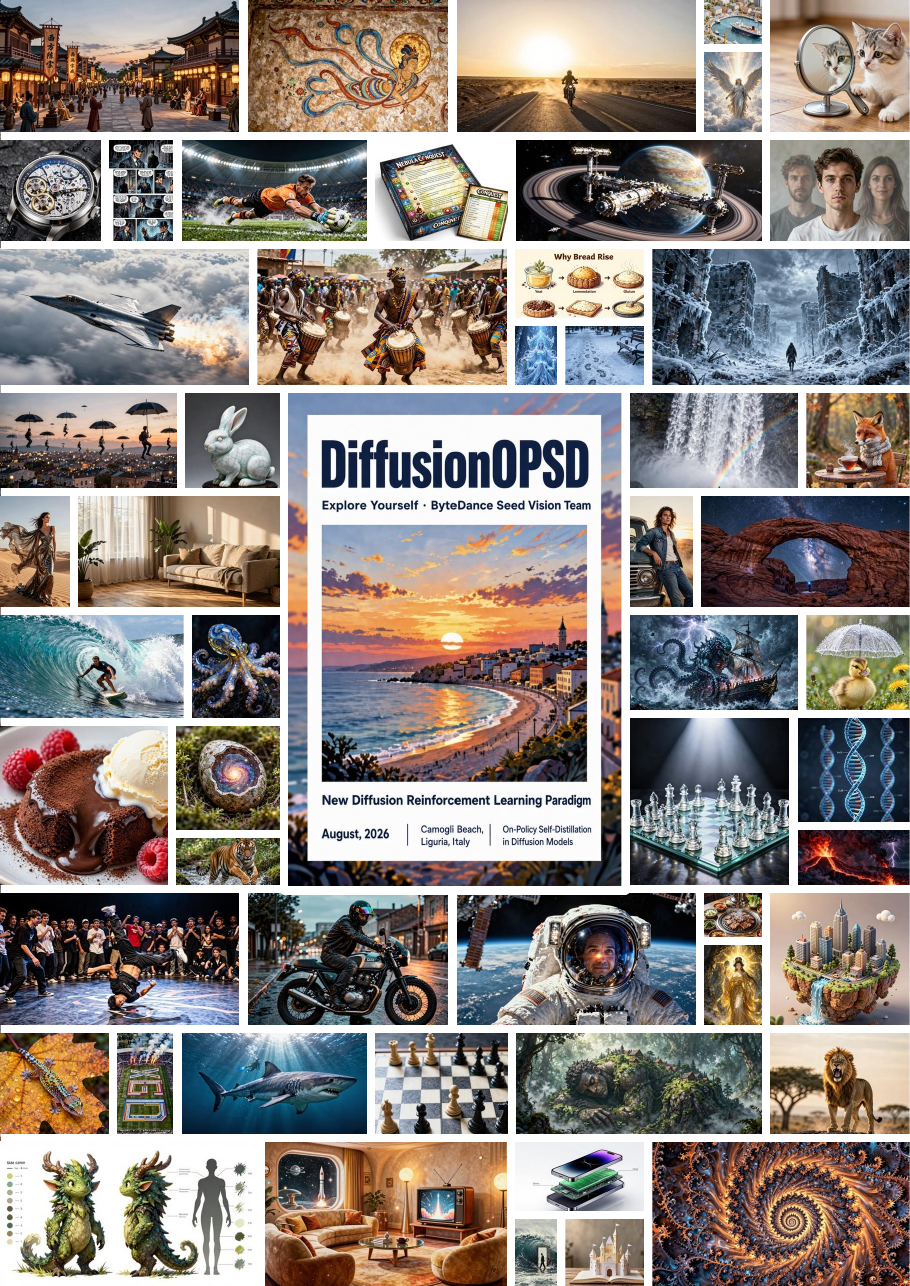
DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

WeMM-Embedding 統一多模態向量

WeMM-Embedding 把文字、圖片、影片和視覺文件放進同一套向量空間,適合要做檢索、比對和跨模態搜尋的場景。它同時提供不同尺寸選擇,方便在準確度與成本之間取捨。

WeMM-Embedding Performance Overview

WeMM-Embedding 是一組多模態 embedding 模型,目標是把文字、圖片、影片、視覺文件和交錯式多模態輸入,轉成可直接比對的統一向量。對要做搜尋、相似度比對、內容檢索或跨媒體匹配的團隊來說,這種做法比逐一分開處理不同素材更省事。

它提供 2B、4B、9B 三個版本,還支援 Matryoshka dimensions,代表可以按需要輸出不同長度的 embedding,減少計算和儲存成本。README 也提到,向量來自 <embedding> token 的最後一層 hidden state,再做 L2 normalization;目前不支援 audio。

實作和試跑方式都算直接,既可以用 transformers,也可以用 SentenceTransformer 直接載入 Hugging Face 模型 ID。作者同時標明推理較建議用 transformers==5.2.0,原因是較新的版本在前處理行為上可能有差異;serving 方面則測過 vLLM 和 SGLang。

  • 統一處理 text、image、video、visual document 和 interleaved multimodal inputs
  • 支援 Matryoshka dimensions,可按成本需要縮短 embedding 長度
  • 適合做跨模態搜尋、內容去重、相似度比對和檢索索引
  • 推理可用 transformersSentenceTransformer,部署可接 vLLM、SGLang
  • 現階段不支援 audio,做語音相關流程要另配其他模型

對要處理多媒體內容的應用團隊、檢索系統、內容平台和資料整理流程,這類模型最直接的價值是減少多套表示法之間的銜接成本。它在多個基準上取得領先結果,但實際選型仍要看你要的是完整維度、較低成本版本,還是偏向部署效率的配置。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, Embedding, 模型, 多模態模型, Video, Image, Audio

Page 3 of 16
1 2 3 4 5 16