LaLa-World 用自然語言連接機械人規劃

以文字描述動作,模型便可從模擬、機械人、圖片和影片學習並預測未來畫面,讓規劃不必為每個任務各自訓練世界模型。

NAVER AI Lab

只用文字描述動作,就能讓同一個世界模型從模擬、機械人、圖片和影片學習,並預測行動後的視覺變化。LaLa-World 是語言條件式潛在世界模型,目標是減少不同領域各自訓練模型的需要,支援跨場景規劃;它亦可微調成 LaLa-Policy,同時預測機械人動作和未來表徵。

關鍵做法是把自然語言當成共通的動作介面,再於潛在空間預測未來視覺表徵,而不是直接生成完整影片。研究結果指,加入圖片和影片資料可改善規劃能力,亦令模型較能適應不同動作措辭;這讓研究團隊可以把多種來源的資料納入同一套規劃流程。

  • 在平均 MPC 規劃 LaLa-World 優於按領域或任務分開訓練的潛在世界模型。
  • 與採用相同條件的 RAEv2 影片生成模型相比,規劃表現相若,訓練成本低 6 倍,規劃速度快 13.9 倍。
  • LaLa-Policy 在 LIBERO 和 RoboCasa 的結果可與 Cosmos Policy 比較,推理速度最高快 5.5 倍。
  • 跨模態資料可提升規劃表現及對動作措辭的穩健性,對需要跨模擬與真實機械人資料研究的團隊較有吸引力。

這些結果令項目適合用作機械人規劃與政策學習研究,尤其是希望整合影片資料、減少逐個任務訓練成本的團隊。不過,GitHub 儲存庫目前仍在補齊內容:環境設定和資料準備程式已提供,LaLa-World 訓練及規劃評估程式、預訓練檢查點和解碼器則尚未公開,因此現階段未能按完整流程重現結果。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 庫

Code2Video-Compass:程式碼生成影片點樣評?2,104 項任務比較 15 個多模態模型

Code2Video-Compass 把文字、圖片和影片輸入納入同一套程式碼影片生成基準,讓團隊比較模型能否產生可執行、貼合指示的影片。

Code2Video-Compass logo

由文字描述出發,或提供圖片、原有影片作參考,模型都要生成可執行程式碼,再經 Remotion 渲染成影片。Code2Video-Compass 是一套評估基準及評測程式,聚焦比較不同多模態模型在程式碼生成影片時的能力,而非提供一個直接生成影片的模型或服務。

它涵蓋文字轉影片(T2V)、圖片轉影片(I2V)和影片轉影片(V2V),支援 HTML/CSS、SVG、Canvas 與 Three.js 等程式碼方式。基準共有 2,104 項任務,分布於 10 個影片類別和 24 個子類別;其中 1,719 項任務配對 573 段來源影片,方便在不同輸入形式下比較模型如何保留參考內容及回應指示。

評測納入 15 個多模態大型語言模型,並以 12 項客觀指標和 5 項主觀指標檢視執行成功率、效率、影片品質、指示吻合度及參考內容保真度。相比只看成片觀感,這套基準亦檢查程式碼能否執行及生成流程的效率;不過,評測結果仍受任務設計、指標定義和主觀評分影響,不能單憑總排名推斷模型適合所有影片工作。

研究團隊可用它比較不同模型在特定輸入形式或影片任務上的表現,亦可檢查系統瓶頸是在程式碼執行、視覺品質,還是參考內容對齊。儲存庫提供評測程式,任務提示、標註、品質檢查清單及參考媒體資料則放在 Hugging Face;提供的資料未列出安裝步驟或完整執行流程,採用前需查看相關程式碼與資料集說明。

  • 支援 T2V、I2V、V2V,並涵蓋獨立任務與來源影片配對任務。
  • 模型以 HTML/CSS、SVG、Canvas 或 Three.js 產生程式碼,再由 Remotion 渲染影片。
  • 以 12 項客觀指標及 5 項主觀指標,評估執行、效率、品質和指示吻合度。
  • 適合模型研究及影片生成系統團隊作比較;它本身不是影片生成模型。

項目主頁 · GitHub · 數據集

Categories: 開源, AI productions, 模型, 多模態模型, Video, Image, 庫, Dataset 數據集

RealMe:從稀疏多鏡頭畫面重建 2K 沉浸式 4D 影片

拍攝角度和畫面清晰度有限,也能為新視角補出細節並維持跨鏡頭、跨時間的一致性。RealMe 以影片擴散模型輔助重建體積影片,但程式碼仍未公開。

RealMe

用稀疏、低解像度的多視角影片製作沉浸式內容,難處不只在補清楚每一格,也要避免不同鏡頭和時間點的畫面互相矛盾。RealMe 是一項體積影片重建研究項目,目標是把 720p 多鏡頭拍攝素材轉成 2K、具 4D 一致性的影片,適合需要從有限拍攝資料重建人物與場景的研究及製作團隊。

流程先由輸入畫面建立粗略的 4D 表示,再從新視角渲染結果和原始畫面裁切出輔助影片,交由高解像度影片擴散模型增強;生成結果會與原始拍攝一同用來細化最終表示。模型以 ControlNet 注入輔助影片條件,並在 DiT 中分開處理時間與視角方向的注意力,讓去噪過程能交換跨影格、跨視角資訊;頻率引導則用來恢復細節。

相比只提升單張影像清晰度的做法,RealMe 同時處理新視角品質與 4D 一致性。研究團隊表示,它在 RealVV 和 DNA-Rendering 兩個資料集的新視角合成品質及 4D 一致性上勝過當時的先進方法;與 STAR、FlashVSR 比較時,示範結果呈現更細緻的面部、頭髮和衣物細節。這些結果來自研究展示,未提供可供讀者自行重現的效能數字。

RealVV 是團隊自行拍攝的多視角資料集,涵蓋不同人物、動作、場景、相機基線和焦距設定,目標是測試較具挑戰性的拍攝條件。現階段 GitHub 程式碼仍在內部審查,資料亦標示為即將提供,因此目前可透過論文、項目網站及示範影片了解方法,尚未能按公開指引安裝或重現流程。

  • 輸入為稀疏、低解像度的多視角影片,輸出目標為 2K 4D 體積影片。
  • 影片擴散模型負責生成增強視角,再與原始拍攝共同細化重建結果。
  • DiT 的時間與視角注意力設計,用來維持跨影格、跨視角一致性。
  • RealVV 涵蓋多種人物、場景及相機設定;程式碼和資料目前尚未公開。

對多鏡頭人物捕捉、自由視角影片和 4D 重建研究而言,RealMe 展示了以生成模型補足稀疏拍攝細節的方向;但在程式碼與資料釋出前,製作團隊仍難以判斷其運算成本、所需拍攝條件及融入現有流程的難度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, Video, Image, 中國, Dataset 數據集

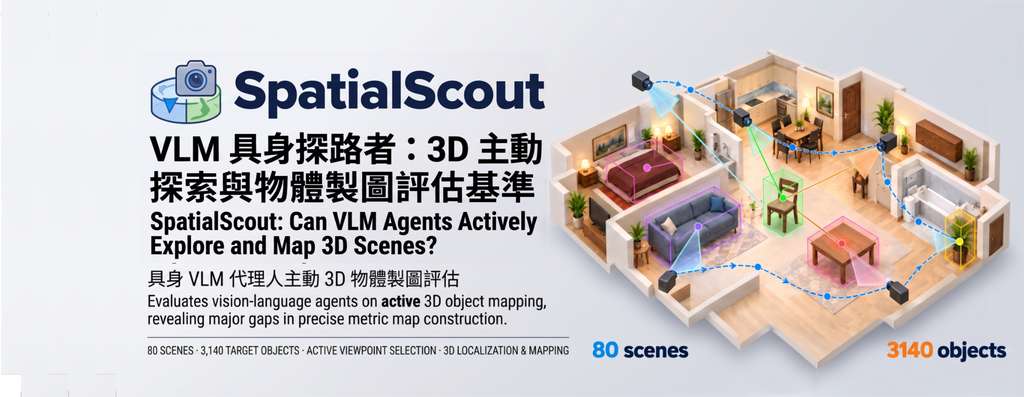
SpatialScout 揭示 3D 定位落差,讓視覺語言模型探索室內空間

視覺語言模型要邊探索室內場景、邊把物件放進共通的 3D 座標,仍難兼顧完整度與精準度。SpatialScout 以 80 個場景測試這種主動建圖能力。

SpatialScout overview

要讓視覺語言模型看過不同角度後,找出物件在房間中的位置,單靠辨認影像並不足夠:模型還要選擇鏡頭視點、累積視覺證據,再把多個畫面中的物件對應起來。SpatialScout 是測試視覺語言模型(Vision-Language Model,VLM)代理主動探索與物件級 3D 建圖能力的基準項目,涵蓋 80 個室內場景及 3,140 個目標物件。

每項任務提供物件清單、RGB 觀察畫面,以及相機校準資料和位置資訊;代理要控制相機,在有限互動回合內探索場景,並估算物件在共通 3D 座標系中的中心位置。這讓測試不只檢查模型能否辨認物件,也衡量它會否選擇有用視點、跨畫面追蹤物件,以及逐步修正位置。

結果反映出由大概布局走向精確地圖仍有明顯距離:表現最佳的受測模型平均 IoU 為 41.71%,只有 3.25%的目標物件達到 IoU 0.9 以上。項目亦提供涵蓋所有物件及已提交物件的八項 IoU 指標,並以成功完成 finish_mapping 的軌跡計算任務平均分;這有助分辨模型是定位不準,還是漏掉了物件。

  • 基準涵蓋 80 個室內場景及 3,140 個目標物件。
  • 每項任務最多 100 回合,模型需主動選擇觀察視點。
  • 評分同時考慮定位準確度與物件完整度。
  • 最佳受測模型平均 IoU 為 41.71%,高精度定位仍有限。

研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, 視覺模型, 多模態模型, Gemini, API, Image, 3D, Linux, Python, Anthropic, Dataset 數據集

PrismaCoder 的多模態生成

多模態程式碼智慧將程式的符號世界與其執行所產生的視覺世界連結起來。

PrismaCoder: Open Multimodal Code Intelligence

從文字或視覺輸入生成圖表、網頁、示意圖、文件和動畫,PrismaCoder 是一系列開放的多模態程式碼模型,處理的不只是程式能否執行,也包括輸出畫面是否符合要求。這對需要快速製作圖表、前端介面或科學文件的開發者和研究團隊,提供了涵蓋多種視覺程式任務的模型選擇。

它的訓練流程 PrismaForge 會為每項指令建立評分規準,分開檢查程式碼與渲染結果,再用相同規準篩選訓練資料及提供強化學習獎勵。這做法把「程式寫得對」和「畫面呈現得對」分開衡量,減少只靠整體印象評分所帶來的偏差。

模型以 Qwen3.5 為基礎,提供 9B 和 35B-A3B 兩種規模,並各有監督式微調(SFT)及強化學習(RL)版本。PrismaCoder-2M 資料集涵蓋圖表生成與重建、網頁介面、互動示範、向量圖像、科學文件及化學圖形等任務;評估工具包括 VisPlotBench 和 ChemDraw。

  • PrismaCoder-9B 的 SFT 與 RL 權重均可取得;35B-A3B 的 RL 權重仍在上載中。
  • 項目網站稱模型在圖表、前端頁面和半結構化文件任務中領先開放模型,並能匹敵或超越部分專有系統;具體分數需查看網站或論文。
  • 儲存庫已提供格式專屬執行與渲染檢查、多模態資料合成,以及 Python、SVG、HTML 的文字評分工具;PrismaForge 完整評分與資料篩選流程,以及 SFT、RL 訓練腳本仍未完成。

模型權重和資料集可經 Hugging Face 項目頁取得;不過,儲存庫目前未提供完整訓練流程,35B-A3B 的 RL 權重亦未上架。想先驗證生成品質的團隊,可參考 VisPlotBench、ChemDraw 評估程式和互動示例;若要自行重現訓練,則要留意腳本尚未開放。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 工具, Python, 庫, 動畫, Dataset 數據集, 強化學習

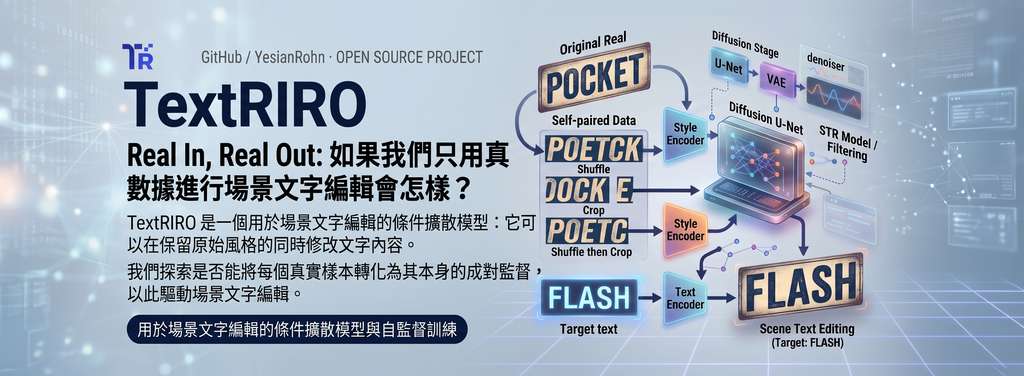
TextRIRO:修改文字內容並保留原始風格

讓圖片中的文字換內容、留風格,但處理範圍限於裁切文字區域,項目暫時只是作為研究,因此生成解像度亦有限制。我仍為這研究有助 Diffusion Model 發展更多的應用

TextRIRO training, inference, STR-pretrained text encoder, and TextRIRO-3M construction pipeline

招牌或包裝上的字換了,仍希望保留原有外觀;TextRIRO 以條件擴散模型處理場景文字編輯(Scene Text Editing,STE),輸入裁切文字圖及替換內容,輸出改字後的圖像。

它以 Shuffle&Crop 打亂真實影像的文字語意,同時保留風格線索,讓每張圖形成自身的配對監督,毋須合成編輯前後配對或字元分割。多尺度風格編碼器配合以場景文字辨識(Scene Text Recognition,STR)預訓練的文字編碼器,分別提供外觀與字元條件。

「Real-only」只涵蓋編輯監督及文字編碼器預訓練。生成骨幹仍採用 Stable Diffusion(SD)1.5 的 U-Net 與 scheduler,以及 SD 2.1 的變分自編碼器(Variational Autoencoder,VAE)。

  • 可透過 Hugging Face Demo 試改文字。
  • 本地推理需 CUDA、模型權重及相關組件;儲存庫列出 Python 3.8/PyTorch 1.13 環境。
  • 生成解像度為 64 × 256,再還原來源尺寸,細節仍受限制。
  • RIROCommon 測試等長及變長改字;所附資訊未提供分數,不能判斷領先幅度。

文字辨識研究團隊亦可利用 TextRIRO-3M 的三百萬張長文字影像。這批資料由篩選後的編輯圖與原圖拼接而成,屬合成資料;完整照片改字流程,仍需另行處理文字區域裁切及回貼。

GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Stable Diffusion, Image, Python, 庫, Dataset 數據集

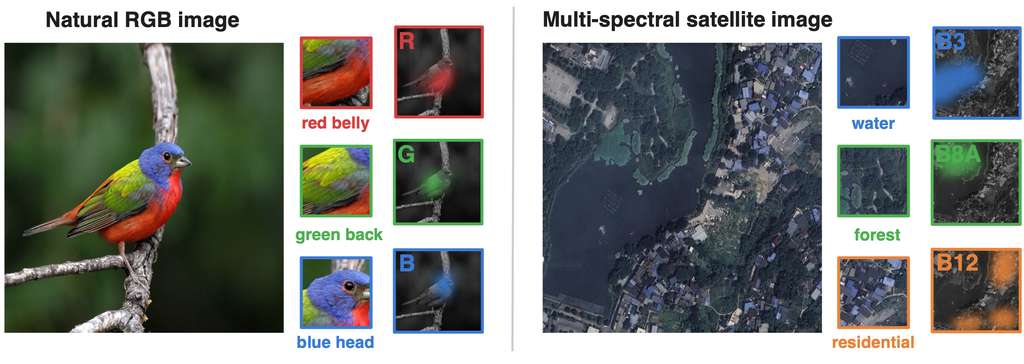
Spectral-Spatial-Interpretation(SSI ) 讓多光譜模型看清每個通道的作用

多光譜模型不只要知道哪個位置重要,還要分辨該位置由哪些通道推高或拉低分數。SSI 以 Shapley values 提供更細緻的解釋。

Figure 1: spatially varying channel relevance in RGB and multispectral images

面對多光譜影像,單一熱圖往往只說明哪裏重要,卻未能交代該位置的光譜通道如何影響結果。SSI(Spectral-Spatial Interpretation)屬於模型解釋工具,為每個空間 cell 和 channel 計算帶正負號的 attribution,拆解模型分數由哪個位置及哪個通道推動。

SSI 固定該 cell 以外的影像內容,只在 cell 內比較不同通道組合,再以 Shapley values 分配貢獻。所有通道貢獻會加總至該 cell 從遮罩狀態到原始狀態的分數變化,因此可分別彙整成 spatial map 或 spectral summary;正值代表推高分數,負值代表拉低分數。

項目提供獨立 NumPy 實作,支援 exact subset enumeration 和 sampled channel permutations,亦附有瀏覽器 Playground、Visual Atlas 及五分鐘互動教學。測試時可先用 Playground 觀察結果,再以 ssi.py 對自己的模型分數和遮罩 baseline 重現分析;通道數增加時,精確枚舉的成本亦會上升,抽樣排列是較可行的取捨。

與 Integrated Gradients (IG)、DeepSHAP、KernelSHAP 及 rank-1 RISE 比較,SSI 在三個資料集、兩種 masking baseline 下,三項指標的平均結果均居首;例如 mean-baseline HLS joint deletion 為 0.1545,KernelSHAP 為 0.2096。它較適合需要同時追蹤空間位置與光譜通道的遙感、農業或科學影像團隊,但要留意各 cell 的貢獻不一定能加總成整張影像相對 baseline 的總變化,因為 SSI 解釋的是條件式局部遊戲。

  • 同時回答「哪裏重要」與「哪個通道重要」
  • 保留正負貢獻,能分辨推高或壓低分數的因素
  • 支援精確計算及排列抽樣兩種方式
  • 可用 spatial map、spectral summary 和 deletion 指標檢查結果
  • 適合多光譜模型,但需留意計算成本及跨 cell 互動限制

項目主頁 · GitHub

Categories: 開源, 模型, Image, 影像處理, 教學, 工具

MOSS Image Edit:一句指令改圖兼支援四圖參考

把人物改成指定穿搭、表情或場景,MOSS Image Edit 透過 LoRA 串連文字與參考圖,並在 ComfyUI 重用參考資訊。

MOSS Image Edit — 用文字编辑图像

要替相片換衫、改正面表情,或將人物移到另一個場景,不一定要由人手逐項遮罩修改。MOSS Image Edit 是一個面向 MOSS-Image 的圖像編輯 LoRA,接收原圖、自然語言指令及最多四張參考圖,負責把服飾、顏色、光照、季節和畫風等要求轉成編輯結果。

發布內容只有 LoRA 權重及配置,必須配搭 MOSS-Image-Base 或 MOSS-Image-SFT,兩者擇一即可。團隊另備獨立 ComfyUI 節點與單圖、多圖工作流;下載底模和 LoRA、按指南擺放模型,再把工作流拖入 ComfyUI 即可測試,亦可調整輸出尺寸、隨機種子和採樣參數。

多圖模式不是單純追加條件:參考圖之間可互相參照,文字與目標圖則可讀取全部資訊,並要在指令內交代每張圖的用途。適合合併人物、服飾及場景參考,但最多四張圖的限制,也意味著複雜構圖仍需反覆測試提示詞與配置。

架構以 text、ref、target 三類 token 組成共享 MOSS Transformer;參考圖固定在無噪聲時間,文字及目標圖則隨去噪時間變化。參考分支只計算一次並快取各層 K/V,之後逐步重用,CFG 的正、負條件亦可共用同一份快取,減少重複運算。

  • 支援單圖指令式編輯
  • 最多連接四張參考圖
  • 可配搭 Base 或 SFT 底模
  • 提供 ComfyUI 單圖及多圖工作流
  • 沒有公開量化評測或推論供應商整合資料

內容團隊、做商品視覺或社交媒體配圖的人,會較容易感受到其價值。它目前更像是 MOSS-Image 生態中的可調編輯模組,而非一開即用的獨立模型;正式採用前仍應以自身相片、指令及輸出尺寸測試一致性、資源需求與授權條件。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, Image, 影像處理, 提示詞, LoRA

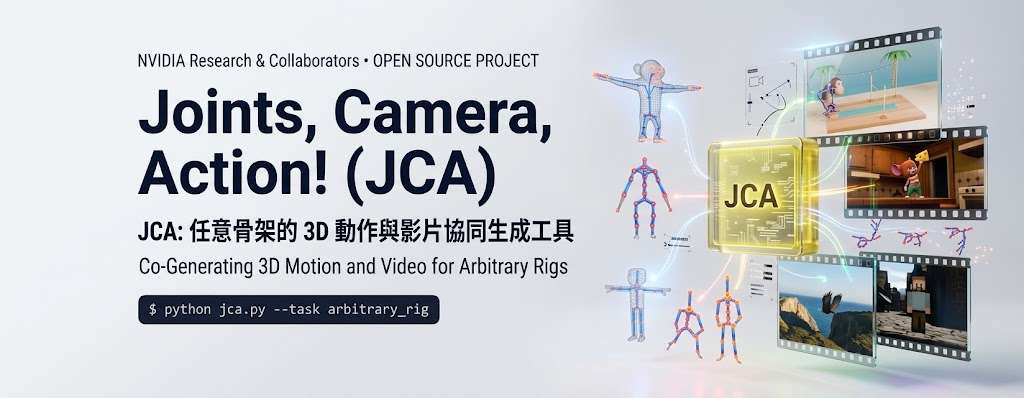
JCA 讓文字生成可重播的 3D 動作與影片

文字提示不只生成畫面,JCA 亦同步產生可重播的 3D 動作,並支援場景及關鍵影格控制。

Paper overview: rigs and scene images, keyframes, video, or rig motion enter JCA to produce scene-aware animation, keyframe-controlled motion, recovered rig motion, or video.

文字生成影片時,動作通常只留在畫面裏,難以直接套用到指定的 3D 角色,或放回原有場景。NVIDIA Research 的 Joints, Camera, Action!(JCA)同步生成影片、3D 骨架動作與鏡頭資訊,讓動作可以重播,並對應到 3D 場景。

JCA 支援不同骨架結構,不限於人形角色。輸入圖片可令動作回應周邊環境,加入少量關鍵影格則可控制動作軌跡;模型亦支援由影片還原骨架動作,或由骨架動作生成影片,適合 3D 資產動畫、場景化影片製作和動作擷取。

  • 文字提示可生成同步的影片與 3D 動作。
  • 輸入圖片和關鍵影格可提供場景及動作控制。
  • 支援不同骨架結構,並可進行影片與動作之間的轉換。

模型以圖編碼器描述骨架,並讓獨立的動作模型與預訓練影片生成器透過少量 cross-attention layers 交換資訊。動作模型可先利用較易取得和擴增的純動作資料學習;它亦會定位影片中的關節,以推算鏡頭位置,協助把 3D 動作放回場景。

訓練資料接近 20 萬組配對,涵蓋人類與機械人影片,以及經整理、確保動作有效的 3D 資產場景影片。研究團隊表示,評估中 JCA 比以影片生成為先的流程更貼合文字描述,動作也能回應場景;原文沒有列出量化指標,效果幅度仍難以比較。

項目主頁

Categories: AI productions, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Image, World-Action Model, 教學, 3D, 動畫

DeepSeek Harness(DSH) 的「可視化插件市場」

把外掛搜尋、相容性核對和整理放進 DeepSeek Harness,並讓同一目錄接入 Discover。

dsh-market logo

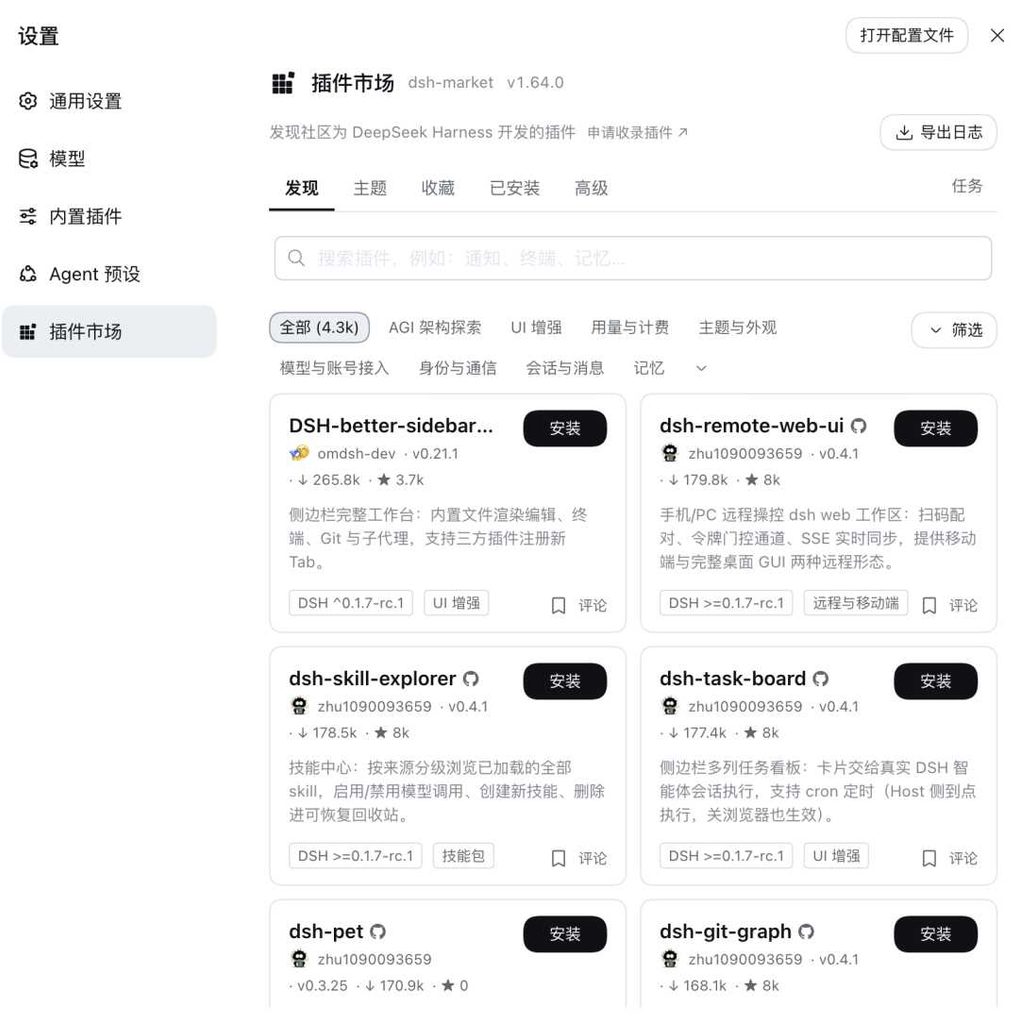
DeepSeek Harness 的 dsh-market 是外掛市集及目錄索引,簡單講,就似 VS Code 嘅 Extensions 頁面:你可以喺介面搜尋、安裝、更新同管理插件,唔使每次自己打指令。方便搜尋社群外掛、核對相容條件並一鍵安裝。

目錄有 4,200 多個項目,支援分類、星數、熱門/最新排序和雙語介紹。相容提示讀取 engines.dsh 或 lockstep @deepseek-ai/dsh-* peers;篩選器只隱藏已確認不匹配的項目,資料缺漏時仍會保留,避免誤判。

dsh 0.2.1 起可在 Discover 加入 npm 提供的 format-1 索引,較能配合主機 15 秒載入時限;GitHub Pages 複本在部分網絡可能超時。

  • 官方桌面版要透過應用程式內的 Settings → Plugins 安裝。
  • 討論串採用 GitHub Discussions 和 giscus;閱讀免登入,發文需 GitHub 帳戶,開啟時會連接 [redacted] 及 GitHub。
  • 收藏、主題及分組資料存於個人檔案的 state.json;群組可統一開關外掛。

需要 dsh web 0.1.0-rc.6 或以上版本,安裝後須重新啟動。

GitHub

Categories: 開源, Agentic, DeepSeek, Image

Page 4 of 28
1 2 3 4 5 6 … 28