Wizard:讓 AI 即時改動遊戲世界與戰鬥規則

Wizard 讓玩家用指令改變場景、角色和戰鬥狀態,再即時生成連貫影片。它適合探索互動遊戲原型與可控世界模型的創作方式。

favicon

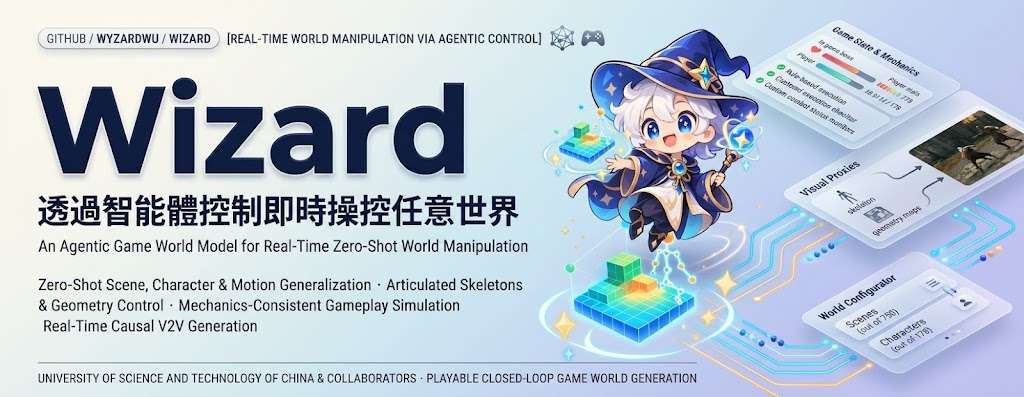
改變地形、召喚敵人,甚至令角色變身,Wizard 都能把這些操作整合到即時遊戲畫面中。這個世界模型項目以代理控制修改遊戲狀態,再由影片生成模型呈現變化,目標是讓互動不只限於移動角色,也能改動環境與戰鬥規則。

使用者可透過按鍵、文字指令或單張畫面控制世界。場景幾何、角色骨架、動作和戰鬥狀態會分開記錄,因此系統可以處理平台升降、地面變形、角色攻擊與受傷等變化;影片生成器則以每秒 24 幀輸出畫面。項目亦稱,展示中的場景和角色都是模型未曾見過的內容。

整個流程分成快速建置和遊戲期間的控制。建置階段會重建場景與角色、配置骨架並整理動作;遊戲期間,代理更新幾何、動作和戰鬥狀態,再交由 Wan2.2-TI2V-5B 生成影片。文字指令會轉成幾何操作程式,戰鬥則由狀態追蹤、攻擊規劃和規則控制器處理。

• 適合想測試可互動遊戲場景、角色動作及戰鬥變化的研究者與創作者。
• 可用文字指令、按鍵或畫面輸入控制世界,也能比較生成影片與場景代理畫面。
• 每秒 24 幀生成,並以兩步去噪處理;項目描述的建置階段少於五分鐘。
• 程式碼尚未公開,現有資料亦未提供下載或使用流程。

Wizard 把可明確追蹤的遊戲狀態與即時影片生成結合,適合探索「能否直接操控世界規則」這類互動設計。它的應用仍受限於目前展示和程式碼尚未開放的狀態,外部使用者暫時難以自行驗證或整合。
項目主頁

Categories: 騰訊, Agentic, AI productions, 模型, 視頻模型, 世界模型, Qwen, Video, Image, 框架, Content Creator, 動畫

FrameForge「換場景、不換主角」統一三種影像生成

FrameForge 把 HunyuanVideo 1.5 的影片時間帶入影像生成,讓同一套模型處理主體生成、邊緣圖生圖和指令式編輯。

Repository image for Lyne1/FrameForge

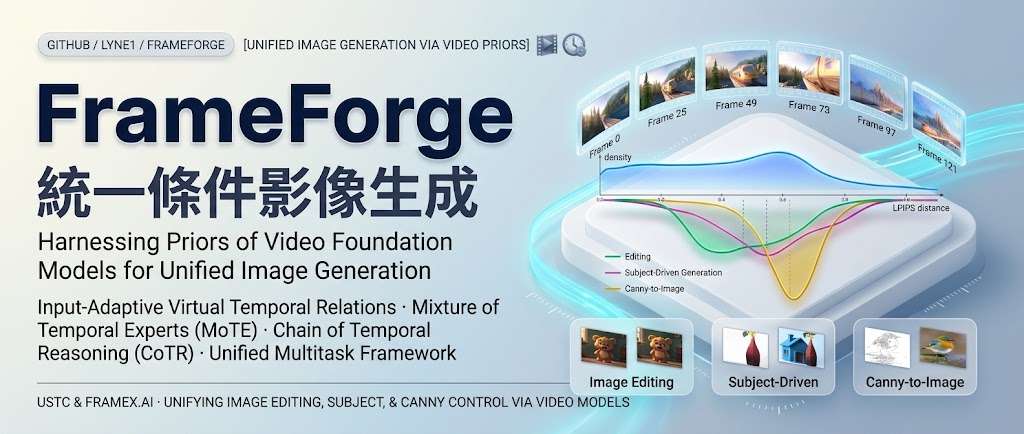
同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。

FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。

它用同一個模型處理三種工作:

功能 你提供什麼 可以做什麼
參考主體生成 一張人物、動物或物件的參考圖,加上文字描述 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上
邊緣圖轉圖片 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 依照既有輪廓、姿勢與構圖生成完整圖片
文字指令修圖 原始圖片,加上修改指令 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容

這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。

技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。

官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。

注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Stable Diffusion, Video, Image, 影像模型, Linux, Python, 庫, 中國, LoRA

h3-motion:沿路徑移動照片主體並重生成影片局部

沿路徑移動照片主體,或為影片局部加上遮罩再重新生成;h3-motion 透過自架 ComfyUI 串連影像理解與動畫模型。

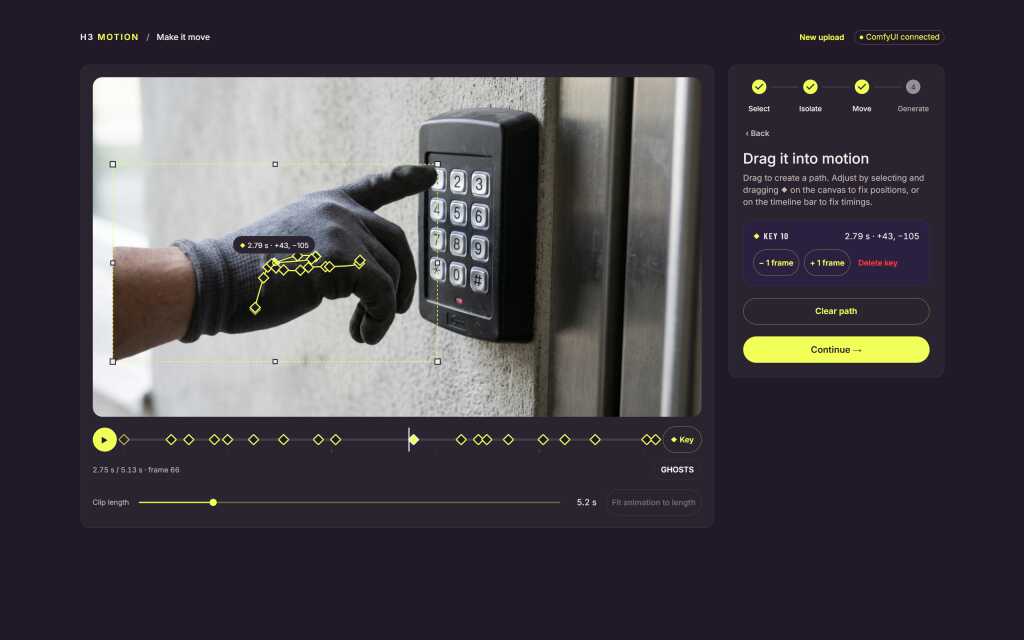
Select step: a gloved hand picked out with SAM 3.1

想沿路徑移動照片主體,或只重做影片局部,h3-motion 把兩種編輯流程整合在獨立 React app,透過 Comfy SDK 操作自架 ComfyUI。流程只用開放權重模型,不依賴 Comfy Router、合作夥伴節點或封閉 API。

照片流程以 SAM 3.1 選取主體,並可用點擊修整遮罩;Qwen3-VL 描述主體,Qwen Image 2.1 清除主體並補回背景。使用者設定路徑、大小或翻轉後,由 MiniMax H3 透過 Time-to-Move 生成動畫與聲音。

影片可用矩形或橢圓標出範圍,設定 keyframe 路徑或讓遮罩跟隨物件,並加入描述及可選參考圖。H3 重生成遮罩區域後,由 app 合成回原片;原有聲音可保留、參照或替換。

  • 照片:主體分割、背景清除,再沿路徑生成動畫。
  • 影片:局部遮罩、路徑或物件跟隨,並合成回來源影片。
  • 模型串連 SAM 3.1、Qwen3-VL、Qwen Image 2.1 與 MiniMax H3。

需要 NVIDIA 或 AMD GPU、近期 ComfyUI、ComfyUI-vlo 0.3.0 或更新版本,以及 Node.js 22.12 或更新版本;原生 Windows 尚未測試。文件未提供速度或畫質評測,較適合熟悉 ComfyUI、需要精細編輯影像局部的創作者。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, NVIDIA, API, Video, Image, Audio, Content Creator, 動畫, MiniMax

mischief 1:用生物神經元技術加速影片生成

mischief 1 建基於 Wan 2.2,主打以相近質素提供快 5 倍、成本更低的 image-to-video 生成。

6aa474e3eb96b19a0696dbe6 cta row bg

生成影片最花時間和預算的地方,往往是反覆試做、比較不同版本,再逐步修正畫面。TBC mischief 1 是 The Biological Computing Co. 推出的 AI video model,透過從活神經元取得的計算效率,處理 image-to-video 生成速度和成本之間的取捨。

TBC執行長兼聯合創辦人Alex Ksendzovsky表示:「我們曾說過,要將對活體神經元的研究成果轉化為人人都能使用的產品,而我們實現這一目標的速度遠超預期。這個模型背後是一個持續學習的發現平台。每一次實驗都加深了我們對神經元計算方式的理解,並為我們改進人工智慧提供了新的契機。」

模型建基於廣泛使用的 open-weight video model Wan 2.2,TBC 表示 mischief 1 在保持相近質素的同時,生成速度提升至基礎模型的 5 倍。項目已在 fal 和 OpenRouter 提供,定價為每秒半美仙;五秒短片約需 2.5 美仙,100 段影片約為 2.50 美元。

較低成本適合需要大量試作的影片創作者、AI-native creative studio,以及把影片生成功能整合到產品的開發者。Wonder Studios 測試後表示,模型讓團隊可以在相同時間和預算內反覆推進創意;不過,來源內容未提供具體畫質指標、支援格式或詳細使用流程。

  • 建基於 Wan 2.2,主打相近質素與更快生成
  • 生成速度較基礎模型快 5 倍
  • 每秒半美仙,適合大量試作和版本比較
  • 可在 fal 和 OpenRouter 使用
  • 技術效率來自 TBC 對活神經元計算方式的研究

項目主頁

Categories: AI productions, 模型, 視頻模型, Video, Image, World-Action Model, Content Creator

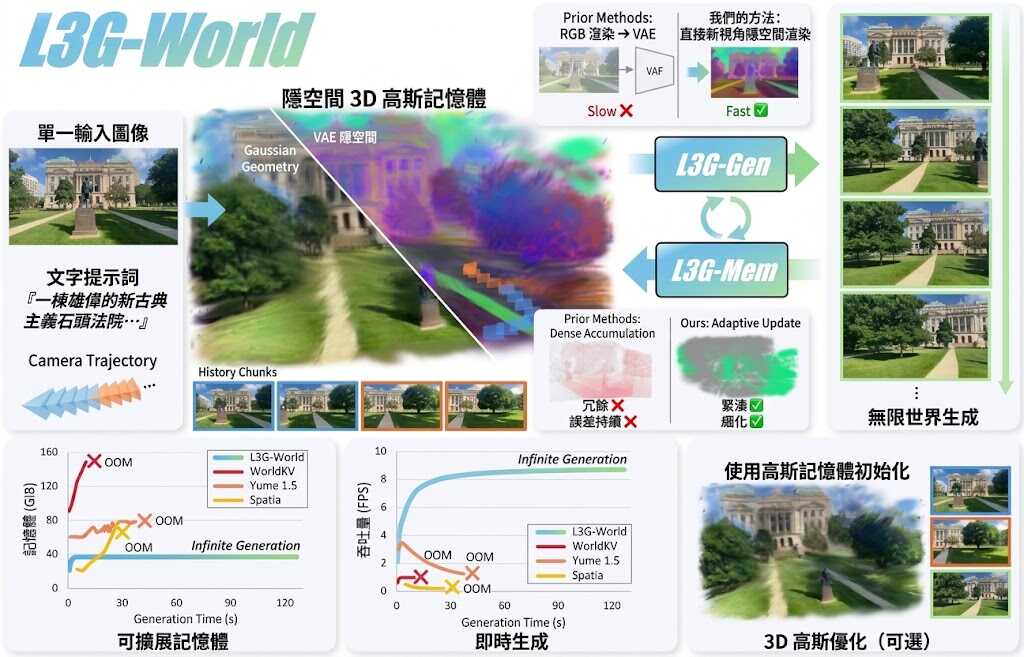
L3G-World 可以連續生成長達數分鐘影片

L3G-World 把單張影像、文字提示和鏡頭路徑接成可持續探索的 3D 世界,重點在長片段一致性與生成速度。

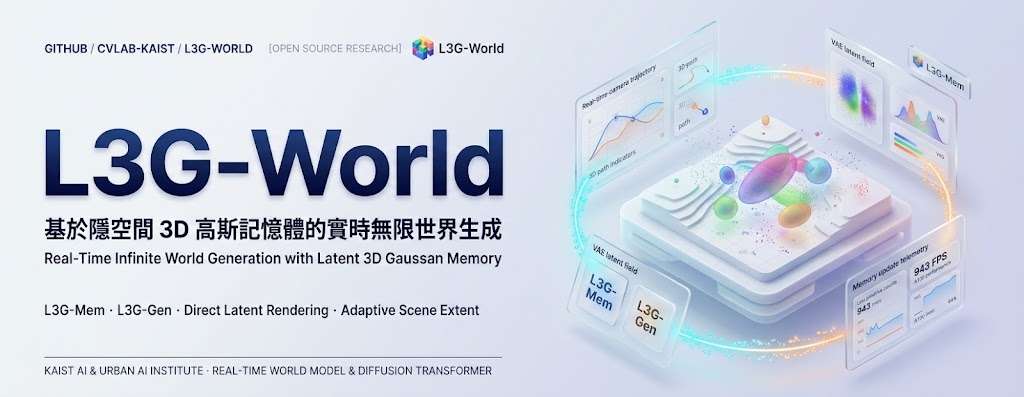
L3G-World overview: input images, text and cameras initialize latent 3D Gaussian memory; L3G-Mem updates the memory whil

由單張影像、文字提示和鏡頭路徑開始,L3G-World 可以連續生成長達數分鐘、視角一致的影片。它屬於世界模型及視頻生成模型項目,針對長時間生成容易失去場景結構、記憶不斷膨脹的問題,加入可持續更新的 3D 記憶。

L3G-Mem 會在新探索區域建立 Gaussian,重訪舊區域時則修正原有幾何資料;L3G-Gen 再利用更新後的記憶,自回歸生成下一段影片。每個 Gaussian 儲存 VAE latent,直接渲染到 diffusion 的 latent space,省去先渲染 RGB、再重新編碼的步驟,配合 few-step video model,目標是支援即時生成。

  • 長時一致性:影片片段會共享持續更新的 3D memory。
  • 記憶增長受控:記憶量跟隨探索範圍,而不是單純跟隨影片幀數增加。
  • 多視角探索:支援單張影像或少量多視角輸入,沿不同 camera trajectory 延伸場景。
  • 速度取捨:直接 latent rendering 減少重建成本,但項目仍屬研究原型。

對需要從影像建立可探索場景的研究團隊、世界模型開發者、機械人和虛擬環境項目較有參考價值。相比每段影片獨立生成的做法,它把場景記憶放入閉環流程;代價是需要同時處理 3D Gaussian 記憶、latent rendering 和擴散模型,工程整合較複雜。

項目首頁展示了 minute-long generation、不同鏡頭路徑和多視角場景延伸,但未提供明確的 FPS、GPU 型號或 VRAM 要求。儲存庫列出的 L3G-Mem、L3G-Gen、推理程式及 Fast checkpoints 仍在發布計劃中,因此目前只能按公開展示理解能力,未能據此確認安裝流程、所需硬件或可直接部署程度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Video, Image, World-Action Model, 3D, 庫

Open-H3-Regenerate-2K:把 MiniMax H3 影片提升至原生 2K

[YouTube 影片]NVIDIA 的 Open-H3-Regenerate-2K 可在 ComfyUI 將 480p MiniMax H3 草稿提升至 2K,並提供兩種測試方法。

Og image

將 480p 影片提升至 2K,往往要在畫面細節、運算成本與輸出穩定性之間取捨。NVIDIA Open-H3-Regenerate-2K 把這項流程帶入 ComfyUI,針對 MiniMax H3 產生的影片草稿進行高解像度重建,適合需要改善輸出尺寸而又想保留原有動態內容的影像工作流程。

影片示範以三個步驟完成處理,並測試兩種方法,相關檔案亦附有連結。不過,提供的原始資料沒有列出具體工作流程、模型檔案名稱、安裝方式或硬件要求,使用者仍需按影片內容及項目檔案確認 ComfyUI 節點、顯示卡記憶體和運算時間。

  • 將 480p MiniMax H3 草稿提升至原生 2K 影片
  • 以 ComfyUI 組合 NVIDIA Open-H3-Regenerate-2K 流程
  • 示範三步處理方式及兩種測試方法
  • 適合影片生成後的放大、修復及高解像度輸出
  • 硬件規格與安裝細節未在原始資料中提供

對內容創作者而言,這個項目可用於先以較低解像度製作草稿,再把選定結果交由高解像度流程處理,減少一開始便以 2K 生成所帶來的資源壓力。它較適合已經使用 ComfyUI、MiniMax H3 或 NVIDIA 影片模型工作流的使用者。

YouTube 影片介紹

Categories: ComfyUI, AI productions, 模型, NVIDIA, Video, Image, Content Creator, 安全, MiniMax

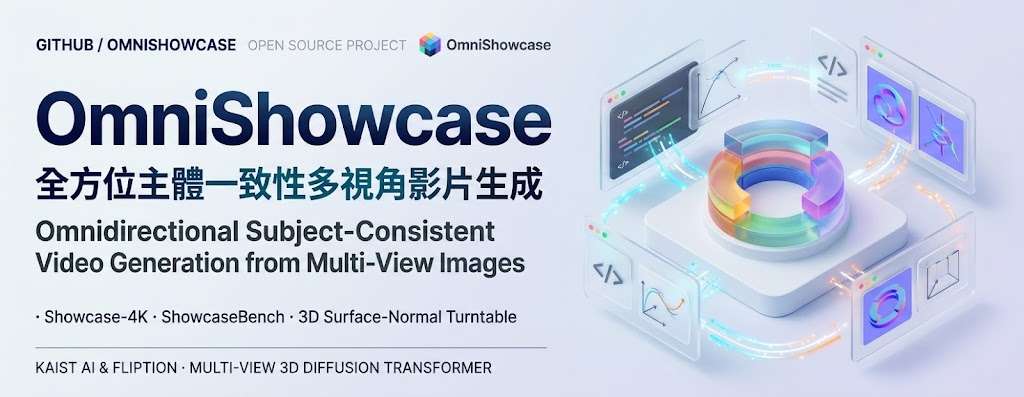
OmniShowcase:維持物件形態生成 360°影片運鏡

幾張多角度參考圖,就能引導 Wan2.1 生成沿不同鏡頭路徑移動的物件影片,並盡量保持外觀與立體結構一致。現階段程式碼與資料集尚未公開,硬件需求亦未交代。

Repository image for justin4ai/OmniShowcase

想把一件商品或角色放進不同場景,再沿環繞鏡頭拍成影片,難處是視角轉到參考圖以外時,物件外形容易走樣。OmniShowcase 是一個影片生成模型項目,利用少量多視角圖片生成同一物件的影片,鏡頭路徑涵蓋完整 360° 環繞,目標是維持物件身份與 3D 結構。

它以 Wan2.1 image-to-video 模型為基礎,透過輕量 LoRA 調整生成模型。流程會由四張參考圖重建物件,再渲染成一組表面法線圖作為條件;生成影片時,鏡頭不必逐格對齊這組法線圖,提示詞可指定其他運鏡路徑。這令模型能沿指定路徑生成影片,而不只是重播固定的旋轉角度。

  • Showcase-4K 是合成訓練資料集,涵蓋 12 種鏡頭運動及 88 種路徑配置。
  • ShowcaseBench 是評測資料集,提供影片對應的來源網格與鏡頭參數,方便檢查生成結果。
  • 項目展示環繞、螺旋下降、弧線移動、推近及拉遠等運鏡;目前提供的資訊未列出量化評測分數。
  • 訓練資料、評測集、推理程式碼及訓練程式碼均尚待公開,暫時未能按文件安裝或執行。

這種方法適合商品展示、角色視覺化及需要多角度鏡頭素材的內容製作,也可供研究多視角條件影片生成的團隊參考。代價是生成品質依賴參考圖的 3D 重建與表面法線條件。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 提示詞, 3D, Dataset 數據集, LoRA

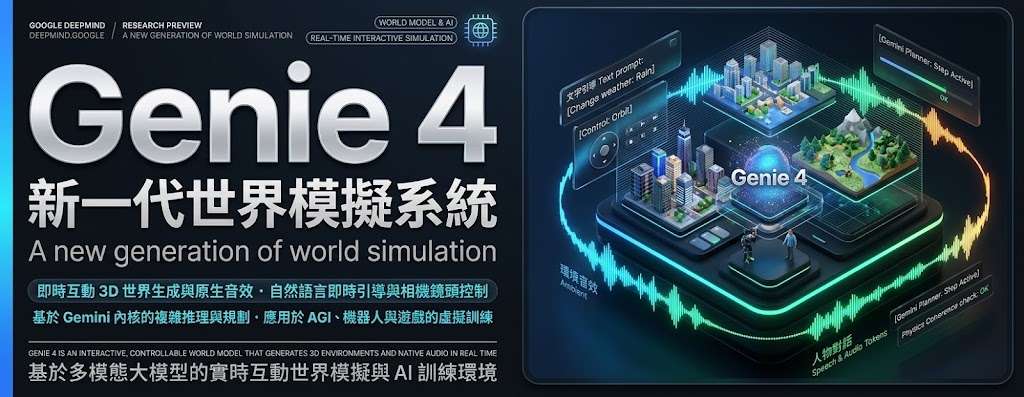
Google Genie 4:即時探索與互動世界模型

Genie 4 可按文字或圖像提示生成可探索的 3D 世界,讓研究人員測試 AI 如何在變化中的環境裡理解場景和採取行動。

Hero image preview

輸入一段描述或一張圖像,AI 便能生成可探索的 3D 世界,並隨玩家的操作即時改變場景。Google DeepMind 推出的 Genie 4 是一個世界模型研究項目,目標是建立能模擬環境、回應互動場景,為訓練和研究具身 AI 提供測試空間。

Genie 4: A new generation of world simulation

這類場景並非預先錄製的影片:玩家可以移動和探索,模型則持續生成後續畫面。研究人員可藉此觀察 AI 能否掌握環境的空間關係,並在多種情境中持續採取合適行動;不過,生成結果能否長時間保持一致,仍是世界模型需要面對的挑戰。

Genie 4 延續 Google DeepMind 的 Genie 系列研究。官方介紹聚焦於模型生成互動世界的能力,但未提供足以比較不同模型的完整量化評測,因此不宜單憑展示內容推斷它已能穩定支援所有模擬或訓練工作。

  • 可由文字或圖像提示生成可探索的 3D 世界。
  • 場景會隨玩家輸入即時變化,而非只播放固定影片。
  • 可用於研究 AI 的場景理解與行動能力。
  • 長時間維持世界一致性的能力及量化表現,仍需更多資料評估。

對具身 AI、遊戲環境生成和世界模型研究者而言,Genie 4 提供一種建立互動測試場景的方向;一般使用者則可透過生成世界,直觀感受模型如何把提示轉化為可操作的環境。

項目主頁

Categories: AI productions, 模型, 世界模型, 模型訓練, Google, Video, Image, 3D

World-in-Context 讓世界模型即時切換視角

操控生成影片時,切換第一人稱、第三人稱與自由鏡頭,畫面仍要延續同一個世界。World-in-Context 以共享控制機制處理這項挑戰。

Alibaba Token Hub

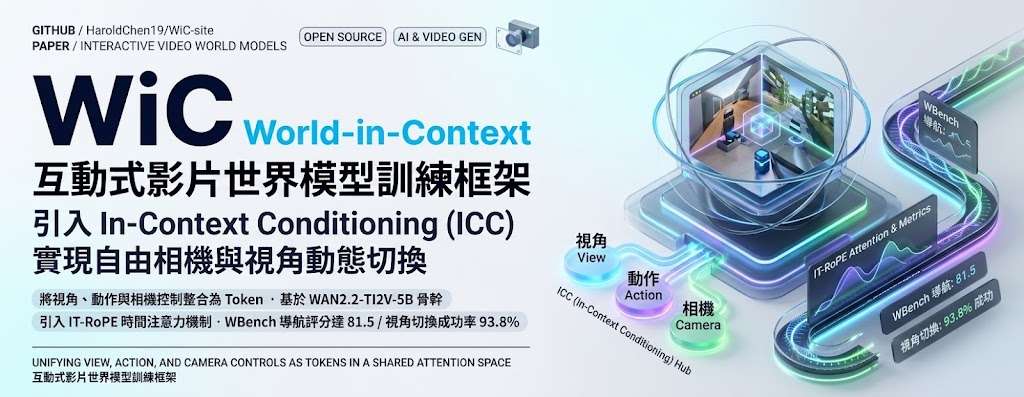
想在生成影片中移動鏡頭、改變觀看角度,甚至在第一人稱與第三人稱之間切換,畫面仍須保持連貫。World-in-Context(WiC)是為互動影片世界模型而設的訓練框架,目標是讓視角、動作和鏡頭控制在同一段影片中協同運作,而不是各自處理。

WiC 以 Wan2.2-TI2V-5B 作為基礎模型,透過 In-Context Conditioning(ICC)把視角、動作與鏡頭控制轉成共享注意力空間中的 tokens;Interaction-Transport RoPE(IT-RoPE)則把累積的控制變化納入時間注意力。這讓系統可支援自由鏡頭、第一人稱及第三人稱視角,也能在影片進行中切換,適合研究互動式場景生成、遊戲環境及長時間因果推演。

在 WBench 評測中,WiC 的導航平均分為 81.5,視角切換成功率為 93.8%。這些結果反映它能處理導航與鏡頭切換,但不能單憑分數判斷生成影片在所有場景都同樣穩定;GPU 記憶體需求亦會隨影片尺寸和設定改變。

目前程式碼、訓練程式及 WiC 權重仍在審核,尚未公開,因此現階段無法自行安裝並重現推理結果。計劃中的版本要求 Linux、Python 3.10,以及支援 BF16 的 NVIDIA GPU;預設生成設定為 832×480、81 幀、16 FPS 和 50 個採樣步驟,並預計提供 11 個包含起始圖片、提示詞與控制資料的範例。

  • 以 Wan2.2-TI2V-5B 為基礎,加入 WiC adapter。
  • 同一影片支援自由鏡頭、第一人稱與第三人稱視角。
  • WBench 導航平均分 81.5,視角切換成功率 93.8%。
  • 程式碼與權重尚未公開,現時未能重現結果。

對研究影片生成、虛擬環境導航或互動遊戲場景的團隊而言,WiC 提供一條把鏡頭與動作控制合併訓練的路線;但在公開程式碼和權重推出前,這些能力仍主要停留在研究成果與展示範例,還不能直接納入工作流程測試。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 提示詞, 框架, 3D, Linux, Python

Iching 64 Motion:《易經》六十四卦結構動畫

想看懂六十四卦如何生成、相互轉換,這部約三分鐘的動畫把卦象、數學關係與經典次序串成一條視覺線索。畫面和配樂均由程式生成,亦可自行預覽及渲染。

shot 8

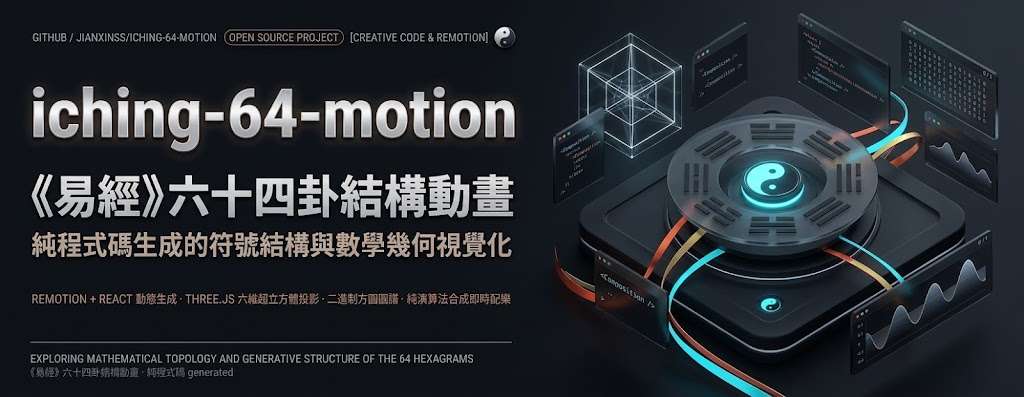
由陰陽爻逐步生成六十四卦,再看卦象如何倒轉、互換和變化,iching-64-motion 把《易經》的符號關係整理成一部約三分鐘的知識動畫。它是以程式製作的動畫項目,處理的是如何把抽象卦序和結構轉成可觀看的畫面;內容聚焦符號系統,不提供占卜解讀。

全片分成七章,從邵雍「加一倍法」帶出六十四卦的生成,再以方圓圖、錯卦與綜卦、互卦、變卦、文王卦序、十二消息卦和京房八宮呈現不同關係。陰爻記作 0、陽爻記作 1,六爻卦可讀成六位二進制數;改變一爻,則可視為在六維立方體的頂點之間移動。這些呈現方式讓讀者能從圖像理解卦與卦之間的連結,而非只看靜態卦名。

畫面由 React、SVG 和 three.js 生成,Remotion 負責把場景渲染成影片;六十四卦、卦序等資料由程式推導,配樂則以 Python、numpy 和 scipy 合成,並按畫面事件安排聲音。項目沒有使用外部圖片、影片或音訊素材,視覺與音樂都能納入同一條可重現的製作流程。這對製作資料驅動動畫、教學影片或展覽內容的創作者,提供了可參考的做法。

本機預覽需要 Node.js 18 或以上;可在 Remotion Studio 預覽,再渲染 MP4;不生成配樂仍可預覽畫面。

  • 資料由定義推導生成,涵蓋 384 爻及本卦、之卦的 4096 種組合。
  • 可預覽並渲染影片;生成配樂需要額外安裝 Python 科學運算套件。

GitHub

Categories: 開源, AI productions, Video, Image, Audio, 教學, 工具, Content Creator, Python, 動畫, 音樂

Page 2 of 28
1 2 3 4 … 28