ComfyUI-DeGrid:Qwen VAE 解碼網格修正

Qwen Image 解碼後的 2px 網格容易被放大流程強化,ComfyUI-DeGrid 讓修正可以在放大前自動完成。

Repository image for lunaaispace-eng/ComfyUI-DeGrid

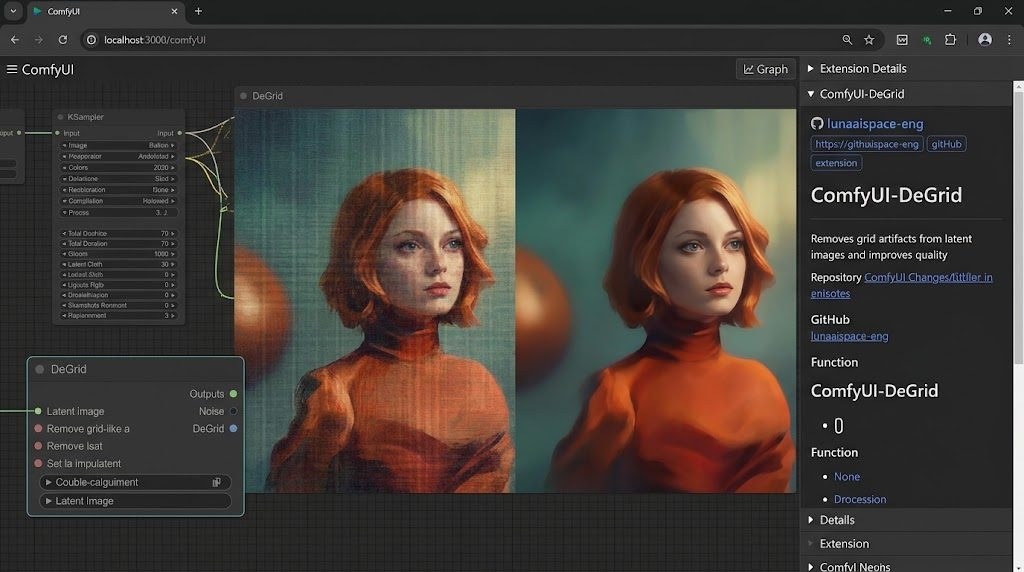
Qwen Image、Qwen Image 2.1 及部分 Wan 2.1 VAE 生成的平坦暗位,可能帶有不易察覺的 2px 像素網格;經過銳化或放大後,瑕疵會變成明顯紋理。ComfyUI-DeGrid 是一個 ComfyUI 影像修正節點,專門在 VAE Decode 後移除這種規律格線。

它採用 VAE DeGrid(Nyquist Notch)處理方式,auto 模式會逐張影像量度網格強度並自動設定修正上限,無需自行調參;未偵測到網格時則原樣傳遞。節點亦會顯示 grid 強度、修正上限及受保護邊緣比例,方便確認是否有執行過度。

安裝只需放入 ComfyUI/custom_nodes,依賴 torch,亦不需要 OpenGL 或 GLFW,因此可在 headless 環境運行。工作流應接成 VAE Decode → VAE DeGrid → 銳化、放大或 SeedVR2 等後續處理,因為縮放後才修正,可能已經太遲。

  • 支援以 Qwen Image、Qwen Image 2.1、Wan 2.1 VAE 為基礎的相關工作流
  • auto 模式按影像校準,manual 模式則可自行設定 limit
  • 可用 enabled 開關快速作 A/B 比較,關閉時完全不修改影像
  • 沒有提供速度或畫質基準測試,效益主要取決於輸入是否含有網格
  • 不應與 ComfyUI-SaveSimple 同時安裝,兩者包含相同的 VAEDeGrid 節點 ID

需要處理 Qwen Image 或 Anima 解碼瑕疵的創作者,會較容易感受到它對後續放大流程的幫助;但若工作流沒有相關 VAE,或影像本身沒有網格,節點只會增加一個檢查步驟,未必帶來可見差異。
GitHub

Categories: 開源, ComfyUI, AI productions, Qwen, Image, Content Creator

lanshu-create-ai-presenter-video:數字人影片 Skill:一張圖+文案自動生成完整講解影片

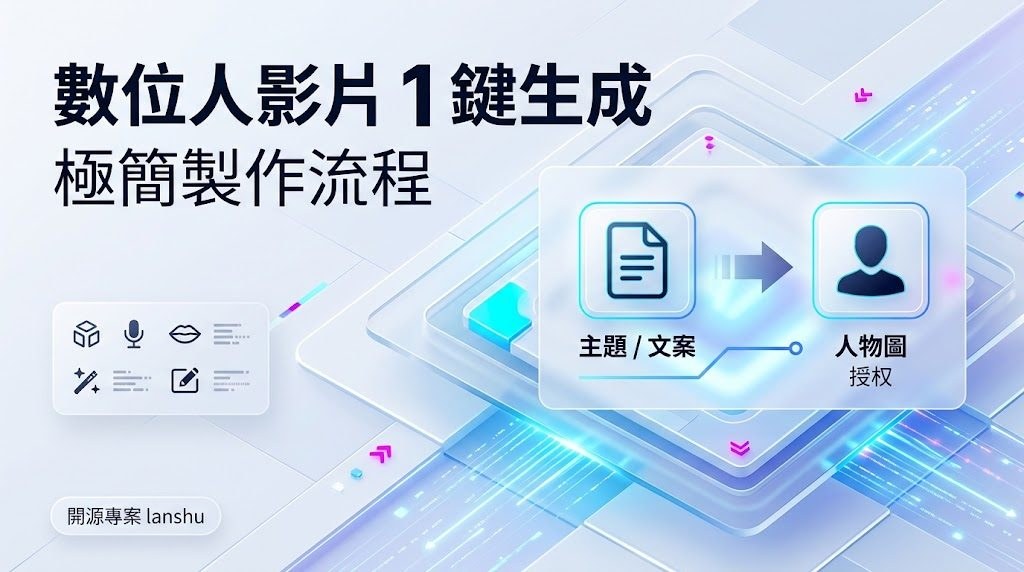
一個針對通用數字人影片製作 Skill。你輸入主題或文案,再加一張授權人物圖,它就會按完整配音時間軸組織生成、剪輯同驗收,輸出一條可發佈嘅講解片。

Repository image for cclank/lanshu-create-ai-presenter-video

做數字人講解片最麻煩嘅地方,往往唔係生成人物,而係口型、文字同聲音對唔齊,最後剪埋一齊就甩拍。lanshu-create-ai-presenter-video 嘅切入點正正喺呢度:佢將「完整配音」鎖定為全片時間基準,人物主素材、字幕、關鍵詞動效同鏡頭轉場都跟住呢條音頻排,從而減少口型漂移同片段接駁嘅問題。整個項目屬於 Agent Skill 工具,由 Codex 或其他兼容本地 Skill 嘅 Agent 環境直接調用,源碼本身唔綁定任何特定服務商、模型或私有接口,可以按當前環境可調用嘅能力動態選擇配音、人物生成同口型同步工具。

最低門檻只需要一份主題或文案,再加一張已授權、包含清晰成年人物嘅參考圖。聲音樣本、屏幕錄影、B-roll、品牌素材、目標平台、時長、橫豎屏同風格等都係可選輸入,畀進階用戶調整。Skill 目錄會隨階段讀取對應參考文檔:generation.md 處理文案、聲音、能力選型同人物提示詞;editing.md 負責時間軸、字幕預設、封面同導出;qa-recovery.md 處理技術驗收、人工驗收同常見故障修復,避免一次過佔用過多上下文。

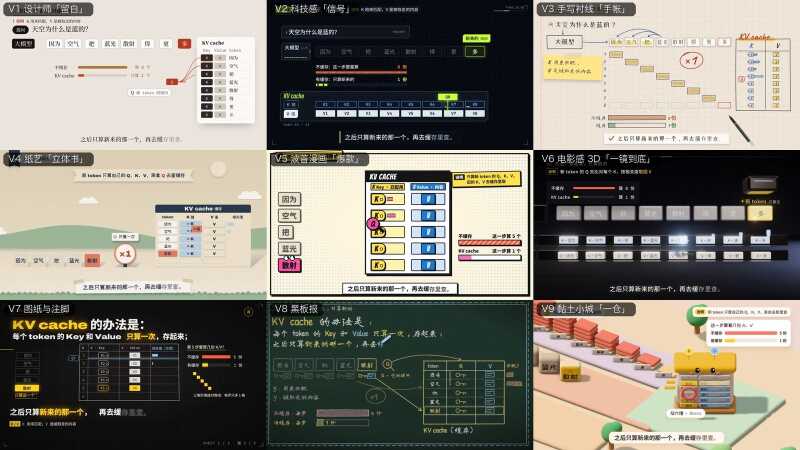
key名称the look · 画面best for · 适合3D
v1-editorialV1 设计师「留白」warm paper, ink, one vermilion accent, data blocks, page turns · 暖白纸、墨色、一抹朱红,大留白serious, premium explainers; business and product topics · 严肃、高级感、商业与产品no
v2-signalV2 科技感「信号」dark HUD, acid-lime accent, labels decode in, packets on wires, glitch cuts · 暗色仪表盘、荧光绿、数据包流动AI / infra / networking, anything “system-like” · AI、基础设施、网络、系统类no
v3-notebookV3 手写衬线「手帐」grid paper, a live pen writes every word, sticky notes, eraser · 方格纸上真笔书写、便利贴、橡皮擦teaching step by step, derivations, study notes · 一步步推导、学习笔记、教学no
v4-paperV4 纸艺「立体书」kraft pop-up book, pieces fold up with soft shadows, parallax · 牛皮纸立体书、折起的纸片、视差warm stories, processes, consumer topics · 有温度的故事、流程、大众话题no
v5-comicV5 波普漫画「爆款」halftone comic page, stickers slam on, bursts and sound words · 半调网点漫画、贴纸拍入、爆炸字punchy short videos, hot takes, myth vs fact · 节奏快的短视频、观点、辟谣no
v6-cinematicV6 电影感 3D「一镜到底」Three.js one-take in a graphite studio, porcelain props, bloom · 一镜到底的 3D 影棚、瓷质道具、辉光flagship pieces, launches, big-picture concepts · 旗舰内容、发布、宏观概念yes
v7-draftingV7 图纸与注脚one black drawing sheet, leader lines, ghost-letter karaoke, true footnotes · 黑色图纸、引线、注脚、卡拉OK式大字technical deep dives for practitioners · 面向从业者的技术深挖no
v8-chalkboardV8 黑板报a wooden blackboard written live in chalk, felt eraser, chalk mind map · 木框黑板、粉笔现写、板擦、粉笔脑图复习classroom feel, beginners, memory-friendly recaps · 课堂感、入门、便于记忆no
v9-clayV9 黏土小城「一仓」an isometric plasticine town, every analogy labelled with its real term · 等距黏土小城,比喻 + 真实术语标签analogies for non-experts, cute and friendly · 用比喻讲给外行、可爱亲和yes

預設輸出係 9:16、1080×1920、30fps 豎屏,時長 45 至 75 秒,發佈響度目標約 -16 LUFS。初始化可透過 init_job.py 自動建立標準任務目錄同 job.json,preflight.py 會做前期檢查,最後由 finalize_delivery.sh 收尾輸出,同時產出 QA 報告。環境要求 Python 3.9+、FFmpeg/ffprobe、Bash、jq、awk、sed,以及至少一種可調用嘅影片生成、語音生成同口型同步能力。

佢唔係一個獨立嘅模型,而係一套組織數字人影片工序嘅 Skill 框架,價值在於把配音、人物、字幕、剪輯、驗收等步驟統一在同一條音頻時間軸上,避免最常見嘅口型錯位同片段斷裂。內容創作者、行銷團隊、課程錄製同需要快速產出講解影片嘅場景會較受惠,特別係想喺不同 AI 服務商之間靈活切換、又唔想被單一平台鎖死嘅人。

  • 以完整配音為全片時間基準,減少口型漂移同片段接駁問題
  • 源碼不綁定服務商或模型,可按環境動態選擇配音、人物、口型工具
  • 三份參考文檔按階段讀取,控制上下文用量
  • 預設 9:16 豎屏、1080×1920、30fps、主題片長 45–75 秒
  • 支援聲音樣本、B-roll、品牌素材、平台、橫豎屏等可選參數

GitHub

Categories: 開源, Agentic, AI productions, 數字人, Video, Audio, 提示詞, 框架, Content Creator, Python, 語音, Skill 技能

XGEN-JING 世界模型開源:邊走邊生成影片與音效

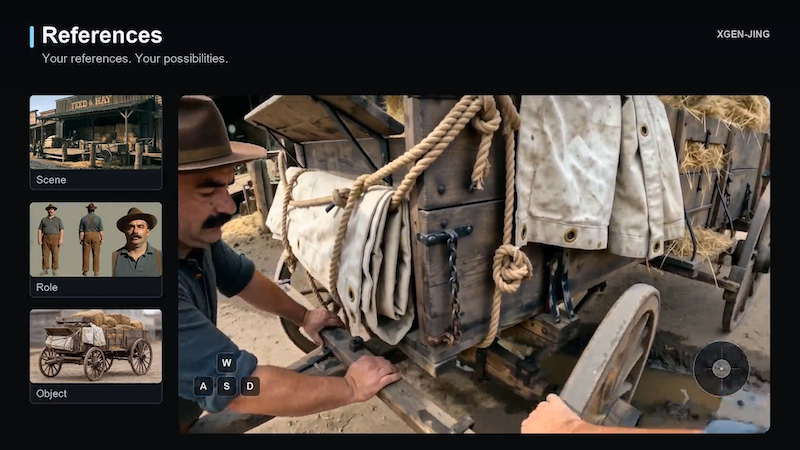
XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

LynnReal-Omni 把十幾種影片任務塞進一個 32B 模型

一個 32B 多模態擴散 Transformer,同時做文字生影片、圖生影片、動作控制、風格遷移、影片修復同長影片串流。Flash 版本更可喺單張 H100 上 377 毫秒出 22 帧 540p 短片。

LynnReal-Omni — Standard four-step and Flash three-step multimodal generation

LynnReal-Omni 想解決嘅,係影片生成工具鏈最煩嘅一件事:每加一個任務(動作控制、參考影像、風格遷移、編輯、修復)就要疊多一個模型或多一套 pipeline。作者選擇用一個 32B 共享多模態擴散 Transformer(跟 MiniMax H3 架構)一次過承載文字生影片、圖生影片、人體與手部姿勢控制、結構控制、omni-reference、風格遷移、影片編輯、退化影片修復,以至串流式長影片生成,仲可以接駁外觀參考、可編輯 3D render、遊戲錄影等異質輸入,等 Agent 可以喺同一個模型內組合視覺條件。

對比同類做法,最大差異係「統一框架」而非「任務專用模型」。每個源帧獨立編輯再組裝成無聲 24fps 影片,每帧只需四次 DiT forward,120 帧即 480 次 forward。輸入限制清楚:24fps、寬高需為 32 倍數、目前只支援 768p(1344×768 起手)。獨立逐帧編輯會帶來亮度或形狀嘅帧間抖動,作者亦坦白標示為已知限制。

對短片創作者、遊戲或 3D 團隊、Agent 開發者來講,好處係少咗一套模型接駁嘅工程成本;Agent 可以直接用外觀參考同 3D render 嚟組裝條件。Flash 版本(27B、三步生成、輕量 VAE decoder)將單張 H100 上 22 帧 540p 由 843 毫秒壓到 377 毫秒,為實時或互動應用鋪路。

項目已提供 ComfyUI workflow 涵蓋 t2v、i2v、r2v、pose2v、v2v 幾個入口,但作者明言仲係早期 beta,質量、兼容性同 bug 仍然存在,訓練代碼、部分訓練數據同更高效 DiT 預計稍後釋出。打算用佢做關鍵流程嘅團隊,宜先以小批量預覽(--indices 0,24,48 --keep-clips)確認穩定性再評估是否引入生產。

重點摘要:
– 一個 32B DiT 模型覆蓋十幾種影片任務,Agent 可直接組合異質視覺條件
– 每源帧四次 DiT forward,120 帧共 480 次;輸入限 24fps、寬高需 32 倍數、768p
– Flash 版本用 27B 加輕量 VAE,單張 H100 上 22 帧 540p 暖機生成耗 377 毫秒
– 獨立逐帧編輯會產生帧間亮度與形狀抖動,屬已知限制
– ComfyUI 支援 t2v、i2v、r2v、pose2v、v2v,目前屬早期 beta,訓練代碼尚未開源

GitHub · 模型

Categories: 開源, ComfyUI, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 框架, 工具, Content Creator, 3D, MiniMax

video-to-h3-prompt SKILL:逐幀反推參考影片,自動生成可貼即用 H3 提示詞

項目把『看幾幀就寫 vibe』的拍腦袋流程,換成五通道取證管線:密集抽幀、音頻交叉驗證、因果事件鏈、剪輯層分離,最後產出對應 MiniMax H3 五種輸入模式的完整模板。

Repository image for LoveRain1997/video-to-h3-prompt

如果你試過把一段參考影片丟給 AI 影片模型、要它重做或延伸,應該都撞過同一面牆:憑『整體 vibe』寫提示詞,往往會錯過動作、把 BGM 誤認為現場聲。今次做的是把這個『創作猜測』變成可驗證的逆向工程,輸出可直接貼進 MiniMax H3 的提示詞骨架。

做法上,它不放棄『一對多逆問題』的本質——同一段畫面,背後劇本可以是 A 也可以是 B。它讓多個候選劇本同時存在,再用 4–8fps 密集抽幀和 0.5s RMS 去裁決哪個版本站得住。同時,頻譜圖負責分辨音樂與環境聲。

它對剪輯層的處理也相當細:定格哏、白色閃屏、漫畫風的集中線/網點/狀聲詞,全部歸入 editing 與 overall_soundscape,不會和實景動作混在一起。因果事件鏈(trigger→action→reaction)則把袖口、單手、車頭外殼這類畫面邊緣的施力者也算進演員名單,避免關鍵 3–5 幀就這樣消失。

對 Coser/換角場景,它只換外表不改劇本,再做動作相容性檢查、分級道具,並把動漫設定翻譯成真人 cosplay,最後吐出一張替換表。輸出端覆蓋 T2VA、I2VA、FL2VA、L2VA 的 14 欄模板,以及 Ref2VA 的六段模板,全部用 <Subject>/<Picture>/<Video>/<Audio> 標籤紀律收束。

適合想用影片反推 AI 影片提示詞的人:二創作者、廣告分鏡、動漫改編的工作流。比起『看幾幀就 vibe』,它的取捨是慢、但每一步都有可追溯證據;代價是要提供參考影片與可選劇本線索,並接受密集取證帶來的額外處理成本。

重點摘要:
– 五通道取證管線取代單一直覺寫 prompt
– 密集抽幀 + 音頻峰值用作裁決證據,而非裝飾
– 剪輯層、漫畫後製、鏡頭外施力者都獨立建模
– 覆蓋 H3 五種輸入模式,欄位與標籤紀律齊備
– 換角只動外表,動作相容性與道具分級有 SOP

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, Video, Audio, 提示詞, Content Creator, MiniMax, Skill 技能

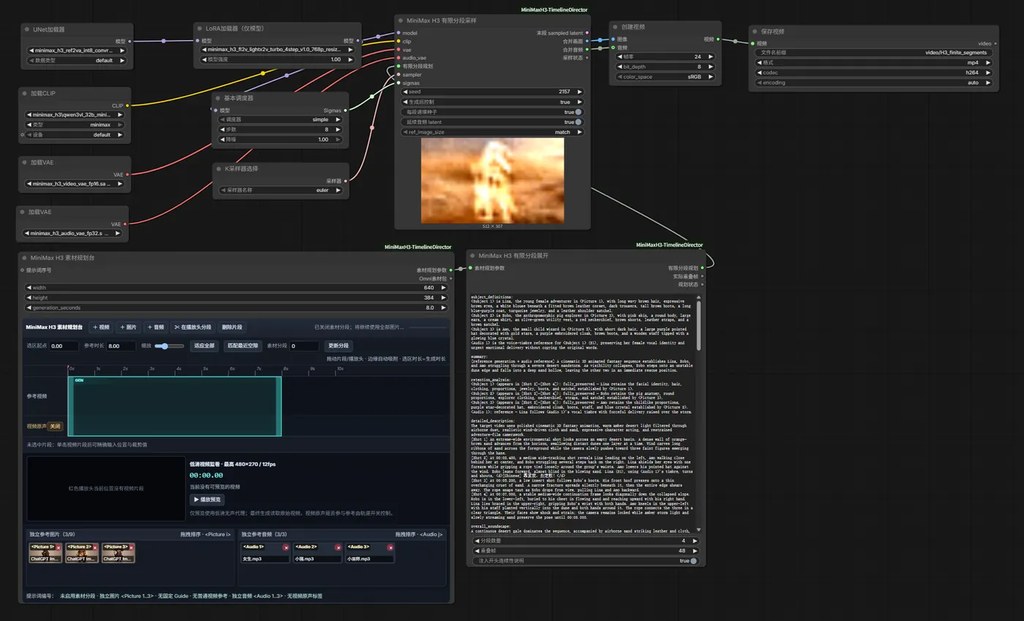
ComfyUI-MiniMaxH3-TimelineDirector:一張圖跑出無斷點長影片

想在 ComfyUI 內一次過生成超過一分鐘的影片,又要角色口型與背景音樂全程對得齊?這套 MiniMax H3 Timeline Director 插件把分段、續接、漂移修正全部收埋喺一張圖。

Creator WeCom contact card

MiniMax H3 官方最令人卻步嘅限制之一,就係單次生成時長偏短,想做一段完整 Demo 或者長 Demo 都要靠 Loop 節點逐段駁,駁完口型同音軌成日走樣。ComfyUI-MiniMaxH3-TimelineDirector 嘅切入點正正喺呢個位:佢提供一個 Full Timeline Director 工作流,把 T2V、Image Reference、音訊驅動、角色替換、動作遷移、數字人同一條龍長片生成,全部塞入同一張 ComfyUI 圖。

插件會把目標時長拆成連續 GEN 窗口,並用同一個共享 seed 串接前一段嘅 AV-latent 尾部,配合 Drift-Control 影片遮罩同 Soft AV 音訊連續性處理,再做 overlap 移除並最終同步輸出成片。長度上限唔再由 Loop 節點或者重複 Sampler 鏈決定,而係睇本地 VRAM、RAM、磁碟空間同 ComfyUI 執行限制。

佢同一般「駁長片」做法最大嘅差異,係對齊音訊嘅方式。當你將一段長 MP3 標記為 Locked Original Audio,插件會將聲音按 sample 位置精確切片,注入每段 AV latent,並以零音訊降噪遮罩保留;Timeline 比音源短就截斷,比音源長就用靜音補尾,用戶唔使再人手對 MP3 metadata 或 codec priming delay。Long-form digital humans 同角色演唱場景亦靠同一條路徑處理:角色圖同長 soundtrack 鎖定後,手動 GEN 窗口即可逐段推出口型同步。

時間軸方面,每段 Clip 設有三種模式——Fixed Guide、Editable Reference、Boundary Only,支援 move、trim、split、delete、snap 同數值定位;只有同 cyan 生成範圍相交嘅媒體先會進入當前 Reference 或 Guide 計劃,避免雜訊干擾。

實際最易受惠嘅人,係要做完整 MV 級 Demo、產品概念片、教學影片、或者 AI 短劇分鏡嘅創作者同中小型團隊。官方已放出兩條約 52.6 秒 / 1263 幀嘅直接生成示範,包括純 latent 續接同 48 幀 Reference overlap 兩個 case,可直接喺 GitHub Release 拎 MP4 對照效果。

  • 類型:ComfyUI 插件 / 時間軸導演工具
  • 核心能力:一張圖內分段續接生成無斷點長影片,音訊 sample-sliced 注入 AV latent
  • 同類差異:唔靠通用 Loop 節點或重複 Sampler 鏈,直接由 AV-latent 尾部續接
  • 適用場景:長片數字人、角色演唱、概念片、教學影片等需要連貫長片嘅創作
  • 部署方式:經 ComfyUI Manager 或手動放入 custom_nodes 目錄後啟動 ComfyUI,載入 example_workflows 內嘅 All-in-One 工作流即可

項目主頁 · GitHub · Youtube 教學

Categories: 開源, ComfyUI, AI productions, 數字人, Video, Image, Audio, 教學, 工具, Content Creator, 音樂, MiniMax

World in World 把 14B 世界模型變成你的虛擬攝影機

想用一條普通影片就做到 360 度重拍、子彈時間、視角切換?World in World 讓凍結的 14B 影片世界模型 LingBot-World 2.0 直接「走進」影片,無需微調,單卡 80GB GPU 即跑。

pipeline

對於做特效、剪輯或沉浸式內容的人來說,最頭痛的往往不是生成新畫面,而是手上明明有一段拍好的影片,卻想換個角度、換條鏡頭軌跡重新「拍一次」。Westlake-AGI-Lab 推出的 World in World,正是針對這個卡位:給定一段輸入影片和一條新相機路徑,模型會重新生成同一事件在新視角下的畫面,不用訓練、不用微調。

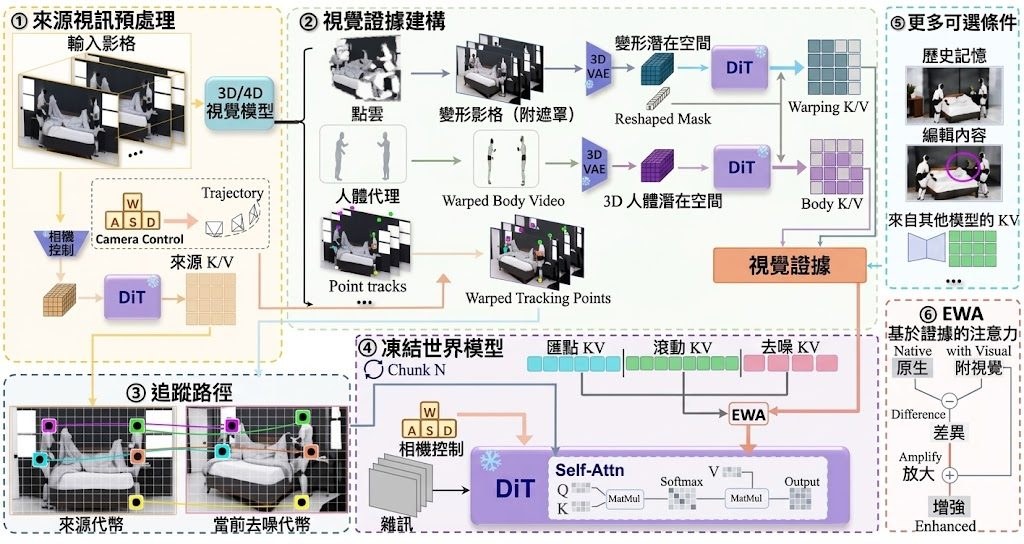
它本質是一個影片再攝影框架,骨幹是一個凍結的 14B 影片世界模型 LingBot-World 2.0。技術上沒有走 latent editing 或 GAN 反轉的老路,而是把所有可控制的訊號——來源影片、場景幾何、相機參數——全部變成視覺證據:先用深度把來源幀提升到 3D,依新相機路徑 warp 過去,再當成額外 key/value 塞進模型自己的 attention,讓模型「看到」新相機應該看到什麼,缺失的部分由它自己補完。這種做法讓相機軌跡、人物動作與場景幾何保持高度一致。

從結果來看,它已經放出自由相機重拍、子彈時間和影片編輯三項功能;大型角度 360 度重拍結合 3D 人體代理、跨模型記憶共享、長影片 frustum memory、串流互動生成、動作遷移等仍在路線圖中。對特效團隊、短片創作者、遊戲過場預覽、AR/VR 內容開發者來說,可以用一條現成素材快速產出多視角版本,而不必從零生成或手動三維重建。

官方在 Linux 上以 80GB A100 測試,峰值記憶體約 72GB,需 CUDA 12.4 與 Python 3.10,並預編譯 flash-attn wheel 以避免從源碼編譯。相較同類影片重生成方案,它放棄了對模型本體做適配,以 warp + attention injection 換取「即插即用」與較低硬體門檻,但代價是大角度旋轉、人物遮擋等極端情況仍依賴後續的 3D 代理與 frustum memory。

  • 凍結模型免訓練:以 warp 後的視覺證據作為 attention key/value,無需微調 14B 世界模型。
  • 多視角影片重拍:支援弧線、推拉、平移、定點旋轉等自由相機路徑。
  • 子彈時間與影片編輯:凍結任意一幀改變視角,或改第一幀讓編輯自然延伸至整段。
  • 單卡 80GB 可跑:Linux + A100 + CUDA 12.4 + Python 3.10,硬體門檻相對可控。
  • 路線圖仍在擴展:360 度重拍、跨模型記憶、串流生成等功能陸續排程中。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, 3D, Linux, Python

MiniMax H3 首尾幀工作流:ComfyUI 一張面板切換三模式、輸出帶聲影片

這個 ComfyUI 工作流把 MiniMax H3 的首尾幀、Turbo LoRA、影片與音訊 VAE 全部封進子流程,外層直接選模型、改步數與時長,最後由 SaveVideo 輸出 24fps 的帶聲短片。

MiniMax H3 总控面板使用指南

想用兩張圖片框住一段六秒帶聲音的影片,再順手在 ComfyUI 面板上換模型、改步數,這個工作流把這件事收得很緊。整套流程把 MiniMax H3 的基礎模型、Qwen3-VL 文本編碼器、影片與音訊 VAE,以及四步 Turbo LoRA 全部塞進一個子流程,常用參數留在外層,內層只負責解析度對齊 32 倍數、計算幀數、把影片與音訊解碼後合成輸出。

跟一般 ComfyUI 影片節點相比,它最直接的差異是「首尾幀可選」:上方節點接首幀、下方節點接尾幀,兩個都填就是首尾幀生成,只填首幀就退回傳統圖生視頻,兩個都跳過則變成純文生視頻,三種模式不用複製工作流,直接在同一張畫布切換。音訊方面也省事,音訊 VAE 跟影片 VAE 分開載入,輸出端靠 SaveVideo 一次寫入 mp4,不用再手動合成聲道。

部署門檻主要在三個地方:ComfyUI 要支援子圖功能、要額外安裝 ComfyUI-MiniMax-H3-Turbo 節點包以取得 MiniMaxH3TurboLoRA,以及 Hugging Face 上的五個權重檔案要放到對應的 diffusion_models、text_encoders、vae、loras 目錄。JSON 內只記錄檔名而非圖片本體,使用前要把首幀、尾幀重新上傳;工作流也沒有附帶顯存或速度數據,必須自己測試本地硬體夠不夠撐得起 int8 基礎模型加 Qwen3-VL 32B 文本編碼器。

對已經在跑 ComfyUI、又想試 MiniMax H3 首尾幀能力的人,這個工作流算是最低摩擦的入口:不用自己接駁一堆節點,也不用研究子流程內部的取樣細節,外部面板就涵蓋了模型選擇、步數、目標時長、種子、寬高比與百萬像素等設定。對只想快速驗證概念或做短影音素材的內容創作者,這種「拉進畫布、換圖、寫 prompt、執行」的流程會比從零搭建省下不少時間。

重點摘要

  • 類型:ComfyUI 工作流 JSON,屬於模型整合與流程封裝類工具,目標是簡化 MiniMax H3 帶聲影片生成。
  • 核心能力:首尾幀、首幀圖生視頻、文生視頻三種模式可切換,並內建音訊解碼與合成。
  • 關鍵依賴:ComfyUI 需支援子圖,另需安裝 ComfyUI-MiniMax-H3-Turbo 節點包與五個 Hugging Face 模型檔案。
  • 輸出規格:24fps,寬高自動對齊 32 倍數,時長與步數可在外層調整。
  • 限制:未提供顯存峰值、速度與相容性測試,需自行驗證本地硬體;JSON 內只存圖檔名,圖片要重新上傳。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, Video, Image, Audio, 工具, Content Creator, MiniMax

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, 庫, 語音, Anthropic, 動畫, Skill 技能

MiniMax H3 Director Studio:Windows 本地模型做 AI 影片前期製作

Director Studio 是一個本地優先的前期製作工作空間,串接 Ollama 規劃鏡頭、ComfyUI 生成畫面,再交由 MiniMax H3 出片,特別適合想完全控制創作流程的獨立創作者。

Repository image for ai2764/Director-Studio

想在本地完成 AI 影片從構思到成片的整條前期流程,而不依賴雲端訂閱?Director Studio 正是針對這個需求的工作空間類工具。它把鏡頭規劃、可重用的視覺與語音資產管理、以及 MiniMax H3 Ref2AV 提示詞撰寫,整合在同一個介面內,最後透過 ComfyUI 與 MCP 協議生成圖像與影片。

與一般 ComfyUI 前端不同,它把「規劃 Agent」綁定在本地 Ollama 上運行,並與 ComfyUI 共享 VRAM,避免兩者搶顯存。用戶可以選擇全本地流程,亦能把 H3 影片交給官方 MiniMax API 處理,兼顧靈活與效能。內建的 typed asset library、演員與場景工作流、可編輯的 Picture/Audio 參考、以及六段式 H3 提示詞結構,讓鏡頭設計不再是憑感覺亂試。

Qwen3.8 27B Directs H3 | Director Studio Is Now Open Source

對於獨立創作者、小型製作團隊,或需要反覆迭代鏡頭分鏡的人,這套工作流省下了在不同工具間切換的成本。Windows 用戶只要安裝 Ollama、ComfyUI Desktop 與 Python 3.10+,再解壓官方 zip 即可透過 DirectorStudio.exe 啟動,所有資料儲存在執行檔旁的 data 目錄,方便升級前備份。

採用 FastAPI 後端配合 Vite + React 前端,規劃 LLM 透過 Ollama 執行,生成層則透過 ComfyUI MCP 串接。架構與擴展點已在 docs/ARCHITECTURE.md 說明,適合想自行修改管線的進階用戶。

需要注意,VRAM 是這套系統的瓶頸:Ollama 與 ComfyUI 需共享顯存,若要同時運行大型本地模型與高解像度影片工作流,硬體門檻不低。對於偏好全雲端、或無獨立顯卡的用戶,這套方案未必比 SaaS 工具方便。

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, 模型, 多模態模型, API, Video, Image, Audio, 工具, Content Creator, Ollama, Python, 庫, MiniMax

Page 4 of 5
1 2 3 4 5