Digital Human Koubo:一句需求生成數字人口播廣告,連聲音也自動完成

相片加一句需求,就能串起數字人口播、字幕與影片包裝;代價是依賴外部雲端生成。

一張相片加一句需求,便可生成有數字人口播、字幕和促銷包裝的短片。andyhuo520/digital-human-koubo 是由人工智能(Artificial Intelligence,AI)代理執行的影片工作流,串連文案、對嘴、聲音整理和剪輯。

主持人設定存於 persona.json,固定外觀和聲線描述;GPT Image 合成場景後,Grok Video 1.5 經 Renoise 的 Model Context Protocol(MCP)製作每段最多 15 秒的口播片。按 SKILL.md 配置代理並連接服務後,可先看倉庫示例;其中一條 27 秒廣告耗用 482 Renoise credits,不能視為固定價格。

  • Whisper 逐段轉錄核對文稿,每段檢查 4 格畫面;若畫面出現生成字幕,該段會重做。
  • 頻譜匹配、去齒音及響度標準化協助統一分段聲音;測試中的齒音差距由 13.2 dB 降至 5.9 dB。
  • 48 項影片包裝手法參考 25 條創作者影片整理,可按需要增減。

這套流程適合需要反覆製作商品介紹或社交平台短片的小型內容團隊,也能把文字置於主持人身後。成品仍受外部模型服務和點數成本限制,使用前宜先檢查口型、畫面及人物一致性。

GitHub

Categories: 開源, AI productions, MCP, 數字人, 模型, Video, Image, Audio, Content Creator, 庫, Skill 技能

CapCut 以外,Concat 把影片剪輯搬回本機

想剪片但不想上載素材、註冊帳戶或處理浮水印?開源影片編輯器 Concat 提供本機字幕、語音與多軌剪輯功能。

Concat

剪短片、上字幕、替換背景,卻不想先建立帳戶,把原片交給雲端平台處理,Concat 提供了另一條路。這個跨平台開源影片編輯器把自動字幕、文字轉語音、聲音複製、背景移除、多軌剪輯及 4K 匯出放進同一個介面,支援 macOS、Windows、Linux 與 Android。

Concat 屬於桌面及流動裝置影片編輯工具,核心特色不是追求完整取代所有專業軟件,而是針對 CapCut 常用的剪輯流程,減少上載素材及依賴訂閱的摩擦。自動字幕由本機 Whisper 處理,選擇模型大小後即可把字幕放上時間軸,再配合文字轉語音、關鍵幀動畫、特效及標題完成內容製作。

這項取捨十分清楚:素材可完全留在本機,離線工作,不會因平台政策改變而失去作品控制權;但代價是本機運算能力會直接影響字幕生成等功能的處理速度。Concat 亦提供語音複製,只需數秒錄音便可建立聲音,適合處理旁白、角色對白及多語言版本,背景移除則涵蓋人物、物件,亦可自行修正遮罩。

  • 支援 macOS、Windows、Linux 及 Android
  • 本機 Whisper 自動字幕,無須上載影片
  • 提供文字轉語音、聲音複製及背景移除
  • 支援多軌剪輯、關鍵幀、特效、標題與 4K 匯出
  • 無浮水印、無需帳戶,亦沒有上載限制或訂閱費用

對內容創作者、獨立製作者、教育工作者及需要處理敏感素材的團隊而言,這是一套頗完整的本機工作流。多軌剪輯、位置、縮放、旋轉、透明度及音量關鍵幀控制,令它不只停留在簡單裁片工具;惟目前版本號仍為 0.2.8,跨平台的成熟度、介面細節及不同裝置上的匯出表現,仍須經實際作品驗證。

GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, Video, Audio, 軟件, 工具, Content Creator, Mac, Linux, 語音, 動畫

video-use:一句指令把素材剪成 final.mp4

video-use 將 Claude Code、FFmpeg 與 AI 動畫工具串成影片剪輯流程,適合需要快速製作短片的創作者與內容團隊。

video-use

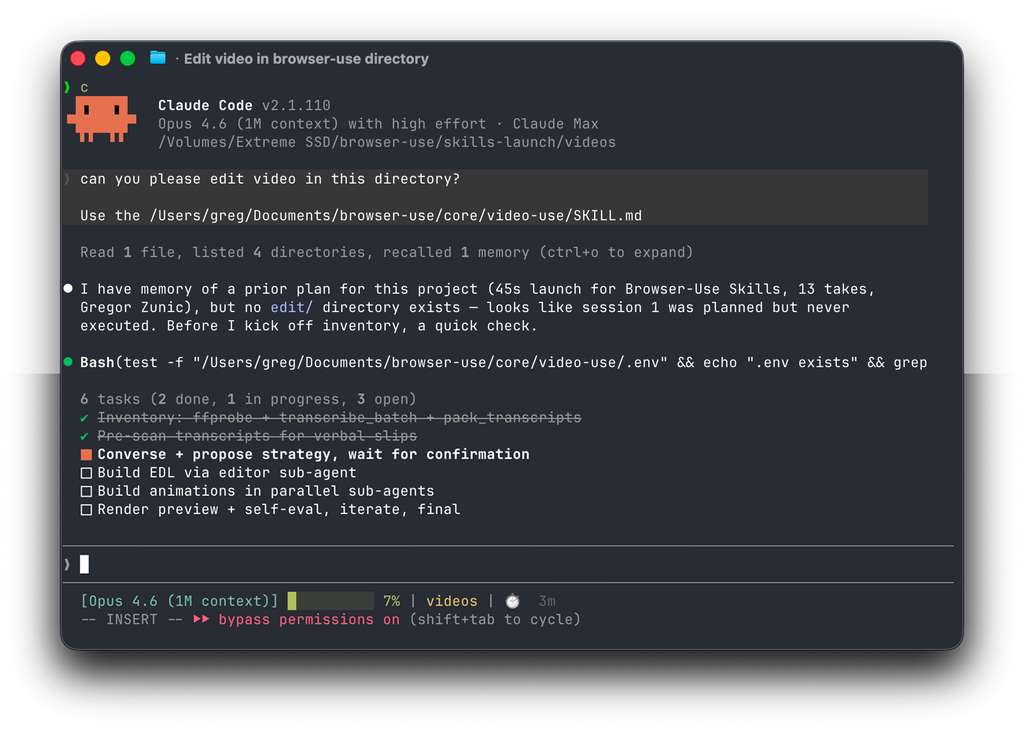
剪片最花時間的往往不是逐格拖拉,而是刪去口誤、停頓、重拍,再處理字幕、調色和動畫。開源項目 video-use 將這些工作整合到 Claude Code 對話中:把原始素材放入資料夾,提出剪輯要求,確認方案後便可取得 final.mp4。

它屬於 Agent 影片剪輯工具,依賴 FFmpeg、ElevenLabs API,以及支援 shell access 的 Agent;Claude Code、Codex、Hermes、Openclaw 等均可按技能方式整合。Agent 會先盤點素材並提出策略,待你確認後才進行剪輯,亦可用 project.md 保存跨次工作的記憶。

  • 自動移除「umm」、「uh」、重試開頭及拍攝間的空白
  • 支援預設或自訂 FFmpeg 調色,並在剪接點加入 30ms 音訊淡出
  • 預設以每兩字一個大寫單元燒錄字幕,樣式可自行調整
  • 可並行呼叫 HyperFrames、Remotion、Manim 或 PIL 製作動畫疊層

這種做法省去大量重複剪輯操作,也毋須在預設項目與選單之間來回切換。代價是成果會受素材品質、Agent 判斷、FFmpeg 設定及 ElevenLabs 服務影響;影片內容、關鍵 API 費用與電腦運算資源仍要由團隊控制。它適合對話式影片、教程、旅遊片段、訪談及社交媒體短片,但複雜敘事和高度精準的專業後期仍需要人工覆核。

影片輸出前,工具會逐個檢查剪接點,協助發現突兀轉場或音訊爆音;然而自我評估並不等同真人審片。採用這個項目時,重點不在追求完全自動,而在讓 Agent 先處理機械而重複的工序,把最後一輪節奏、內容與品牌審校留給創作者。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, Audio, 工具, Content Creator, OpenClaw, Anthropic, 動畫, Skill 技能

AI Toolkit 把擴散模型訓練搬上消費級硬件

將多種新式圖像與影片模型放入同一套訓練工具,兼顧 GUI、CLI 與本地環境管理。

AI Toolkit UI

想在家用硬件微調 FLUX、Qwen-Image 等模型,過往往往要自行處理環境、依賴與介面;Ostris AI Toolkit 把這些繁複步驟整合成一套擴散模型訓練工具。官方資料未提供完整安裝指令,但建議透過儲存庫內建的 AI Toolkit Manager 啟動。

AI Toolkit Manager 會偵測硬件並配置合適的 PyTorch 版本、建立 Python 環境,以及下載 Node.js 和 FFmpeg,所有檔案留在 ai-toolkit 資料夾內,不會系統級安裝。啟動時亦會檢查更新;若本機檔案經修改,更新會跳過並發出警告,減少覆蓋自訂設定的風險。

它屬於開源訓練套件,可透過 GUI 或 CLI 操作,涵蓋圖像及影片模型訓練。模型支援範圍頗廣,包括 FLUX.1、FLUX.2、FLUX.2-klein 4B/9B、Lumina-Image-2.0、Qwen-Image-2512、SDXL,以及 Chroma、HiDream、OmniGen2、Z-Image、ERNIE-Image 等新式架構。

  • 以消費級硬件為主要目標,縮低本機訓練門檻
  • 同一套工具支援多種新舊擴散模型
  • GUI 與 CLI 並存,兼顧互動操作及批次流程
  • 依賴與模型資源集中管理,減少系統污染
  • 保留本機修改,並在更新衝突時給出警告

相較只針對單一模型或只提供訓練腳本的做法,AI Toolkit 的優勢是將模型選擇、環境配置與操作介面放進同一工作流。不過,原始資料沒有交代各模型的訓練速度、記憶體需求或量化設定,硬件是否足夠仍要視模型大小與訓練配置而定。

這套工具較適合需要建立角色、產品或風格資料的設計團隊、內容創作者,以及想在本地微調開源模型的開發者。模型及環境檔案仍佔用大量磁碟空間,影片模型亦可能帶來更高記憶體與運算負擔,部署前宜先核對個別模型的條件。

GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Stable Diffusion, Video, Image, 工具, Content Creator, Python, 庫, 百度

ComfyUI-CharacterCardStudio:Qwen-Image 2.1 角色多視圖自動排版

將角色圖、提示詞與場景圖交給 ComfyUI 插件,自動生成多視圖、表情及細節,再精準拼成設定卡。

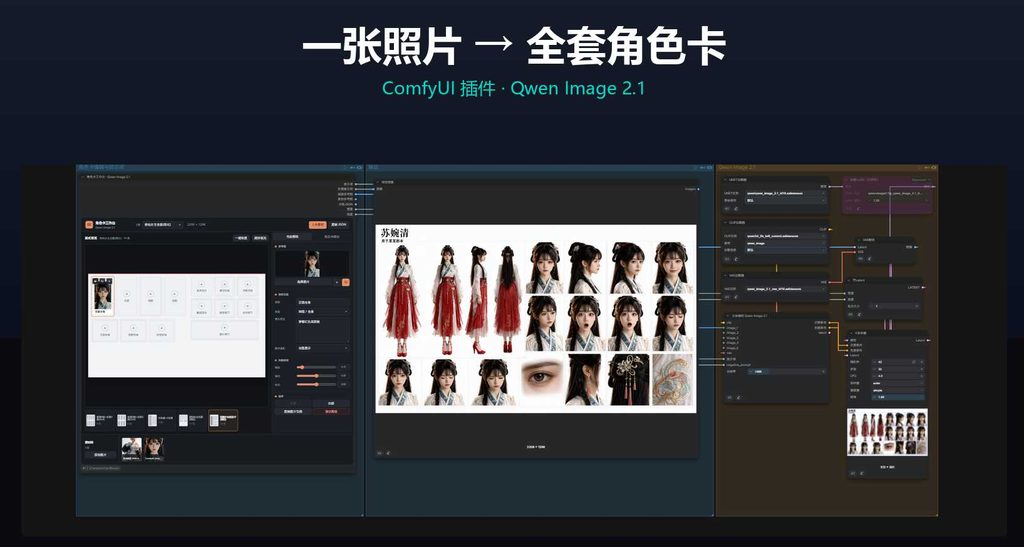
手工製作角色設定卡最費時的,往往不是生成單張圖,而是補齊正反面、表情、動作,再逐格貼圖兼避免裁走頭腳。JGRFW/ComfyUI-CharacterCardStudio 屬於 ComfyUI 圖像生成插件,針對 Qwen-Image 2.1 將多視圖生成、切片、排序同排版整合成工作流程。

  • 支援角色參考圖及純提示詞兩種生成入口
  • 提供 8 套角色卡版與 1 套 360° 場景卡版
  • 自動切片、重排,並預設完整顯示全身
  • 可分項生成多視圖、動作、表情與細節
  • 右側面自動鏡像,統一由模板決定位置

安裝方式是把儲存庫資料夾放入 ComfyUI 的 custom_nodes 目錄,再重啟 ComfyUI;README 同時提供圖生卡、文生卡、純提示詞及場景補面的工作流。模型選擇方面,插件使用 Qwen-Image 2.1 的 UNET、CLIP 與 VAE,亦為記憶體較緊的環境列出 int8 模型選項,但實際仍需自行準備相應檔案。

插件最實際的價值在排版,而非提升 Qwen-Image 2.1 本身的生成能力。切片節點可讀取模板資料,按 panel_order 將格子重新排列,fit mode 預設保留頭頂至鞋底;場景卡則以一張圖為錨點,補充 0°、90°、180°、270° 環視、360° 全景及環境細節。右側面會自動水平翻轉,減少模型未能準確理解左右方向造成的版面問題。

一次生成整卡仍然受模型隨機性影響,角色姿勢、表情或物件位置未必逐格穩定。對需要固定構圖的團隊,逐格生成及排版流程會較可靠;工作台亦可逐格替換素材及微調裁切。README 未提供量化評測,因此較適合 ComfyUI 創作者、遊戲角色設計師同視覺內容團隊,以工作流方式驗證產出質素。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Image, 提示詞, Content Creator, 庫

FilmFlow: 虛擬電影攝影機代理

FilmFlow 讓創作者用文字指示或參考影片,為 3D 場景生成鏡頭移動。它會結合場景理解與渲染後的視覺回饋,逐步修整鏡頭位置、方向和構圖。

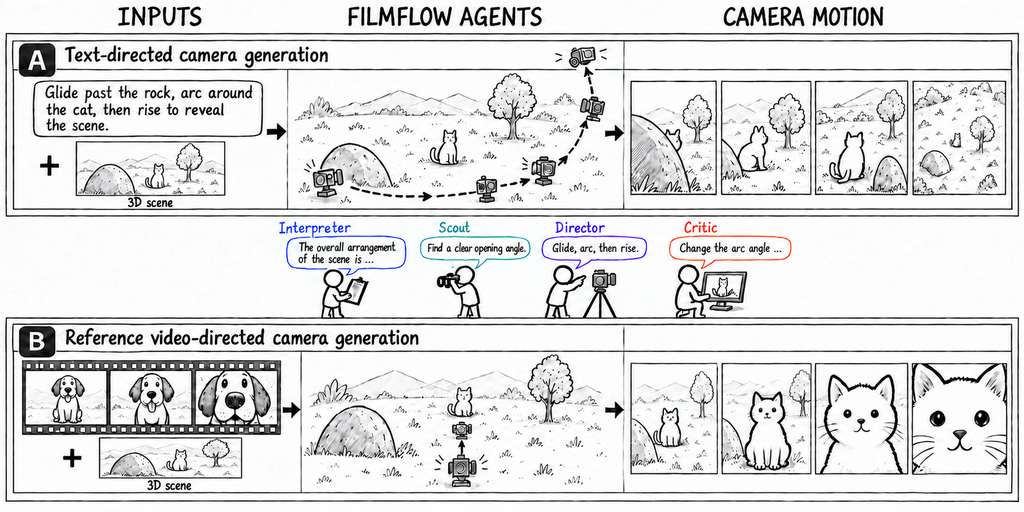
FilmFlow accepts text or a reference video and a 3D scene. Interpreter, Scout, Director, and Critic agents refine camera motion through visual feedback.

想為 3D 場景安排推鏡、環繞或特定構圖,FilmFlow 可將文字指示轉成可執行的鏡頭軌跡,也能把參考影片中的運鏡轉移到另一個場景。這套電影攝影代理系統面向動態 3D 環境,處理的是如何把拍攝意圖落實成有時間安排、能在場景中執行的鏡頭動作。

FilmFlow 由四個代理協作:Interpreter 理解場景並整理鏡頭意圖,Scout 尋找合適的起始視點,Director 安排鏡頭操作及其時間和參數,Critic 則檢視渲染結果並提供修正方向。Director 可同時組合多項基本操作,控制鏡頭平移、旋轉和取景;整個流程會根據畫面回饋反覆調整,而非只輸出一段抽象描述。

兩種輸入方式適合不同工作流程:文字導向生成讓創作者直接描述鏡頭動作與構圖要求;參考影片導向生成則適合借用既有片段的運鏡,並套用到另一個 3D 場景。這可用於虛擬場景分鏡、動畫預演及 3D 鏡頭設計,但生成效果仍取決於指示能否表達清楚,以及場景是否提供所需的視覺條件。

研究團隊同時推出 CinemaBench,涵蓋 150 個 Blender 場景、750 項文字導向任務和 60 段參考影片,用來評估文字導向與影片導向的鏡頭生成。提供的資料沒有列出基準測試成績,也未交代安裝或使用流程,因此目前可確認的是系統設計與評估集規模,不能據此判斷其性能表現。

  • 支援文字指示與參考影片兩種鏡頭生成方式。
  • 以四個代理分工處理場景理解、起始視點、鏡頭規劃和畫面檢視。
  • 可組合平移、旋轉與取景操作,並以渲染結果反覆修整。
  • 適合 3D 場景的鏡頭設計、分鏡及動畫預演。
  • CinemaBench 收錄 150 個 Blender 場景、750 項文字任務及 60 段參考影片。

項目主頁

Categories: 開源, Agentic, AI productions, Video, 框架, Content Creator, 3D, 動畫

Manga2Animate 雙智能把關分鏡,動漫不走樣

把漫畫直接餵進影片模型,角色與分鏡往往走樣。Manga2Animate 改走正規動畫流程:先寫腳本、再繪分鏡,最後才生成影片,由審核智能體把關忠實度。

想用 AI 把幾頁漫畫變成連貫動畫,最常撞到的兩個卡位是:純文字輸入會讓角色外貌與畫風消失,直接把分鏡頁送進影片模型又會誤判版面、講錯故事。Manga2Aniate 屬於多智能體框架,它把整條流程切成「預處理 → 腳本與分鏡優化 → 影片生成」三個階段,第二階段是關鍵差別所在:系統先生成動畫腳本,再產出視覺分鏡,兩者各由一個 creator agent 撰寫,並由對應的 reviewer agent 對照原始漫畫頁給意見,前後跑兩輪迭代才進入成片。

預處理階段用 Magi 偵測漫畫格並排出閱讀順序、抽取文字,再由 Character Description Creator 從角色參考圖歸納出識別特徵,避免後續鏡頭換角色就認不出來。這個雙層審核機制,是它和一般 I2V(image-to-video)套法最大的分水嶺。

對動漫改編從業者、影像敘事研究者,或想快速把作品原型化的獨立創作者,這套 pipeline 提供了比端到端模型更可控的中介層。論文與用戶研究都顯示,無論是角色一致性還是跨鏡頭連貫性,輸出都較接近既有方法優勝。

重點摘要

  • 三階段流程:Magi 切格+轉錄 → 腳本與分鏡兩輪迭代 → 片段式影片生成
  • 雙智能體架構:creator 撰寫、reviewer 對照原頁把關,腳本與分鏡各有獨立審核
  • 兩種生成模式:ref 模式以角色參考為主,i2v 模式則把分鏡切成首幀再生成
  • 開源後端齊全:程式碼、評測資料與模型設定皆公開,方便重現
  • 改善既有 I2V 套法常見的「角色走樣、敘事錯位」問題,在忠實度與一致性上有所提升

需要留意的是,目前公開的程式碼屬於研究框架性質,本地重現需要自行串接影片生成後端,權重未統一打包,下載及設定流程會比一般一鍵安裝的開源項目多幾道手續。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Image, 框架, Content Creator, 動畫

YuE2 Studio 由樂譜到成曲:讓 AI 音樂可編輯重做

YuE2 Studio 先把風格與歌詞寫成可修改樂譜,再生成完整人聲歌曲,讓 AI 作曲不再只剩一個音訊檔。

logo

由風格描述和歌詞開始,YuE2 Studio 會先產生旋律與和弦樂譜,再演唱成最長約 10 分鐘的完整歌曲。這個項目屬於本地執行的 AI 音樂製作軟件,處理的是生成歌曲後難以修改編曲、旋律和聲部的問題。

YuE2 由 M-A-P 開發,先以 ABC notation 記錄 composition,再輸出歌曲;使用者可以閱讀及編輯樂譜,之後以相同 composition 重新渲染不同聲音。它不是只提供一次性音訊生成,而是把 score 帶回製作流程,較適合需要反覆改歌詞、旋律或配器的創作者。

項目建基於 yue2.cpp,一個原生 C++/CUDA port;桌面介面則採用 Rust、React 和 Tauri,執行路徑不需要 Python、Node.js 或 launcher。Windows 提供安裝程式及 portable folder,支援離線運行;NVIDIA 顯示卡需要至少 6 GB VRAM,AMD 和 Intel 透過 Vulkan 的支援仍屬 experimental。

  • 先寫樂譜再生成演唱,保留 composition 的修改空間
  • 支援歌曲、stems、MIDI、lyric sheets、scores 和 videos 的檔案管理
  • 內置十段 equalizer,並提供 Winamp 頻率配置預設
  • 可在本地 GPU 執行,毋須依賴線上音樂服務

它較適合有歌詞、曲式或編曲要求的獨立音樂人、內容創作者,以及需要離線處理素材的團隊。硬件限制亦相當直接:NVIDIA 6 GB VRAM 是較穩妥的起點,非 NVIDIA 顯示卡則要接受 Vulkan 路徑仍可能不完整。

GitHub

Categories: 開源, NVIDIA, Audio, 軟件, 工具, Content Creator, Mac, Python, 音樂, 廣東話

ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。
  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

Kandinsky 6.0 把同步聲畫生成帶入開源模型

Kandinsky 6.0 可由文字或圖片生成帶同步音效、口形的短片,並提供 3B 與 29B 兩款模型。

promo

由文字或圖片輸入,到畫面、音效和口形同步輸出的流程,Kandinsky 6.0 將短片生成由單純影像延伸至完整 audio-video 內容。這個項目屬於開源多模態視頻模型,實際處理的是聲音與畫面難以同步、創作者需要分開製作素材的問題。

Kandinsky 6.0 Video Lite 有 3B 參數,Kandinsky 6.0 Video Pro 則有 29B 參數,兩者都能生成 5 秒片段、44 kHz 音訊及 lip-sync,支援 text-to-audio-video(T2AV)和 image-to-audio-video(TI2AV)。額外的 super-resolution 模型可把輸出提升至 Full-HD 1920×1080,但這並不代表原生生成階段已經以 Full-HD 運作。

• 同一生成流程處理視頻、音效和口形同步
• Lite 較適合資源有限的測試,Pro 追求更高生成能力
• 支援文字生成及圖片延伸兩種模式
• 可透過 Hugging Face Space、Diffusers、ComfyUI 或 vLLM-omni 接入

測試需要 NVIDIA GPU,以及 Python 3.13 或 3.14;首次執行會下載 Kandinsky-6.0-Pro-distill-5s 權重,輸出會寫入項目指定的 MP4 路徑。對不想自行配置環境的創作者,Hugging Face Space 是較直接的試用入口;需要納入工作流的團隊則可考慮 Diffusers 或 ComfyUI。

在非精簡版顯示卡上處理 5 秒影片片段的工作時間(秒)。不包括負載載入和 MP4 編碼時間。 RTX PRO 6000 (96 GB)、A100 80 GB 和 H100 80 GB 使用模組卸載。消費級顯示卡使用區塊卸載。 RTX 4090、RTX 5060 Ti、RTX 5080、RTX 5090、RTX PRO 6000 和 A100 80 GB 使用 SageAttention2++ 進行視覺自註意力控制。 H100 使用 FlashAttention 3。

RTX 4090RTX 5060 TiRTX 5080RTX 5090RTX PRO 6000A100 80 GBH100
Lite SD4371310577309242532239
Lite HD4221328579296274472203
Lite Full HD5781774770406387664284
Pro SD93630801336754621972356
Pro HD119427161189638561791292
Pro Full HD1247353015468547651106402

Kandinsky 6.0 適合製作概念片、角色對白及需要同步聲畫的短內容,但 5 秒時長、NVIDIA GPU 依賴,以及高解像度要靠額外模型處理,仍限制了它作為長片生產工具的角色。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, 多模態模型, 視頻模型, NVIDIA, Video, Image, 影像處理, Audio, 工具, Content Creator, Python, Dataset 數據集

Page 2 of 5
1 2 3 4 5