HelixWorld 即時生成互動視聽世界

輸入一張圖片和提示詞,再用方向指令探索場景,HelixWorld 會同步更新畫面與空間聲音。預覽版已提供瀏覽器示範及離線推理程式碼,但硬件門檻不低。

HelixWorld — Sound and vision, born together

轉身時,聲音方向也會跟着視角改變,這是 HelixWorld 與一般先生成畫面、再配上音軌的做法不同之處。它是 Noiz AI 開發的即時互動視聽世界模型,讓使用者從一張圖片和提示詞出發,以方向指令在生成場景中移動,並同步產生影像與聲音。

瀏覽器示範適合先感受互動效果;想離線測試,則可使用已公開的 Preview v1 推理程式碼和預覽模型。它目前支援 Linux、Python 3.11 和 CUDA 12.x,建議使用配備 80 GB VRAM 的 NVIDIA GPU;BF16 單卡測試約需 70 GB VRAM,對個人電腦使用者而言是明顯門檻。

操作時可輸入前進、轉向或停止等動作,並設定第一人稱視角及生成影格數;提示詞亦可分別描述影片、音訊或視聽內容。輸出會整理成 MP4,適合研究人員、互動內容創作者及想探索空間音效生成的團隊測試,但目前公開資訊未提供性能評測數據,亦未公開完整模型與訓練資料。

  • 畫面和聲音會隨鏡頭移動同步更新,空間聲場跟隨視點改變。
  • 可先用瀏覽器示範體驗,也可在符合硬件條件的 Linux 系統離線推理。
  • 預覽版已開放,完整模型、訓練資訊及報告仍待公開。

HelixWorld 展示了視聽生成從固定片段走向可操控場景的一種做法;不過,現階段的高顯示記憶體需求和有限評測資訊,令它較適合研究與原型測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, Video, Image, Audio, 提示詞, Content Creator, Linux, Python

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

AcademiaSD LoRAlab Trainer Studio:訓練影像與影片 LoRA

把多個模型的 LoRA 訓練流程集中到一個介面,支持消費級 NVIDIA 8G 顯卡。

AcademiaSD LoRAlab Trainer Studio

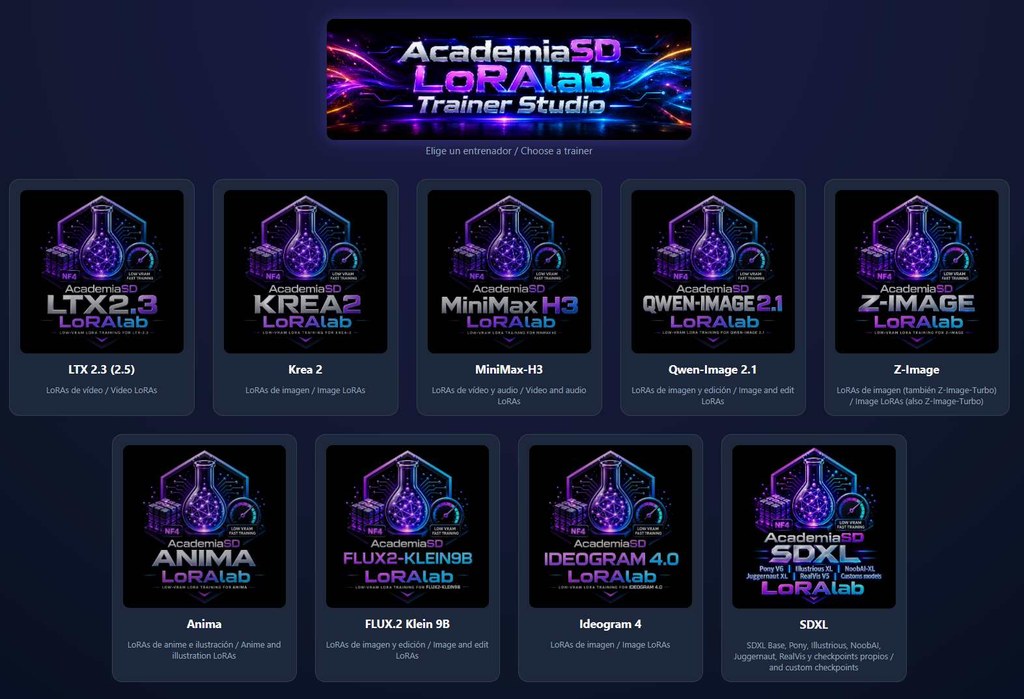
想為角色、物件或畫風訓練 Low-Rank Adaptation(LoRA),不一定要準備高階顯卡;AcademiaSD LoRAlab Trainer Studio 是一套 LoRA 訓練工具,目標是在最低 8 GB VRAM 的消費級 NVIDIA GPU 上處理最新影像及影片模型,並把不同 trainer 收進同一個 Web 介面。

每個模型會以 4-bit NF4 載入,文字編碼器與 VAE 只在 pre-cache 階段執行一次,之後把 GPU 資源集中到訓練。項目支援 Windows 10、Windows 11 及 Linux,使用 Python 3.13、PyTorch 2.14 cu130,以及 Flask + HTML5 介面;同一套安裝環境可加入後續新增的 trainer,毋須為每個模型另建環境。

工作流程包括資料集管理、自動 caption、即時預覽、精確步數續訓及一鍵匯出至 ComfyUI。訓練期間可以修改 steps、儲存及預覽頻率、預覽設定和 learning rate,按下 Save JSON 後,變更會在下一步生效;每個項目亦會分開保存 pre-cache、checkpoint、預覽圖及 LoRA 輸出,刪除快取或訓練內容不會碰到資料集。

  • 匯出的 LoRA 帶有 kohya-style metadata,包含 trigger word、rank、steps 和 resolution
  • CivitAI 及 LoRA managers 可以讀取相關 metadata
  • 一般角色、物件和風格 LoRA 可採用一張圖片配一段 caption
  • 可從同一網絡的其他裝置上載資料集及下載 LoRA

這套工具較適合想在本機反覆試驗、又不想手動管理多個訓練環境的創作者和小型團隊。預覽圖只用來追蹤訓練進度及角色、物件或風格的相似度,不能直接當成最終品質;完成後仍要在 ComfyUI 或 Forge 調整 LoRA 強度及模型品質設定。由於多個模型支援接近同時加入,README 亦明確提醒可能存在錯誤、未完善設定,以及預設訓練參數未必適合每個資料集,使用者需要自行測試並透過 Issues 回報結果。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 工具, Content Creator, Linux, Python, Win, LoRA

ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

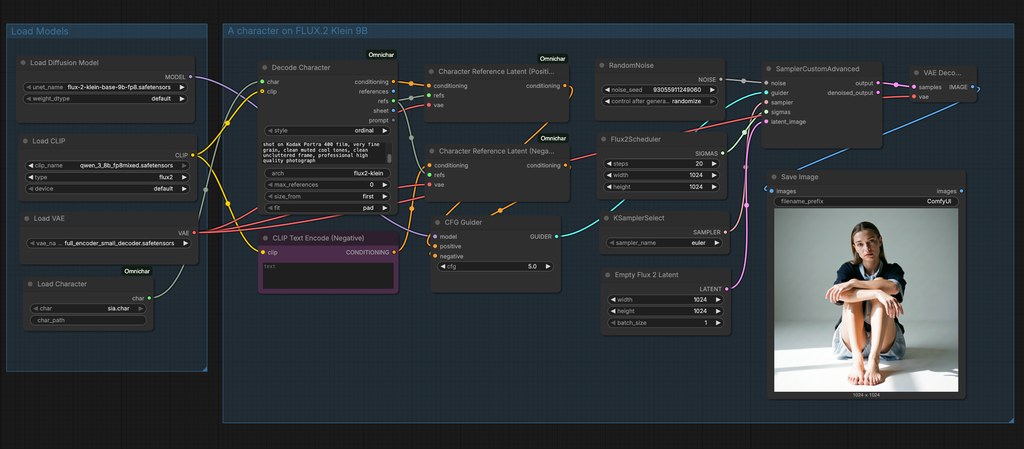
Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

Vlo 把 ComfyUI 帶進本地影片剪輯時間線

Vlo 將生成式 AI、ComfyUI 和傳統剪輯工具放在同一條時間線,適合想在本地處理影片的創作者。

landing

想在影片時間線內直接交給 AI 做遮罩、修補或畫面變換,Vlo 提供了一條較完整的工作流程。它屬於免費、開源的本地影片編輯器,處理的是生成式 AI 與逐格剪輯之間難以銜接的問題,亦支援在本機或遠端 GPU 上編輯同一批本地項目檔案。

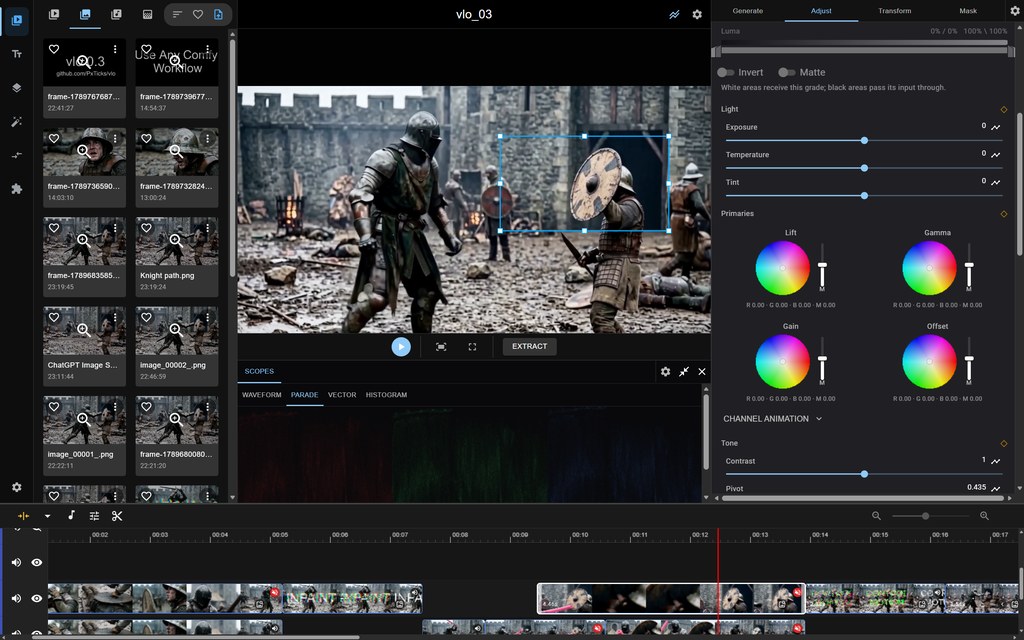
Vlo 把 ComfyUI bridge 接入編輯器,圖片、影片和時間線選取內容都可以送入 ComfyUI 工作流;SAM2 points editor 則用於遮罩,並配合自動裁剪與拼接處理 video inpainting。自動調整 aspect ratio 讓不同影片模型處理素材時毋須先裁走畫面,色彩校正、音訊、版面、濾鏡、keyframes、spline editor、beat detection 和可吸附 markers,則補上傳統剪輯所需的控制。

測試時需要 Chromium-based browser,官方已測試 Chrome 和 Edge;Firefox 由於 WebCodecs 實作差異,早期測試曾出現明顯延遲。媒體渲染由 mediabunny 包裝 WebCodecs,配合 File System Access API 直接管理磁碟檔案,但清除瀏覽器資料後可能遺失項目資料夾位置。

  • ComfyUI 工作流可直接套用到時間線選取內容
  • SAM2 遮罩支援影片修補流程的自動裁剪與拼接
  • 本地項目可配合本機或遠端 GPU 編輯
  • 具備逐格影片編輯所需的 keyframes 和 spline 控制
  • 目前依賴 Chromium,瀏覽器兼容性是主要限制

Vlo 較適合需要把 AI 影片生成、inpainting 和傳統後期剪輯放在同一個工作區的創作者或小型團隊。項目沒有提供可直接比較的性能指標,現階段較能確認的是它以 WebCodecs 支撐 frame-accurate nonlinear video editing,並以可擴展的 ComfyUI 工作流延伸功能;瀏覽器限制和本地檔案管理方式,仍會影響團隊採用前的測試安排。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, API, Video, Image, 影像處理, Audio, 工具, Content Creator

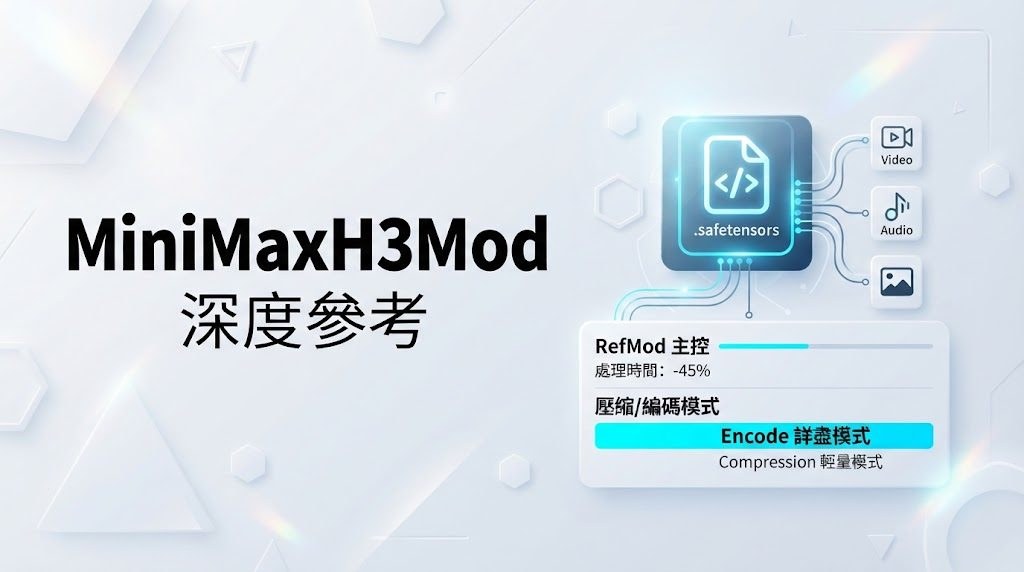
ComfyUI-MiniMaxH3Mod:可重用參考模組

你可以把它理解成 MiniMax H3 的參考素材管理層,把圖像、影片和聲音整理成可重用的 RefMod。

ko-fi

想在 ComfyUI 的 MiniMax H3 工作流中重用同一組人物、場景或聲音參考,不必每次重新編碼原素材。ComfyUI-MiniMaxH3Mod 是一個開源 custom node 項目,處理 RefMod 的建立、儲存、載入、組合及套用,讓圖像、影片和音訊參考可以保存成 .safetensors,再交給 Apply H3 RefMod 使用。它不會訓練 H3 權重,也不是 LoRA 或監督式概念學習工具,而是接入 H3 原生 reference-token 路徑的儲存與選擇層。

使用時需要將項目放入 custom_nodes 後重新啟動,並把標準 H3 video VAE、audio VAE 及原生 CONDITIONING 接到相應節點。項目已提供 Create H3 RefMod、Create H3 RefMod Master、Load H3 RefMods、Apply H3 RefMod 等節點;Master 可以一次處理視覺和音訊,save=False 則可只產生記憶體中的 bundle,不寫入檔案。ComfyUI Manager 可處理 safetensors、numpy 和 Pillow 等 Python 依賴,影片資料夾載入則可按需要加入 opencv-python 或 imageio。

  • 支援圖像、影片、音訊 RefMod,並可在同一個 .safetensors bundle 儲存視覺與聲音。
  • encode 保留較多細節但消耗更多 reference tokens;training 先壓縮 latent,降低 token 成本,亦可能損失細節和動態。
  • Collect H3 RefMod Masks 可處理不同尺寸的 MASK,並按對應參考素材保留尺寸;上游裁走的像素則無法恢復。
  • Full Reference video sampling 會先決定因果 frame 數,避免 16 等限制直接截掉影片尾段。
  • Loader 和 Axis 採用按需增加的參考槽位,並可分開選擇 All、Visual 或 Audio。

它和單純把素材放在工作流內的做法不同,RefMod 會把編碼結果保存下來,之後重用時可避免重複處理來源檔案。壓縮模式適合控制 token 和生成成本,完整 encode 則較適合作為身份或細節比較的基線;兩者都不能保證只轉移指定屬性,身份、服裝、背景和構圖仍可能互相混合。項目支援最多八個參考槽位、子資料夾、外置磁碟及 extra_model_paths.yaml 登記的 RefMod 根目錄,Library 和 Config 亦能搜尋及檢視已保存內容。

可調整的 max_tokens、frame limit、視覺 budget policy 和 Refinement Steps,令項目較適合需要反覆測試參考組合的創作者、ComfyUI 工作流作者,以及要管理大量人物或場景素材的團隊。truncate 會削減畫面內容以符合 token 預算,error 則在超出預算時停止保存;這些選擇直接影響細節保留和工作流是否繼續。項目目前沒有提供可與原生完整 reference workflow 對齊的正式基準測試,Windows 是原先測試環境,Apple Silicon 只覆蓋部分預處理和 H3 VAE 檢查。

音訊支援仍是最大限制。項目可以保存及混合視覺、音訊參考,亦曾成功處理音樂參考,但目前測試未能完成 speaker-identity transfer,因此不能當作已驗證的 voice cloning 解決方案;它亦不會自動修正影音同步。API 和 node schema 仍在演變,節點名稱及輸入欄位可能隨版本調整,適合接受工作流需要維護、並願意自行測試參考強度與 token 取捨的使用者。

GitHub
Categories: 開源, ComfyUI, AI productions, 模型訓練, API, Video, Image, 影像處理, Audio, 工具, Content Creator, Clone, 庫, 語音, 音樂, 蘋果, MiniMax, LoRA

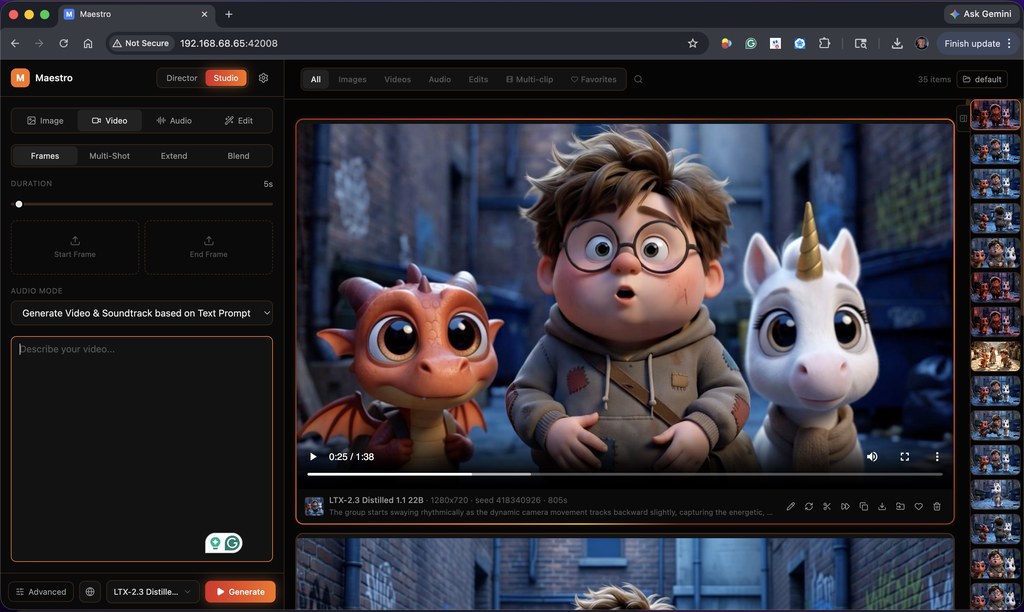
Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

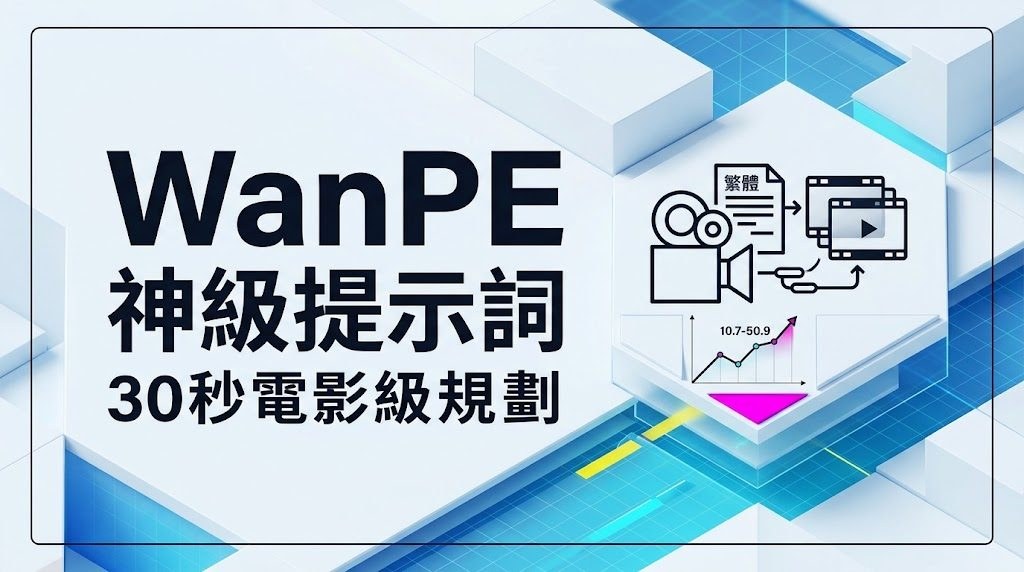
阿里 WanPE 用 397B 參數重寫電影級提示詞

阿里 Wan Team 推出 397B 參數嘅電影級提示詞增強模型 WanPE,專門幫影片生成模型把簡單描述擴寫成導演級腳本。

Wan logo

用文字寫出導演水準嘅提示詞係一道高牆。普通用戶多數只會輸入「一個人喺森林行」,但頂級模型需要更細緻嘅鏡頭語言、動作編排同節奏控制,先至能夠生成高質素嘅 30 秒成片。阿里 Wan Team 推出嘅 WanPE,正正瞄準呢個痛點:佢會將用戶輸入嘅簡短描述,自動擴寫成包含鏡頭運動、燈光變化、動作節奏嘅電影級分鏡腳本,再交俾下游影片模型執行。

WanPE 採用「Video-grounded reverse construction」做法,先從真實影片反向建構出鏡頭規劃,再學習點樣由提示詞出發重建同樣嘅結構,比起由前向改寫提示詞更能保留導演意圖。同時,佢透過 Semantic-Consistency GRPO(SC-GRPO)訓練方法,確保長鏡頭、多分鏡之間嘅語意唔會走樣。整個模型以約 105 萬條真實影片訓練而成,參數量達到 397B。

沒有 WanPE

使用 WanPE 之後

團隊構建咗人類標註嘅 WanPEval 測試集,覆蓋 5 至 30 秒唔同時長同意圖粒度,並用約 11,000 組盲測配對評分做對比。當配搭 Wan3.0 影片生成器時,WanPE-397B 喺 5 至 15 秒影片將人類偏好分數提升 10.7 至 18.8 分;喺 30 秒嘅長片場景,偏好分數更大幅躍升 50.9 分。喺 5 至 15 秒組別,佢領先所有受測嘅商業方案;30 秒組別則與 Seedance 2.5 保持競爭水平。

對內容創作者、短影片團隊或者想做 AI 廣告片嘅人嚟講,呢類自動「導演助手」能夠省卻大量分鏡草稿時間;對開發者而言,佢亦可作為外掛增強模組,套用到 LTX-2.5、MiniMax-H3 等其他生成器身上做格式適配。

重點摘要

  • 397B 參數專職寫分鏡:WanPE 將用戶簡短提示擴寫為導演級電影腳本,再交俾下游影片模型執行
  • 逆向建構 + SC-GRPO:從真實影片反向學習鏡頭規劃,並透過強化學習保持長片語意一致
  • WanPEval 評測:人類標註、5 至 30 秒覆蓋、約 11,000 組盲測配對評分
  • 30 秒長片偏好激升:搭配 Wan3.0 時,人類偏好分數提升 50.9 分
  • 可遷移:經格式適配後,可應用於 LTX-2.5、MiniMax-H3 等其他生成器

項目主頁 · Paper

Categories: 南京大學, 清華大學, 阿里巴巴, AI productions, 模型, 模型訓練, Video, 提示詞, Content Creator, LTX, 中國, Dataset 數據集, MiniMax

Calliope:由故事到成片 : ComfyUI 本地工作流

Calliope 將故事拆成劇本、鏡頭片段,再交由本機 ComfyUI 生成影片,兼顧創作流程與資料私隱。

Repository image for benjiyaya/Calliope

由一個故事構想開始,Calliope 會整理情節節拍、角色與場景,再按場景寫出貼近劇本的內容,拆成多個鏡頭片段交給 ComfyUI 生成影片。它屬於本地優先的 story-to-video 工具,處理的是文字創作與影片生成之間需要反覆整理、分鏡和合成的工作。

LLM 負責故事結構及逐場景腳本,ComfyUI 則按既有 workflow 和模型逐個產生片段,兩者分工清楚;完成後再由 ffmpeg 加入 crossfade、匹配音量並串成完整影片。項目資料放在 SQLite,媒體保存在本機資料夾,只有你指定的 LLM endpoint 可以是雲端服務,因此私隱程度和可控性較依賴本身的模型及 ComfyUI 配置。

Make AI Micro Dramas From Script to Video Locally Using Calliope 1.5

使用前需要 Python 3.11+、Node.js 18+、已安裝模型的 ComfyUI、OpenAI-compatible LLM endpoint,以及可從 PATH 呼叫的 ffmpeg。前端是 SvelteKit,後端採用 FastAPI;啟動兩者後,在 Settings 設定 LLM、ComfyUI URL 及可選的 agent 分工,亦可調整並行工作數、輪詢間隔和等待上限,長時間影片工作可把預設 30 分鐘 timeout 延長,或設為無限等待。

適合需要保留素材在本機的個人創作者、小型製作團隊,以及已經建立 ComfyUI workflow、想加入故事編排層的使用者。Dry-run 只會產生佔位結果,不能用來判斷真正的影片效果。

  • 流程完整:由故事、劇本、分鏡到片段合成集中處理
  • 本機優先:項目資料與媒體不必上載到雲端
  • 依賴明確:需要自行管理 ComfyUI、模型、LLM endpoint 和 ffmpeg
  • 可調整佇列:支援並行數、輪詢設定及長任務 timeout

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, API, Video, 工具, Content Creator, Python

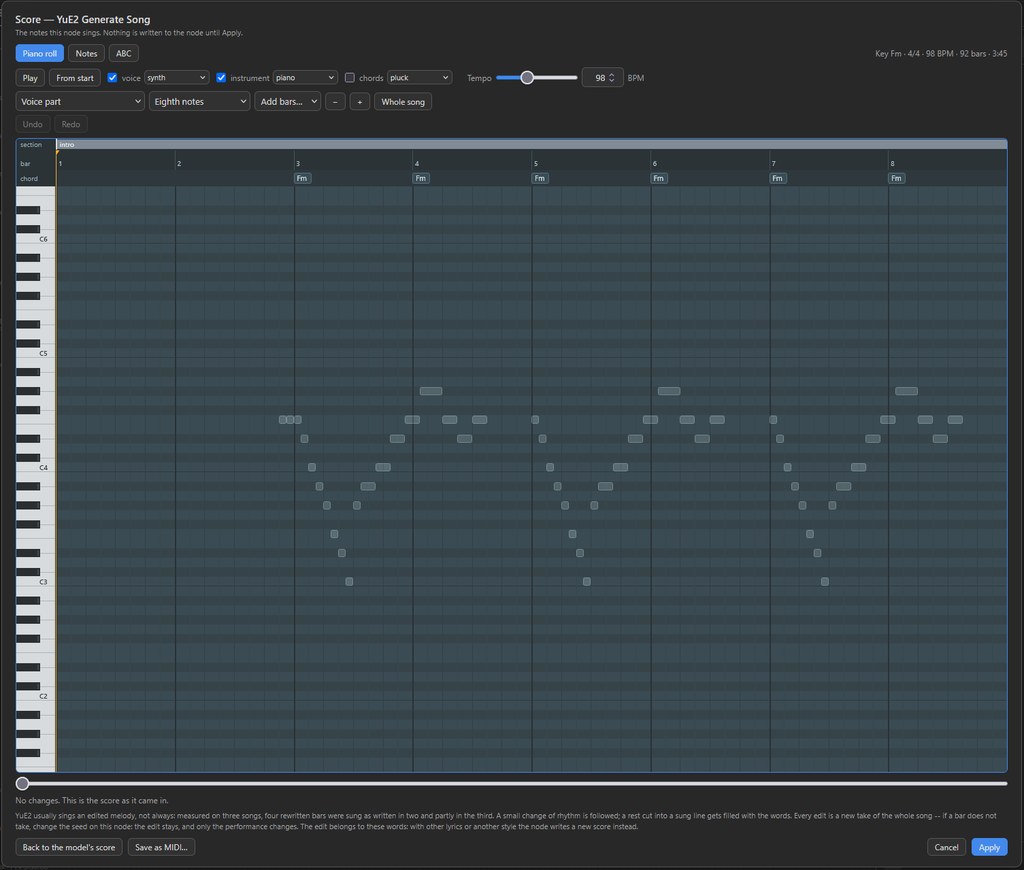
YuE2-ComfyUI:本地生成完整歌曲,能改樂譜再翻唱

輸入風格與歌詞,便能在 ComfyUI 生成歌曲及可讀樂譜,讓創作流程多一個可修改的環節。

The score editor over the canvas, titled Score -- YuE2 Generate Song, with the line The notes this node sings. Nothing i

把歌詞接入節點、設定曲風後,YuE2-ComfyUI 便能在本機生成完整歌曲與可讀樂譜。這套音樂生成節點工具把 YuE2-3B 接入 ComfyUI,適合想在同一工作流程反覆試作的音樂創作者。

它先寫出 ABC 樂譜,再生成演奏內容,最後透過變分自編碼器(Variational Autoencoder,VAE)解碼成 48 kHz 立體聲。樂譜也可修改後送回節點演唱,讓旋律調整有更具體的入口。

  • YuE2 Generate Song 接收風格、歌詞及 seed。
  • 歌詞可從文字節點接入,以 [Verse]、[Chorus] 標示段落。
  • YuE2 Write Song 可從一句構想撰寫風格與歌詞。
  • YuE2 Options 提供選填設定,主節點會自動尋找本機權重。

項目示例在 RTX 5090 上花 40.2 秒生成 75 秒歌曲,但單一示例不足以推算其他硬件的速度。提供的內容未列出完整安裝步驟、最低顯示記憶體需求或音質比較;準備納入製作流程前,仍需確認本機能否載入模型。

GitHub

Categories: 開源, ComfyUI, AI productions, 工具, Content Creator, 音樂, 廣東話

Page 3 of 5
1 2 3 4 5