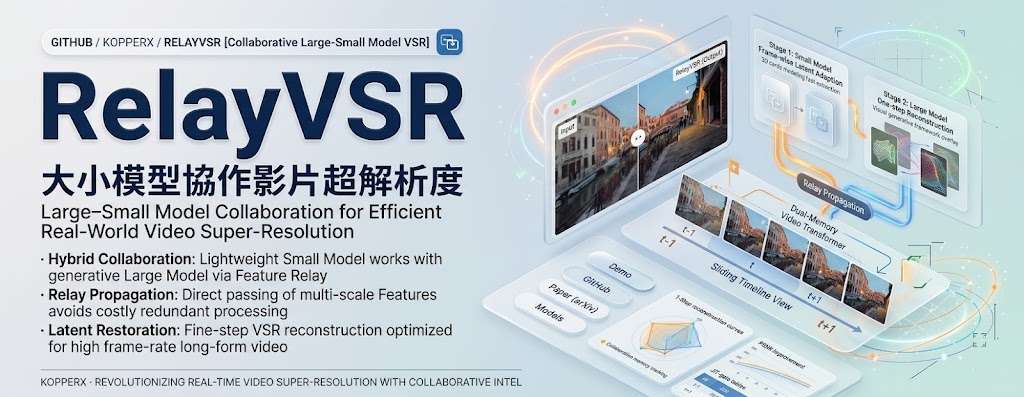
低清影片要放大四倍,往往要在細節真實感與處理速度之間取捨。RelayVSR 屬於影片超解像模型項目,讓大型 Wan 模型產生稀疏參考,再由輕量 Dual-Memory Video Transformer 重建其餘畫面,減少逐幀使用生成模型的成本。
RelayVSR 的流程不只是把兩個模型串起來:Video-Aware Reference Optimization(VARO)以影片層面及關鍵幀層面的獎勵,透過強化學習改善參考品質,降低錯誤關鍵幀在後續畫面累積的風險。輕量模型會結合關鍵幀細節與近期影片內容,支援有限前看及雙端點條件。
在單張 NVIDIA A100 80GB、1080p 及 15 幀關鍵幀間隔下,雙端點 RelayVSR 達到 29.29 FPS,峰值 GPU 記憶體為 13.82 GB,首幀模型延遲 0.327 秒;FlashVSR-Tiny 則為 7.80 FPS、24.447 GB 及 2.83 秒。這個比較反映它把速度和記憶體壓力放在系統協作,而非單一大型模型硬撐。
- 支援 4×輸出,保留輸入影片 FPS
- Linux、Python 3.11–3.13 及 NVIDIA GPU
- Wan 與 Flash 兩個 safetensors 權重分開載入
- 可處理 MP4 或按順序排列的圖片資料夾
- 不會複製原影片音訊,長片可用
--max-frames限制處理量
要試用項目,需要先取得兩個 Hugging Face 權重,再以 inference.py 指定輸入影片;預設每 15 幀產生參考端點,也可調整 --window-size。它較適合需要串流處理、長影片放大或受 GPU 記憶體限制的研究者與影像工作流程,但輸出沒有音訊,亦仍依賴 NVIDIA GPU,未必適合一般消費級電腦直接處理高解像長片。