NVidia Hydra-0 以人類動作統一機械人訓練

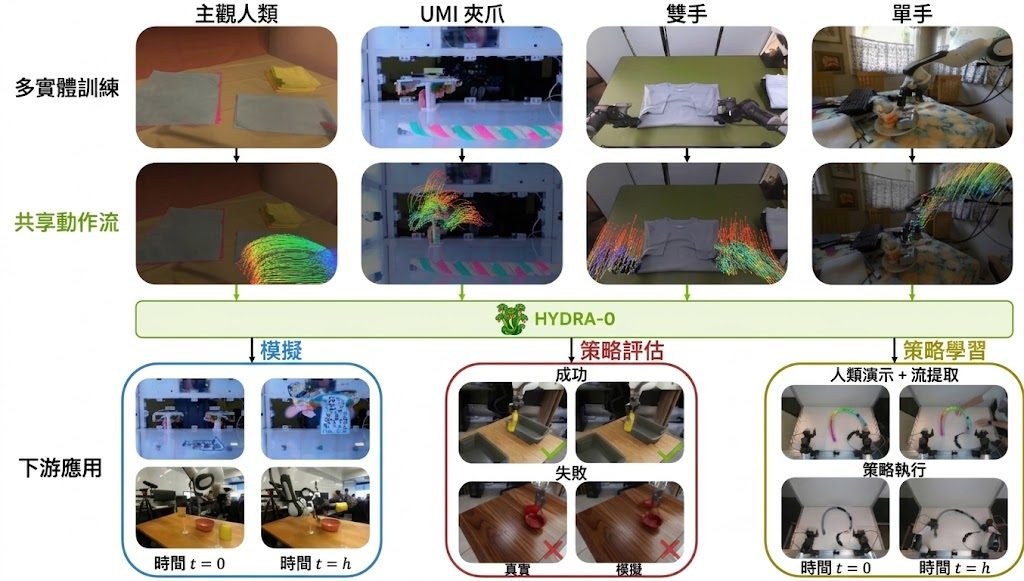
Hydra-0把機械人動作轉成畫面上的像素流,讓同一個世界模型學習不同機械人形態,並支援模擬、策略評估及真機控制。

Og image

機械人面對不同手臂結構、夾具和操作環境時,動作通常以各自的關節或末端執行器座標表示,令資料難以共用。Hydra-0以 Action Flow 將可見的機械人運動表示成影像平面上的像素流,建立跨形態、任務和環境的共同控制介面,屬於面向通用控制的 world model。

Hydra-0在運行時採用 hybrid simulator:physics engine 負責移動機械人,learned video model 則預測動作對場景造成的變化。模型可從 egocentric human demonstrations、handheld UMI grippers、single-arm robots 和 bimanual robot arms 等互動影片學習,減少依賴單一機械人平台資料的限制。

Forward mode會根據 gripper flow 預測未來場景,生成的結果可用於 open-loop policy evaluation;inverse mode則由目標物件的 flow 推導相容的機械人運動,再透過 supervised readout 轉換成可執行動作。把模擬、策略測試和控制放進同一套模型流程。

• 以像素流統一四種不同 embodiment 的互動資料
• 同時支援世界預測、策略評估及機械人控制
• 以 physics engine 和 learned video model 組成 hybrid simulator
• 最佳配置令 robot-motion error 降低90.4%,object-motion error 降低60.2%,比較基準為 action-conditioned baseline

Hydra-0適合需要整合多來源示範影片、先在模擬環境測試策略,再連接真實機械人的研究和開發工作。它仍然依賴動作影片、像素流表示和模型預測的準確度,跨形態轉移能否在更多任務中保持穩定,仍要配合完整數據和真機測試判斷。
項目主頁

Categories: 視覺模型, 世界模型, NVIDIA, Video, Image, World-Action Model, Robotic

RapidLiDAR:單次前向傳播做到 10 Hz 嘅 LiDAR 場景補全

佢將稀疏嘅部分點雲一次性還原成稠密場景,主打即時同可調速度,適合對延遲敏感嘅自動駕駛同機器人開發者。

Repository image for AzharSindhi/RapidLiDAR

對做自動駕駛或機械人感知嘅人嚟講,LiDAR 場景補全最頭痛嘅唔係質素,而係慢——好多現有方法要幾百毫秒先出一幀,根本追唔上車規或即時反應嘅需求。RapidLiDAR 嘅定位就喺呢度:佢設計成一個端到端、單次前向傳播嘅補全模型,目標係跑到接近 10 Hz,同時保留可調速度同可調節輸出密度嘅彈性。

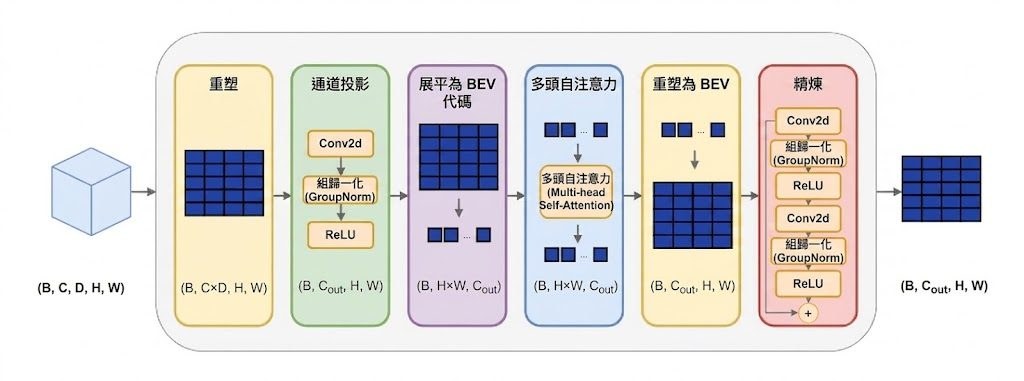
做法上,佢先用體素化抽取多尺度 3D 特徵,再透過一個自注意力 BEV 頭產生密集 2D 特徵圖。Adaptive Initialization Module 會預測一個空間變化嘅位移,把稀疏點雲「撐開」做粗略初始化;之後 Multi-Scale Reconstruction Module 用可變形注意力(deformable attention)將每點特徵同多尺度 BEV 特徵對齊做精修。如果想再稠密仲可以加一個可選嘅 Refinement Network 喺凍結嘅主模型上做上採樣,倍率為 κ。

換句話講,舊方法通常分開做初始化同迭代 refinement,或者用兩階段網絡先粗後細;RapidLiDAR 將呢幾步壓入一次前向,靠 BEV 座標化同可變形注意力同時兼顧效率同幾何一致性。代價係依賴 SemanticKITTI 風格嘅資料 loader,需要 .npy 格式嘅 GT 同 input 配對,唔係 out-of-the-box 處理原始 Velodyne 掃描。

適合做自動駕駛 stack、實時 SLAM、機械人感知原型,或者想喺邊緣裝置上試稠密 LiDAR 預測嘅團隊。原文強調即時性為 10 Hz,具體 mIoU 或 Chamfer distance 等數字未在 README 完整列出,安裝需 CUDA 12.4 同 PyTorch 2.4.1,並要自行 JIT 編譯 Chamfer distance CUDA extension。

GitHub · Paper

Categories: 開源, 模型, 視覺模型, NVIDIA, Robotic, 3D, Python, Dataset 數據集

Google DeepMind 把手語 AI 放進用戶手中 涵蓋 30 種 ASL 詞彙

Google DeepMind 將手語識別 AI 整合到日常應用,讓失聰與健聽人士的溝通更自然。

A person signs with one hand while holding a smartphone, demonstrating the Gboard sign-to-text dictation feature.

聾人手語使用者日常面對的最大卡位,是怎樣讓手機或視訊鏡頭直接「讀懂」手語並即時翻譯。Google DeepMind 近期把手語 AI 從實驗室帶到實際產品中,覆蓋約 30 個美式手語(ASL)詞彙並透過 Gemini 模型支援即時回應,目標是讓聾人朋友毋須依賴真人翻譯就能完成基本對話。

這套技術並非單純的影像分類,而是結合姿態估計、語境理解與大型語言模型的能力,把手語動作轉成自然語言並維持對話節奏。比起過去只能辨識孤立詞彙的系統,現時更著重處理連續手語與多輪對話,使翻譯過程貼近真實交流節奏。

DeepMind 同時強調負責任部署,與聾人社區合作收集訓練數據,並透過小規模詞彙起步降低誤譯風險。對於依賴視訊通訊的聾人用戶來說,這項能力讓 Zoom、Meet 等場景下的溝通體驗更貼近健聽人之間的對話節奏。

這項功能適合手語使用者、聾人家屬,以及需要服務聾人客戶的企業。它並非要取代真人翻譯,而是作為日常輕量溝通的輔助工具,降低手語學習門檻並促進更即時的互動。

重點摘要:

  • 覆蓋範圍:支援約 30 個 ASL 詞彙,涵蓋日常問候與基本對話。
  • 技術核心:結合姿態估計與 Gemini 大型語言模型,處理連續手語與上下文。
  • 部署方式:整合到 Google Meet 等視訊應用,即時翻譯手語為文字或語音。
  • 負責任設計:與聾人社區協作訓練數據,從小規模詞彙起步降低誤譯風險。
  • 使用場景:聾人用戶日常視訊通話、聾人家庭成員溝通、企業客服聾人客戶。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, Video, Audio, Robotic, 安全, Skill 技能

360CityArena 把城市導航基準拉近真街景

想測試 Embodied Agents 喺城市場景到底識唔識搵路,360CityArena 提供咗一個更貼近真實街區的基準,但結果亦直接揭示現時模型離人類判斷仲有一大段距離。

360CityArena teaser showing a panoramic Akihabara scene and an embodied navigation agent

喺模擬城市入面叫 Embodied Agents 認路、數物件、跟地圖行,難度一向唔低;換成秋葉原的 360 度真實街景之後,問題就由「會唔會做任務」變成「可唔可以喺複雜環境保持判斷」。360CityArena 屬於 benchmark,核心用途係評估 multimodal large language models 喺 embodied navigation 同 visual reasoning 上,到底有幾接近真實城市探索需求。

呢個項目最有意思的地方,在於它唔係靠乾淨的 3D 合成地圖,而係用 602 段 360° 影片重建東京秋葉原 85 條街道,再放入 Unity 環境,用 pose graph 方式讓 agent 沿既定節點移動。換句話說,代理唔可以自由行去任何 3D 座標,也唔涉及實體互動;它測的是在受限移動下,模型能否理解街景、地圖、語言提示同空間關係。

公開版本有 175 個人工設計任務,涵蓋 localization、landmark search、counting、map navigation、language guided navigation 同 relational spatial reasoning。部署方式亦算清楚:Unity 6.5 負責環境,Python runner 接模型 API、送出相機與地圖觀察,再把每次執行結果寫入 outputs/<run_id>/,因此它比較適合研究團隊或評測項目直接重跑同對照。

  • 用 360° 真實街景而唔係純合成場景,城市細節更接近真實導航
  • 任務覆蓋找地標、看圖尋路、數物件、按文字指示前進等七類能力
  • Unity 環境配合 Python runner,方便接駁不同 MLLM API 做可重現測試
  • agent 只可沿 pose graph 移動,限制更明確,同時保留城市探索的推理壓力

最值得留意的是結果並唔樂觀。官方比較指出,Gemini 2.5 Flash 目前在整體任務只有 17.1%,人類則有 77.3%,差距大到足以說明:現時多模態模型即使已經能看圖和讀指令,一旦放入連續街景、地圖對位與空間推理混合的場景,穩定性仍然不足。對做 Agentic、Robotic、世界模型相關研究的團隊來講,360CityArena 的價值正在於它唔再只測單步理解,而係把城市級導航的瓶頸攤開畀人直接比較。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, Gemini, API, Robotic, 3D, Python, Dataset 數據集

RynnValue 用秒估計機械人完成時間

它不只判斷機械人有冇做對,仲會估計距離完成仲差幾多秒。呢種時間式價值訊號,令強化學習獎勵設計變得直接得多。

RynnValue overview

機械人操作最難的不只是識別動作成敗,而是要持續知道距離完成指令仲有幾遠。RynnValue 就是針對呢個空缺而來的模型項目:它把機械人影片連同文字指令一齊讀入,逐格預測剩餘完成時間,並輸出自然語言分析,讓進度估計、失敗偵測與 VLA(vision-language-action)policy 的獎勵建構可以共用同一套訊號。

它和常見進度分數或偏好標註做法的分野很清楚。RynnValue 不靠人工標出「較好」軌跡,也不把進度硬壓成 0 到 1,而是直接學習 goal-conditioned cost-to-go 的物理時間;標籤來自時間戳,配合子任務切分與 cutoff relabeling,於是能擴展到 7,000 多小時、約 300 萬段 instruction-conditioned clips 的異質機械人資料。這個取捨帶來的好處是可擴展,代價則是模型必須更好地處理長尾任務時長與不同視角、不同 embodiment 的差異。

RynnValue 連同完整工具鏈一併提供。你可以把它理解成一套由 HuggingFace 相容模型、影片推理示範,到 reward-model benchmark 與強化學習介面都包起來的研究型工具組;當中 RynnValue 建基於 RynnBrain,實作在 Qwen3-VL architecture 之上,除了預測 absolute 與 relative temporal value,亦會生成影片描述,並判斷 instruction–video 是否匹配、任務是否成功。

  • 核心能力是把「距離完成尚餘幾多秒」變成稠密 value signal
  • 訓練毋須 preference 或 progress annotations,較易放大量異質資料
  • 8B 版本在 RBM-EVAL-OOD 的平均 Kendall’s τₐ 達 0.675,高於文中對照的 fully preference-supervised 方法 0.655
  • 可直接接到 reward shaping,用作 policy ranking、evaluation 與 reinforcement learning critic

為免模型偷看序列位置去猜進度,作者加入 temporal-order shuffling、random temporal sampling,以及 value-isolation attention;消融結果亦顯示這些設計不是裝飾,拿走後指標會明顯下跌。再進一步,它把輸出的 value 轉成 potential-based shaping reward,在雙臂 Franka 的真實機械人學習中,無論 online 定 offline 都比最強 reward-model baseline 有更高成功率。

最受惠的會是做機械人操作、VLA 訓練、reward modeling 與 embodied AI 評測的團隊,尤其想減少人手標註成本、又需要跨資料來源泛化能力的人。限制同樣存在:這類時間距離訊號雖然比二元成敗更細緻,但對任務切分、影片品質與觀測覆蓋仍然敏感,而且它目前聚焦於 robot manipulation,不代表可直接外推到所有 agent 場景。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, Dataset 數據集

Ego2Robot 把人類影片轉成機械人訓練數據

Ego2Robot將第一身人類操作影片轉化成大規模機械人訓練數據,改善 VLA 模型面對陌生環境時的泛化能力。

Ego2Robot pipeline overview

機械人要應付陌生場景,往往需要大量而且多樣化的示範數據;Ego2Robot選擇從第一身人類操作影片取材,將人手動作轉換成不同機械人形態可以使用的訓練資料。這個數據合成項目面向 Vision-Language-Action(VLA)模型預訓練,處理人類影片與機械人動作、視覺外觀不一致的問題。

流程分為動作對齊、視覺對齊和品質篩選三部分。系統會把拇指、食指、中指指尖及手腕等關鍵點重新映射到夾爪的 TCP、開合幅度和方向,再以 Savitzky–Golay 及 SLERP 平滑動作;視覺處理則結合 SAM 3、ProPainter、機械人底座姿態搜尋和 IK solving,把機械人手臂合成到已修補的人類場景中。

項目支援已有手部姿態標註的數據集,也可以從原始影片估算姿態,後者使用 WiLoR 逐幀重建和 DynHaMR 時序最佳化。統一流程可以平行產生 15 種 robot morphologies,累積 18,561 小時訓練數據,涵蓋較多任務、場景和機械人配置。

重點包括:
– 同時支援 curated datasets 和 in-the-wild videos
– 以多層 quality curation 篩走動作及視覺合成中的低質資料
– RoboTwin 2.0 加入視覺外觀、場景佈局、機械人形態和任務語義等干擾軸
– 與機械人數據聯合預訓練後,多種 out-of-distribution 情況下的泛化能力提升
– 改善效果亦在真實機械人部署中獲得驗證

對需要建立通用機械人操作模型的研究團隊,Ego2Robot提供了一條減少真人示範收集成本的路線。不過,合成數據的品質仍取決於手部姿態估算、動作重定向、逆運動學和場景合成是否準確,因此它較適合作為真實機械人數據的補充,而不是完全取代實體部署資料。

項目主頁

Categories: 阿里巴巴, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, 中國, Dataset 數據集

N0-TWAM 把觸覺帶進機械人決策

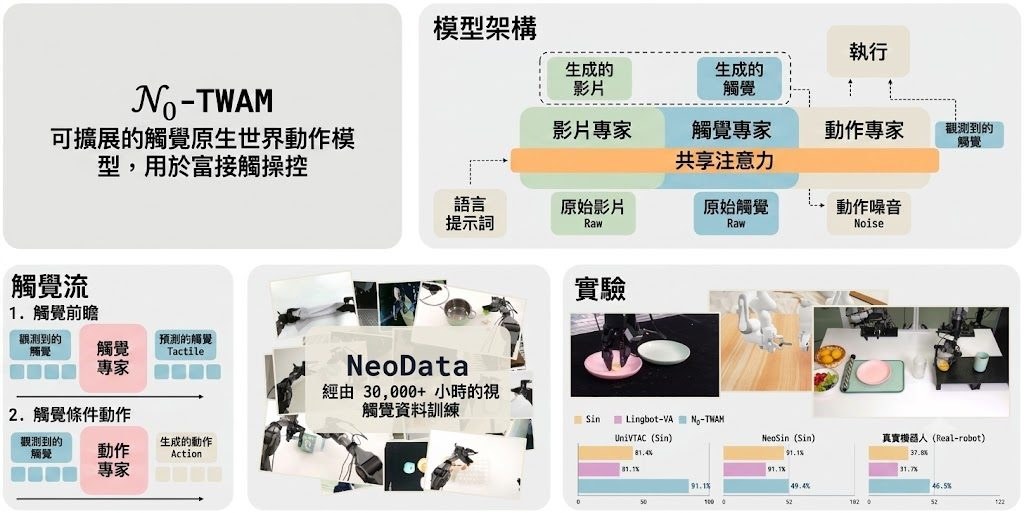
鏡頭睇到嘅畫面未必足夠,N0-TWAM連觸覺一齊預測,再生成動作。對接觸密集操作來說,這個方向比只看影像更貼近現場需要。

teaser

插頭有冇卡住、夾爪有冇真係受力,單靠畫面往往判斷唔完整。N0-TWAM放喺呢個空缺上處理問題:它屬於世界動作模型,將 vision、tactile 同 action 一齊建模,先推進未來會見到乜、摸到乜,再輸出低層動作,目標直指 contact-rich manipulation。

它吸引之處不只是多加一種感測,而係把觸覺當成未來狀態的一部分,而唔係事後補充訊號。相比只預測影片的 world-action model,或者直接由當前觀察回歸動作的 VLA policy,N0-TWAM更著重「預測之後再行動」;代價是系統更重,儲存庫亦只釋出 pretrained checkpoint、inference server 同 post-training toolkit,未包含大規模預訓練流程。

  • 可直接載入 pretrained checkpoint,再用自家 demonstrations 做 post-training
  • 可經 websocket 部署,由 observation 持續取回動作,也可接到自家 robot 或 simulator 做 closed-loop 控制
  • 支援 NeoSim 的 closed-loop benchmark,方便用 vision–tactile 場景驗證表現
  • 核心做法是 Mixture-of-Transformers (MoT),分開 video、tactile、action 三個 experts,再共享注意力交換資訊

模型背後沿用 WAN2.2 TI2V-5B video diffusion transformer 作 backbone,重組成三個 experts,並用 rectified-flow / flow-matching 目標聯合學習。readme 亦交代 action space 是 20-dim dual-arm end-effector,配合 tactile-aware execution,明顯不是聊天式 agent,而是面向機械臂操作與接觸控制的研究模型。

它在 UniVTAC、NeoSim 與八個 real-robot tasks 的平均成功率分別達到 84.5%、49.4% 和 46.3%。這些結果說明觸覺對高接觸操作有實質幫助;同時也要留意,部署門檻仍然偏研究導向,較適合機械人團隊、模擬環境開發者,以及已經有 demonstrations 與感測資料流的項目直接接入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 模型訓練, Video, VLA, Robotic, Dataset 數據集

ACE-Data-0:以人為中心的環境式採集構建具身數據引擎

煲水、抹枱、拎杯過房,呢類日常動作其實最難完整記錄。ACE-Data-0 嘗試用同步多模態方式,保留家居活動由開始到完成的全程變化。

Og image

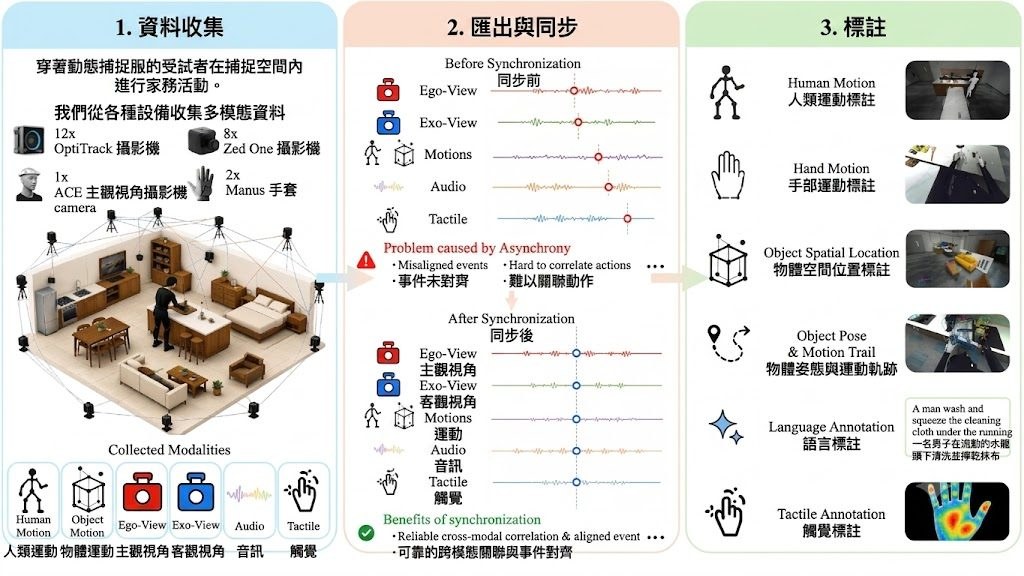
家居環境入面嘅長時間活動,一直係具身 AI 最難補足嘅數據缺口。ACE-Data-0 聚焦嘅唔係幾秒鐘嘅單一步驟,而係一段完整家務流程點樣一路影響視角、身體動作、物件狀態、接觸訊號同聲音,令模型可以學到「同一件事點樣隨時間演變」。

項目背後用 Ambient Capture Engine(ACE),將真實住宅場景變成同步錄製系統,並且同時覆蓋 table-scale 同 room-scale 兩個尺度。重點唔止係拍到第一身畫面或者外部鏡頭,而係將 ego view、exo views、body motion、hand articulation、object state、audio 同 touch 對齊到同一時間線,整理成可訓練、可標註嘅 embodied AI 數據。

相比只提供單一視角影片、實驗室動作捕捉,或者只得短片段互動記錄嘅常見做法,ACE-Data-0 更著重完整性同連續性。它以 household goal 為單位記錄活動,參與者自然完成任務,過程可以跨房間、牽涉多個物件,亦會保留場景由初始狀態、中途改變到任務完成嘅完整軌跡,較適合研究長程規劃、狀態追蹤同記憶能力。

  • 用同步多模態方式記錄真實家居活動,而唔係只截取短動作片段
  • 同一事件內對齊視角、身體、手部、物件、聲音同接觸訊號
  • 以目標導向活動收集數據,保留跨步驟、跨房間嘅連續變化
  • 適合具身 agents、機械人感知與操作、長時序決策相關研究

現有資料清楚交代咗項目定位、捕捉方式同數據價值,亦提到已釋出技術報告同 Hugging Face dataset。適合先將它理解為一個面向具身 AI 數據收集嘅基礎設施項目,而唔係即時上手型工具。

項目主頁

Categories: Agentic, Video, Audio, Robotic, Dataset 數據集

Gemini Robotics 2 想令機械人動作更完整

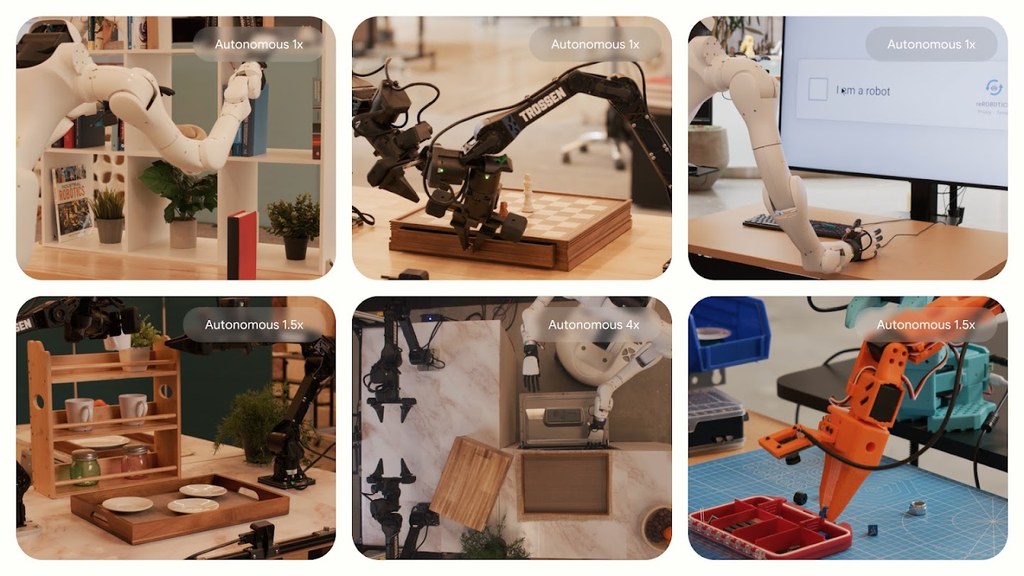
重點唔止係識睇同識答,而係令機械人連身體控制都更連貫。Gemini Robotics 2 指向的是把感知、推理同動作放入同一條工作流。

CSJxggUnu5m5TfompiXP2z7YLThhUvDn2 kBueCZv6HCEWWefUt WLzM6wxnTV1sTGqBbvmXDnOTB12W18NDr2NgFVXvHKCiTtjfXpyzuOYPJZXlg=w1440

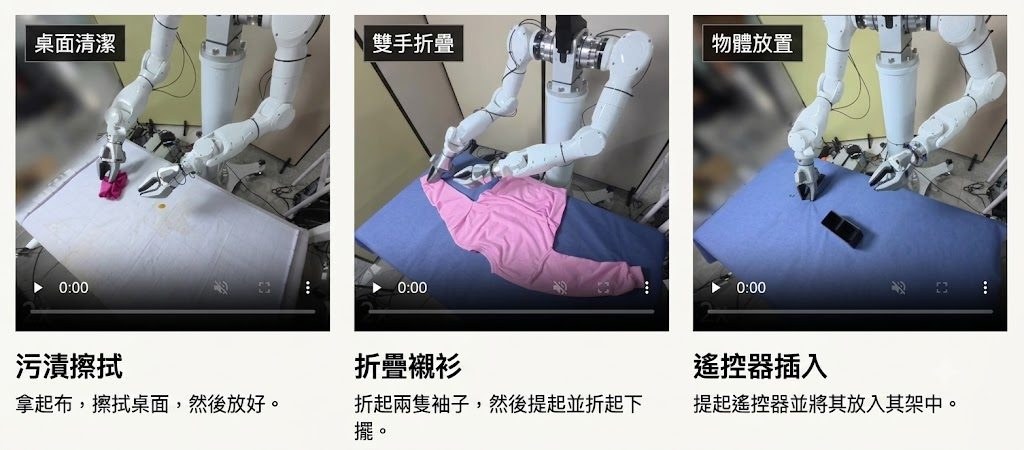
機械人最難處理的,往往不是單一步驟,而是由看見環境、理解指令,到整個身體協調完成動作的連續過程。Gemini Robotics 2 聚焦的正是這個落差,嘗試把 whole body intelligence 帶入機械人,讓系統不只會辨識和規劃,還能更自然地連動身體控制。

Google DeepMind 把它放在 Gemini Robotics 這條 physical AI 路線之下,定位清楚偏向機械人操作與互動。相比只處理螢幕、語言或單一機械臂任務的做法,這個方向更重視整體行為是否連貫,包括感知、推理、用工具與跟環境互動能否接上同一套能力。

對研究機械人、embodied AI 同 VLA 工作流的人來說,這類項目最有參考價值的地方,在於它瞄準真實場景中的協調問題,而不是只展示單點能力。文章提供的內容仍屬簡介層面,未見完整評測細節、量化指標或部署條件,所以現階段較適合當成技術方向觀察,而不是直接當作可落地規格。

  • 把機械人的感知、推理與身體動作放到同一條能力鏈
  • 核心關注點是 whole body intelligence,而不只是語言或視覺理解
  • 屬於 Gemini Robotics 系列,延伸 Google DeepMind 的 physical AI 佈局
  • 現有公開資訊偏介紹性,性能與限制仍有待更多技術資料補充

整體來看,Gemini Robotics 2 反映出機械人模型正在由「識唔識做判斷」走向「能唔能夠完整做完一個動作」。對需要長步驟操作、工具使用與環境互動的場景,這種整合式能力會比單一模組升級更值得留意。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, NanoBanana, Video, VLA, Audio, Robotic, 安全, Skill 技能

HiFi-UMI 用純人類示範訓練可落地機械手策略

唔使先收機械人數據,亦可以把人手操作片段變成可部署的 manipulation policy。HiFi-UMI 想處理的,正是資料取得太貴又太慢的卡位。

Hero image preview

收集機械人操作數據一直又貴又慢,尤其牽涉真機示範、重覆錄製同場景對齊時,門檻會再高一截。HiFi-UMI(Universal Manipulation Interface) 聚焦在 robotic manipulation 訓練流程,嘗試只靠高保真人類示範資料,學出之後可以直接部署的 manipulation policy,重點放在減少對 robot data 的依賴。

它吸引人的地方,不是單純把人類影片拿來做模仿學習,而是想處理一個更難的落差:人類動作同機械人執行方式並不一樣,但資料又最容易先由人收集。HiFi-UMI 的方向,是用 high-fidelity UMI data 把這種落差壓低,令純 robot-free data 也有機會支撐 deployable policy。

適合留意這個項目的人,會是做 imitation learning、robot learning,或者正面對資料成本過高的研究與開發團隊。當工作流卡在「冇足夠真機數據先練唔到模型」時,這類方法提供了一條先用高質人類資料起步的路。

  • 核心取向是 robot-free data,減少收集真機示範的成本
  • 重點不只在學習動作,還在能否得到 deployable manipulation policies
  • 依賴的是 high-fidelity UMI data,而唔係低配對、低一致性的隨意示範
  • 最受用的場景是資料昂貴、真機時間有限的 robotic 項目

現有資料只交代了項目的核心主張,未見更完整的模型結構、訓練細節或評測數字,所以現階段較適合把它理解成一個很鮮明的研究方向:先提升人類示範資料的可用性,再把學到的能力推近真實部署。要判斷它比其他做法強幾多,仍要等更完整的技術內容同 benchmark 結果。

項目主頁

Categories: Robotic, Dataset 數據集

Page 3 of 8
1 2 3 4 5 8