ActiveVision 點出視覺推理真空帶

望一眼答題的多模態模型,在 ActiveVision 幾乎集體失靈。這個 benchmark 把「要一路觀察先答到」的能力,拆成更貼近人類解題節奏的測試。

ActiveVision — An Exam for Active Observers. Vision is a loop, not a glance.

不少視覺題目唔係靠一眼辨認,而係要沿住線追、逐區域數、一步步核對先答得到;ActiveVision 正正針對呢種落差而來。作為一個 benchmark,它集中測試 iterative visual reasoning,處理的是模型看得到畫面,但未必能持續整理觀察過程的問題。

現有多模態模型常見做法是對單張圖作一次性判讀,再配合 chain-of-thought 直接作答;作者認為這種 single-glance 範式,對需要反覆掃描、追蹤順序與維持中間狀態的題型特別吃力。ActiveVision 因此設計了 17 個任務,並用 deterministic program 生成場景,再以 photorealistic 方式重繪,令畫面自然之餘仍保留可驗證結構。
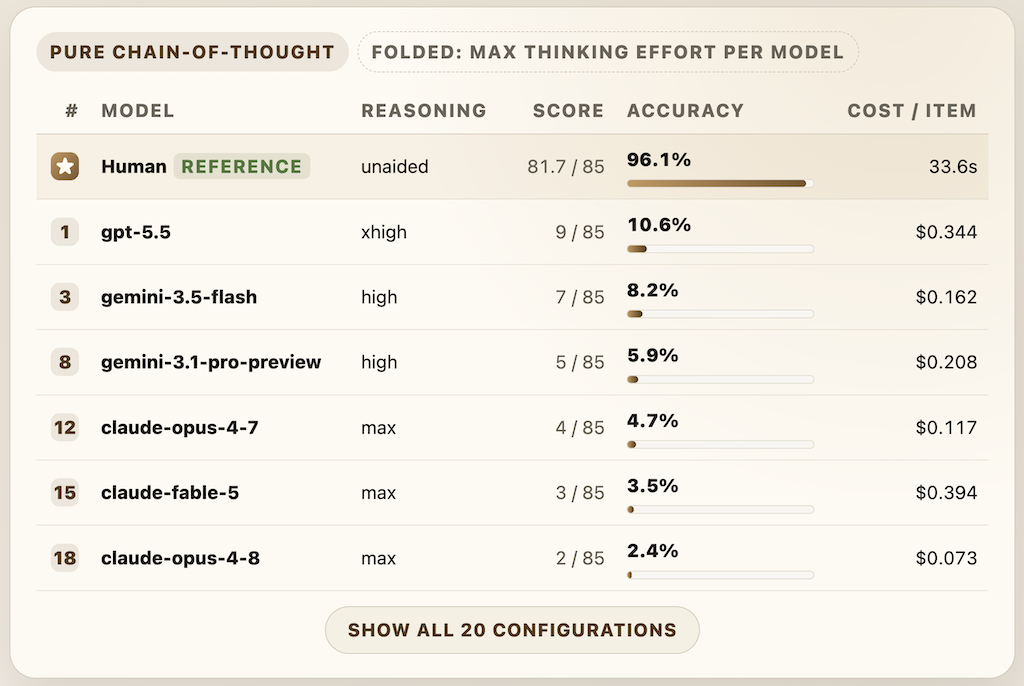
數字相當直接:人類表現為 96.1%,前沿模型在官方無工具評測下最高約 10.6%,差距接近 9 倍。網站亦列出 agent 版本的 tool-use ablation,像 Claude Code 與 Codex 接入工具後,分數明顯高過純 chain-of-thought,表示問題未必只是「看不懂圖」,而是缺少可逐步外化與操作的解題流程。

  • 收錄 17 個任務,重點放在 distributed scanning 與 sequential traversal 一類逐步觀察題
  • 官方評測涵蓋 Claude、GPT、Gemini,亦提供 agent ablation 腳本
  • 數據集可經 Hugging Face 下載,評測程式以 Python 為主
  • 同一靜態圖片也能迫使模型做多步推理,唔靠影片輸入撐起難度

整個 GitHub 項目比較像研究與評測基建,而唔係即用型產品:你需要先下載數據集、配置對應供應商 API,然後用 repo 內的 eval 腳本跑結果。對做多模態模型評測、Agentic 工作流、或者想驗證 Computer-use agents、CUAs 式外部工具協作價值的團隊,它提供了一個很尖銳的檢查點:模型是否真的會「觀察」,還是只會對影像作高階猜測。
項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, OpenAI, Gemini, API, Python, Anthropic, Dataset 數據集

Google 開源表格基礎模型 TabFM:零樣本處理混合欄位資料

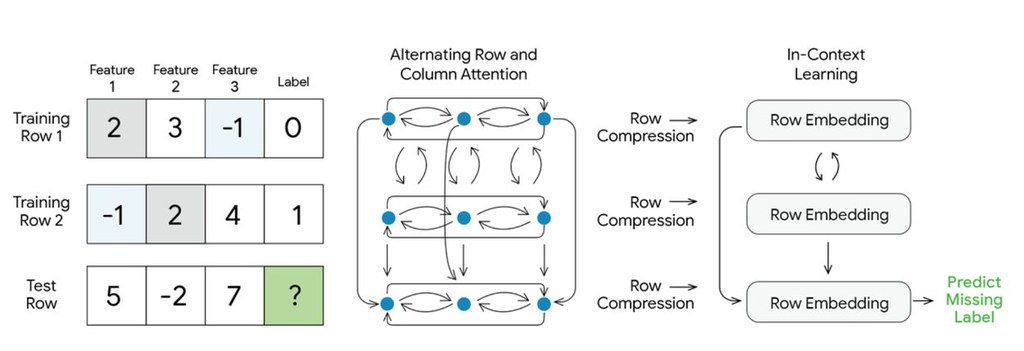
你可以把它理解成一個專門為表格資料設計的基礎模型,由 Google Research 開源,無需訓練即可做分類與迴歸,對於常用 scikit-learn 的團隊特別友善。

Repository image for google-research/tabfm

對熟悉表格資料分析的人來說,每次換資料集就得重新訓練模型,是一個長期存在的痛點。TabFM 想解決的就是這個卡位:透過 in-context learning,把訓練資料當作「上下文」直接餵進模型,省掉逐個資料集做參數訓練的步驟,支援數值與類別混合欄位的零樣本分類與迴歸。

這個項目屬於模型與框架混合性質的開源工具,以 scikit-learn 風格的 API 呈現,因此熟悉 fit、predict、predict_proba 的人可以幾乎無痛地接入。它提供 v1.0.0 預訓練權重,使用者可選擇 JAX(含 Flax 0.12.7 的 flax.nnx API)或 PyTorch(torch 2.12.1)作為後端,權重會自動從 Hugging Face Hub 下載。

與傳統監督式表格模型相比,TabFM 的差異在於「即時預測、不需要再訓練」這個取向,特別適合快速原型設計或資料集頻繁變動的場景;不過它的實際效果仍取決於預訓練權重對目標領域的覆蓋程度。中小型資料團隊、需要處理多種表格欄位類型的研究者,以及想用統一介面同時跑分類與迴歸任務的人,較容易從中受惠。

效能方面,由於原文提供的評測細節有限,難以斷言它在所有基準上的強弱;採用 GPU 版本時推理速度會明顯提升,但 CPU 環境亦可運行。需注意此項目並非 Google 官方支援產品,定位偏向研究原型,正式部署前應自行評估穩定性與資料合規性。

重點摘要:

  • 零樣本推論:無需在自己資料上訓練參數,靠 in-context learning 即時產生預測
  • scikit-learn 相容 API:可用熟悉的 fit、predict、predict_proba 流程接入
  • 混合欄位支援:同時處理數值與類別特徵,免去額外前處理設計
  • 雙後端選擇:可依環境需求在 JAX(Flax)與 PyTorch 之間切換
  • 開源但非官方產品:定位為研究性質,部署前宜自行驗證效果與合規

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Google, API, Python, Dataset 數據集

FunASR 工業級語音辨識:支援廣東話

想在本地架一個 OpenAI 相容嘅語音轉文字 API?ModelScope 嘅 FunASR 將 SenseVoice、Paraformer、Fun-ASR-Nano 等模型收喺同一個 Python 接口,仲支援 vLLM 加速同 MCP 接入 AI Agent。

Repository image for modelscope/FunASR

如果你做過語音相關項目,大概率遇過呢種情況:開源模型散落喺唔同倉庫、部署方式各異、要接入 Agent 仲要自己寫 WebSocket 中間層。FunASR 就係針對呢類工程痛點嘅工業級語音識別工具包,屬於開源框架,由阿里達摩院維護,提供統一 Python 接口,將 ASR、VAD、標點恢復、說話人分離、情感偵測同音訊事件辨識串成一條流水線。

旗艦模型 Fun-ASR-Nano 係基於 LLM 嘅解碼架構,覆蓋中、英、日三語以及中文方言群組;針對 31 種語言嘅場景可以用 Fun-ASR-MLT-Nano-2512;鍾意多語言又有 LLM 解碼能力嘅,亦有 Qwen3-ASR(52 種語言、0.6B/1.7B 參數)。如果想要更輕量、非自迴歸嘅選擇,Paraformer 同 SenseVoice 仍係穩陣起點,前者適合生產線串流,後者額外送情感同音訊事件標籤。

funasr-server 一行指令就可以拉起 OpenAI 相容嘅轉寫 API,本地聽返 localhost:8000,配合 vLLM 仲可以做到 2-3 倍 LLM 解碼加速同 tensor parallel 批次推理。Agent 整合係另一個重點:MCP Server 可以直接接入 Claude 或 Cursor,OpenAI API 接口又同 LangChain、Dify、AutoGen 無縫對齊。最近幾個版本(v1.3.18 至 v1.3.22)就專門執緊 SRT/字幕分段、長時 WebSocket 連線、verbose_json 回傳呢啲工程細節。

要留意嘅取捨係:Fun-ASR-Nano 需要 GPU;新環境第一次 import funasr 已唔再強行依賴 PyTorch,但用 AutoModel 仍然要先裝 torch。FunASR 比較適合需要私有語音 API、字幕生成、長會議轉寫、或想將語音能力塞入 Agent 工作流嘅團隊開發者。

重點摘要:

  • 統一 Python 接口整合 ASR、VAD、標點、說話人分離、情感偵測
  • Fun-ASR-Nano 旗艦模型支援 31 種語言及中文方言,Fun-ASR-MLT-Nano 覆蓋更廣
  • funasr-server 提供 OpenAI 相容 API,搭配 vLLM 可達 2-3 倍加速
  • 內建 MCP Server 支援 Claude/Cursor,亦可接入 LangChain、Dify、AutoGen
  • 近期版本持續優化字幕分段、WebSocket 長連線、verbose_json 回傳等工程細節

以下是其對粵語支持的詳細信息:

  • UniASR模型:這是一個專為粵語設計的語音識別模型,能夠處理簡體中文的粵語語音識別任務。
  • ITN模型:用於對粵語語音識別結果進行擬文本正則化後處理,以提高識別結果的準確性。
  • VAD模型:語音端點檢查模型,用於檢測長語音片段中有效語音的起止時間點,這對於粵語方言的語音識別同樣重要。
  • 訓練語料:為了提高模型的準確性和適用性,通常會使用大量的粵語語料進行訓練,以便模型能夠更好地理解和識別粵語中的特有詞彙和表達方式。
  • 離線功能:Funasr提供了離線語音識別模型,這意味著即使在沒有網絡連接的情況下,也能夠進行粵語語音識別。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Qwen, NVIDIA, API, IDE, LangChain, Python, 語音, Dataset 數據集

[入門教學文章]一文搞懂 CNN、RNN 與 Transformer

見到深度學習名詞一大堆時,最卡的通常不是公式,而是分不清它們各自擅長什麼。這項內容用直觀比喻整理 CNN、RNN 同 Transformer 的分工。

Og image

學深度學習最容易卡住的位置,往往不是模型太難,而是聽過 neural network、Deep Learning、CNN、RNN、Transformer,腦入面仍然分唔清邊個處理影像、邊個擅長序列、邊個適合長距離內容關係。這篇文章屬於入門教學,重點是用 mental model 幫讀者建立直覺,而不是一開始就掉出一堆數學式。

內容先把 AI(Artificial Intelligence)、ML(Machine Learning)同 Deep Learning 的層次關係講清楚,再解釋 neural networks 點樣透過多層表示學習資料特徵。文中亦提醒一個常見誤解:Deep Learning 入面的「deep」主要是指層數夠多,並不是指模型真的像人腦那樣理解世界。

之後的重點放在三類常見架構之間的差異:CNN 適合由局部特徵逐步組合出整體理解,常見於影像;RNN 會按次序處理資訊,較貼近文字或時間序列;Transformer 則更重視整段內容之間的關聯,成為近年自然語言處理與多模態模型的重要基礎。對初學者來說,這種比較方式比單獨背定義更容易入手。

  • 用直觀方式整理 Deep Learning 與 neural networks 的基本概念
  • 把 CNN、RNN、Transformer 放在同一條線上比較用途與取向
  • 強調模型強項來自資料處理方式,而不只是名稱不同
  • 文章亦提到 Keras,方便之後進一步動手建立模型

引用模型:CNN、RNN、Transformer。整體來說,這項內容適合剛接觸深度學習、想先建立整體地圖的人閱讀;有少量 Python 基礎會更易銜接到 Keras,但就算未寫過模型,也能先用它釐清觀念。

項目主頁

Categories: 模型訓練, 教學, Python, 深度學習, Dataset 數據集

UniVR:視覺推理訓練變成可控工作流

UniVR 把 Emu3.5 的視覺推理訓練拆成 SFT 與 GRPO 兩段,讓團隊可用自己的資料同獎勵函數接上去。它更像一個面向視覺任務的訓練骨架,而唔係單一模型。

UniVR Overview

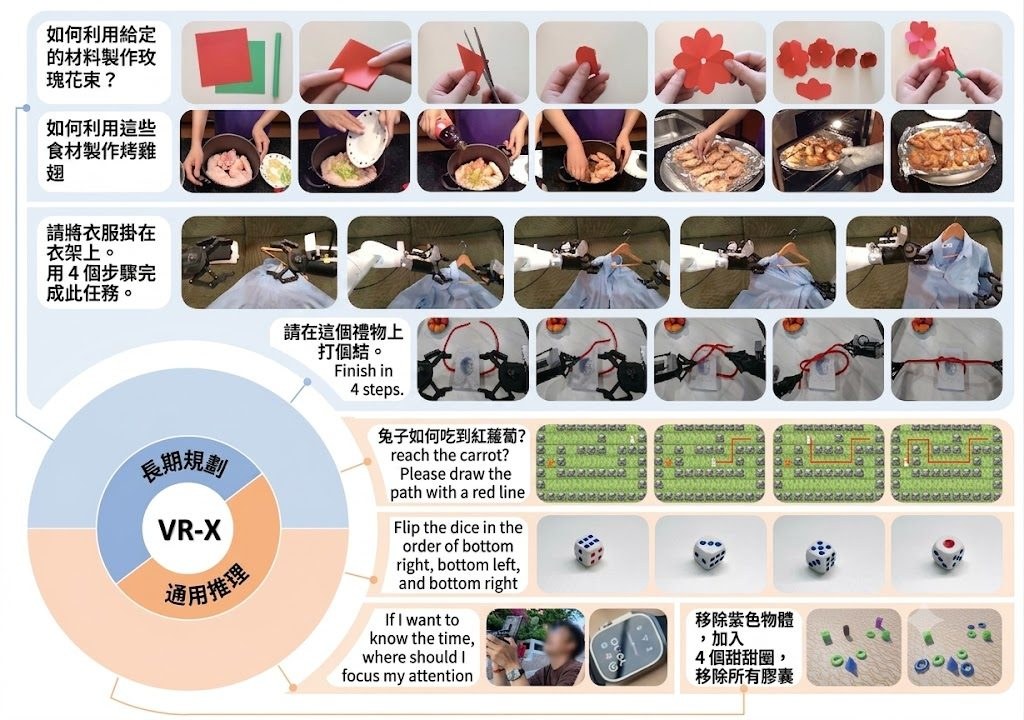
UniVR 係一個能理解我們視覺空間中的思考方式及其在統一視覺推理中的應用,它針對 Emu3.5 unified generative models 的訓練框架,處理的是視覺推理、長程規劃同結果判斷點樣一齊學。它唔係拿來直接做推理展示,而係俾你用自己的資料同獎勵訊號,去微調一個已經懂得處理圖像與文字的底座模型。

SFT(supervised fine-tuning)階段要提供統一格式的樣本:query image、textual instruction、visual reasoning trajectory;RL(reinforcement learning)階段則改成透過 HTTP reward server 送回分數。原始資料沒有提供完整安裝流程,所以目前可確定的只有要把自定義 PyTorch Dataset 接入 UniVR_SFT/train.py,以及把 reward function 換成自己的服務。

和一般只做單次微調的做法相比,UniVR 的取向更偏向「先教格式,再用獎勵修正推理」。它在 RL 端用 GRPO,並配合 HybridEngine 與 Emu3.5 的 vLLM patch,強調 rollout 效率;同時保留 LoRA 同 full-parameter training,適合資源與改動幅度唔同的團隊。

  • 支援多節點 SFT,兼容 LoRA 同 full-parameter training
  • RL 端基於 verl,同 GRPO 搭配自訂 HybridEngine
  • Emu3.5 的 vLLM no-CFG parallel inference 可做到約 2 倍 throughput
  • 獎勵設計分成 format reward、global reward,同 step-level 的視覺推理約束
  • 相關模型包括 Emu3.5 同作為評分器的 Qwen3-VL-30B

較容易受惠的情境包括做視覺代理、機械臂/操作規劃、長程任務推理,或者想將現成視覺模型轉成自己工作流的團隊。它的價值在於把「資料格式、推理軌跡、獎勵判斷」串成同一條訓練路線,令視覺任務唔再只靠靜態標註去學。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Gemini, Image, Python, Dataset 數據集

BadWAM 直指 World-Action Models 盲點

BadWAM唔係做更強控制,而係專門測試 World-Action Models 會點樣「想得啱、做錯事」。對研究機械人安全同對抗攻擊的人來說,呢類偏移比一般失敗更值得警惕。

Repository image for LiQiiiii/BadWAM

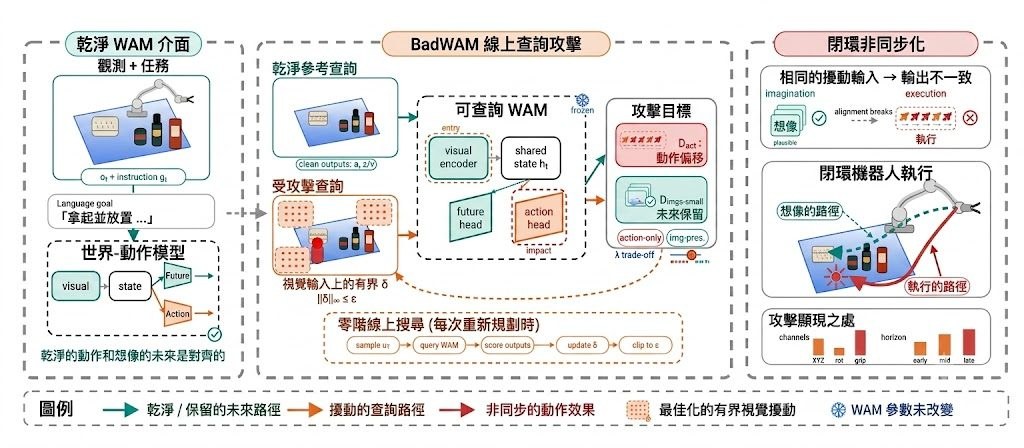
當一個 World-Action Models(WAMs)睇落仍然能夠預測合理未來,但實際控制已經被悄悄帶偏,問題就唔再只是準確率高低。BadWAM 屬於研究型安全測試框架,集中模擬 World-Action Drift Attacks,用細微視覺擾動去拆開「想像」同「行動」之間原本應該對齊的部分。

呢個項目的價值,在於它唔係單純證明模型會失手,而係指出一種更難察覺的失效方式:未來預測仍然似樣,行動卻已經朝向任務失敗。相比一般只睇輸出有冇偏移的對抗攻擊做法,BadWAM更貼近 WAM 的結構特性,分成 Action-only Adversarial Attack 同 Imagination-preserving Adversarial Attack 兩條路線,後者尤其針對「表面正常、實際出錯」的情況。

重點可先睇幾項:
– 支援 query-based 攻擊,重點在凍結的 WAM 上做線上搜尋
– 提供 LIBERO closed-loop attack evaluation,唔只停留在單步分析
– 包含 matched-strength stealth analysis 同 ablation experiments
– 內附 statistics export 與 plotting utilities,方便整理結果

從部署角度看,儲存庫提供的是研究代碼而唔係開箱即用套件,基礎環境指向 Python 3.10+,並建基於 FastWAM。README 亦講明未附 model checkpoints、LIBERO data、dataset statistics、RoboTwin assets 同實驗輸出,所以要重現結果,仍然要自行補齊相關資源與依賴。

現有公開結果已經說明這個框架唔只係概念展示。在 LIBERO closed-loop 測試中,action-only WAM 成功率由 96.5% 跌到 43.1%,joint WAM 亦由 98.1% 跌到 61.5%。受益最大的會係做機械人控制、WAM 安全、對抗魯棒性測試的研究團隊;對一般應用開發者來說,它未必直接幫你部署產品,但很適合作為檢查模型是否「睇落可靠、其實已偏航」的驗證工具。

項目主頁 · GitHub

Categories: 開源, 香港理工大學, 世界模型, 框架, 香港, Python, 安全, Dataset 數據集

EgoMemo 讓助手懂得幾時先開口

唔少助手識回應,真正難的是判斷應否打擾你。EgoMemo把連續第一身影片整理成可檢索記憶,嘗試把主動提醒變成可評測的能力。

Repository image for SitongGong/EgoMemo

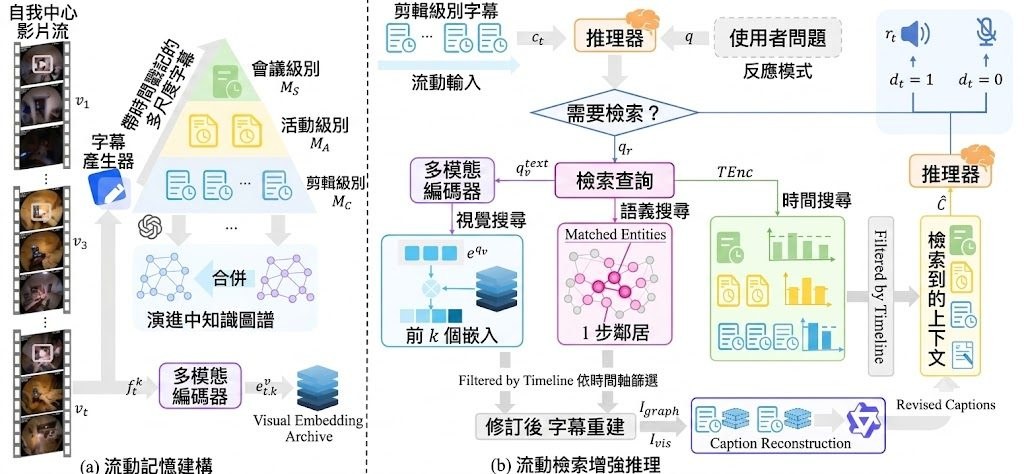
助手最難處理的,不是看見了甚麼,而是判斷幾時該出聲、幾時應該保持安靜。EgoMemo對準的正是這個空位:它屬於一個面向連續第一身影片的記憶增強代理系統,同時附上 benchmark,目標是讓系統根據累積情境主動提供服務,而不只是等人發問或對每個事件都作反應。

現有做法多數落在兩個範式:reactive,只會被問到先答;semi-proactive,偵測到預先定義事件就回應。作者認為這兩類方法都欠缺對使用者歷史、當前活動與介入時機的判斷,所以用 EgoServe 重新定義問題,把主動協助視為 context-dependent decision problem,再由 EgoMemo用 three-level temporal memory graph、semantic knowledge graph 同 visual embedding archives 做 retrieval-augmented reasoning。

這個 GitHub 項目不止放出模型思路,亦包含 memory-graph construction + retrieval pipeline、evaluation suite、dataset annotation 與 streaming demo。理解部署方式並不複雜:先準備 Python 3.10 環境與 .env 內的 API keys、資料路徑,再下載 EgoServe 註釋及對應來源影片,之後按不同資料集分開執行 processing 與 retrieval 兩階段,前者建立記憶圖,後者生成 proactive-service response。

  • EgoServe 收錄超過 3,000 個 service instances,橫跨 4 個 temporal memory horizons 與 10 類服務
  • EgoMemo 採用 training-free 設計,重點放在記憶組織與檢索,而不是再訓練一個大模型
  • 項目同時支援 EgoLife、HoloAssist、CaptainCook4D、EyeWo / ESTP-Bench、OVO-Bench 等資料來源
  • retrieval 可切換 caption retrieval、visual retrieval 等設定,方便做 ablation

EgoMemo 不是追求單次問答表現,而是補上長時間情境累積後的判斷能力。受益最大的是做 egocentric AI、智能助理、穿戴式裝置或多模態 Agentic 項目的研究團隊;限制也同樣直接,整個流程依賴外部影片資料、API keys 與多階段處理,重點更接近研究基線與評測框架,而未算一個即裝即用的消費級產品。相關模型與組件方面,儲存庫示例已出現 QwenVL 3 8B Instruct、GPT-5、Gemini 等作為 caption 或 response 端選項。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Embedding, 多模態模型, 模型訓練, OpenAI, Gemini, API, KnowledgeGraph, Python, Dataset 數據集

RINO 用圖像編輯統一視覺任務

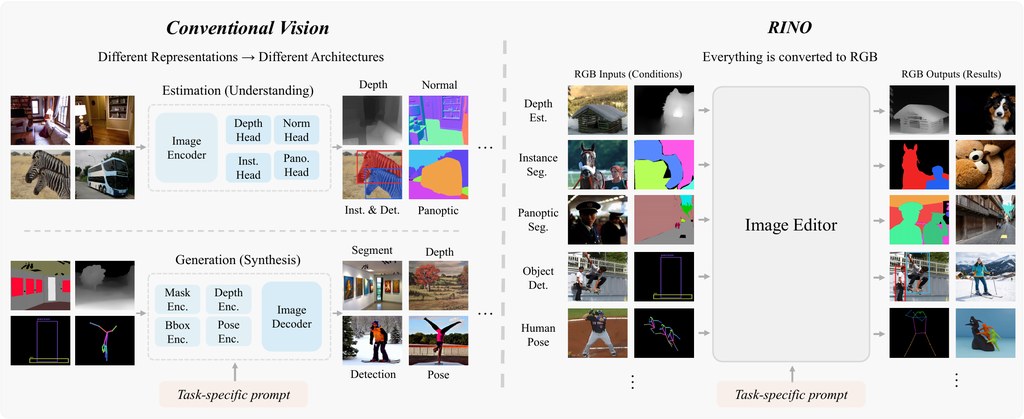
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

MuScriptor 把多樂器轉譜拉近可用水位

想把整首歌拆成可編輯的 MIDI,MuScriptor 提供一條比舊式轉譜工具更貼近真實錄音的路。它重點唔係只識單一樂器,而係處理混音後仍然保留多聲部。

MuScriptor logo

聽住一段完整歌曲,直接整理出可編輯的 MIDI,本來最易卡住嘅位係多樂器同時出現之後,音色、失真同重疊頻段會令轉譜結果迅速走樣。MuScriptor 針對嘅正正係呢種情況:它屬於開源音樂轉譜模型,目標係將真實世界嘅多樂器錄音轉成符號化樂譜,而唔係只喺單一樂器或合成資料上做得好睇。

舊一代 Automatic Music Transcription 往往依賴大量 synthetic training data,代表性做法如 MT3,喺合成測試集成績可以唔錯,但一落到真實混音音樂就容易失準。MuScriptor 嘗試修正呢個範式,先分析 synthetic data pre-training 嘅作用,再結合真實音訊 fine-tuning,同時加入 reinforcement learning 做 post-training,重點唔係追求實驗室式乾淨訊號,而係提升跨曲風、多樂器錄音嘅泛化能力。

對一般創作者、編曲人、音樂研究者同需要把歌曲快速轉成 MIDI 工作流嘅團隊來講,呢個項目吸引力幾直接。它提供 web UI 同 CLI 兩種方式,本地可先用 uvx muscriptor serve 背後嘅介面理解效果,亦可以用命令列批次處理;首次執行前要有 HuggingFace 帳戶並接受模型授權,權重會下載後快取,本地網頁服務預設只開喺 127.0.0.1,改成 --host 0.0.0.0 就可以喺區域網路存取。

  • 已公開 small、medium、large 三個模型,分別為 103M、307M、1.4B 參數
  • small 較適合 CPU-only 環境,medium 係預設速度與準確度平衡,large 追求更高準確率但更重
  • 模型架構採用 transformer decoder only
  • 支援 instrument presence conditioning,用來控制轉譜時聚焦邊類樂器
  • 播放功能唔係單純示意,而係透過完整 SoundFont synthesizer SpessaSynth 回播

限制亦寫得算坦白:權重受 CC BY-NC 4.0 約束;Intel Mac 要留意 PyTorch 同 Python 版本配搭。現有資料指出它訓練用到 170k 首歌,涵蓋 classical music 到 heavy metal,定位上明顯比只靠小量真實資料、再用大批合成音訊補足嘅方法更著重真實混音可用性。對需要高質多樂器 AMT 嘅人,MuScriptor 目前最值得留意嘅,係它唔再只展示「可以轉譜」,而係開始處理「轉出嚟能否進入後續編曲或分析」呢個關鍵差距。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Mac, Python, 音樂, Dataset 數據集

MedPMC 把醫學圖文資料做成可訓練基座

想做醫學影像與文字理解,卡位通常唔係模型,而係乾淨又夠大的圖文配對。MedPMC 把這件事連同訓練流程一併開放,方向相當務實。

Repository image for Yale-BIDS-Chen-Lab/MedPMC

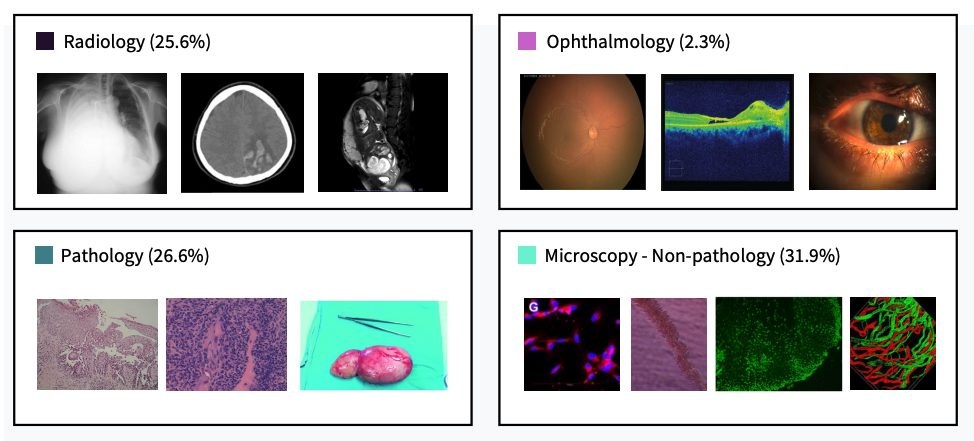
做醫學多模態模型,最難往往不是再堆一個新架構,而是先整理到可用的圖文資料。MedPMC 屬於Dataset 數據集加模型訓練程式碼項目,核心價值是把 PubMed Central (PMC) 文獻中的醫學圖片與文字抽取、清理,再接上訓練與評估流程,處理的是醫學 vision-language 資源長期分散、難重現的問題。

目前最值得留意的是 MedPMC Dataset 首個版本,提供約 1,100 萬組 medical image-text pairs;同時亦有基於 MedPMC-11M 訓練的 MedPMC-CLIP。這種做法與不少只放模型權重、或只交出資料連結的項目不同,它把 dataset curation、preprocessing、model training、evaluation 放在同一個代碼庫,較適合研究團隊沿住同一條流程再做微調或重跑實驗。

部署與測試的理解方式很直接:資料集與模型都已放到 Hugging Face,現階段較像給研究者先下載資料、檢查抽樣品質、再接入自家訓練管線。README 未提供很完整的操作文件,dataset viewer 亦未必可直接預覽,所以短期內它比較偏向有 Python 與資料處理能力的團隊,而不是即開即用的線上服務。

  • 約 1,100 萬組來自 PMC 的醫學圖文配對,是項目現時最重要資產
  • 連同 MedPMC-CLIP 一併釋出,方便由資料走到模型驗證
  • 重點不在花巧介面,而在可重現的資料整理與訓練流程
  • 文件仍在補完中,benchmarks 與更多 training recipes 尚待發布

以現有資訊看,MedPMC 的強項是規模與研究流程整合,限制則是文件與基準結果仍未齊備,暫時較難單靠公開頁面判斷模型表現上限。對醫學 AI、視覺模型、RAG 前處理,或需要建立醫學圖文檢索基座的團隊來說,這個開源項目已有不錯參考價值;相關模型現時可確認的是 MedPMC-CLIP。

項目主頁 · GitHub · 模型

Categories: 開源, RAG, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Image, Medical醫學, Python, Dataset 數據集

Page 15 of 21
1 … 13 14 15 16 17 … 21