MERIT:把音樂相似度拆成三條獨立線索

MERIT 將旋律、節奏、音色拆成三個獨立相似度分數,讓音樂檢索不再只看單一總分,支援更細緻的查詢方式。

MERIT architecture

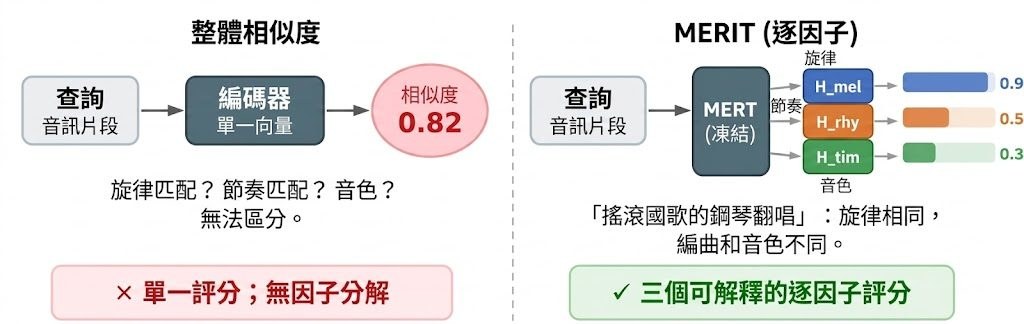
現有的音樂相似度模型大多只輸出一個籠統的總分,把旋律、節奏、音色混在一起計算,使用者很難說明「為何這兩首歌像」。MERIT(Multi-Factor Disentangled Music Similarity)由新加坡科技與設計大學的 AMAAI 實驗室推出,以凍結的 MERT backbone 為基礎,再訓練三個各約 11 MB 的輕量投影頭(projection heads),分別負責旋律(S_mel)、節奏(S_rhy)、音色(S_tim)。一段鋼琴翻唱搖滾歌曲的音檔,會在旋律分數偏高、節奏和音色分數偏低,差異即時可見。

這個項目解決的核心問題是音樂檢索的可解釋性。傳統 CLAP、MuLan 或 MERT 這類自監督音訊模型把多種特徵壓縮到同一向量,餘弦相似度難以拆解;MERIT 改用條件式音訊生成與音源分離技術,自動產生 296K 組「單一變因」三元組訓練資料,免去人工標註。三個頭在 held-out 測試中都達到 ≥99.6% 的三元組準確率,並在零樣本真實音訊探測中各自主導對應的感知維度。

重點摘要:

  • 把相似度拆成旋律、節奏、音色三條獨立訊號
  • 採用凍結 MERT-v1-330M 主幹,僅訓練小型投影頭
  • 透過生成式管線產生 296K 因子控制三元組,無需人工標註
  • 每個頭約 11 MB,總計約 33 MB,方便部署
  • 預訓練權重與資料集已發布於 HuggingFace

合適的場景包括音樂串流平台的進階推薦、音樂學研究中的跨版本比較,以及需要解釋「為何推薦這首」的場景。對一般使用者而言,把 S_mel 較高的曲目組成「同一旋律」歌單,就能體驗到差異。

運作流程相當直接:下載三個 .pt 投影頭,以 Wav2Vec2FeatureExtractor 讀入音檔,從 MERT 指定的第 3、4、5、6、23 層抽取特徵,分別送入三個頭即可得到三組 embedding,再以餘弦相似度比較。模型與資料集皆已開源,有興趣的開發者可從 HuggingFace 取得 amaai-lab/merit 與對應資料集。
GitHub: https://github.com/AMAAI-Lab/MERIT

Paper: https://arxiv.org/pdf/2605.27346

Categories: NVIDIA, OpenClaw, Dataset 數據集

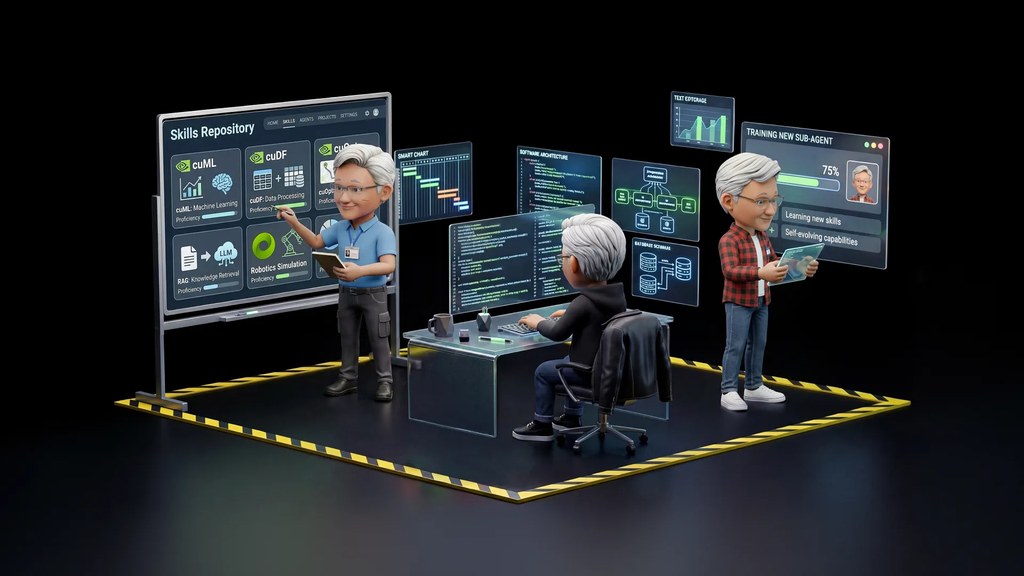
Agent Skill 的安全盲點:當三套掃描器互相矛盾時

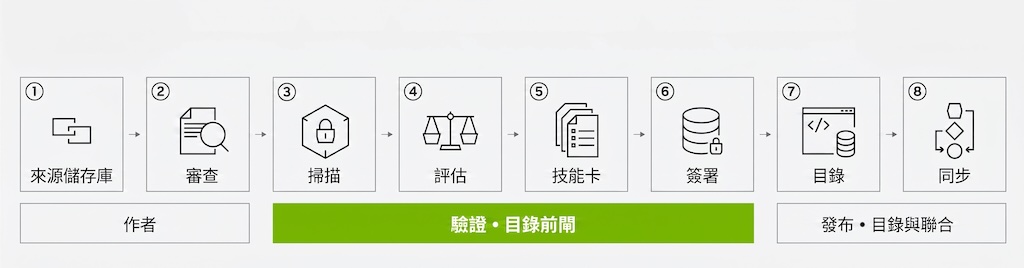
研究團隊發佈逾六萬筆 AI 代理技能的安全掃描數據,發現不同掃描器極少達成共識,揭示單一掃描器難以判斷技能是否安全。

隨着 AI 代理(AI agents)愈來愈普及,一種稱為「代理技能」(agent skills)的新興軟件層亦隨之興起。技能可以包含指令、工具調用模式、可執行腳本等內容,屬於代理與外部工具之間的執行層,與傳統軟件包有明顯差異。技能即使不含惡意程式碼,仍可能因為授予過大權限、隱藏遠端控制路徑或不安全地儲存憑證而構成風險。

OpenClaw 基金會聯同 NVIDIA 發佈了名為 ClawHub Security Signals 的數據集,收錄了 67,453 個最新版本的公開 OpenClaw 技能。每筆紀錄包含已遮罩的 SKILL.md 內容、清理後的附帶檔案,以及三套掃描器的結果:VirusTotal、靜態啟發式分析,以及 NVIDIA 自行開發的 SkillSpector。研究團隊並非要估算惡意技能的普及率,而是聚焦於「掃描器之間的分歧」這個現象。

研究結果令人意外:三套掃描器極少對同一批技能發出警示。任何兩個掃描器的重疊率最高只有 10.4%,三者同時標記的技能僅佔 0.69%,而被單一掃描器標記的技能卻高達 81.9%。這種分歧並非隨機,而是呈現出明確的結構。SkillSpector 專門針對語意層面的代理風險,在 25,504 個可疑項目中有 75.3% 觸發警示,但在確認惡意的 206 個項目中只標記了 6.8%。相反地,在確認惡意的項目中,VirusTotal 標記了 72.8%,與附帶程式碼的惡意軟件證據吻合。

這項研究強調,AI 代理技能的安全審查需要多層次治理(layered governance),不能依賴單一掃描器作出封鎖或放行的決定。

以下是這項工作的重點摘要:

  • 規模龐大的安全數據集:收錄逾六萬個 OpenClaw 技能的最新版本,涵蓋三套不同掃描器的結果。
  • 聚焦於掃描器分歧:研究發現不同掃描器對同一批技能的判斷差異極大,重疊率偏低。
  • 不同掃描器各有所長:SkillSpector 擅長識別語意層面的代理風險,VirusTotal 則對附帶惡意程式碼的技能更敏感。
  • 支持分層治理理念:研究主張技能安全需要多層次、多工具的綜合判斷,而非單一指標。
  • 公開版本供社群使用:數據集以「銀標準」形式發佈,標籤來自自動判定而非人工標註,研究團隊歡迎社群在此基礎上開發更專門的技能安全分類模型。

這個項目最適合關注 AI 代理安全、軟件供應鏈防護及自動化安全掃描的研究人員與工程師。數據集已在 Hugging Face 上公開,研究團隊鼓勵社群進一步開發針對技能安全分類的模型。

Paper: https://arxiv.org/pdf/2606.01494

Categories: NVIDIA, OpenClaw, Dataset 數據集

contrastive-probing:拆解 VLM 空間判斷偏差的輕量診斷項目

這個項目不是再做一次答題測試,而是直接觀察 VLM 內部怎樣表示左右、高低與遠近。對想研究模型偏差的人很有參考價值。

Repository image for cheolhong0916/contrastive-probing

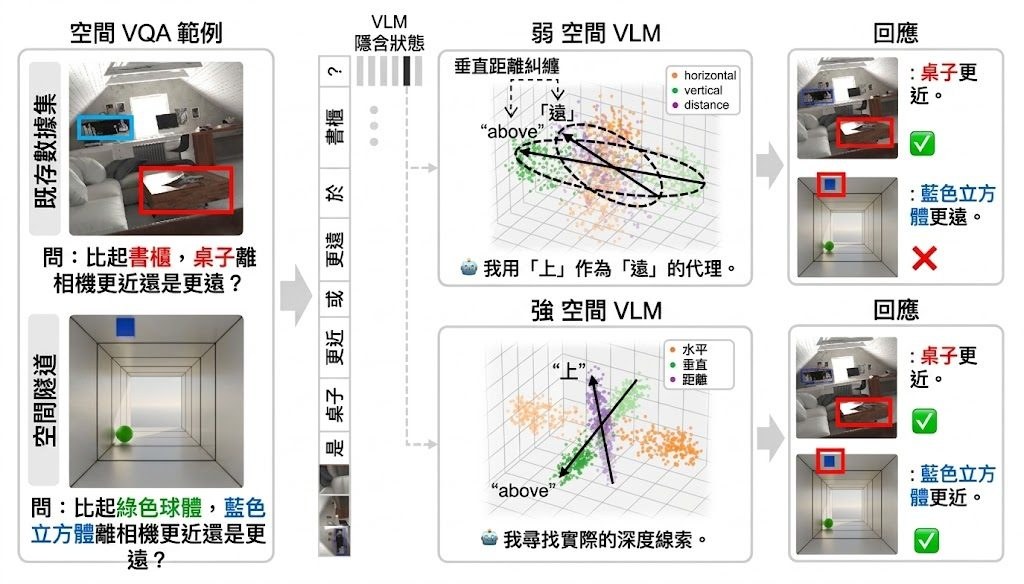
contrastive-probing 是一個用來檢查 Vision-Language Models(VLMs)內部空間表示的輕量項目,焦點不是模型答對幾多題,而是它腦內如何分開 left / right、above / below、far / close。它沿用論文《Why Far Looks Up: Probing Spatial Representation in Vision-Language Models》的 contrastive probing 方法,透過交換問題中的兩個物件,再比較 hidden states 差異,抽出 Δ vectors 作分析。

使用時,做法是把一張圖片配上一條原始空間問題,再生成一條交換 obj1 ↔ obj2 的對照問題,之後對同一個 VLM 跑兩次 forward,並在每層 transformer 擷取最後 token 的表示。這個流程可配合 🤗 transformers 載入的模型,然後輸出 Axis Coherence、6×6 Δ-similarity heatmap、2D/3D PCA 視覺化,以及 Vertical–Distance Entanglement Index(VD-EI)等結果。

這個項目解決的核心問題,是 benchmark accuracy 往往只告訴你模型有冇答中,卻未必揭示它是否用對了空間線索。論文與附帶說明指出,多個模型家族都出現 vertical-distance entanglement,也就是把畫面較高的位置誤當成較遠,反映自然照片常見的 perspective heuristic「higher in the image ⇒ farther away」。

  • 用最少對照設計觀察表示層,而不只看答題分數
  • 可比較不同 layer 的空間軸是否清晰分離
  • 能發現 vertical 與 distance 是否糾纏,幫助找出偏差來源
  • 適合分析 EmbSpatial-Bench、SpatialTunnel 這類空間推理資料

對研究者、模型分析人員,或者要檢查 multimodal assistant、robotics、embodied agents 背後空間推理可靠性的人,這個項目尤其有用。現有資料顯示,就算 benchmark 分數相近,不同 VLM 的內部表示也可能差很遠,而空間軸分得較清楚的模型,通常在不同測試上的穩健性會較好。

整體來看,這不是訓練新模型的項目,而是一套偏向診斷與解釋的工具。它的創新點在於用 minimal contrastive pairs 加上 representation-level analysis,把「模型為何會答對或答錯」拆成更具體的內部結構問題,對想深入理解 VLM 空間能力的人,價值比單看排行榜更高。

GitHub: https://github.com/cheolhong0916/contrastive-probing

項目: https://cheolhong0916.github.io/whyfarlooksup.github.io/

Categories: 開源, 視覺模型, 世界模型, 模型訓練, NVIDIA, 框架, 3D

AIQ 為代理工具加上深度研究能力

NVIDIA AI-Q把深度研究流程封裝成可重用技能,讓代理工具更易處理多來源分析。

Og image

不少代理工具本身已很擅長協調流程,例如管理對話、串接工具和執行程式碼;但一到需要整合多份文件、引用來源、或根據企業資料整理長篇分析,開發團隊往往要自行處理大量繁瑣工作。這篇內容介紹的 NVIDIA AI-Q,重點正是把這類深度研究能力封裝成可攜的項目技能,讓代理工具直接調用。

它解決的問題很明確:團隊不用再為每個項目重建檢索、規劃、整理、引用與評估流程。代理工具可把研究任務交給本機或託管的 AI-Q 伺服器,之後收回一份有結構、附引用的報告;而敏感資料亦可留在企業內部環境,對醫療、金融、政府及國防等重視資料管控的場景尤其重要。

上手方式亦相對直接。這個項目提供 SKILL.md 說明檔,以及一個輔助腳本去處理請求路由、提交工作、輪詢進度和取回結果。使用前需要 Python 3.10 或以上,並準備一個可連線的 AI-Q Blueprint 伺服器;預設會連到本機位址,也可透過環境變數改寫。

Give Codex a Deep Research Skill With NVIDIA AI-Q

重點可概括如下:
– 把深度研究流程包裝成代理工具可調用的技能
– 支援多來源資料整合,並輸出附引用的報告
– 減少每個項目重複搭建研究流程的工作
– 讓敏感資料可保留在企業內部環境
– 可配合 Claude Code、Codex 等通用代理工具使用

這個項目的創新之處,在於它不是只提供單一工具函式,而是把意圖分類、澄清問題、淺層研究、深度研究與評估整合成較高層的能力。換句話說,代理工具只需學會如何委派,便可利用完整研究管線,較適合想快速為現有代理系統加入研究能力的團隊。文中未見具體效能數字或基準測試,因此現階段較適合把它理解為一個工程整合與工作流程簡化方案。

模型列表:Claude Code、Codex

GitHub: https://github.com/NVIDIA-AI-Blueprints/aiq/tree/v2.1.0

項目: https://developer.nvidia.com/blog/add-a-specialized-deep-research-skill-to-agent-harnesses/

Categories: 開源, Agentic, NVIDIA, 框架

Aurora:把影片編輯指令講清楚的 AI 代理

Aurora 想處理影片編輯最麻煩的一步:把含糊要求轉成可執行流程。它把代理式理解與影片生成結合,方向幾幾清晰。

Repository image for yeates/Aurora

Aurora 是一個面向影片編輯的 AI 項目,重點不只是「生成畫面」,而是先理解你想改甚麼。它把使用者一句較口語、甚至有點含糊的要求,整理成較明確的編輯計劃,再交給影片模型處理,目標是減少「講唔清、改唔準」的情況。

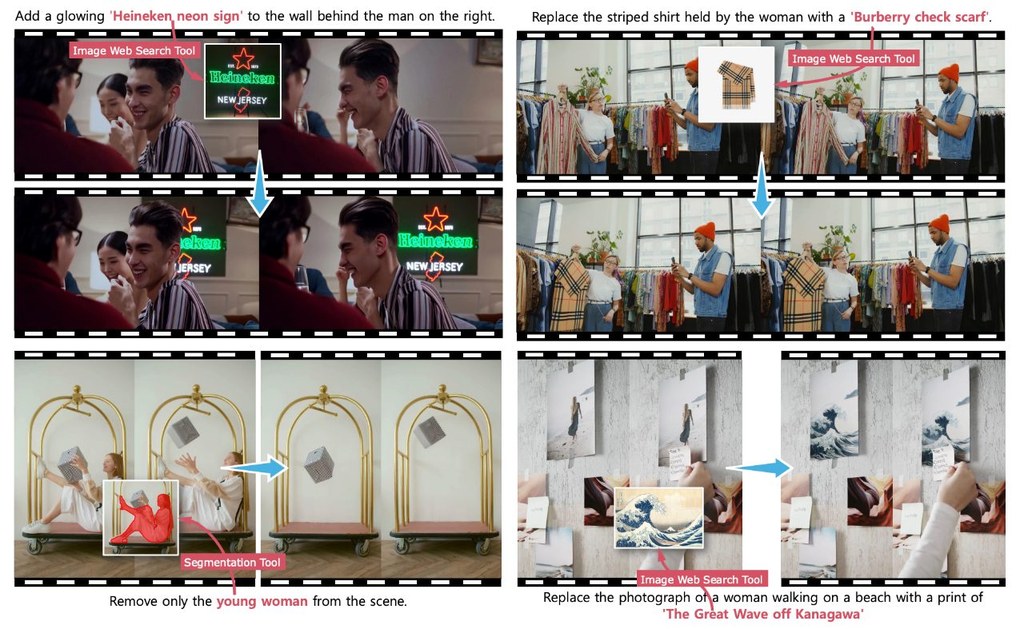
這個項目想解決的核心問題,是影片編輯要求經常不完整。你可能只說想「換走背景」、「刪除路人」或「改成某種風格」,但未必提供參考圖,亦未必指出遮罩範圍;Aurora 會嘗試補回這些缺口,例如用圖像搜尋找參考,或用分割方式找出需要修改的位置。

它較有新意的地方,在於把多種影片編輯工作放進同一個框架,而不是每種效果各自一套模型。根據目前資料,這個項目支援替換、移除、風格轉換,以及根據參考內容插入元素,背後並結合了工具增強的視覺語言模型代理,以及統一的影片 diffusion transformer,也就是影片 DiT。

動手了解這個項目時,可先把它當成「會先幫你整理需求的影片編輯助手」。現階段儲存庫內容顯示官方實作仍在準備中,所以較適合先閱讀論文與項目頁,理解它如何把原始要求拆成指令、任務標籤、圖像搜尋查詢與遮罩描述四部分,再留意之後公開的程式。

  • 同一個項目框架處理多類影片編輯工作
  • 會先重寫使用者要求,再交由影片模型生成
  • 可補足缺少的參考圖與編輯區域資訊
  • 相關模型重點包括工具增強 VLM 代理與影片 DiT
  • 另有 AgentEdit-Bench,用來評估這類代理式影片編輯能力

對內容創作者、影像研究人員,或者關心人機協作編輯流程的人來說,Aurora 特別值得留意。它未必是即刻可用的成品,但從設計方向看,這個項目著重的不是單次炫技效果,而是令影片編輯指令變得更完整、更可執行。

GitHub: https://github.com/yeates/Aurora

Paper: https://arxiv.org/pdf/2605.18748

Categories: 開源, Agentic, NVIDIA, 框架, 中國

LongLive:長片段影片生成再快一步

LongLive 專注解決長影片生成的速度與記憶體壓力,重點放在更長、更連貫的輸出流程。它同時照顧訓練與推理效率,方向相當清晰。

LongLive2.0 logo

LongLive 係 NVIDIA NVLabs 針對長影片生成提出的基礎設施,核心目標唔係單純「整到片」,而係令模型喺處理長時間、多鏡頭內容時,冇咁易被記憶體同速度拖慢。由 1.0 強調即時互動式生成,到 2.0 加入 NVFP4 平行化設計,重點已經擴展到訓練、蒸餾同推理全流程。

實際使用時,較自然嘅路線係先睇示範頁同文件,了解佢點樣接收連續提示詞,再按需要選擇 BF16 或 NVFP4 模型版本。現有公開模型包括 LongLive-2.0-5BLongLive-2.0-5B-NVFP4-S4,而較早期分支亦有 LongLive-1.3B,方便分別比較畫質、速度同硬件需求。

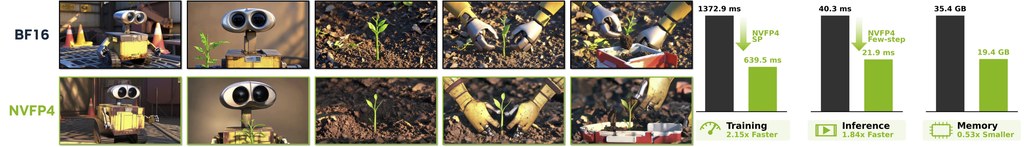
呢個專案最值得留意嘅地方,在於佢唔只優化生成結果,仲直接處理長影片常見樽頸,例如 KV cache 佔用、跨卡通訊、以及多鏡頭自回歸生成時嘅效率問題。資料顯示,2.0 版本支援多鏡頭或單鏡頭訓練、序列平行推理、非同步解碼,同時可用較低精度格式減少記憶體開銷;論文亦提到訓練與推理速度都有明顯提升,但實際表現仍要視乎 GPU 架構而定。

  • 支援長影片、多鏡頭連續生成,方向比一般短片生成更明確
  • 提供 BF16NVFP4 版本,方便按硬件取捨
  • 針對訓練與推理一齊優化,唔係只顧其中一端
  • 包含序列平行、KV cache 量化、非同步解碼等工程設計
  • 適合研究人員、影片生成開發者,同埋需要評估部署效率嘅團隊

整體來講,LongLive 比較似一個面向進階影片生成工作流嘅「引擎室升級」,特別適合關注長片段敘事、互動式生成,或者想研究多鏡頭影片模型點樣落地嘅人。對一般讀者而言,最容易理解嘅價值就係:佢嘗試用更慳資源、更快嘅方式,令 AI 生成長影片唔再只停留喺概念展示。

GitHub: https://github.com/NVlabs/LongLive

Paper: https://arxiv.org/pdf/2605.18739

Categories: 開源, NVIDIA, 影像模型

AnyFlow:影片生成更靈活的一步

AnyFlow 主打「任意步數」影片生成,同一模型可兼顧速度與畫質。對想試文字轉影片的人來說,方向相當實際。

Repository image for nvlabs/AnyFlow

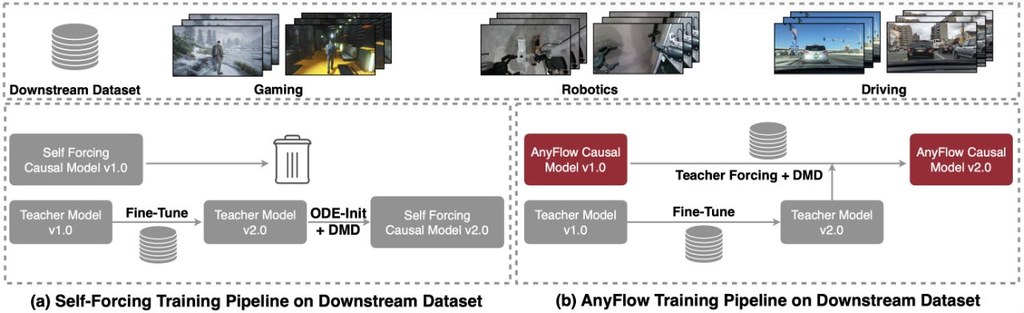
AnyFlow 是 NVIDIA Labs 推出的影片擴散框架,重點不是單純把片生出來,而是讓同一個模型可按你手上的運算時間,自由調整推理步數。簡單講,趕時間時可以用較少步數先出結果;有更多資源時,再加步數換取更穩定的細節表現。

實際使用上,它較適合研究員、開發者或內容生成團隊,用來測試文字轉影片、圖片轉影片,以及影片轉影片。README 顯示它已有示範程式和預訓練模型,代表使用者可直接下載模型試效果,而不一定要由零開始訓練。

這個專案較有新意的地方,是把傳統常見「固定步數」的限制放寬,做成 any-step 生成。對非專業人士來說,可理解為同一套引擎在快出片與慢慢精修之間更有彈性,而不是每種速度都要換另一個模型。

  • 支援 Text-to-Video、Image-to-Video、Video-to-Video
  • 可配合不同推理步數,平衡速度與質素
  • 涵蓋 causalbidirectional 影片擴散架構
  • 已驗證可擴展到 1.3B 至 14B 參數級別

若你要做社交媒體短片原型、廣告分鏡視覺化,或研究影片生成流程,AnyFlow 的定位相當清晰。相關模型方面,README 提到可找到 AnyFlow-FAR-Wan2.1-1.3B-Diffusers、AnyFlow-FAR-Wan2.1-14B-Diffusers、AnyFlow-Wan2.1-T2V-1.3B-Diffusers、AnyFlow-Wan2.1-T2V-14B-Diffusers;名稱反映它既有偏研究框架,也有文字轉影片版本。整體來看,這不是一般即開即用的消費級工具,但對需要靈活控制生成成本與效果的人,確有參考價值。

Source: https://github.com/nvlabs/AnyFlow

Categories: 開源, 模型, 視頻模型, NVIDIA, 影像模型

Moonlake AI 3D 建模代理

Moonlake AI 推出的 3D Agent 是其世界建模代理的重要更新,能直接在 Blender 中操作電腦,自動建立 3D 場景、關節資產與複雜環境。 主要功能 它能從單一圖像重建可編輯的室內外場景,無需預定義規則;同時建模具零件與關節的資產,並持續精煉數千步驟。代理像技術藝術家般運作,整合現有製作流程,支援資產管理系統並批量啟動任務。早期合作夥伴已用於模擬資產創作、遊戲世界建置與場景清理等重複工作自動化。 應用場景 適用於遊戲開發、3D 內容生成與生產線自動化,能加速互動世界建置達 100 倍。Moonlake AI 獲 NVIDIA 等投資,聚焦多模態推理模型與生成遊戲引擎。

Moonlake AI 推出的 3D Agent 是其世界建模代理的重要更新,能直接在 Blender 中操作電腦,自動建立 3D 場景、關節資產與複雜環境。

主要功能

它能從單一圖像重建可編輯的室內外場景,無需預定義規則;同時建模具零件與關節的資產,並持續精煉數千步驟。
代理像技術藝術家般運作,整合現有製作流程,支援資產管理系統並批量啟動任務。
早期合作夥伴已用於模擬資產創作、遊戲世界建置與場景清理等重複工作自動化。

應用場景

適用於遊戲開發、3D 內容生成與生產線自動化,能加速互動世界建置達 100 倍。
Moonlake AI 獲 NVIDIA 等投資,聚焦多模態推理模型與生成遊戲引擎。

Categories: Agentic, NVIDIA, 3D

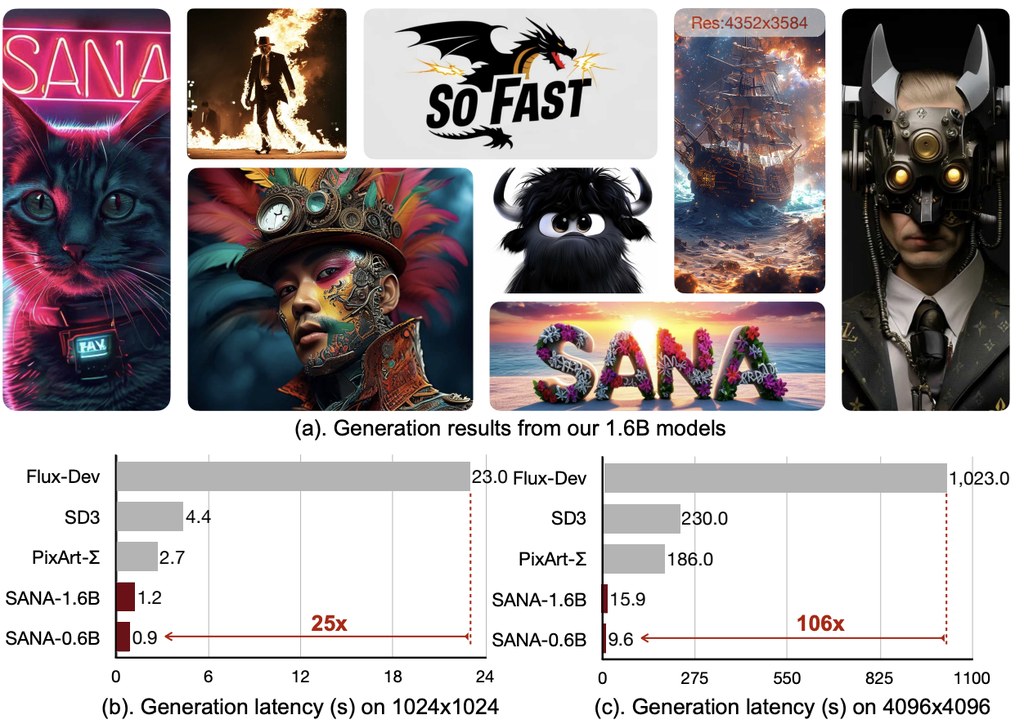
NVlabs/Sana:SANA:使用線性擴散變換器進行高效高解析度影像合成:快速專案概覽

SANA 是一個以效率為導向的代碼庫,用於高解析度影像和視訊生成,提供完整的訓練和推理管道。此儲存庫包含 SANA、SANA-1.5、SANA-Sprint 和 SANA-Video 的代碼。

logo
來源:GitHub 上的 NVlabs/Sana

SANA 是一個以效率為導向的代碼庫,用於高解析度影像和視訊生成,提供完整的訓練和推理管道。此儲存庫包含 SANA、SANA-1.5、SANA-Sprint 和 SANA-Video 的代碼。更多詳細資訊可以在我們的 📚 文件中找到。

我們介紹 SANA ,一系列用於高解析度影像和視訊生成的高效擴散模型:

  • SANA :生成高達 4K 解析度的文本到影像,比 Flux-12B 小 20 倍且快 100 倍。
  • SANA-1.5 :在訓練時間和推理時間進行高效的計算擴展,以獲得更好的品質。
  • SANA-Sprint :透過 sCM 蒸餾進行一步/少步生成,在 H100 上每張 1024px 影像只需 0.1 秒。
  • SANA-Video/LongSANA :使用區塊線性注意力 / 配合 LongLive 進行高效的視訊生成。
  • 線性注意力 :在 DiT 中用線性注意力替換傳統注意力,以在高解析度下提高效率。
  • DC-AE :32× 影像壓縮(與傳統的 8× 相比)以減少潛在令牌。

來源:https://github.com/NVlabs/Sana (NVlabs/Sana)

Source: https://github.com/NVlabs/Sana

Categories: 開源, 香港大學, NVIDIA, 影像模型, 新聞

LongVie 2 – 可控超長影片生成

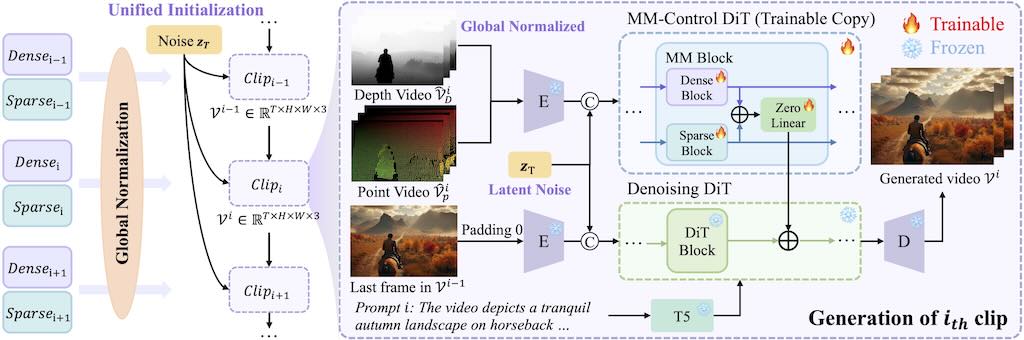
可控的超長影片生成是一項基礎但具有挑戰性的任務,因為現有的方法雖然對短片段有效,但由於時間不一致和視覺品質下降等問題而難以擴展。 LongVie 2 的核心設計可確保時間一致性:1)統一雜訊初始化策略,在各個片段之間保持一致的生成;2)全域控制訊號歸一化,可在整個視訊的控制空間中強制對齊。為了減輕視覺品質下降,LongVie 2 採用密集(例如深度圖)和稀疏(例如關鍵點)控制訊號,並輔以一種退化感知訓練策略,可以自適應地平衡模態貢獻以保持視覺品質。

可控的超長影片生成是一項基礎但具有挑戰性的任務,因為現有的方法雖然對短片段有效,但由於時間不一致和視覺品質下降等問題而難以擴展。

LongVie 2 的核心設計可確保時間一致性:
1)統一雜訊初始化策略,在各個片段之間保持一致的生成;
2)全域控制訊號歸一化,可在整個視訊的控制空間中強制對齊。為了減輕視覺品質下降,LongVie 2 採用密集(例如深度圖)和稀疏(例如關鍵點)控制訊號,並輔以一種退化感知訓練策略,可以自適應地平衡模態貢獻以保持視覺品質。

LongVie 2 : Multimodal Controllable Ultra-Long Video World Model
Categories: 開源, 模型, 多模態模型, 視頻模型, NVIDIA, 影像模型

Page 10 of 11
1 8 9 10 11