SepGen 讓影片生成同時輸出獨立聲軌

SepGen 把影片生成與聲音分離放進同一模型,讓每種聲音獨立輸出,方便重混及空間音效製作。

SepGen overview

影片生成不再只產生一條混合音軌:SepGen 是一個多模態生成模型,處理影片畫面、完整配樂,以及按描述分開的聲音 stem。你可以描述場景和各種聲音生成新片,也可以交給它現有影片,抽取指定聲音。

SepGen 建基於 LTX-2.5,在同一次運算加入兩條由文字控制的音訊軌;原有完整 soundtrack 保持不變,每條 stem 只根據自己的描述生成。相同模型同時支援 generation 和 separation,分離後的聲音亦可配合場景位置,延伸至 4D video 和 spatial audio 工作流程。

  • 生成影片、完整 soundtrack 及獨立聲軌
  • 以文字指定要抽取的聲音
  • 同一組 weights 支援兩種任務
  • 可配合移動視角重新呈現聲音位置

項目適合影片後期、遊戲場景、互動媒體及需要重新混音的研究團隊。README 提供 Linux、ffmpeg 及單張 48 GB NVIDIA GPU 的執行條件;模型 weights 約 72 GB,每段影片在 RTX A6000 上需數分鐘,長片則要啟用 VAE tiling,且 num-frames 必須符合 8k+1。

SepGen 的取捨在於硬件及模型容量要求不低,README 亦未提供低記憶體替代方案。gen-3k checkpoint 可用於 generation,分離能力約相近;項目同時提供模型與 SepGen-Dataset,但目前資料未交代更廣泛硬件的性能比較,較適合作為研究原型或具備 NVIDIA 工作站的製作項目。
項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, NVIDIA, Video, Audio, Linux, LTX, Dataset 數據集

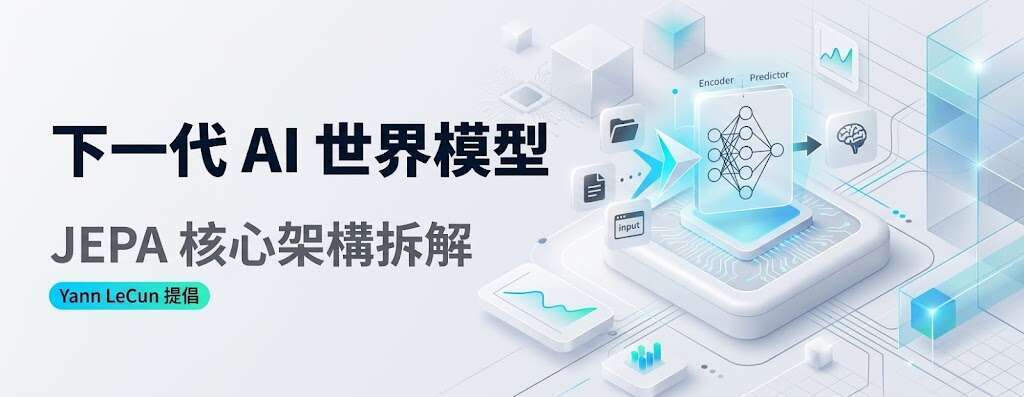
JEPA 以潛在世界模型加速機器人決策

JEPA 不再逐幀生成畫面,而是在抽象特徵中預測世界如何變化,降低機器人規劃的算力成本。

Og image

機器人或自動駕駛系統需要預測動作帶來的後果,單靠文字推理難以掌握物體移動、空間關係與物理變化。聯合嵌入預測架構(Joint Embedding Predictive Architecture,JEPA)屬於潛在動態世界模型,直接在抽象特徵空間推演未來狀態,避開逐步生成高解析度畫面的成本。

世界模型通常要完成渲染、模擬與規劃三類工作,JEPA 主要集中於模擬和預測。它不重建像素,而是從視覺或感測資料抽取高層次表徵,再預測下一個潛在狀態;這種做法有助減少噪聲影響,亦讓智能體能在較低成本下進行多步策略推演。

文章將世界模型分為三大類:直接生成未來觀測的模型、在潛在空間運作的模型,以及明確表示物件、深度和幾何佔據的結構化模型。JEPA、I-JEPA、V-JEPA 和 DINO-WM 屬於預測表徵路線,Dreamer 和 PlaNet 則以重構型狀態空間支援想像式訓練。

  • JEPA 適合機器人快速規劃及強化學習 roll-out
  • 不生成像素,換取較低算力需求和較高推演效率
  • 視覺生成模型較擅長畫面還原,JEPA 偏向狀態預測
  • 自動駕駛仍可能需要結合 OccWorld 等空間幾何模型

選擇架構時要視乎瓶頸在視覺逼真度、運算預算,還是 3D 空間與物理精準度。JEPA 能有效處理抽象動態,但若項目需要可視化未來畫面或精確描述物體幾何,便可能要配合觀測生成模型或結構化世界模型。

項目主頁

Categories: AI productions, 多模態模型, 世界模型, Google, NVIDIA, 強化學習

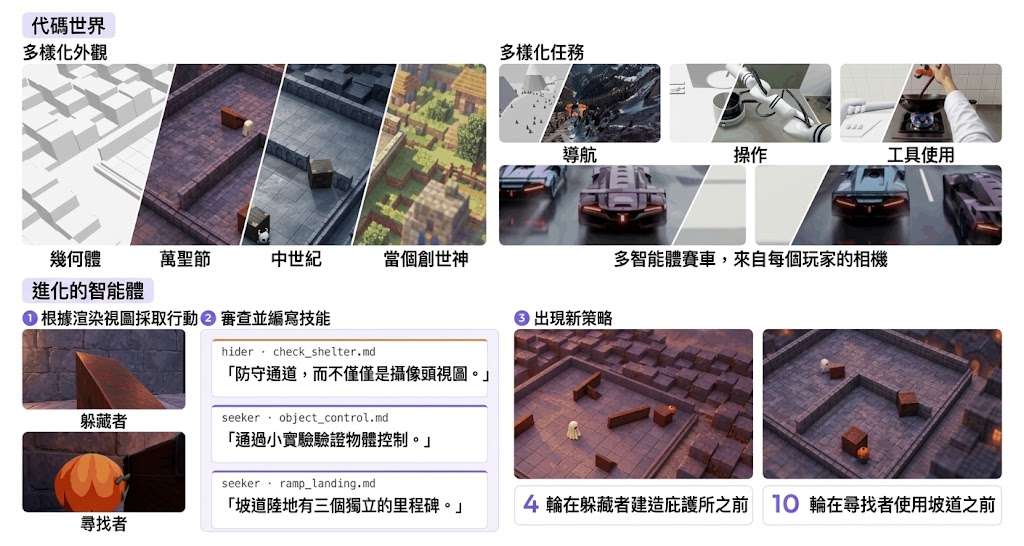
AgentGarten 以神經渲染器打造可演化的 AI 世界

AgentGarten 讓智能體在由程式控制狀態與規則、再由神經渲染器生成畫面的世界中反覆學習,兼顧可控性與視覺真實感。

MirroS logo

讓智能體在同一個世界反覆試錯,關鍵不只在模型能力,也在環境是否真的記得狀態、遵守規則,並以接近真實的畫面回應行動。AgentGarten 屬於面向 Agentic 系統的互動環境與神經渲染器項目,處理的是可執行世界難以同時兼顧規則一致性、視覺質感與即時速度的問題。

世界中的物件、目標和變化由程式保存,程式輸出的 depth 或 surface normals 則交給共享 neural renderer 生成智能體看到的畫面。renderer 以 NVIDIA Cosmos3-Nano 為基礎,先用 bidirectional rectified-flow 訓練完整影片,再以 autoregressive block-causal 方法配合 teacher forcing 或 diffusion forcing 生成後續畫面,最後透過 Adversarial Forcing 將模型蒸餾成較少步驟的學生模型。

目前公開內容集中在 neural renderer、訓練配方及 streaming inference;code worlds 和完整 agent practice loop 仍會逐步加入。試用需要 Python 3.11 或以上、PyTorch 2.9 或以上,以及 CUDA 主機,較適合研究智能體、模擬環境或自製互動遊戲的團隊,而非只想即時調用一個現成聊天模型的讀者。

  • 可控狀態:規則和世界變化留在可檢查、可修改的程式內。
  • 統一視覺介面:只要提供幾何條件,同一世界可以切換不同視覺風格。
  • 即時能力:官方資料指在單張 H100、480×832 解析度可超過每秒 30 幀。
  • 學習閉環:智能體每輪把經驗整理成 playbook,交給後續輪次繼承。

這種做法以幾何條件取代為每個世界重新製作完整視覺資產,換來較高彈性,但畫面質素仍取決於 renderer 訓練資料、條件輸出和硬件。項目展示的 shelter、bridge 及 companion dog 場景說明它可支援 self-play RL;不過完整程式世界尚未全部公開,現階段更適合作為研究原型和 renderer 實驗基礎。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, Python, 強化學習

TokenRouter 讓多個模型逐 Token 協作

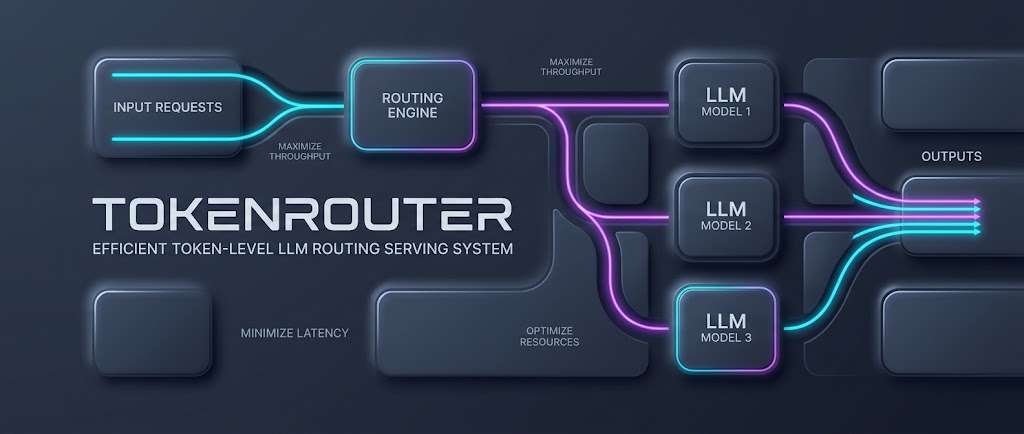
同一個回答可按 Token 在大小模型之間切換,TokenRouter 以專用服務引擎處理路由、交接與批次調度。

TokenRouter Logo

同一個回答需要小型模型快速生成,亦要大型模型處理指定 Token 時,服務系統要同時應付模型切換、不同步解碼和不規則請求。TokenRouter 屬於開源 serving system,專門處理 token-level LLM routing,讓多個模型在單次回應內協作。

開發者只需透過 route()、send() 和 receive() 描述路由邏輯,系統便負責請求交接、Tokenization、Detokenization、批次調度及模型執行。它採用獨立 subserver、非同步 model-centric execution 和 delayed batching,讓快模型繼續解碼,慢模型處理被路由的 Token;Python 3.10、YAML 配置、OpenAI-compatible chat completions 和 Python engine 則提供了較直接的測試入口。

  • 支援同一回應內按 Token 或片段切換模型
  • 內置 scheduler、model executor 及 CUDA graph 支援
  • 可用單機或跨節點配置不同模型
  • 涵蓋五種路由算法、三類工作負載及多組模型配對

測試結果顯示,TokenRouter 在不同算法、工作負載和模型配對下,解碼吞吐量較現有系統高 2.01–64.15 倍。這個差距會受硬件、批次規模、路由頻率及模型組合影響,不能直接視為所有場景的固定提升;項目提供的 Qwen3-0.6B 與 Qwen3-32B 配置,較適合用來理解小型與大型模型協作的流程。

需要研究 token-level routing、測試推理工作流,或營運多模型服務的團隊會較容易受益。TokenRouter 把路由策略與執行引擎分開,保留較大彈性,但亦意味着使用者仍要自行設計算法、準備模型節點和調校分散式通訊,並非即插即用的模型服務平台。

項目主頁 · GitHub

Categories: 開源, 模型, Qwen, NVIDIA, Python, Tokenize

UniWAM 把理解、預測與機械人動作合而為一

UniWAM 以 8B 參數模型整合語意理解、視覺預測和動作生成,瞄準機械人操作中理解與執行脫節的問題。

UniWAM teaser

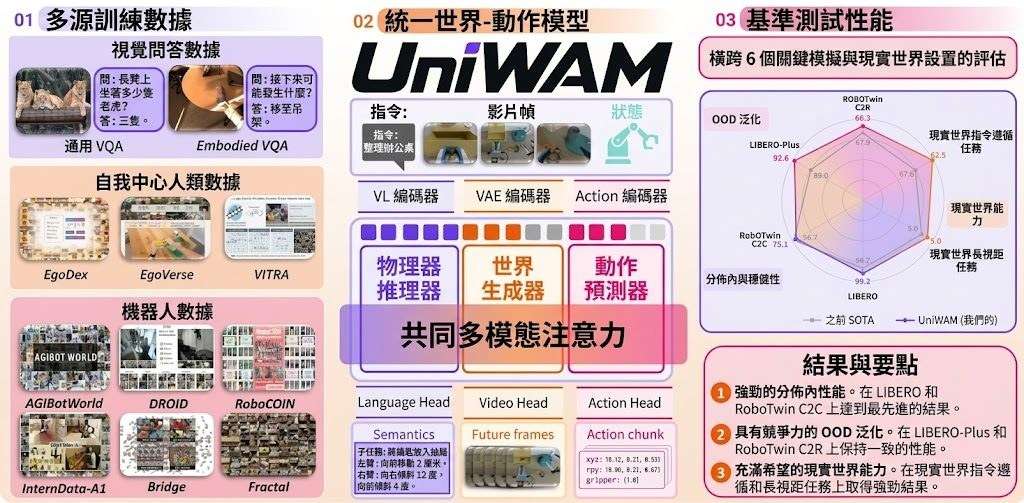
面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。

模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。

  • 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
  • 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
  • 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
  • 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時

GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。

項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。

項目主頁 · GitHub · 項目

Categories: 開源, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, VLA, Robotic, 香港, 工具, Python, 庫, Dataset 數據集

VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

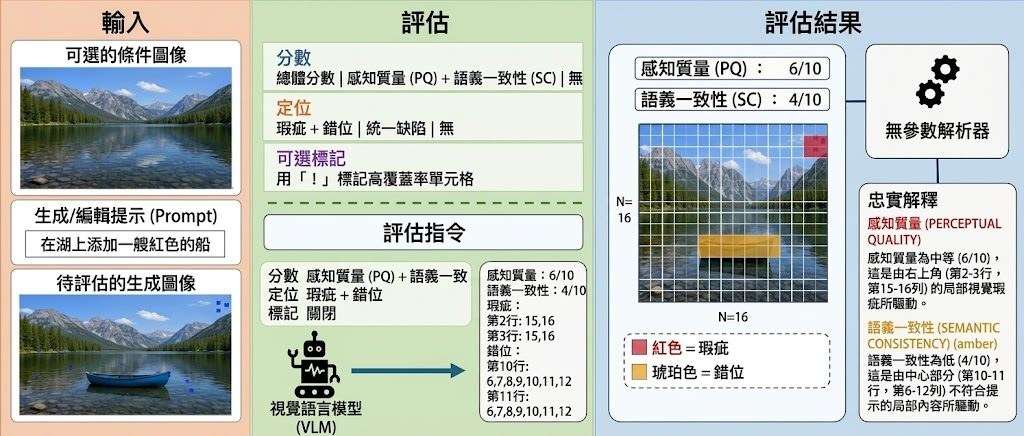
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

WorldSonus architecture

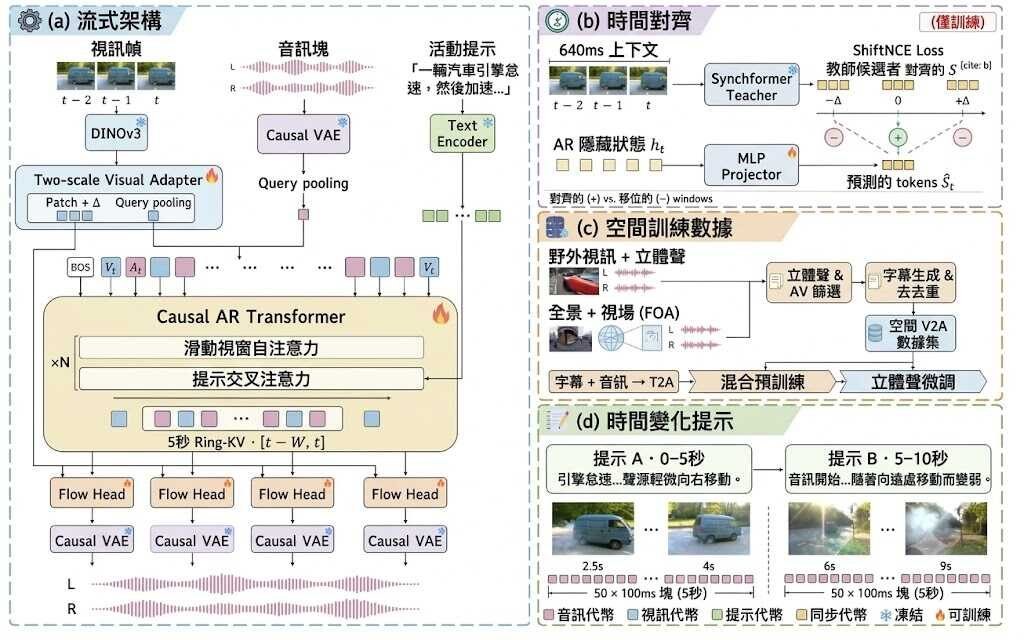
影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

InterMimicGen 讓一段示範變成多種機械人動作

InterMimicGen 把人類互動示範轉化成不同人形機械人的動作,並透過實體執行持續擴充數據。

Og image

一段人類與物件互動的示範,經過 InterMimicGen 可以轉化成多種人形機械人的行走、抓取和操作動作。這個研究項目針對不同機械人身體結構難以直接套用同一動作的問題,連接動作重定向、追蹤、演化和實體部署流程。

系統結合 MimicGen 的動作擴展方式與 InterMimic 的物理落地能力,先把示範調整至不同物件和機械人配置,再由真實機械人執行。每次成功完成的動作都會成為新數據,支援下一輪生成,形成持續增長的數據循環。

• 跨物件重定向,例如行李箱和大型箱子
• 支援 Unitree G1、Dexmate Vega、Booster K1 等平台
• 涵蓋雙手操作、抓取及不同手部配置
• 透過多輪局部修改,逐步擴大動作範圍

研究展示了 Unitree G1 配合 Inspire hands、橡膠手,以及 Dex3 等組合的實體執行案例,也測試大型梳化、三腳架和球拍等不同物件。內容未有提供統一的量化性能指標,成果主要以跨平台動作轉移和連續實體執行作展示。

這個項目較適合研究人形機械人模仿學習、動作重定向和資料生成的團隊。它的價值在於減少每個機械人配置都要重新收集示範的需要,但動作是否成功仍取決於機械人的硬件、手部形態和現場環境。

項目主頁 · Paper

Categories: NVIDIA, Robotic

xllm-loop:循環語言模型

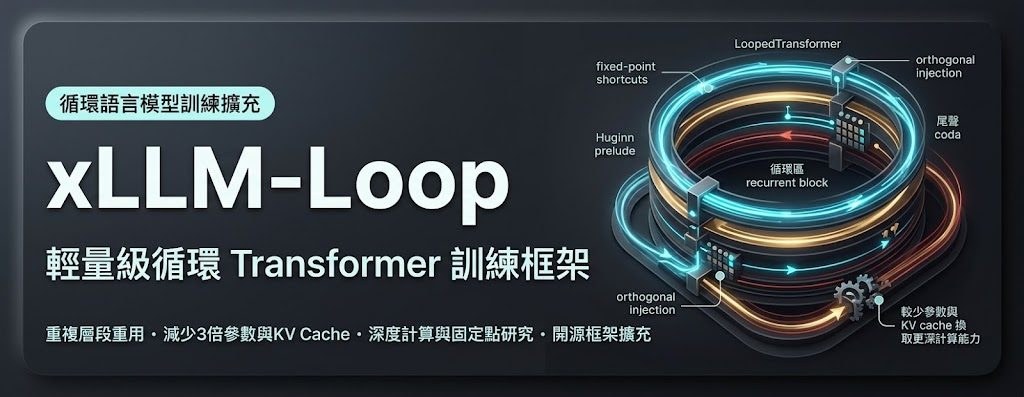
xLLM-Loop 把同一組 Transformer 層重複運算,探索以較少參數和 KV cache 維持語言模型能力。以更少參數換取更大推理深度。

Repository image for ifm-ai/xllm-loop

想用較少模型參數和 KV cache,換取更深的計算能力,xLLM-Loop 提供了一條可直接研究的路線。它屬於開源語言模型訓練框架擴充,處理的是循環語言模型如何重用層、控制深度,以及評估固定點帶來的效率取捨。

LoopedTransformer 會重複執行指定層段,Huginn 則把模型分成 prelude、recurrent block 和 coda,並支援單一或階層式 recurrent state。Part II 進一步研究 fixed-point shortcuts、learned depth prior 和 orthogonal injection,目標是在增加 FLOPs 時維持近乎固定的記憶體需求;相關說法包括較標準 Transformer 少約三倍參數和 KV cache,但不能視為所有任務都能達成的保證。

項目已接入 xLLM,提供兩篇研究工作的 training、evaluation 和 checkpoint 程式碼,並有 49 個 Hugging Face checkpoints。Part I 涵蓋 Dense 和 MoE 共 17 種 recipes、25 個 checkpoints;Part II 涵蓋 depth priors、input-injection variants 和 distilled prefill,共 24 個 checkpoints。

  • 適合研究循環架構、固定點推理和參數效率的模型團隊
  • 可比較固定、抽樣及 learned depth 的訓練方式
  • 支援 LoopedTransformer、Huginn 和 DepthControlledHuginn
  • 需要 PyTorch 2.11、CUDA 12.8、Python 3.12,實驗曾使用 NVIDIA H200

安裝方式沿用 xLLM,但硬件和軟件版本要求偏新,訓練成本亦不低,論文實驗是在 NVIDIA H200 上完成。對想在本地直接使用成熟聊天模型的人,它不是即裝即用的產品;對需要重現研究、載入 checkpoints 或改造訓練流程的團隊,程式碼、評估及 checkpoint 配套就更有價值。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, 框架, Python

Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

Page 4 of 17
1 2 3 4 5 6 … 17