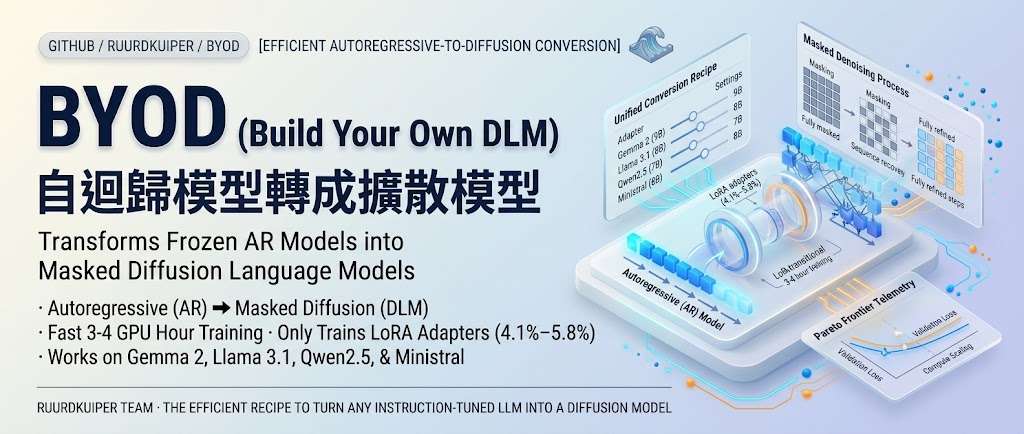
BYOD 把指令模型轉成雙向遮罩擴散語言模型,讓模型生成文字時能逐步去噪,並在互動頁面即時查看生成變化。它是模型訓練工具,主要處理如何用單張 GPU 訓練這類模型;Colab Notebook 可選模型、啟動訓練及查看 loss 曲線,第 6 步會開啟可調整生成設定的推理介面。
使用方式分為 Colab 和本機兩條路徑:Notebook 會沿用 Colab 的 PyTorch、CUDA 套件,只在啟動推理介面時安裝 Gradio;本機訓練則需 NVIDIA GPU、Hugging Face 讀取權杖,並先接受受限模型的使用條款。本機推理網頁需安裝 .[demo] 套件。訓練資料會自動下載,手動中止時會保存 interrupted/,可載入該次結果繼續推理。
BYOD 以 LoRA 微調既有模型,而非從頭訓練;quick 模式採用較小模型和 rank-128 LoRA,適合先檢查流程,但不會重現論文分數。paper 模式使用 rank-1024 LoRA,原始訓練使用 96 GB 記憶體,對硬件要求高。兩種模式預設均訓練 25,000 次更新,訓練與驗證 loss 若出現 NaN 或無限值,程序會報錯並保留先前最佳 adapter。
- Notebook 提供模型選擇、訓練和 loss 曲線檢視。
- 推理介面可調整生成設定,並即時查看去噪過程;也支援載入中斷訓練的結果。
- 可選 Llama、Gemma、Qwen 和 Ministral;各模型提供不同 quick 或 paper 配置,Ministral 只有 paper 配置。
- 評估在每個 checkpoint 執行,輸出只保留
best/;本機訓練要求 NVIDIA GPU,quick 模式不等同論文設定。
研究者和模型工程團隊可用它比較不同指令模型經擴散式訓練後的生成過程,也可先透過託管示範體驗已訓練模型。若目標是復現論文結果,應採 paper 配置並準備高記憶體 GPU;低資源測試則可用 quick 模式確認訓練流程。