BYOD:用單張 GPU 將指令模型改造成雙向擴散模型

BYOD 讓你從 Colab Notebook 選擇指令模型並進行訓練,再透過互動介面觀察逐步去噪生成;但快速模式不會重現論文分數。

Repository image for RuurdKuiper/BYOD

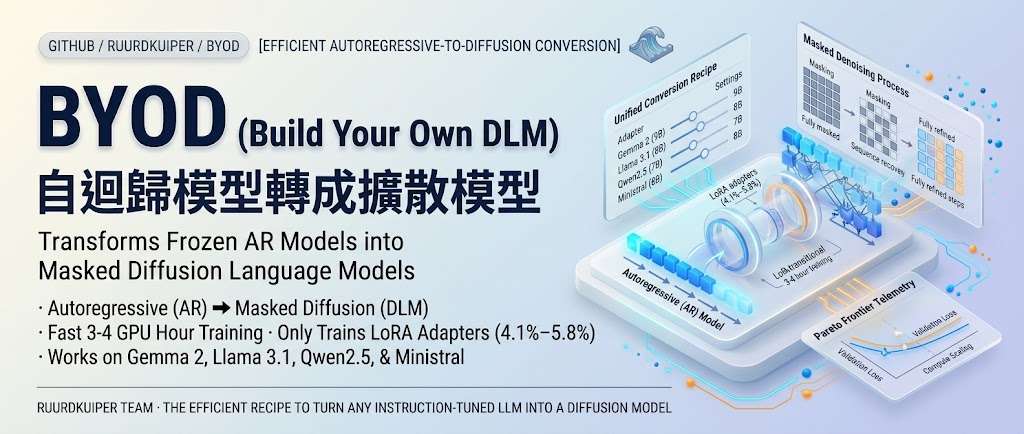
BYOD 把指令模型轉成雙向遮罩擴散語言模型,讓模型生成文字時能逐步去噪,並在互動頁面即時查看生成變化。它是模型訓練工具,主要處理如何用單張 GPU 訓練這類模型;Colab Notebook 可選模型、啟動訓練及查看 loss 曲線,第 6 步會開啟可調整生成設定的推理介面。

使用方式分為 Colab 和本機兩條路徑:Notebook 會沿用 Colab 的 PyTorch、CUDA 套件,只在啟動推理介面時安裝 Gradio;本機訓練則需 NVIDIA GPU、Hugging Face 讀取權杖,並先接受受限模型的使用條款。本機推理網頁需安裝 .[demo] 套件。訓練資料會自動下載,手動中止時會保存 interrupted/,可載入該次結果繼續推理。

BYOD 以 LoRA 微調既有模型,而非從頭訓練;quick 模式採用較小模型和 rank-128 LoRA,適合先檢查流程,但不會重現論文分數。paper 模式使用 rank-1024 LoRA,原始訓練使用 96 GB 記憶體,對硬件要求高。兩種模式預設均訓練 25,000 次更新,訓練與驗證 loss 若出現 NaN 或無限值,程序會報錯並保留先前最佳 adapter。

  • Notebook 提供模型選擇、訓練和 loss 曲線檢視。
  • 推理介面可調整生成設定,並即時查看去噪過程;也支援載入中斷訓練的結果。
  • 可選 Llama、Gemma、Qwen 和 Ministral;各模型提供不同 quick 或 paper 配置,Ministral 只有 paper 配置。
  • 評估在每個 checkpoint 執行,輸出只保留 best/;本機訓練要求 NVIDIA GPU,quick 模式不等同論文設定。

研究者和模型工程團隊可用它比較不同指令模型經擴散式訓練後的生成過程,也可先透過託管示範體驗已訓練模型。若目標是復現論文結果,應採 paper 配置並準備高記憶體 GPU;低資源測試則可用 quick 模式確認訓練流程。
GitHub

Categories: 開源, 模型, 模型訓練, Qwen, NVIDIA, Gemini, 工具, LLaMa, Python, LoRA

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

SparseDecoding 針對 LLM 解碼加速至 1.48 倍

SparseDecoding 針對生成階段重新校準剪枝,兼顧模型準確度與解碼速度。

Og image

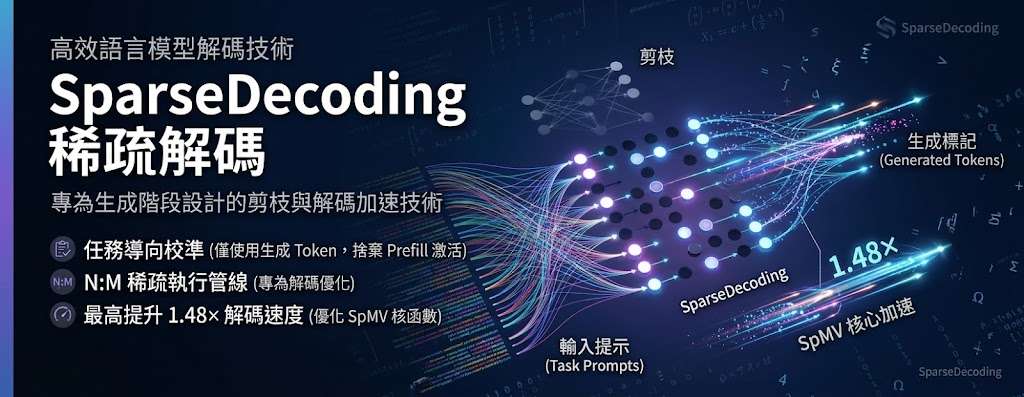
大型語言模型(Large Language Model,LLM)逐個生成 token 時,延遲往往受記憶體讀取限制;SparseDecoding 以解碼階段為核心重新設計剪枝流程,減少需要讀取的非零參數,處理稀疏模型加速與輸出質素之間的取捨。

傳統剪枝方法通常從固定自然語料收集 calibration activations,再計算 Hessian;但模型生成 token 時會依賴自己早前產生的內容,兩者分佈不一致,令剪枝後的表現受影響。SparseDecoding 改為在 dense model 進行 autoregressive generation 時,按層收集模型自行生成的 activation,並略過 prefill 階段,讓校準資料更貼近真正解碼流程。

系統部分則針對解碼主導的 sparse matrix-vector(SpMV)運算,加入支援 N:M sparsity 的 bitmask indexing 與 fixed-step traversal kernel。這和主要優化 prefill 的 sparse matrix-matrix multiplication(SpMM)方案不同,後者在部分 autoregressive decoding 情境下未必能超越 dense throughput。

實驗涵蓋 Llama-3.1-8B、Llama-3.3-70B 及 Qwen3-14B/32B,在 WritingBench 和 ClassEval 等測試中維持具競爭力的結果;A100 上的端到端 decoding speedup 最高達 1.48×,不同稀疏模式則約為 dense 模型的 1.34 至 1.48 倍。

  • 以模型自行生成的 token 作 decoding-aware calibration
  • 略過 prefill activation,聚焦 autoregressive decoding
  • 提供優化 N:M SpMV kernel,支援 bitmask indexing
  • 在 50% 權重保留率及 2:4 sparsity 下測試
  • 目前屬於 preprint,程式碼標示為即將提供

項目主頁

Categories: 模型, 模型訓練, Qwen, 框架, LLaMa

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

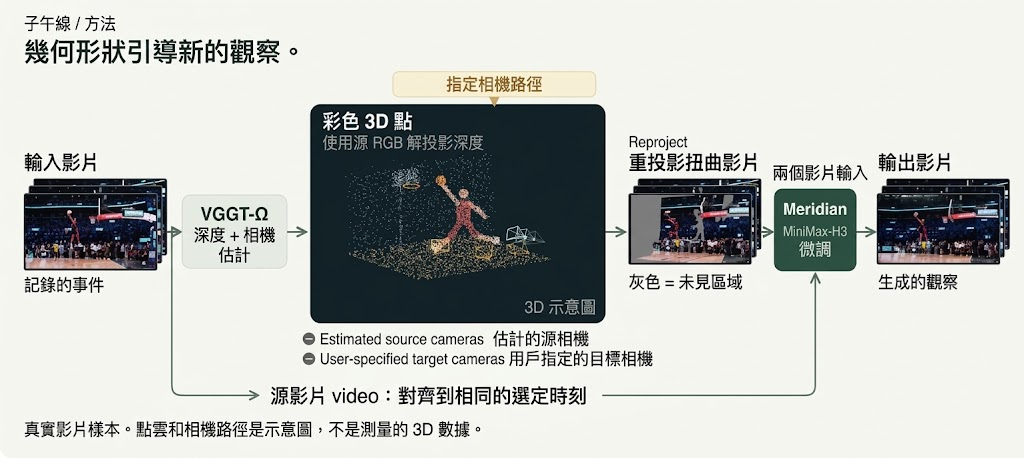
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

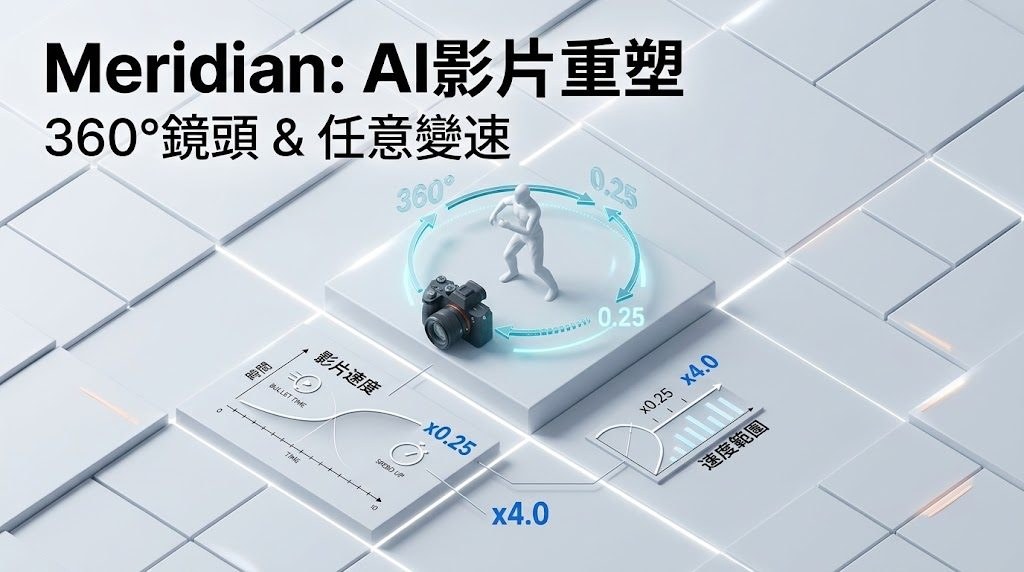
Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

Mind2Dialogue:讓模型學會推斷用戶內心狀態

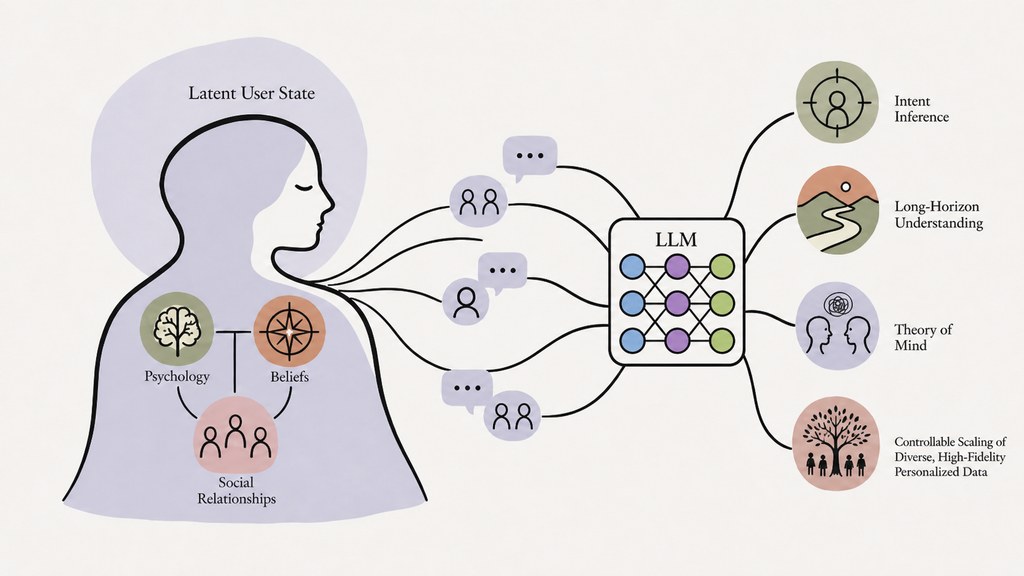
這個項目用一套共享狀態的對話模擬流程,讓模型從純對話歷史推回用戶的信念、目標和情緒,從而提升個人化與心理理論能力。

idea-promotion

現時很多聊天模型在多輪對話中表現不錯,但一到「這個用戶其實想要什麼、心情如何、跟上一句話背後的脈絡」就容易失去線索。Mind2Dialogue 直接在訓練階段把這個缺口補上:模擬器跟一個 Oracle 助理共用同一個會隨對話演化的用戶狀態,Oracle 寫出的回覆就成為學生模型的訓練目標;學生模型在訓練時只看到 persona 與對話紀錄,要自行還原背後狀態。

整個流程由六個階段組成:規模化產生 persona 種子情境、批次生成對話、用 LLM 作評審過濾低質樣本、從對話抽取 QA 對、語料改寫增廣,最後做微調與評估。設計上刻意把模擬者、Oracle、評審分成不同模型端點,避免自我評分,也容許把較強模型放在 Oracle 位置。情境類型涵蓋終生關係、高頻互動、情緒事件與敏感議題,使訓練語料貼近真實長期陪伴的場景。

在 Qwen2.5-7B-Instruct 上,個人化指標 PrefEval-Gen 比基礎模型高 33.4 分,PersonaMem-v2 高 10.0 分,並在同骨架下壓過加記憶模組與其他個人化方法。Qwen 與 Llama-3.1-8B-Instruct 在 BigToM 等 Theory-of-Mind 基準上也同步進步,代表個人化與心智理論可能共享同一種「從觀察推回未觀察狀態」的能力。OLMo-3-8B-Instruct 則未見轉移,顯示效果仍受骨架預訓練影響。

隨訓練資料量由八分之一擴到全量,三個骨架的個人化分數都穩步上升,呼應「資料規模足夠,學生才能學會狀態還原」這個核心假設。對做對話系統、角色 AI、AI 陪伴或客服助手的研究團隊,這套管線可作為不需要逐句人工標註的個人化資料生成起點;對關心評測的研究者,內附 LLM-as-judge 與消融設定(full、no_privilege、no_state、latent 等)便於追溯不同監督訊號的貢獻。

重點摘要:

  • 共享狀態模擬:模擬器與 Oracle 共用演化中的用戶狀態,Oracle 回覆成為學生訓練目標
  • 零人工標註管線:六階段流程從 persona 種子到微調皆可批次執行
  • 個人化與 ToM 同步提升:Qwen 與 Llama 在 PrefEval-Gen、PersonaMem-v2、BigToM 上均有明顯改善
  • OLMo 未見轉移:效果依賴骨架預訓練特性,OLMo-3-8B-Instruct 在 ToM 上反而下跌
  • 資料越多越好:從 1/8 到全量語料,三個骨架的個人化分數持續上升

項目主頁 · GitHub · 數據集

Categories: 開源, Agentic, 模型訓練, Qwen, LLaMa, Dataset 數據集

VibeVoice-ASR-Streaming-7B 即時辨識與轉錄合而為一

Microsoft Research團隊將講者辨識加入串流語音轉錄,讓語音助手更快知道誰在說甚麼。

Hugging Face

Microsoft Research 聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。

模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。

VibeVoice-ASR-Streaming 會交錯處理固定大小的audio chunks,並加入少量lookahead,讓模型在保留未來聲音片段作判斷的同時,逐步產生轉錄結果。固定分塊有助控制處理延遲,但lookahead 與分塊大小之間仍要取捨:前者越多,講者切換及語句判斷可能更穩定,回應時間亦可能增加。

  • 以單一LLM-based端到端模型同步處理ASR與speaker attribution
  • 使用固定大小audio chunks及少量lookahead支援串流輸出
  • 針對即時語音助手及agents的低延遲需求設計
  • 量化檔案、推論框架、硬體需求及效能指標尚未在提供內容中交代

項目主頁 · Paper · 模型

Categories: Agentic, 微軟, Audio, Discord, LLaMa, Ollama, 語音, Dataset 數據集

[技術文章]LLM 媲美 Embedding,成本卻高逾 1431 倍

LLM已能追上頂尖Embedding模型,但搜尋系統未必值得因此承受高昂成本。

Hugging Face

做語意搜尋、分類或文件聚類時,LLM已能在多項測試追上專門的文字嵌入模型;但每次評測成本最高相差1,431倍,令「是否應取代Embedding pipeline」成為成本與能力之間的取捨。本頁屬研究論文內容,並非可直接下載的單一模型頁面;未有提供可確認的 base model 或 fine-tuned from 資訊,因此無法判定某個模型的原始基礎模型。

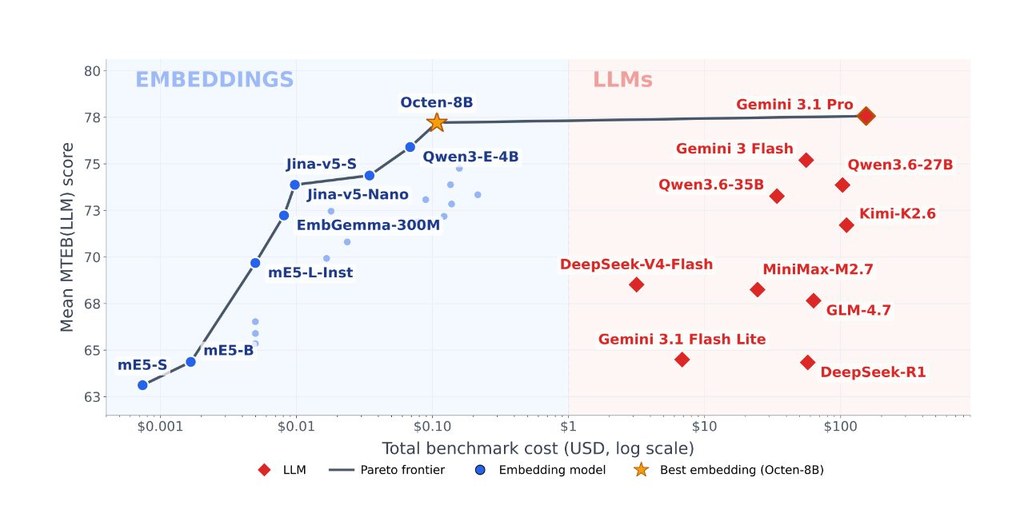
研究比較10個、來自6個家族的 large language models (LLMs),以及26個參數量由118M至14B的 embedding models,測試涵蓋37項 MTEB(LLM) 任務,包括分類、semantic textual similarity (STS)、聚類、pair classification 和 retrieval。最佳 LLM Gemini 3.1 Pro 得分77.6,最佳 embedding model 得分77.2,差距只有0.4分。

  • Embedding models 在分類、相似度和聚類表現較合適
  • LLM 在需要推理的 retrieval 任務較有優勢
  • LLM 每次 benchmark pass 成本約154美元,embedding model 約0.11美元
  • 開源 LLM 在同一 GPU 上慢約2.5至736倍
  • reasoning tokens 佔 LLM inference 成本28%至81%

研究亦指出,降低 reasoning budget 對多數模型的 retrieval 品質沒有明顯傷害,反映混合式流程更合理:以 embedding model 負責大部分相似度搜尋,再把需要理解語境或多步推理的查詢交給 LLM。

Paper

Categories: Embedding, Qwen, Gemini, LLaMa, Ollama, Dataset 數據集, Kimi

Qwen3.8-2.4T-A95B 超大型開放權重文字推理模型

Qwen3.8 把 Qwen-Max 級別能力帶到開放模型,強項不只是答題,而係更穩定完成多步驟工作。

Og image

Qwen3.8-2.4T-A95B 把 Qwen-Max 級別的能力開放出來,而且明確建基於 Qwen3.5 的架構底層,BF16 safetensors 格式及1M上下文。定位上屬於 Causal Language Model,面向文字生成、編程、研究工作與長流程 Agentic 任務;相比只追求單輪回答,它更著重規劃、接收環境回饋,以及把多步驟工作做完。

Qwen3.8-2.4T-A95B 的核心規格相當進取:總參數 2.4T(2.4 trillion)參數,但每次啟動 95B,屬於典型大型 Mixture of Experts(MoE)路線,用較高總容量換取較可控的推理成本。模型經過 Pre-training 與 Post-training,並採用 Qwen3.5 架構延伸而來的層設計,包括 Gated DeltaNet、Gated Attention 與 MoE 組合,重點不是單純堆大,而是提升長鏈推理與任務完成的穩定性。

Qwen3.8-2.4T-A95B 主要來自兩個控制點:reasoning_effort 可調整推理深度,preserve_thinking 可保留歷史訊息中的 reasoning context。這代表它比較適合需要反覆修正、逐步執行的工作流,而唔係只看一次輸出的場景。頁面亦提到它對常見 harness 與開發工具有更廣泛支援,模型檔案可配合 Transformers、vLLM、SGLang、TokenSpeed 等推論堆疊。

  • 基礎模型可確認是建基於 Qwen3.5 architectural foundation。
  • 已知開放的是 Hugging Face Transformers 格式的 post-trained 權重。
  • 官方另有 Qwen3.8-Max 版本,功能更多,包含 vision input、non-thinking support、內建工具,以及預設 1M context length;但這些能力屬於官方服務版本,不應直接視為此頁權重全部具備。
  • 從已公開資訊看,它的優勢在於長流程 Agent 執行與專業工作可靠度提升;限制是硬體需求、完整上下文長度與量化部署細節未在此頁交代,離本地輕量部署仍有距離。

跟一般只強調 benchmark 分數的模型相比,它更強調任務完成率、規劃能力與工具鏈兼容性。由於缺少量化版本、推理記憶體需求與更完整評測數字,現階段較適合把它理解成面向高階推論服務與大型基建環境的開放權重,而不是即插即用的本地模型項目。

模型

Categories: 開源, Agentic, 模型訓練, Qwen, API, LLaMa, Ollama, 編程, Dataset 數據集

Page 1 of 3
1 2 3