ConvFill:即時語音代理的雙模型方案

ConvFill 用本地小模型先開口,再由雲端大模型補上答案。它想解決語音代理常見的「快但唔夠準,準但唔夠快」拉扯。

Teaser

ConvFill 是一個用來建立語音代理的開源系統與研究原型。能夠實現即時回應和準確回答——這兩個目標通常難以兼顧。它將本地運行的小型快速語言模型與在後台進行繁重推理的大型雲端模型相結合,使代理能夠立即開始對話,並在資訊可用時自動填充合理的答案。此程式碼庫包含完整的系統、一個即時語音演示、七個即用型模型以及訓練您自己的模型所需的一切資源。

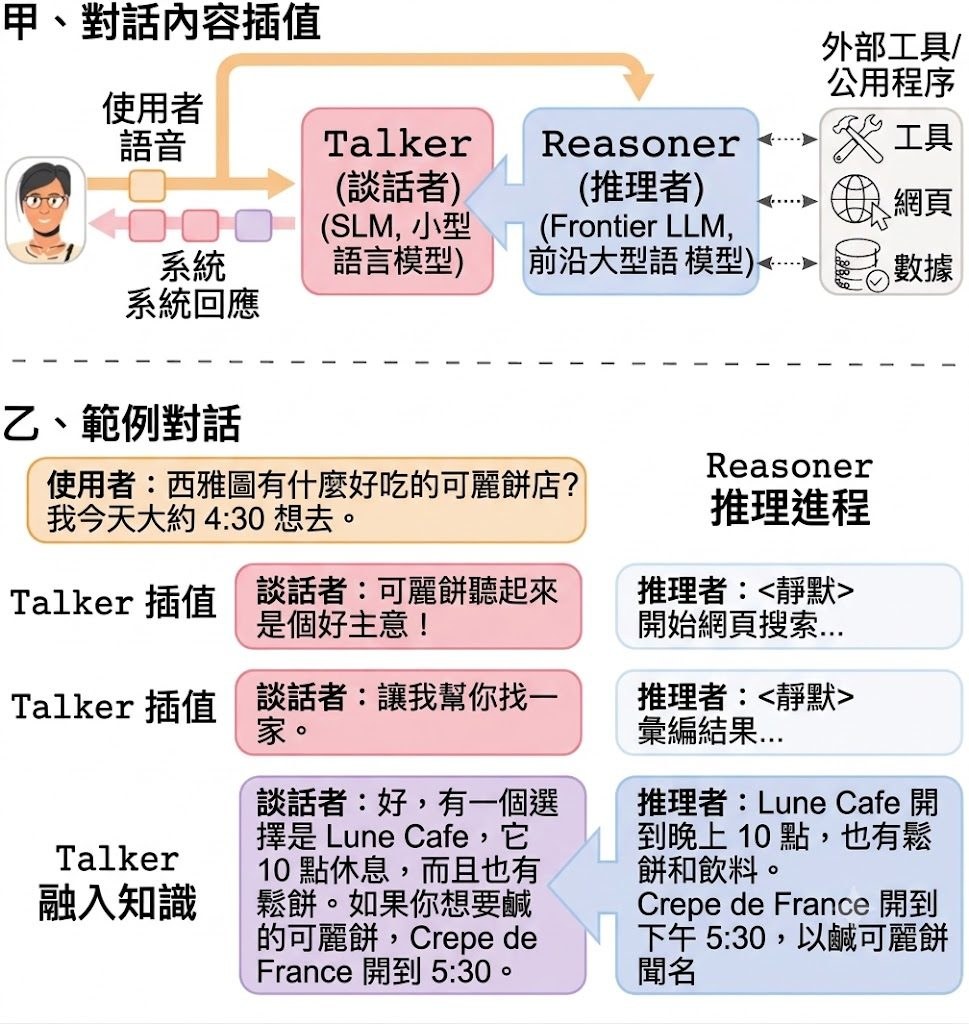
現有做法通常要麼直接等大型模型完整生成,回應較慢;要麼改用較小模型追求低延遲,但複雜查詢、文件搜尋同工具調用能力會明顯下降。ConvFill 提出 conversational infill 這個新任務,將 Talker 與 Reasoner 分工:Talker 先即時說話,Reasoner 在背景處理慢工序,再把精簡知識流式交回 Talker 融入回答。

ConvFill 不是單純做語音介面,而是重新安排推理時序。Talker 可用 135M 到 1.7B 參數的小模型,在手提電腦或手機本地運行;Reasoner 則可接 Claude、GPT 或 Gemini。儲存庫已提供 live voice demo、七個現成模型,以及訓練自家 Talker 所需內容,理解上可視為「本地即時對話層 + 雲端能力層」的組合。

  • 內置七個已微調 Talker,涵蓋 Qwen、Llama、Gemma、SmolLM 家族
  • 配套 ConvFill dataset,含 290,571 個經驗證訓練樣本,覆蓋六個領域
  • Reasoner 可替換為 Claude、OpenAI 或 Gemini,毋須為更換 Reasoner 重新訓練
  • 論文指出系統可維持 millisecond-level time-to-first-response,準確度與對應 frontier Reasoner 的差距縮至 6.3% 內

受益最明顯的,會是想做客服、助理、查詢式語音介面或需要邊說邊找資料的團隊。它未必適合完全離線、又要求深度推理的場景,因為關鍵能力仍依賴雲端 Reasoner;但對希望保留本地回應速度,同時接入大模型能力的項目,這套設計比單模型方案更有工程上的彈性。
GitHub · Paper

Categories: 開源, 模型, Qwen, OpenAI, Gemini, LLaMa, 語音, Anthropic, 蘋果, Dataset 數據集

LLM 組合唔一定勝過最佳單模

呢個 Hugging Face Space重點唔係新模型,而係用統計上限分析多模型編排何時無明顯收益。

Og image

這是一個 Hugging Face Space,用來展示多個大型語言模型組合策略的分析結果,而不是可下載微調模型;頁面亦無提供 base model,因為它本身並非基於某個基礎模型微調而成。它主要回答一個很實際的問題:把多個 LLM 放入 routing、voting、cascade 或 mixture-of-agents(MoA)之後,是否真能穩定超越單一最佳模型。

核心結論圍繞 β = P(all wrong),即所有模型在同一題一起答錯的機率。文中指出,凡是輸出仍然只能選自成員模型答案的策略,理論上準確率上限就是 1 − β;常見的 pairwise error correlation ρ 即使相同,亦未必能反映 β,所以只看模型之間「錯得是否相似」並不足以估算可提升空間。

這個項目的價值,在於它把模型編排問題由「多加幾個模型會否更準」轉成「這些模型是否在不同題目上出錯」。作者用 67 個 frontier models、21 個供應商資料說明:就算是多樣化模型池,all-wrong tail 仍比單靠相關性模型估算更高;在 open-ended mathematics、execution-graded code 這類可檢查任務,多模型通常難以大幅勝過最強單模,除非有很強的 query-level routing signal。

  • 這不是生成模型權重頁,沒有參數規模、context length、GGUF、mmproj 或量化檔案清單
  • 不涉及 llama.cpp、Ollama、LM Studio 部署,亦無 Q4_K_M 一類量化建議
  • 方法重點是用 Clopper–Pearson bound 先估計 β 上限,再判斷是否值得訓練 router
  • 與 Self-MoA 類做法相比,低 ρ 且真正「錯題互補」的模型組合更有機會帶來收益

對技術決策者而言,這個 Space 更像一個模型編排可行性檢查工具。它提醒人不要把 orchestration 當成免費性能加成:當共同失敗率高,多模型系統增加的可能只是成本、延遲與系統複雜度,而非可觀準確率提升。

項目主頁 · Paper

Categories: Agentic, Qwen, OpenAI, DeepSeek, Gemini, 工具, LLaMa, Ollama, Anthropic

DREAM:用語言模型反向教檢索

DREAM 不是一般對比式檢索訓練,而是借用自回歸語言模型的預測誤差來教 retriever。它瞄準標註成本高、負樣本難挖的老問題。

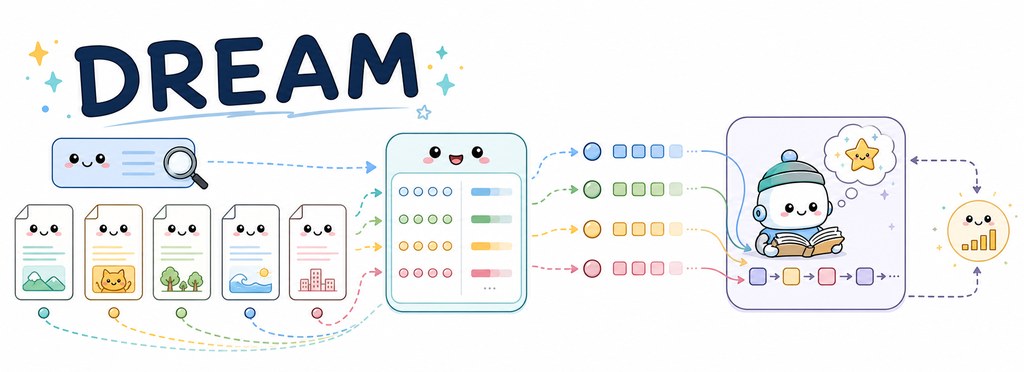
DREAM banner

DREAM 是一個稠密檢索嵌入訓練方法/研究原型,核心是把 autoregressive language model 的預測訊號拿來訓練 dense retriever。它要解決的問題很明確:傳統 dense retrieval 多數依賴 contrastive objectives,需要正負文件配對與標註,但這類資料昂貴,hard negatives 也不穩定。

現有做法通常是替 query 配 positive documents 與 sampled negatives,再拉近或拉遠 embedding 距離;作者認為這種範式過度依賴人工或額外挖掘流程,未必真正反映哪些文件能幫助模型完成生成。DREAM 的做法是把 query-document 相似度送入指定的 Query-Focused Retrieval Heads(QRHeads),讓 frozen LLM 在預測 target 時,直接用 next-token prediction loss 回傳訊號,告訴 retriever 哪些文件真的有用。

這個取向最值得留意的地方,在於它不是單純改 loss,而是把檢索分數接進 attention heads,令生成模型的預測難度成為監督來源。代價也很明顯:流程比一般 embedding fine-tuning 更複雜,要先做 QRHead detection,再跑 DREAM adapter 訓練;儲存庫亦未附完整 training data、checkpoints 與 evaluation outputs,較接近研究復現路線,而不是即裝即用工具。

安裝與理解方式算清晰,儲存庫分成 qrhead_repo/dream_routing/data/sample/ 三部分:前者負責找出 QRHeads,後者負責訓練 adapter,樣本資料則用 JSONL 提供 querydocstarget 結構。部署重點不是直接上線服務,而是先準備自己的 Hugging Face dataset 或本地 JSONL,依序完成 head 檢測與訓練;推論部分則主要依賴 Hugging Face 上已釋出的 adapters。

  • 已提供預訓練模型:DREAM-0.5BDREAM-1BDREAM-3B
  • 對應底座模型:Qwen2.5-0.5BLlama-3.2-1BLlama-3.2-3B
  • 評測指向 BEIRRTEB,論文稱在不同模型尺寸上都優於既有 baselines
  • 適合研究檢索訓練、RAG、embedding 設計與 LLM-retriever 協同優化的團隊

受益最大的一類人,不是只想下載 embedding 即用的使用者,而是要研究 retriever 如何配合生成模型工作的團隊。對做 RAG、知識檢索、代理式搜尋的人來說,DREAM 提供了一條不同於 contrastive training 的路;對資源有限的小團隊而言,訓練鏈較長、重現門檻較高,較適合作為方法參考或實驗基線,而非現成產品元件。

GitHub: https://github.com/yixuantt/DREAM

Model: https://huggingface.co/collections/yixuantt/dream

Categories: 開源, 香港科技大學, RAG, Embedding, 模型, 模型訓練, Qwen, 香港, 工具, LLaMa, Python, , Meta, Dataset 數據集

Llama 4 模型系列

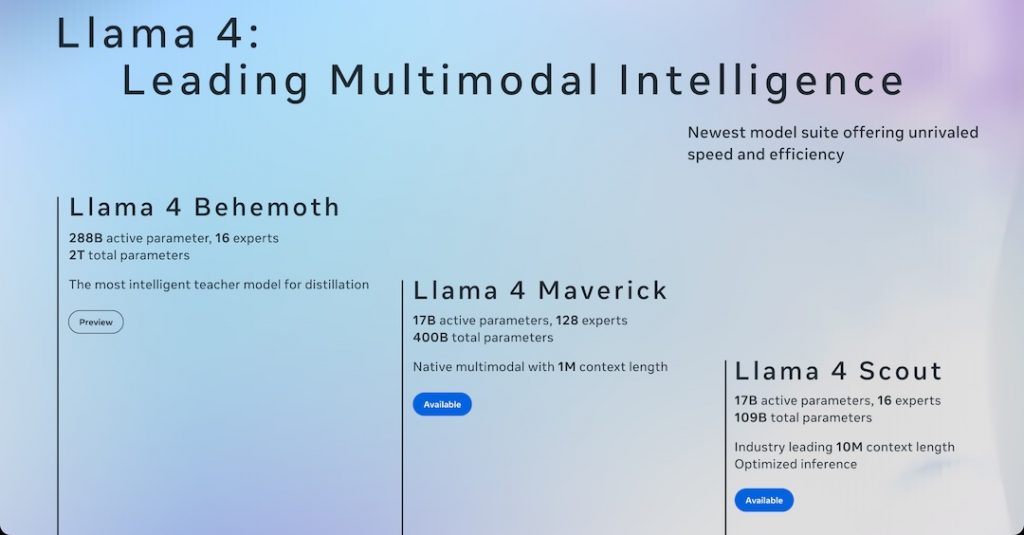
Llama 4 Scout 是一個擁有 170 億個活躍參數和 16 個 MOE 的混合專家模型。它被認為是目前同類型最優秀的多模態模型,比前幾代的 Llama 模型更強大。新模型可以用單張 NVIDIA H100 GPU 運作。佢擁有業介領先的 1000 萬 tokens 上下文窗口,並且在廣泛使用的基準測試表現都優勝過 Gemma 3、Gemini 2.0 Flash-Lite 和 Mistral 3.1。它在預訓練和後訓練的過程都用了 256K 的上下文長度。 另一個模型 Maverick 同樣是一個擁有 170 億個活躍參數的模型,但它擁有 128 個 MOE 的混合專家模型。基準測試擊敗了 GPT-4o 和 Gemini 2.0 Flash,而在圖像方面亦表現相當出色,能夠將提示詞同埋相關的視覺概念對齊,將模型的回應鎖定到圖像中的特定區域。兩個模型都有獨特的活躍參數模式,能夠節省一半資源。令開發同應用的價格更低。

Llama 4 Scout 是一個擁有 170 億個活躍參數和 16 個 MOE 的混合專家模型。它被認為是目前同類型最優秀的多模態模型,比前幾代的 Llama 模型更強大。新模型可以用單張 NVIDIA H100 GPU 運作。佢擁有業介領先的 1000 萬 tokens 上下文窗口,並且在廣泛使用的基準測試表現都優勝過 Gemma 3、Gemini 2.0 Flash-Lite 和 Mistral 3.1。它在預訓練和後訓練的過程都用了 256K 的上下文長度。

另一個模型 Maverick 同樣是一個擁有 170 億個活躍參數的模型,但它擁有 128 個 MOE 的混合專家模型。基準測試擊敗了 GPT-4o 和 Gemini 2.0 Flash,而在圖像方面亦表現相當出色,能夠將提示詞同埋相關的視覺概念對齊,將模型的回應鎖定到圖像中的特定區域。兩個模型都有獨特的活躍參數模式,能夠節省一半資源。令開發同應用的價格更低。

Llama-4 First Look & Hands On Testing (Code, Vision, Dialogue)
Categories: 開源, 模型, LLaMa

bolt.diy 生成式網頁設計

bolt.diy 允許使用者使用任何大型語言模型 (LLM) 來建立、執行、編輯和部署全端網頁應用程式。它支援多種 LLM,例如 OpenAI、Anthropic 和 HuggingFace 等,並具備可擴展架構以支援更多模型。這裡包含專案的安裝說明、使用方法、支援的 LLM 列表、以及社群參與和未來發展規劃等資訊,目標是提供一個方便易用且高度彈性的 AI 程式碼輔助工具。

bolt.diy 允許使用者使用任何大型語言模型 (LLM) 來建立、執行、編輯和部署全端網頁應用程式。它支援多種 LLM,例如 OpenAI、Anthropic 和 HuggingFace 等,並具備可擴展架構以支援更多模型。這裡包含專案的安裝說明、使用方法、支援的 LLM 列表、以及社群參與和未來發展規劃等資訊,目標是提供一個方便易用且高度彈性的 AI 程式碼輔助工具。

🎯 Let’s Hack Bolts! | Optimize Bolt.diy Using Prompt Engineering 🚀

MAC ImageWIN Image

Categories: Gemini, 教學, LLaMa, Ollama

Ollama3.2-vision 本地部處教學

影片示範使用 OLAMA 平台,離線運行 Llama 3.2 vision 模型。重點在於說明如何使用終端機或 Open Web UI 與圖片互動,以及運用 Python 和 JavaScript SDK 建立應用程式。影片涵蓋基本設定到進階應用程式開發,並提供詳細程式碼範例,協助 Llama 3.2 vision 模型進行圖像識別和描述等任務,展現消費級硬體上的強大能力。

影片示範使用 OLAMA 平台,離線運行 Llama 3.2 vision 模型。重點在於說明如何使用終端機或 Open Web UI 與圖片互動,以及運用 Python 和 JavaScript SDK 建立應用程式。影片涵蓋基本設定到進階應用程式開發,並提供詳細程式碼範例,協助 Llama 3.2 vision 模型進行圖像識別和描述等任務,展現消費級硬體上的強大能力。

Llama 3.2 Vision + Ollama: Chat with Images LOCALLY

MAC ImageWIN Image

Categories: 多模態模型, LLaMa, Ollama


llama3 中文指令微調模型 Unichat-llama3-Chinese-8B · Hugging Face

中國聯通AI創新中心發佈業界第一個llama3中文指令微調模型(全參數微調),2024年4月19日22點上傳 本模型以Meta Llama 3為基礎,增加中文數據進行訓練,實現llama3模型高質量中文問答 模型上下文保持原生長度8K,支持長度64K版本將於後續發佈 基礎模型 Meta-Llama-3-8B

中國聯通AI創新中心發佈業界第一個llama3中文指令微調模型(全參數微調),2024年4月19日22點上傳

本模型以Meta Llama 3為基礎,增加中文數據進行訓練,實現llama3模型高質量中文問答

模型上下文保持原生長度8K,支持長度64K版本將於後續發佈

基礎模型 Meta-Llama-3-8B

Categories: LLaMa, 新聞

MobiLlama:0.5B 能在手機上運行的小型語言模型

模型基於LLaMA-7B架構設計 旨在能夠在邊緣設備上高效運行,無需將數據發送到遠程服務器或雲端處理。如智能手機、平板電腦、智能手錶等。

Categories: 軟件, LLaMa, 新聞

Page 2 of 3
1 2 3