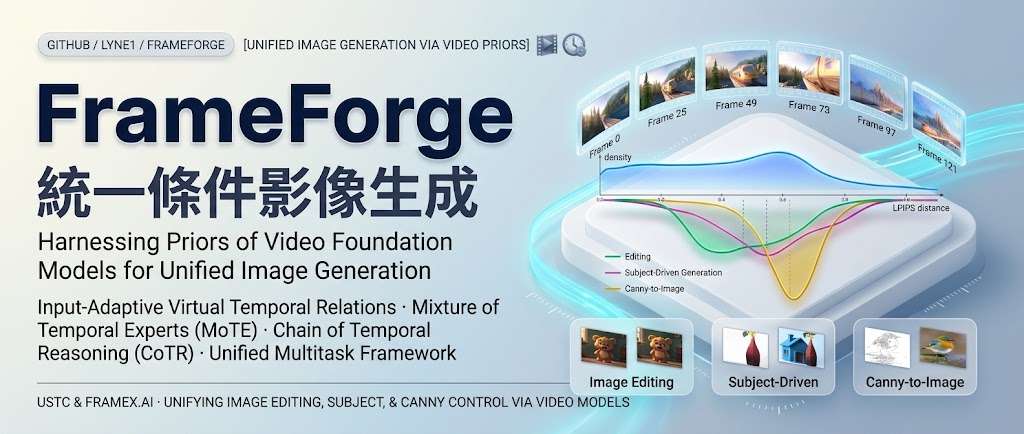
FrameForge「換場景、不換主角」統一三種影像生成

FrameForge 把 HunyuanVideo 1.5 的影片時間帶入影像生成,讓同一套模型處理主體生成、邊緣圖生圖和指令式編輯。

Repository image for Lyne1/FrameForge

同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。

FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。

它用同一個模型處理三種工作:

功能 你提供什麼 可以做什麼
參考主體生成 一張人物、動物或物件的參考圖,加上文字描述 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上
邊緣圖轉圖片 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 依照既有輪廓、姿勢與構圖生成完整圖片
文字指令修圖 原始圖片,加上修改指令 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容

這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。

技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。

官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。

注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。
項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Stable Diffusion, Video, Image, 影像模型, Linux, Python, 庫, 中國, LoRA

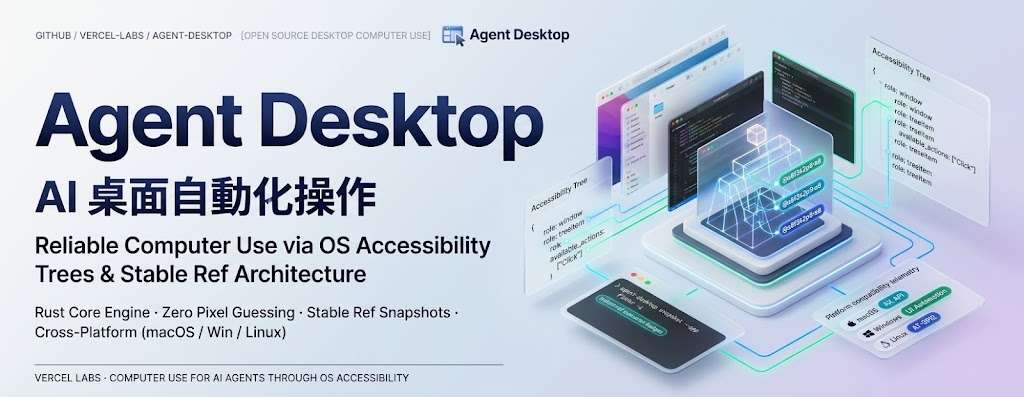
agent-desktop:讓 AI 代理讀取並操作桌面應用程式

以 OS accessibility tree 取代像素定位,讓 AI 代理操作桌面應用程式並逐步核對結果。

Repository image for vercel-labs/agent-desktop

要讓 AI 代理操作桌面應用程式,agent-desktop 讀取 OS accessibility tree,以 ref 指向按鈕、輸入框等元素,再用 JSON snapshot 核對結果。這個跨 macOS、Windows、Linux 的 CLI 與 C library 不靠 pixel matching,將控制循環留在 agent。

可透過 npm 安裝並先確認 version;macOS 要 Accessibility permission,Linux 要 graphical session 及 at-spi2-core,Windows 受終端機 integrity level 限制。macOS command host 保留 native accessibility objects,減低舊 identifier 誤連到已移除元素的風險。

  • 適合:需要 AI 控制桌面軟件、並自行編排 agent 的團隊。
  • 限制:沒有 benchmark 或成功率;JEV helper 與 native CLI 分開,headless calls 亦禁止 foreground activation 和 synthesized input。
  • 私隱:snapshot、screenshots、剪貼簿及 debug artifacts 可能含私人內容,不應放入公開 logs。

項目更像桌面操作底層而非完整代理,是否適合取決於目標程式的 accessibility 支援、權限和資料處理方式。

GitHub

Categories: 開源, Agentic, 軟件, Mac, Linux, 庫, Dataset 數據集

CVE-2026-98432:修補 Linux TCP 遠端攻擊風險

Linux 核心 TCP 子系統被揭發高風險漏洞,遠端攻擊者或可在無需登入下取得系統控制權,維運團隊需同步檢查修補與網絡防護。

Linux 伺服器面對的風險不只在應用程式,核心處理 TCP 連線建立的程式碼同樣可能成為遠端入侵入口。CVE-2026-98432 被描述為競態條件(Race Condition)及記憶體釋放後重用(Use-After-Free, UAF)漏洞,國家漏洞資料庫(NVD)評分達 9.8,攻擊不需要帳戶或使用者互動。

漏洞涉及 Linux 核心 IPv4 TCP 連線處理流程,問題集中於 tcp_v4_syn_recv_sock() 處理連線選項轉移時,inet_opt 與 ireq_opt 的釋放及複製未有受到適當保護。來源指稱,攻擊者或會利用核心位址外洩繞過 KASLR,再嘗試改寫回呼指標以達成遠端代碼執行(RCE)。

受影響範圍據稱涵蓋 Linux 4.4 以來的大部分主流核心架構,Ubuntu、RHEL、OpenShift、Amazon Linux 2023、Debian、SUSE 及 Oracle Linux 等環境需要按自身核心版本核對公告。不同發行版的修補進度並不一致,不能只按作業系統名稱判斷是否安全。

• 核心問題:TCP 連線選項處理中的競態條件與 UAF
• 風險特性:可由網絡遠端觸發,且不需驗證
• 維運重點:盤點核心版本,優先套用官方安全更新
• 緩解方向:檢查防火牆及更新 Suricata 等入侵防禦規則
• 來源提及:MikroTik 可透過 RAW 規則暫時封鎖異常 IPv4 TCP 選項封包

在官方修補完成前,邊界防火牆和入侵防禦系統只能作為降低暴露面的臨時措施,並不能取代核心更新。文章未提供各發行版完整修補版本清單,管理員仍應以供應商安全公告及自身測試結果作最後判斷。

項目主頁

Categories: Linux, 安全

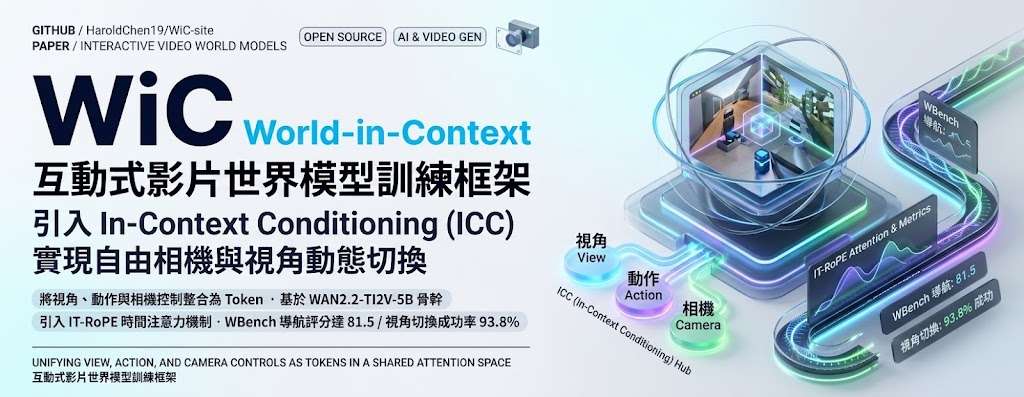
World-in-Context 讓世界模型即時切換視角

操控生成影片時,切換第一人稱、第三人稱與自由鏡頭,畫面仍要延續同一個世界。World-in-Context 以共享控制機制處理這項挑戰。

Alibaba Token Hub

想在生成影片中移動鏡頭、改變觀看角度,甚至在第一人稱與第三人稱之間切換,畫面仍須保持連貫。World-in-Context(WiC)是為互動影片世界模型而設的訓練框架,目標是讓視角、動作和鏡頭控制在同一段影片中協同運作,而不是各自處理。

WiC 以 Wan2.2-TI2V-5B 作為基礎模型,透過 In-Context Conditioning(ICC)把視角、動作與鏡頭控制轉成共享注意力空間中的 tokens;Interaction-Transport RoPE(IT-RoPE)則把累積的控制變化納入時間注意力。這讓系統可支援自由鏡頭、第一人稱及第三人稱視角,也能在影片進行中切換,適合研究互動式場景生成、遊戲環境及長時間因果推演。

在 WBench 評測中,WiC 的導航平均分為 81.5,視角切換成功率為 93.8%。這些結果反映它能處理導航與鏡頭切換,但不能單憑分數判斷生成影片在所有場景都同樣穩定;GPU 記憶體需求亦會隨影片尺寸和設定改變。

目前程式碼、訓練程式及 WiC 權重仍在審核,尚未公開,因此現階段無法自行安裝並重現推理結果。計劃中的版本要求 Linux、Python 3.10,以及支援 BF16 的 NVIDIA GPU;預設生成設定為 832×480、81 幀、16 FPS 和 50 個採樣步驟,並預計提供 11 個包含起始圖片、提示詞與控制資料的範例。

  • 以 Wan2.2-TI2V-5B 為基礎,加入 WiC adapter。
  • 同一影片支援自由鏡頭、第一人稱與第三人稱視角。
  • WBench 導航平均分 81.5,視角切換成功率 93.8%。
  • 程式碼與權重尚未公開,現時未能重現結果。

對研究影片生成、虛擬環境導航或互動遊戲場景的團隊而言,WiC 提供一條把鏡頭與動作控制合併訓練的路線;但在公開程式碼和權重推出前,這些能力仍主要停留在研究成果與展示範例,還不能直接納入工作流程測試。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 提示詞, 框架, 3D, Linux, Python

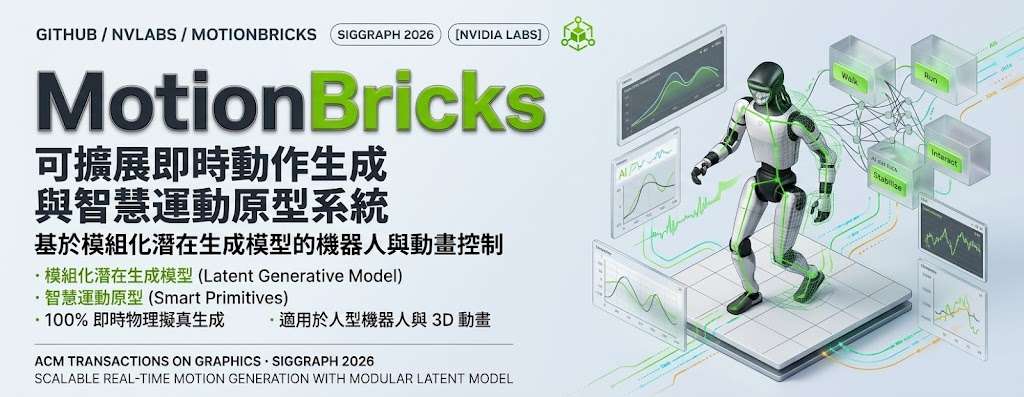
MotionBricks 讓動畫或機械人即時串接自然動作

只需提供角色最近的姿勢和目標姿勢,MotionBricks 就能生成中間動作,並把行走、跨越或坐下等行為組合成連貫場景。

MotionBricks animates characters and robots with one model

機械人或遊戲角色要由一個姿勢自然移動到另一個姿勢,MotionBricks 可以即時補出中間動作。這個模組化潛在生成模型(modular latent generative model)支援角色與機械人動畫,透過最近四個姿勢作為上下文,再以一至四個目標姿勢控制終點及抵達時的動作方式。

它提供 SOMA 人體模型和 Unitree G1 機械人的預訓練模型,並附有 Python 執行環境、動作示範及場景編輯器。使用者可在 Inbetweener 放置姿勢來生成動作,也可用 Scene Preview 測試角色在場景中行走、奔跑、跨越、躲避和坐下;編輯器則可製作 Smart Primitives,將導航與物件互動動作組合起來,無須為新行為重新訓練模型。

MotionBricks 的做法,是讓三個學習模組分工生成動作,再以 Smart Primitives 提供可組合的行為積木。研究團隊表示,模型涵蓋超過 35 萬段動作,並可用於新任務而無須微調或逐項標記;這有助遊戲動畫、機械人模擬及互動場景製作,但實際效果仍取決於目標姿勢和場景設定。

項目網站報告最高每秒 15,000 FPS、延遲 2 毫秒。執行環境依賴 NVIDIA GPU 和 TensorRT,示範曾在 Windows 及 Linux x86-64、配備 GeForce RTX 4090 的系統測試;首次載入模型與精度設定時,還要建立 TensorRT 執行計劃,因此這些數字不宜直接視為所有硬件上的保證。

  • 支援 SOMA 人體模型及 Unitree G1 預訓練模型,模型以 ONNX 提供,檢查點則放在 Hugging Face。
  • Python 執行環境以 Warp、Newton 和 TensorRT 串接多次生成,形成連續動作。
  • 附有 Inbetweener、Scene Preview,以及 Smart Primitives 和場景編輯器。
  • 儲存庫提供導覽教學;但執行需要 NVIDIA GPU,設定亦涉及 Git LFS、uv 和首次建立 TensorRT 計劃。

對需要快速製作可控角色動畫、驗證機械人動作或搭建互動場景的團隊,MotionBricks 提供由姿勢控制到行為組合的一套研究原型。它減少了手工編排動作轉場及為每個任務重新訓練的需要,但硬件門檻和場景設定工作仍需納入製作流程。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, NVIDIA, 教學, Linux, Python, 庫, 動畫, Dataset 數據集

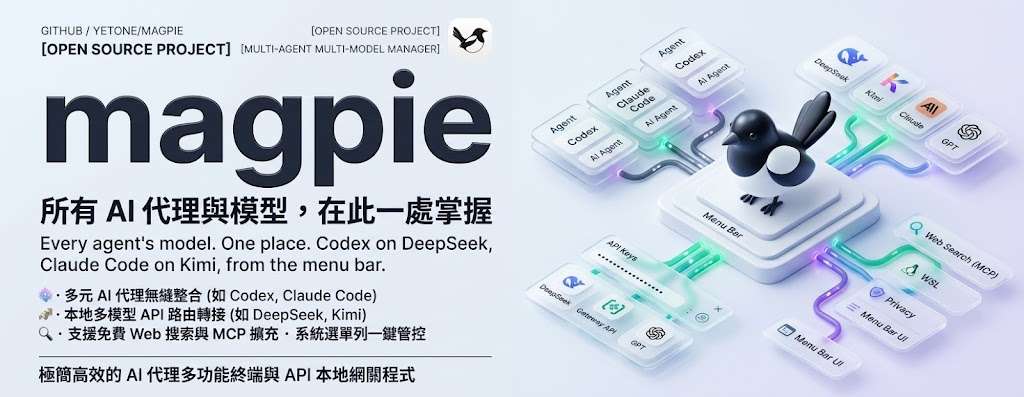
magpie:通過本機閘道,把不同 AI 編程代接上同一模型

Claude Code、Codex、Gemini CLI 等代理可以各自改用其他模型或訂閱帳戶;配額用完時,Magpie 亦可按設定切換帳戶或路由到其他服務。

magpie

想讓 Claude Code 用 Kimi、Codex 用 DeepSeek,或者讓 OpenCode 使用 ChatGPT 訂閱模型,不必逐個代理手動改一堆設定。Magpie 是一款跨平台工具,透過本機閘道統一管理模型與供應商,並從選單列切換代理設定;它改動的是各代理自己的關鍵設定,並非把不同代理合併成同一個程式。

它支援 API key、本機模型,以及 Claude、ChatGPT、Copilot、Gemini、Grok 等已登入帳戶。Claude 整合會呼叫本機的 Claude CLI,並透過 MCP(Model Context Protocol)橋接代理工具;ChatGPT 訂閱模型則可供其他代理使用。這讓使用者能沿用熟悉的代理工作流程,同時更換背後的模型來源。

配額耗盡時,Magpie 可改用同一供應商的另一個帳戶;若設定了路由群組,也可轉往其他模型或供應商。沒有備用帳戶或路由群組時,錯誤仍會傳回代理,因此不中斷並非無條件保證。隱私遮罩則須在設定中手動開啟,啟用後會在請求離開本機前遮蔽提示中的金鑰、密碼和電郵地址,再把內容還原到回覆。

  • 從同一份清單為不同代理選擇模型,減少逐個修改設定的工作。
  • 可混用雲端 API、本機模型和已登入的訂閱帳戶。
  • 帳戶或路由備援可降低配額用盡造成的中斷,但須先配置可用的後備路徑。
  • 隱私遮罩預設關閉,敏感資料保護需自行啟用。

對同時使用多個 AI 編程代理、需要管理不同供應商帳戶的個人或團隊,Magpie 可集中處理切換與備援;若只用單一帳戶,或不希望工具改寫代理設定,收益會較有限。項目支援 macOS、Windows、Linux、Docker 和 Termux;提供下載與文件,但所給資料未列出效能測試或延遲數據,選用前宜確認所需代理、模型與登入方式均在支援範圍內。

GitHub

Categories: 開源, MCP, 模型, 微軟, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Linux, 編程, Anthropic, Kimi, MiniMax

gpu-unlock-ada:RTX 4090 張量運算吞吐翻倍

Linux 核心模組可在 NVIDIA 驅動程式載入前啟用 Ada GPU 的 SM speed-select override,讓 RTX 4090 的 FP16、BF16 張量指令吞吐接近翻倍。實際 GEMM 增幅較小,量化推理甚至沒有受益。

Repository image for JustAResearcher/gpu-unlock-ada

想提升 RTX 4090 的 FP16、BF16 張量運算能力,這個 Linux 核心模組會在原廠 NVIDIA 驅動程式啟動前套用 SM speed-select override。它針對的是 FP32 累加的張量指令路徑,不是全面提高顯示卡效能;項目亦列出 RTX 4070 Ti SUPER 的實驗結果,Ada 系列支援仍須按型號和環境驗證。

測試中,RTX 4090 的 FP16/FP32 指令吞吐由約 160 TF/s 升至 320 TF/s,BF16/FP32 亦接近翻倍。不過,cuBLAS GEMM 的增幅按矩陣尺寸約為 12% 至 34%;量化混合專家模型推理測試則沒有加速,反映指令吞吐提升不等於應用程式整體提速。

模組須在 NVIDIA 驅動程式初始化前生效,因此項目提供 mkinitcpio 和 dracut 的 initramfs 設定方式,並附有 Quick Start、測試流程及各次硬件與驅動程式測試記錄。測試涵蓋 PCIe Function Level Reset、驅動程式交接和數值檢查,但不少結果來自單張顯示卡或單次配對測試,未足以證明長期穩定性。

• RTX 4090 的 FP16、BF16 張量指令吞吐接近翻倍。
• GEMM 增幅依矩陣形狀而異,量化推理未見收益。
• 支援依賴核心、顯示卡型號及 NVIDIA 驅動程式組合。
• 適合有 Linux GPU 測試環境、能自行核對結果的研究者與工程團隊。

對需要測試 NVidia RTX 4090 Ada GPU 張量指令上限的團隊,這項目提供了可查閱的測試流程與硬件證據;若工作負載主要依賴量化矩陣運算,或要求長時間穩定運行,現有結果並未證明它能帶來相應收益。

GitHub

Categories: 開源, 模型, NVIDIA, Linux, 庫

CapCut 以外,Concat 把影片剪輯搬回本機

想剪片但不想上載素材、註冊帳戶或處理浮水印?開源影片編輯器 Concat 提供本機字幕、語音與多軌剪輯功能。

Concat

剪短片、上字幕、替換背景,卻不想先建立帳戶,把原片交給雲端平台處理,Concat 提供了另一條路。這個跨平台開源影片編輯器把自動字幕、文字轉語音、聲音複製、背景移除、多軌剪輯及 4K 匯出放進同一個介面,支援 macOS、Windows、Linux 與 Android。

Concat 屬於桌面及流動裝置影片編輯工具,核心特色不是追求完整取代所有專業軟件,而是針對 CapCut 常用的剪輯流程,減少上載素材及依賴訂閱的摩擦。自動字幕由本機 Whisper 處理,選擇模型大小後即可把字幕放上時間軸,再配合文字轉語音、關鍵幀動畫、特效及標題完成內容製作。

這項取捨十分清楚:素材可完全留在本機,離線工作,不會因平台政策改變而失去作品控制權;但代價是本機運算能力會直接影響字幕生成等功能的處理速度。Concat 亦提供語音複製,只需數秒錄音便可建立聲音,適合處理旁白、角色對白及多語言版本,背景移除則涵蓋人物、物件,亦可自行修正遮罩。

  • 支援 macOS、Windows、Linux 及 Android
  • 本機 Whisper 自動字幕,無須上載影片
  • 提供文字轉語音、聲音複製及背景移除
  • 支援多軌剪輯、關鍵幀、特效、標題與 4K 匯出
  • 無浮水印、無需帳戶,亦沒有上載限制或訂閱費用

對內容創作者、獨立製作者、教育工作者及需要處理敏感素材的團隊而言,這是一套頗完整的本機工作流。多軌剪輯、位置、縮放、旋轉、透明度及音量關鍵幀控制,令它不只停留在簡單裁片工具;惟目前版本號仍為 0.2.8,跨平台的成熟度、介面細節及不同裝置上的匯出表現,仍須經實際作品驗證。

GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, Video, Audio, 軟件, 工具, Content Creator, Mac, Linux, 語音, 動畫

Hycli 將網站變成可操作的 CLI 工具

Hycli 把網站包裝成 typed CLI 與 MCP 工具,讓 AI agent 讀取、搜尋及修改內容,同時把 cookies 留在本機。

Hycli — Websites, ready for AI.

網站操作之所以難交给 AI agent,往往不是模型不懂流程,而是登入狀態、網站結構與寫入風險都混在一起。Hycli 是開源 CLI 與 MCP server 生成工具,會從網站文件、前端 bundle 及瀏覽器網絡流量建立 typed CLI,涵蓋讀取與寫入操作,並沿用真實瀏覽器登入狀態。

它的差異不在於讓 agent 多一層包裝,而在於把「探索網站」與「執行變更」分開。三個 AI workers 會檢查文件、程式碼和 live traffic,建立工具規格期間不會執行 mutation;即使路徑或 GraphQL body 隱藏了寫入行為,也會被攔截。新 CLI 預設 writes: false,首次寫入前要求用戶確認,亦可隨時撤銷權限。

  • 用 hycli prepare 探索網站並產生 CLI 規格
  • 透過 CLI 或 MCP 讀取、搜尋、建立及編輯網站內容
  • cookies、localStorage、sessionStorage 與 API keys 儲存在本機 vault
  • 寫入失敗不會自動重試,避免重複下單或發文
  • 匯入登入狀態時只讀取指定網域的資料

瀏覽器憑證不會放入 LLM prompt,模型只會看到帳戶標籤、storage key 名稱及已遮蔽的 response schema;真正的 secret 由本機在執行時注入,並從輸出與日誌中移除。OS keyring 分別支援 Windows Credential Manager、macOS Keychain 與 Linux Secret Service,亦備有只限擁有者讀取的檔案權限。

Hycli 適合需要反覆處理後台、內容平台或內部網站介面的團隊,也適合已使用 MCP 的 AI agent 工作流。它不是通用網頁爬蟲,重點是為特定網站建立可重用的 typed 操作介面;實際效果仍取決於網站是否提供可辨識的文件、前端 bundle 或網絡 API,以及該網站是否容許相關自動化操作。

GitHub

Categories: 開源, Agentic, MCP, 模型, API, 工具, Mac, Linux, 安全

Verus-Insight 分析可見瑕疵:影片真假判斷有跡可尋

Verus-Insight 不只判斷影片是真還是假,亦會逐步規劃檢查項目、核實畫面證據,再整理成結構化結論。這套開源模型適合研究影片偽造分析及可解釋檢測的團隊評估。

Verus-Insight — Towards Explainable Artifact Detection in AI-Generated Videos

檢查 AI 生成影片時,單有真假標籤未必足以說明判斷依據。Verus-Insight 是一個影片瑕疵檢測模型,會按影片內容制定檢查準則、核實畫面中是否看得到相關瑕疵,再把觀察結果整合成真假判斷,讓分析不只停留在分類結果。

模型建基於 Qwen3-VL-8B-Instruct,採用「檢查規劃、證據核實、證據整合」流程。訓練方法以人工標註作錨點,涵蓋 Context → Rubric → Audit → Aggregation;這套流程旨在讓模型按影片內容提出檢查項目,並以可見證據支持結論。程式庫提供的是推理版本,並非可直接執行的訓練套件。

Verus-Bench 包含 192 段真實及 AI 生成影片,各佔 96 段,另有 320 項人工標註瑕疵,分屬 17 個類別。資料集可用來檢視模型能否找出細節瑕疵,但目前提供的資訊沒有列出具體評測分數,因此不宜據此判斷它比其他模型準確多少。

程式庫支援 Transformers、vLLM 推理,亦提供影片、圖片或影格序列輸入,以及批次推理與結果續跑功能。使用者可按文件準備 Linux、CUDA 環境並下載模型;Transformers 測試配置使用一張 H100 80GB GPU,但這只是已驗證配置,並非最低硬件要求。程式庫沒有提供訓練指令或訓練配方。

  • 適合研究影片偽造、視覺瑕疵分析及可解釋檢測的團隊。
  • 可由單一輸入測試,也可批次處理已整理的資料清單。
  • Verus-Bench 提供人工標註,方便檢視瑕疵定位與影片層級判斷。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Video, Image, Linux, 庫, Dataset 數據集

Page 1 of 7
1 2 3 … 7