Video-RSI:不改模型權重,讓影片代理自行進化

Video-RSI 透過改寫提示詞、工具、記憶與執行邏輯,提升影片理解代理的準確度及取樣效率。

Video-RSI framework: Solver execution, active video investigation, and cost-aware harness evolution.

影片理解代理遇到答錯問題時,未必需要重新訓練模型。Video-RSI 是一個開源框架,讓代理重新檢視影片,補充視覺、字幕及 OCR 證據,再把失敗原因轉化為可重用的程式修改;模型權重則保持不變。

項目由 Solver 和 Editor 配合:Solver 執行影片問答,Editor 調查失敗案例,並演化 prompts、tools、memory 及 execution logic。相比只調整模型參數,這種做法把改善集中在可執行 harness,較適合需要快速反覆修正工作流程的研究團隊。

  • 透過額外視覺、transcript 及 OCR 證據分析錯誤
  • 以 accuracy 和 visual-frame cost 共同篩選修訂版本
  • 提供 Initial harness、final harness、inference 及 evolution framework
  • 預設支援 DeepSeek-V4-Pro 和 Qwen3.6-Plus 等 OpenAI-compatible service 模型

評測會在私有 Gate set 以答案準確度及視覺影格處理成本配對選擇版本。項目資料所述結果指向更佳的 accuracy–efficiency trade-off:演化後 harness 在維持競爭力準確度的同時,處理較少影格,但未有公開具體分數或基準逐項差距。

要測試項目,需要 Linux、Python 3.12、兼容 API 服務,以及本地 RapidOCR 3.9.2 PP-OCRv6 small detection and recognition models;影片輸入採 JSONL,包含問題、選項、片長及絕對路徑,也可載入 faster-whisper large-v3 產生的 transcript。需要留意,允許 provider calls 會使用付費模型 API,因此成本控制和本地 OCR 準備是部署前的重要取捨。
項目主頁 · GitHub

Categories: 開源, 模型訓練, Qwen, DeepSeek, API, Video, 提示詞, 框架, 工具, Linux, Python

SepGen 讓影片生成同時輸出獨立聲軌

SepGen 把影片生成與聲音分離放進同一模型,讓每種聲音獨立輸出,方便重混及空間音效製作。

SepGen overview

影片生成不再只產生一條混合音軌:SepGen 是一個多模態生成模型,處理影片畫面、完整配樂,以及按描述分開的聲音 stem。你可以描述場景和各種聲音生成新片,也可以交給它現有影片,抽取指定聲音。

SepGen 建基於 LTX-2.5,在同一次運算加入兩條由文字控制的音訊軌;原有完整 soundtrack 保持不變,每條 stem 只根據自己的描述生成。相同模型同時支援 generation 和 separation,分離後的聲音亦可配合場景位置,延伸至 4D video 和 spatial audio 工作流程。

  • 生成影片、完整 soundtrack 及獨立聲軌
  • 以文字指定要抽取的聲音
  • 同一組 weights 支援兩種任務
  • 可配合移動視角重新呈現聲音位置

項目適合影片後期、遊戲場景、互動媒體及需要重新混音的研究團隊。README 提供 Linux、ffmpeg 及單張 48 GB NVIDIA GPU 的執行條件;模型 weights 約 72 GB,每段影片在 RTX A6000 上需數分鐘,長片則要啟用 VAE tiling,且 num-frames 必須符合 8k+1。

SepGen 的取捨在於硬件及模型容量要求不低,README 亦未提供低記憶體替代方案。gen-3k checkpoint 可用於 generation,分離能力約相近;項目同時提供模型與 SepGen-Dataset,但目前資料未交代更廣泛硬件的性能比較,較適合作為研究原型或具備 NVIDIA 工作站的製作項目。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, NVIDIA, Video, Audio, Linux, LTX, Dataset 數據集

RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

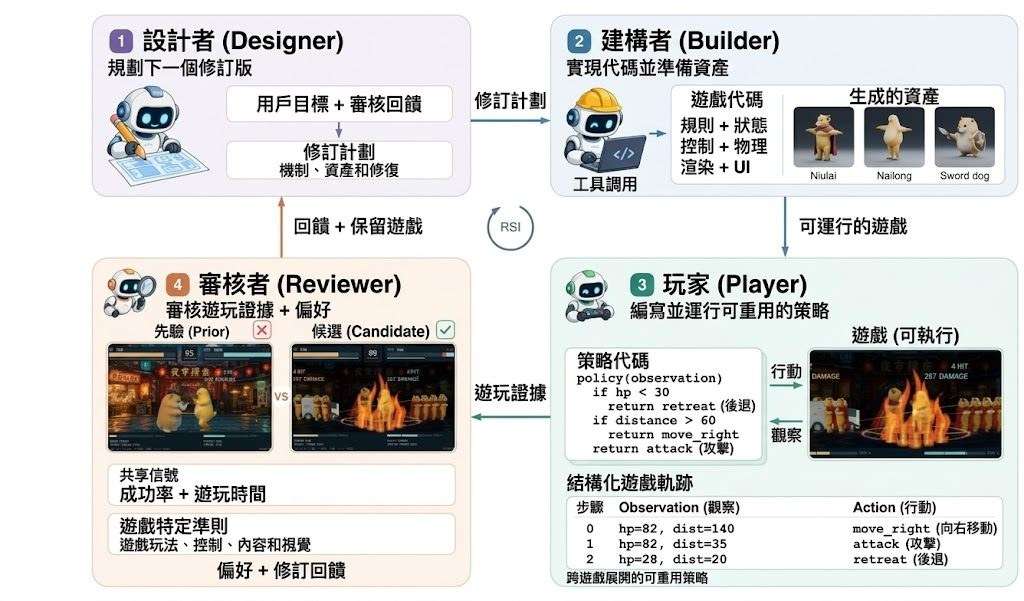
Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

nanoMuse:跨裝置、會先徵求同意的開源個人代理

nanoMuse 將手機、電腦與網頁連成同一個個人代理,能代辦事情,也會在刪除、傳送或付款前停下來確認。

nanoMuse: an open-source personal agent for every device you own

你可以在手機交代工作,讓 nanoMuse 轉到電腦執行,完成確認時再把要求送回手上的裝置。它屬於開源個人代理項目,處理的是跨裝置協作、持續執行與高風險操作控管。nanoMuse 是獨立的社區項目,與 Meta Platforms, Inc. 無關

手機 App、桌面 App、網頁控制台和串連各裝置的 relay 放在同一個 GitHub 儲存庫,支援 Android、iPhone、iPad、macOS、Windows、Linux 和網頁。Shell、瀏覽器、MCP servers、skills,以及可透過畫面操作手機 App 和電腦視窗的 Hands,全部經 Sentinel 轉接;刪除、傳送或付款前會要求批准,代理本身不會直接執行工具。

  • Markdown 檔案可讀寫,用來描述代理身份、記憶和喚醒時機
  • App 關閉後仍可繼續工作,裝置共用同一個帳戶和對話
  • 可使用社群 relay 的免費模型額度,亦可改用自己的 key
  • relay 能在自家伺服器運行,減少資料離開住所的需要

和 Muse、OpenMinis 的比較:nanoMuse 明確沿用 Meta Muse 式的個人代理方向,但把手機、桌面、網頁、relay 和安全批准機制一併開源。Android、Windows、macOS 和 Linux 有下載版本,iPhone、iPad 則透過 TestFlight beta。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 框架, 工具, Mac, Linux, 庫, 安全, Meta, 免費試用, 中國, 蘋果, Skill 技能

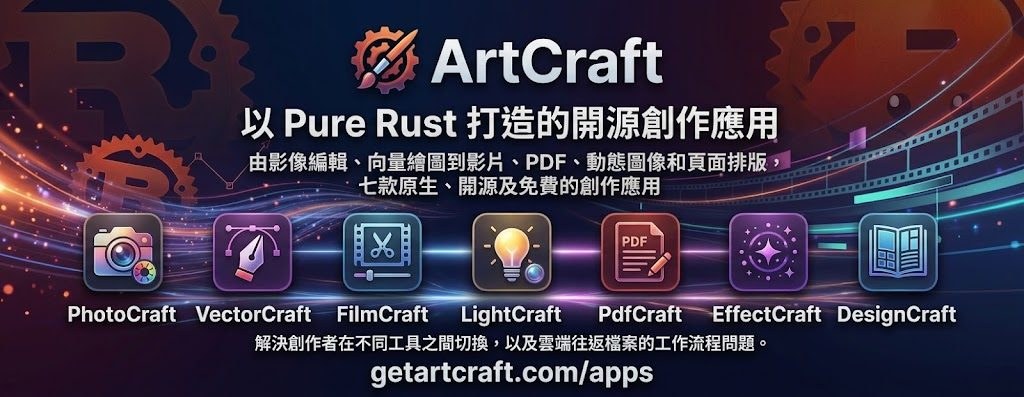
ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。

  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

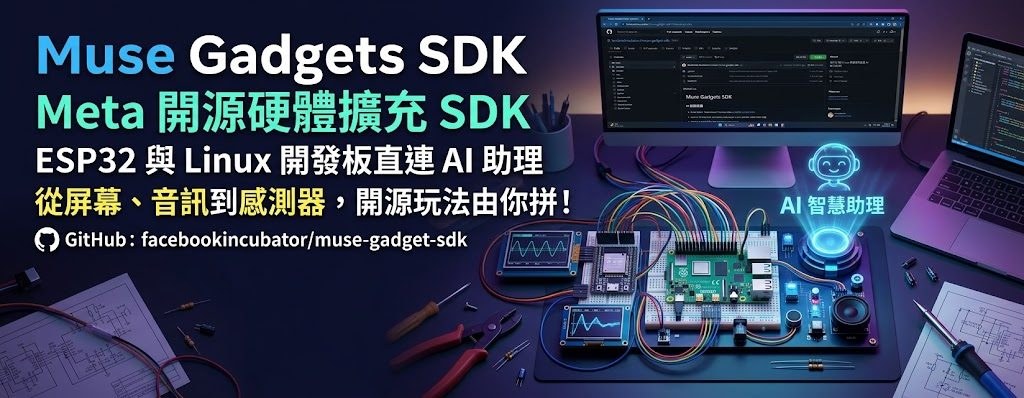
Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

HelixWorld 即時生成互動視聽世界

輸入一張圖片和提示詞,再用方向指令探索場景,HelixWorld 會同步更新畫面與空間聲音。預覽版已提供瀏覽器示範及離線推理程式碼,但硬件門檻不低。

HelixWorld — Sound and vision, born together

轉身時,聲音方向也會跟着視角改變,這是 HelixWorld 與一般先生成畫面、再配上音軌的做法不同之處。它是 Noiz AI 開發的即時互動視聽世界模型,讓使用者從一張圖片和提示詞出發,以方向指令在生成場景中移動,並同步產生影像與聲音。

瀏覽器示範適合先感受互動效果;想離線測試,則可使用已公開的 Preview v1 推理程式碼和預覽模型。它目前支援 Linux、Python 3.11 和 CUDA 12.x,建議使用配備 80 GB VRAM 的 NVIDIA GPU;BF16 單卡測試約需 70 GB VRAM,對個人電腦使用者而言是明顯門檻。

操作時可輸入前進、轉向或停止等動作,並設定第一人稱視角及生成影格數;提示詞亦可分別描述影片、音訊或視聽內容。輸出會整理成 MP4,適合研究人員、互動內容創作者及想探索空間音效生成的團隊測試,但目前公開資訊未提供性能評測數據,亦未公開完整模型與訓練資料。

  • 畫面和聲音會隨鏡頭移動同步更新,空間聲場跟隨視點改變。
  • 可先用瀏覽器示範體驗,也可在符合硬件條件的 Linux 系統離線推理。
  • 預覽版已開放,完整模型、訓練資訊及報告仍待公開。

HelixWorld 展示了視聽生成從固定片段走向可操控場景的一種做法;不過,現階段的高顯示記憶體需求和有限評測資訊,令它較適合研究與原型測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, Video, Image, Audio, 提示詞, Content Creator, Linux, Python

AcademiaSD LoRAlab Trainer Studio:訓練影像與影片 LoRA

把多個模型的 LoRA 訓練流程集中到一個介面,支持消費級 NVIDIA 8G 顯卡。

AcademiaSD LoRAlab Trainer Studio

想為角色、物件或畫風訓練 Low-Rank Adaptation(LoRA),不一定要準備高階顯卡;AcademiaSD LoRAlab Trainer Studio 是一套 LoRA 訓練工具,目標是在最低 8 GB VRAM 的消費級 NVIDIA GPU 上處理最新影像及影片模型,並把不同 trainer 收進同一個 Web 介面。

每個模型會以 4-bit NF4 載入,文字編碼器與 VAE 只在 pre-cache 階段執行一次,之後把 GPU 資源集中到訓練。項目支援 Windows 10、Windows 11 及 Linux,使用 Python 3.13、PyTorch 2.14 cu130,以及 Flask + HTML5 介面;同一套安裝環境可加入後續新增的 trainer,毋須為每個模型另建環境。

工作流程包括資料集管理、自動 caption、即時預覽、精確步數續訓及一鍵匯出至 ComfyUI。訓練期間可以修改 steps、儲存及預覽頻率、預覽設定和 learning rate,按下 Save JSON 後,變更會在下一步生效;每個項目亦會分開保存 pre-cache、checkpoint、預覽圖及 LoRA 輸出,刪除快取或訓練內容不會碰到資料集。

  • 匯出的 LoRA 帶有 kohya-style metadata,包含 trigger word、rank、steps 和 resolution
  • CivitAI 及 LoRA managers 可以讀取相關 metadata
  • 一般角色、物件和風格 LoRA 可採用一張圖片配一段 caption
  • 可從同一網絡的其他裝置上載資料集及下載 LoRA

這套工具較適合想在本機反覆試驗、又不想手動管理多個訓練環境的創作者和小型團隊。預覽圖只用來追蹤訓練進度及角色、物件或風格的相似度,不能直接當成最終品質;完成後仍要在 ComfyUI 或 Forge 調整 LoRA 強度及模型品質設定。由於多個模型支援接近同時加入,README 亦明確提醒可能存在錯誤、未完善設定,以及預設訓練參數未必適合每個資料集,使用者需要自行測試並透過 Issues 回報結果。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 工具, Content Creator, Linux, Python, Win, LoRA

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

Page 3 of 7
1 2 3 4 5 … 7