它吸引人的地方不只是可以對話,而係可以直接接去 Claude Code、OpenClaw、Codex、Copilot 等現有工具鏈。換句話說,Ollama 唔係只提供一個聊天殼,而係充當本地模型服務層;你可以用 CLI 跑模型、經 REST API 調用,亦可以配合 ollama-python、ollama-js,或者再接 Open WebUI、LibreChat、Lobe Chat、NextChat、Perplexica 呢類前端與應用。
安裝方式以桌面應用為主,官方已提供下載、文件同 troubleshooting,理解上接近本地 AI studio,而唔係單一模型倉庫。現有資料未見統一基準分數或嚴格 benchmark,對聲音相似度、延遲同穩定性,仍要視乎你選用邊個 engine、樣本質素,同埋會唔會改用 local or remote inference;但作為把多語音模型、克隆流程同輸入輸出控制整合起來嘅開源項目,它已經比只提供單點功能嘅工具更接近可長期放入工作流。
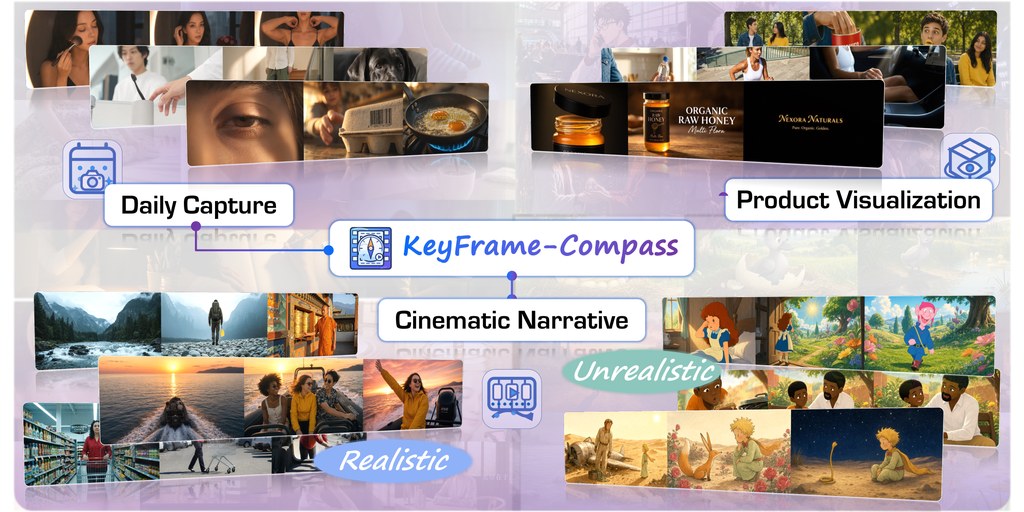
KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。
這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。
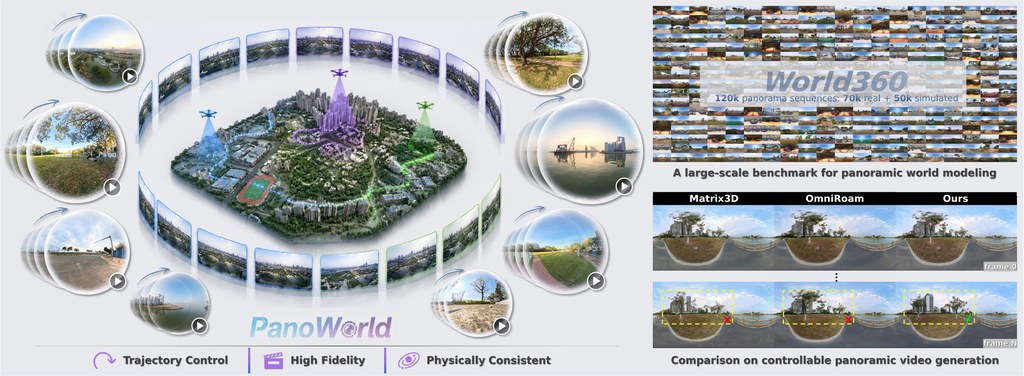
受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。