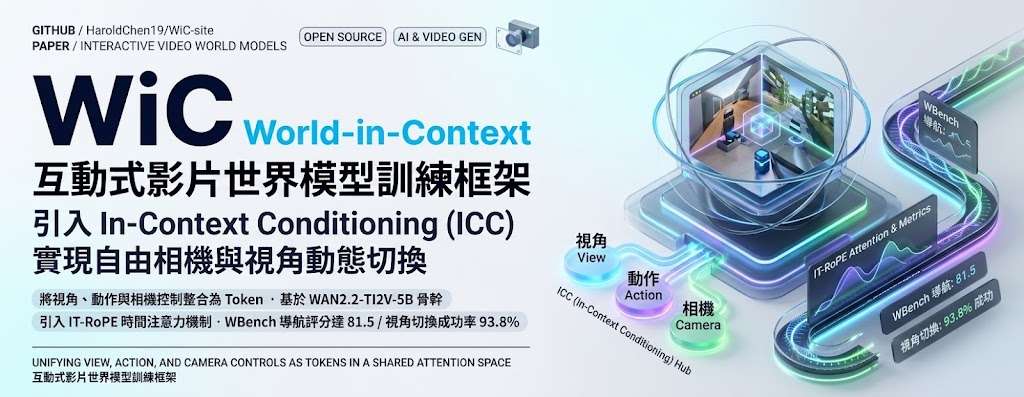
想在生成影片中移動鏡頭、改變觀看角度,甚至在第一人稱與第三人稱之間切換,畫面仍須保持連貫。World-in-Context(WiC)是為互動影片世界模型而設的訓練框架,目標是讓視角、動作和鏡頭控制在同一段影片中協同運作,而不是各自處理。
WiC 以 Wan2.2-TI2V-5B 作為基礎模型,透過 In-Context Conditioning(ICC)把視角、動作與鏡頭控制轉成共享注意力空間中的 tokens;Interaction-Transport RoPE(IT-RoPE)則把累積的控制變化納入時間注意力。這讓系統可支援自由鏡頭、第一人稱及第三人稱視角,也能在影片進行中切換,適合研究互動式場景生成、遊戲環境及長時間因果推演。
在 WBench 評測中,WiC 的導航平均分為 81.5,視角切換成功率為 93.8%。這些結果反映它能處理導航與鏡頭切換,但不能單憑分數判斷生成影片在所有場景都同樣穩定;GPU 記憶體需求亦會隨影片尺寸和設定改變。
目前程式碼、訓練程式及 WiC 權重仍在審核,尚未公開,因此現階段無法自行安裝並重現推理結果。計劃中的版本要求 Linux、Python 3.10,以及支援 BF16 的 NVIDIA GPU;預設生成設定為 832×480、81 幀、16 FPS 和 50 個採樣步驟,並預計提供 11 個包含起始圖片、提示詞與控制資料的範例。
- 以 Wan2.2-TI2V-5B 為基礎,加入 WiC adapter。
- 同一影片支援自由鏡頭、第一人稱與第三人稱視角。
- WBench 導航平均分 81.5,視角切換成功率 93.8%。
- 程式碼與權重尚未公開,現時未能重現結果。
對研究影片生成、虛擬環境導航或互動遊戲場景的團隊而言,WiC 提供一條把鏡頭與動作控制合併訓練的路線;但在公開程式碼和權重推出前,這些能力仍主要停留在研究成果與展示範例,還不能直接納入工作流程測試。