MemSlides 把簡報生成變成可記憶代理

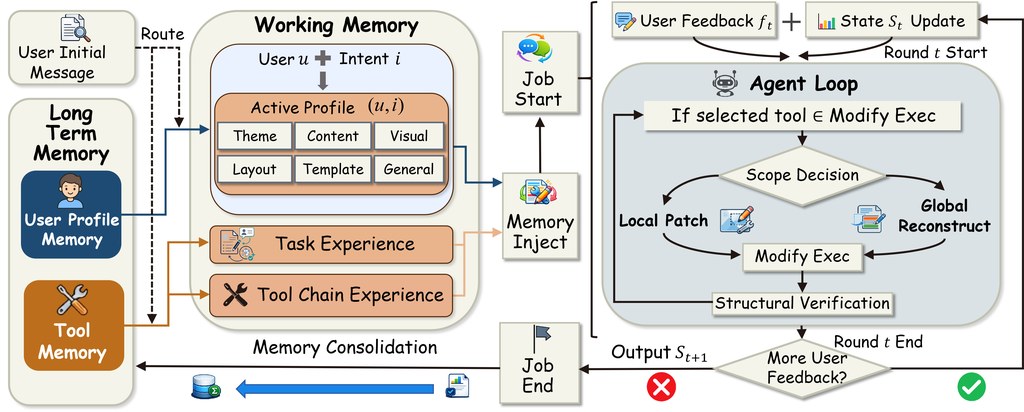
MemSlides不是一次過出投影片,而是把簡報寫作當成可持續修改的流程。它用分層記憶處理個人化與多輪修訂。

MemSlides hierarchical memory and localized revision overview

不少簡報生成工具仍然走 one-shot source-to-slides conversion:丟一份材料進去,整份投影片一次生成,之後每次修改又大範圍重做。MemSlides 把問題改寫成 stateful authoring process,核心不是單次輸出,而是記住你是誰、這一輪想改甚麼,以及過往哪些工具操作較可靠。

這是一個 Agent Framework,目標是解決 personalized slide generation 與 multi-turn local revision 兩個常見痛點。它把記憶拆成 user profile memory、working memory、tool memory:前者保存跨工作重覆出現的偏好,中段記住當前簡報的限制與暫時要求,後者則保留工具鏈執行經驗,方便之後做相似修改時少走彎路。

跟同類做法相比,最需要留意的是它不主張每次收到新意見就重生整副 deck,而是做 scoped slide-local revision,只更新受影響的最小區域。這種取向的好處是修改更穩定,較易保留原本好的內容;代價是整體品質會依賴記憶管理與局部編輯判斷是否準確。

從倉庫資訊看,這個項目較適合研究 presentation agents、企業內部簡報自動化,或要反覆為不同角色產出版本的團隊。倉庫亦提供 Docker Hub、網站、示範影片與論文連結,理解方式可先看 demo,再決定用容器部署還是按 Python 3.11 與 Node 20 的環境自行搭建;不過公開資訊未見完整量化基準,現階段較像研究型框架,而非已標準化的產品方案。

  • 把簡報生成由一次性輸出改成有狀態的寫作流程
  • 分層記憶是重點:user profile memory、working memory、tool memory
  • 修改時傾向局部修補,不是整份重生成
  • 適合需要 persona-aware 內容、反覆修訂、多人協作的情境
  • 相關元素包括 presentation agents、multi-turn revision、localized editing、tool-chain execution
GitHub: https://github.com/huohua325/Memslides

項目主頁: https://memslides.github.io/

Categories: 開源, 清華大學, Agentic, 框架, 工具, IDE, Python NLP, Python, 庫

MolmoMotion 把語言變成 3D 動作預測

這是一個會按文字指令預測物件未來移動路徑的 4B 視覺語言模型,也連同資料集與基準一併公開。

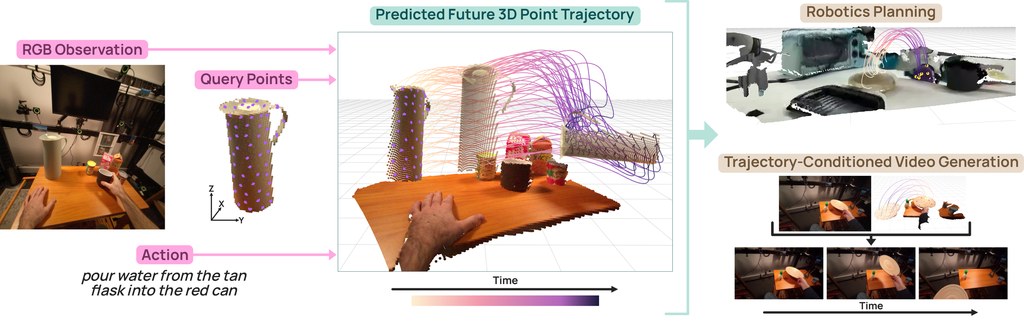
MolmoMotion teaser

現有做法多數偏向追蹤已經發生的移動,或者只在 2D 畫面估計下一步位置;作者認為這種 retrospective 範式難以支援機械人規劃與可控影片生成,所以提出 MolmoMotion、MolmoMotion-1M 同 PointMotionBench,把問題改成「根據語言指令預測 3D 點位未來軌跡」。這不是單純看影片理解內容,而是要模型根據短段 RGB 歷史、2D query points、初始 3D 位置,以及文字動作描述,預測之後約 2 秒的 3D movement。

MolmoMotion 本身屬於模型,更準確地說是 4B vision-language model,處理的是物件上指定點會怎樣移動的預測問題。儲存庫目前公開的是 autoregressive (AR) variant,並提供訓練資料、評測集、已釋出模型,以及由 pretrain 到 long-horizon finetune 的兩階段流程,較適合研究團隊直接重現結果或改成自家任務。

和同類方法相比,這個項目的取向很鮮明:它不是先做一般影片理解,再另外接 motion head,而是把 language-guided 3D point trajectory forecasting 當成核心任務。代價是輸入要求較多,你要有 query points 同初始 3D 資訊;回報則是輸出更貼近規劃用途,特別適合要預測「物件將會點樣郁」而不是只想分類場景的人。

  • 可預測最長約 2 秒未來軌跡,文件提到 15 fps、F=30 或 F=32 的設定
  • 評測指標列出 ADE、FDE、PWT,焦點放在軌跡準確度而非只看畫面相似度
  • 配套包含 MolmoMotion-1M 訓練資料集與 PointMotionBench 評測基準
  • 作者指出學到的 motion prior 可轉移到 robotics planning 與 motion-guided video generation

部署與測試的理解方式相當直接:先下載模型、資料集或 benchmark,再按儲存庫提供的 evaluation 與 training 流程執行;若不打算重訓,較合理是先拿已釋出模型跑 PointMotionBench 或自家樣本,看看語言指令改變時,3D 點位預測是否穩定。現有資訊未見完整效能數字摘錄,但官方明確聲稱表現明顯優於既有 forecasting 方法;較保守的判斷是,它最適合 embodied AI、robotics、可控影片生成研究者,以及需要把語言意圖轉成未來運動假設的團隊。

相關模型與資源包括:MolmoMotion、其 autoregressive (AR) variant、MolmoMotion-1M、PointMotionBench;底層 backbone 初始化與從零訓練入口亦有提供。

GitHub: https://github.com/allenai/molmo-motion

項目主頁: https://allenai.org/blog/molmo-motion

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Robotic, IDE, 3D, 庫, Dataset 數據集

JanusMesh 把雙提示變成 3D 視覺

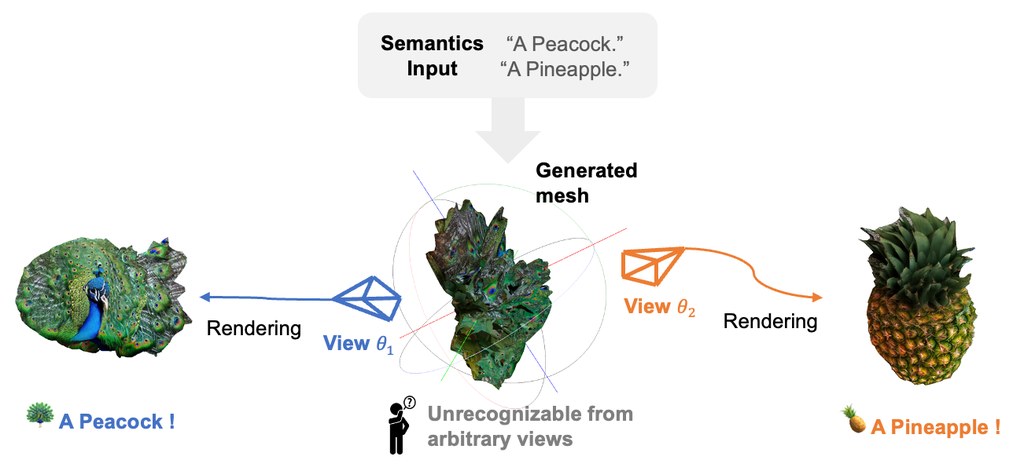
JanusMesh 用兩句文字生成同一個3D物件,從不同角度看出不同意思。它主打免訓練、速度快,亦針對舊方法的接縫與語意外漏問題。

Teaser

現有 3D visual illusions 做法,多數不是走 optimization-based methods,就是把兩個形體直接拼接。前者慢,還容易出現過飽和顏色;後者雖然直接,但會留下明顯幾何接縫,亦會有 semantic leakage。JanusMesh 提出的不是新訓練模型,而是一條 training-free pipeline,目標是把兩個文字提示融合成一個 3D mesh,並在指定視角各自呈現不同語意。

它的核心分成兩步:先用 cross-space dual-branch denoising,在 voxel 與 Signed Distance Field (SDF) 之間處理形體融合,再配合 CLIP 做 orientation alignment;之後再用 view-conditioned 2D diffusion 補貼圖與外觀。這種拆法的重點,不是單純把兩個物件疊上去,而是先解決幾何是否連貫,再處理不同視角看到的表面語意。

部署上,現有資訊顯示它較適合有 CUDA 環境的研究或圖像團隊,因為要安裝多個 CUDA extensions,例如 flash-attn、nvdiffrast、diff-gaussian-rasterization、pytorch3d。測試思路相當清晰:可先用 case 1 或 case 2 直接生成固定 voxel split 結果,再用 case 3 加入 CLIP pose search,比較視角對齊是否更穩定;另外也可調整 noise guidance、space control、t0 idx value 與 guided structure weight,觀察語意強度與形體穩定度之間的取捨。

JanusMesh 的表現頗有競爭力:生成時間約 3–5 分鐘,主打 geometric integrity、semantic recognizability、efficiency 都比同類方法好。不過它目前更像研究型工具,適合做 3D 內容展示、視覺實驗、生成式藝術或學術比較;若想要任意角度都自然,文中亦明言這類物件在非目標視角本來就可能難以辨認,這其實是 3D 視覺錯覺成立的一部分。

  • 項目類型:一個 training-free 的 3D 生成流程,解決雙語意 3D visual illusions 的幾何接縫、語意外漏與生成速度問題。
  • 最值得留意的差異:不是 per-shape optimization,也不是 direct concatenation,而是先做 cross-space 幾何融合,再做 view-conditioned 外觀細化。
  • 較適合的情境:3D 生成研究、視覺傳達、展覽內容、概念設計,以及想比較多種 3D illusion 範式的團隊。
  • 性能重點:論文聲稱 3–5 分鐘可完成,較傳統 SDS-Based Methods 快,亦減少 oversaturation 與 seams。
  • 相關模型/組件:CLIP、2D diffusion、voxel、Signed Distance Field (SDF)、flash-attn、nvdiffrast、diff-gaussian-rasterization、pytorch3d。

GitHub: https://github.com/siang1105/JanusMesh

項目: https://siang1105.github.io/JanusMesh.github.io/

Categories: 開源, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 工具, IDE, 3D, Python

SSync 用選擇式蒸餾改善影片物件分解

SSync 針對影片物件分解常見的對齊成本高、訊號互相拖累問題,提出更精準的學習方式。它不是改整套架構,而是補強 slot-based 方法的弱點。

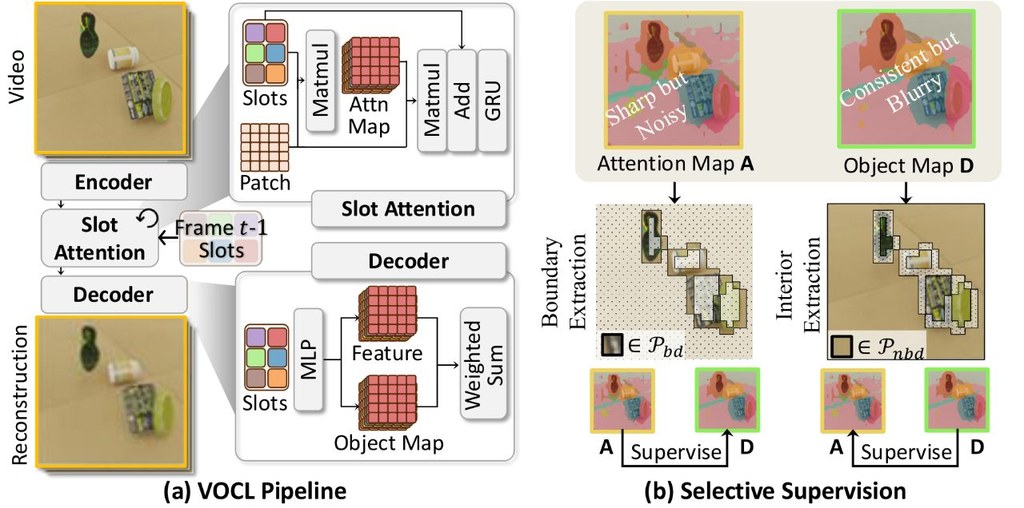
SSync

現有的 video object-centric learning(VOCL)多數沿用 slot-based frameworks,通常建基於 reconstruction-driven encoder–decoder architectures:encoder 產生 attention maps,decoder 產生 object maps,再嘗試把兩者對齊。近年的 dense alignment strategy 會對所有 spatio-temporal patches 做 contrastive learning,但這種全對全對齊會把 encoder 的雜訊和 decoder 的模糊邊界一併放大,計算量亦會升到 quadratic complexity,影片一長就更難擴展。

SSync(Selective Synergistic Learning)屬於一個可插入現有流程的 PyTorch 學習模組,目標是改善影片中的物件分解質素。它不是強迫所有 patch 全面一致,而是只挑選較可信的訊號做 mutual-distillation:用 encoder 幫手修邊界,用 decoder 清理物件內部雜訊,方向相當明確。

這項目把「全部都對齊」改成 selective distillation,並透過 pseudo-labeling 把成本降到 linear complexity。作者亦加入 transitive pseudo-label merging,處理 slot redundancy,將時序上反覆重疊的 slots 合併,減少模型把同一物件拆成多份的偏差。

如果你本身有研究 Slot Attention、影片分解、無監督物件發現,這項工作相當值得細看;如果你只是想快速試概念,亦可直接留意作者提供的 PyTorch implementation、Hugging Face 權重和 project page。它屬於 plug-and-play module,較適合已有 VOCL 基礎模型的人接入比較,而不是給完全零基礎讀者當成獨立應用程式。

  • 核心問題:dense alignment strategy 計算昂貴,亦會傳播 encoder 與 decoder 各自的錯誤
  • 核心方法:Selective Synergistic Learning 只蒸餾可靠線索,分開處理 boundary refinement 與 interior denoising
  • 結構補強:加入 transitive pseudo-label merging,減少 slot redundancy
  • 論文聲稱:可提升 decomposition quality,並對 slot configurations 有較強 robustness
  • 相關技術詞:VOCL、slot-based frameworks、Slot Attention、mutual-distillation、pseudo-labeling

整體來看,SSync 的價值不在於另起爐灶,而是在既有 slot-based video learning 範式上,直接指出 dense patch alignment 的兩個痛點:錯誤傳播與計算擴張。對研究型讀者而言,這比單純再堆模型容量更有意思;對工程導向團隊而言,它也提供了一個較容易插入現有項目的改良方向。

GitHub: https://github.com/wjun0830/SSync

項目:https://wjun0830.github.io/SSync/

Categories: 開源, 模型, 視覺模型, Video, 框架, IDE, Python, 編程, 深度學習

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

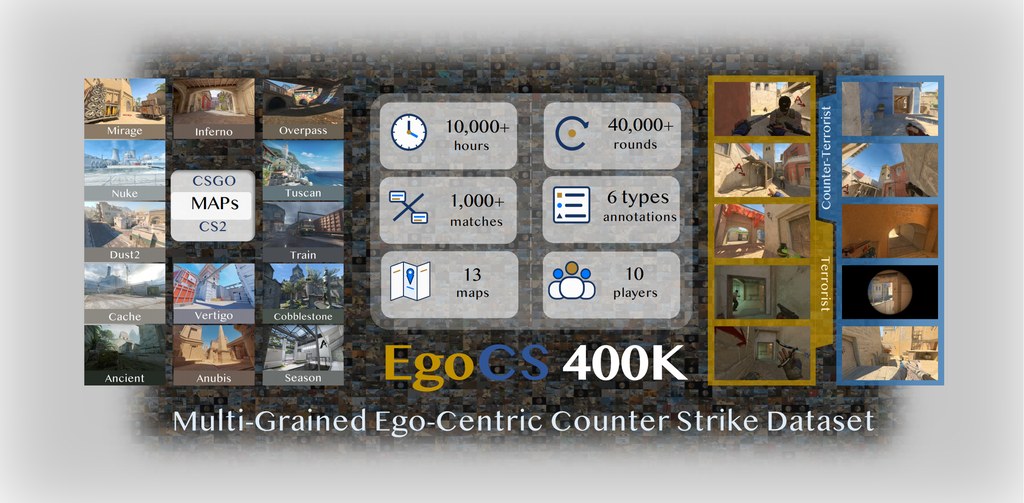
EgoCS-400K dataset overview

現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, 庫, 動畫, Dataset 數據集

SeeQ 讓 VLM 學識自己出視覺問題

這個項目聚焦 Visual Question Generation,想解決高質視覺提問數據昂貴又難擴充的問題。它用自我演化流程,令 VLM 由答題者變成會主動發問的系統。

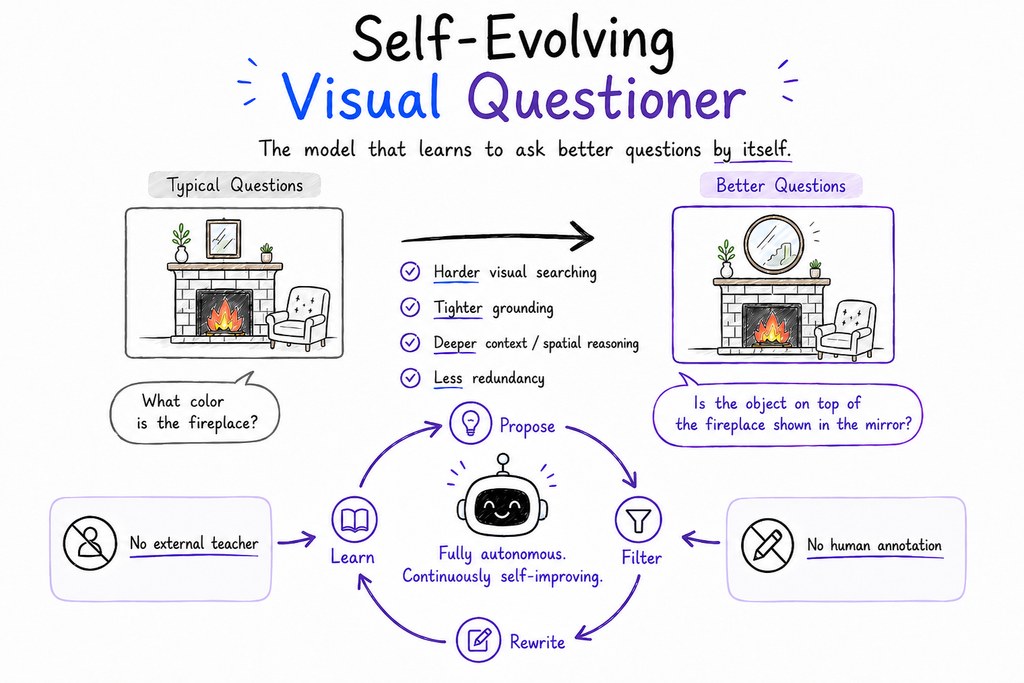
Cover Figure overview

現有 Vision-Language Models(VLMs)多數按「被動答題」範式訓練:人類或外部模型先提供問題,模型再學習回答。論文認為這種 fixed inputs 做法受制於靜態資料分佈,Visual Question Generation(VQG)亦容易卡在標註成本高、題目深度不足這兩個瓶頸,所以 SeeQ 提出 Self-Evolving Visual Questioner,用同一個 VLM 同時做 proposer 與 filter,自動從未標註圖片生產更難、更貼近畫面內容的問題。

這個項目屬於框架兼研究型工具,重點不是再做一個普通題庫,而是建立完整流水線:先生成 seed questions,再反覆改寫,提升 visual search、context 與 spatial reasoning 要求,之後再由模型自行過濾。作者同時加入 exploration diversity 控制,目標是避免訓練一路收窄,最後只剩單一風格題目。

如果你想試,較合理的做法是先準備圖片對應的 JSON 輸入,再分開看 generation 與 evaluation 兩部分輸出。倉庫內沒有附模型權重、數據集與快取,評測亦會用到 image-capable OpenAI evaluator 與 Qwen embedding models,所以較適合已經有 VLM 環境、想驗證自動出題流程的研究者或多模態團隊。

  • 以未標註圖片開始,自動生成、改寫、過濾視覺問題
  • 保留 Agentic evaluation,從 visual search、evidence coverage、context、spatial reasoning 評分
  • 另用 Qwen embedding models 檢查整體多樣性,不只看單題質素
  • 強調 zero external supervision,不依賴人工標註或 GPT-4V 這類外部 teacher models

創新點在於它不單止用 VLM 產生問題,還把「提問能力」當成可自我增強的訓練訊號,並且把 questioner 與 answerer 兩種模式一起考慮。按論文說法,這套方法在多個 backbone VLMs 上都能提升問題質素,亦把自動出題的難度邊界推高;同樣預算下,比直接用靜態來源資料訓練更有效,而模型的 answerer 能力亦未有明顯犧牲。

相關模型與元件方面,倉庫內容顯示生成流程可配合 Qwen2.5 3B 類型設定,評測會用 OpenAI 的可看圖評估器,以及 Qwen embedding models。若你關心多模態訓練、合成數據、或想建立能自己發問再自我改良的 Agentic workflow,SeeQ 的方法論比單純看分數更有參考價值。

GitHub: https://github.com/tianyi-lab/SeeQ

Paper: https://arxiv.org/pdf/2606.13929

Categories: 阿里巴巴, Agentic, AI productions, RAG, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, OpenAI, Image, 框架, 工具, IDE, Python, 庫, Dataset 數據集

Ponytail:幫 AI Agent 減少大量的程式碼

Ponytail 是給 AI Agent 用的規則型工具,重點不是炫技,而是逼模型先刪繁就簡。它特別適合想減少過度工程化的人。

Ponytail, the lazy senior dev

Ponytail 是一個針對 AI Agent 的工具型項目,核心作用不是取代模型,而是替模型加上一套固定判斷規則,令它在寫程式前先問自己:這段東西是否真的需要存在、標準函式庫能否處理、平台本身有沒有現成功能。它想解決的問題很直接,就是不少 AI Agent 會把簡單任務寫得太重,順手加框架、包裝層、額外抽象,最後程式碼變多、回應變慢,成本也上升。

這個項目已相當成熟。它把「少寫不是偷懶,而是保留必要部分」變成一條清晰階梯:先跳過不需要的東西,再優先用 stdlib、原生平台功能、已安裝依賴,最後才自己寫最少可行實作。這種設計對 AI Agent 特別有效,因為模型常見問題不是完全不懂,而是太願意補很多你未必需要的東西。Ponytail 等於把資深工程師那種「先刪再寫」的習慣,包成可重複套用的規則。

如果你想試它,先找幾類容易被模型寫得過火的小任務,例如日期輸入、debounce、rate limiter、簡單驗證或 CSV 處理。倉庫資料顯示,它支援 Claude Code、Codex、GitHub Copilot CLI、Gemini CLI、OpenCode、OpenClaw 等多種環境,亦即它不是綁死單一平台,而是瞄準「那些 AI Agent」的日常編碼流程。對於經常要用 Agent 產生前端小功能、工具腳本、日常後端邏輯的人,這類規則比再換一個新模型更實際。

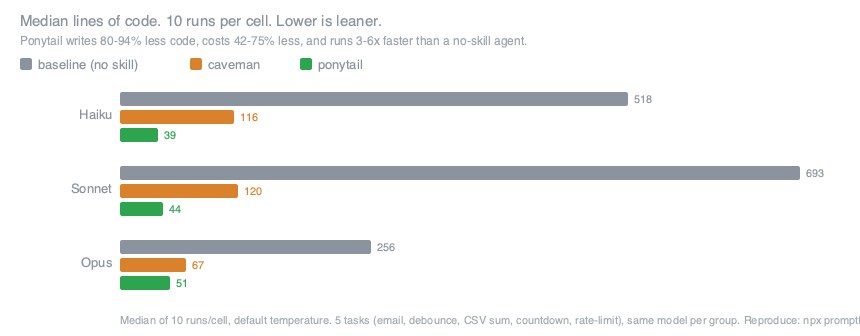
在 Claude API 的基準測試中,官方列出每項任務程式碼可減少 80% 至 94%,延遲快 3 至 6 倍,成本下降 42% 至 75%。不過這些結果有清楚前提,只能代表特定模型與提示方式下的中位數表現,並非所有模型都一定受惠;倉庫亦明言像 GPT-5.5 這類較簡潔的推理模型,規則注入與思考步驟本身可能抵消節省效果。這種寫法反而增加可信度,因為它沒有把 benchmark 包裝成放諸四海皆準的勝利宣言。

  • 重點不是生成更多程式,而是限制 AI Agent 只寫任務真正需要的部分
  • 支援多個 Agent 宿主,包括 Claude Code、Codex、Gemini CLI、OpenClaw 等
  • 提供 /ponytail-review、/ponytail-audit、/ponytail-debt 等指令,方便檢查過度工程化
  • benchmark 數據亮眼,但倉庫已提醒不同模型、提示長度與回合數會影響結果
  • 適合經常叫 AI Agent 寫工具碼、介面小功能、重複邏輯的人

Ponytail 的創新在於它把工程判斷流程產品化,讓 AI Agent 先經過一道「有沒有更省、更原生、更少依賴」的篩選。這令它比較像一個行為約束層,而不是新模型或框架。相關模型與環境方面,倉庫內容直接提到 Claude 的 Haiku、Sonnet、Opus,也提到 GPT-5.5,並覆蓋 Codex、Gemini CLI、Antigravity CLI、GitHub Copilot CLI 等代理工具鏈。若你想要的不是更花巧的生成能力,而是更穩定地避免 AI Agent 過度設計,這個項目有很明確的價值;若你的工作本身需要大量自訂架構與長鏈依賴,它未必會永遠選出你最喜歡的答案,但至少會迫使模型先證明「為何需要寫那麼多」。

GitHub: https://github.com/DietrichGebert/ponytail

Categories: 開源, Agentic, AI productions, 模型, 微軟, OpenAI, Gemini, API, 框架, 工具, IDE, 庫, OpenClaw, Anthropic, Skill 技能

JoyAI-VL-Interaction 把影像助手變主動

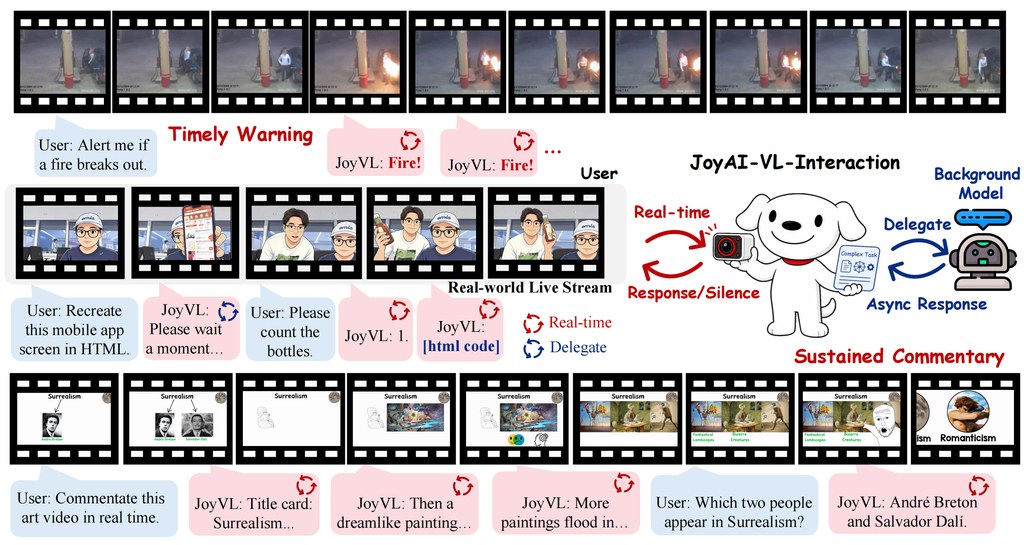
這不是等你發問的聊天模型,而是持續看畫面、自己判斷何時出聲的互動項目。

JoyAI-VL-Interaction overview

現時多數視覺語言模型仍然沿用 turn-based 問答範式:用戶問一句,模型答一句;就算放進視像通話或直播介面,底層仍是被動回應。JoyAI-VL-Interaction 直接挑戰這個做法,改成持續觀看、按秒判斷要沉默、回應,還是把難題交給背景模型處理,目標是把 VLM 從「被問先答」推向即時互動。

這是一個多模態模型加可部署系統項目,想解決的不是普通問答,而是「畫面中的關鍵一刻不會等人發問」這個問題。技術報告提到它是 8B vision-first 模型,支援 real-time video-language interaction,並配合 time-aligned interaction data、training recipe 與完整系統,重點放在時間感、主動觸發與持續在線。

如果你想理解它是否適合自己,最容易的測試場景是把 webcam、直播畫面或監控串流接入,觀察它會否在有事件時主動開口,而不是每次都等指令。這種模式較適合直播助理、居家提醒、遠端看護、商務示範,甚至要一邊看影像一邊調用 API 或 agent 的流程。

  • 核心改動是由問答式互動,轉向 watch-and-do 式互動
  • 模型每秒自行決定沉默、回應或 delegation
  • 系統可接駁 ASR、TTS、memory、API 與其他 agent
  • 報告稱可長時間處理連續影片,延遲維持在 sub-second
  • 人工評分比較中,對 Doubao 與 Gemini 的質量與時機掌握都有明顯優勢

創新位不只在模型本身,也在整個開放堆疊一起釋出:模型、數據、訓練方法與部署系統放在同一個項目脈絡,方便研究者與開發者沿原路線延伸。相關模型與組件包括背景大模型、API、agent,以及文中對比的 Doubao、Gemini;若完整開源內容如期提供,這個項目會對即時多模態互動研究有相當高參考價值。

GitHub: https://github.com/jd-opensource/JoyAI-VL-Interaction

項目:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/

Categories: 開源, 字節跳動, 文字轉語音, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, OpenAI, Gemini, API, Video, Image, 工具, IDE, 語音

MiniMax Mavis:多 Agent 協作處理長任務

MiniMax 將 Agent 升級為 Mavis,主打多 Agent 團隊協作。它瞄準長時間、步驟多、需要覆核的工作流程。

Og image

MiniMax 把原有 Agent 升級並命名為 Mavis,重點是加入 Agent Teams,讓多個 Agent 在桌面版同時運行,並以不同角色分工合作。這個方向主要處理單一 Agent 面對長任務時容易同時做執行者與裁判、資料整理與事實核對混在一起的問題。

過去把一個複雜要求直接交給單一 AI assistant,回覆速度可以很快,但當內容需要最新資料、來源整理、格式輸出與結果驗證時,流程便容易失焦。Agent Team 的做法是把任務拆成前台與後台、有驗收、有記憶的工作流;用戶仍然只需輸入一個要求,系統再判斷是否拆解、哪些角色可並行、哪些結果需要覆核。

對一般用戶而言,這項目最易理解的用法,是把它視為一個可分工的 AI 工作團隊。若你要處理長篇內容整理、跨格式輸出,或需要連續跟進的知識工作,Mavis 會比單一 Agent 更合適;如果只是一次性的小任務,官方亦暗示未必需要動用 Agent Team。

  • 支援多個 Agent 並行,適合長時間與複雜任務
  • 可建立不同角色分工,提升整理、驗證與交付流程
  • 用戶只需提供一次指令,系統會自行判斷是否拆解任務
  • 整合 TokenPlan 與 Agent Plan,CLI、API、Agent 共用訂閱與 credits

另一個更新是把 TokenPlan 與 Agent Plan 合併成單一訂閱,涵蓋 CLI、API、Agent,以及 M2.7、music、video、voice 等能力,credits 亦可共享。對已同時訂閱兩個計劃的用戶,官方表示會補送一個月會籍。這次內容未見具體跑分或量化基準,重點更偏向產品工作流與使用體驗的重整。

項目: https://www.minimax.io/blog/minimax-agent-team-long-running-1779893953

Categories: Agentic, AI productions, API, Video, 工具, 線上服務, IDE, MiniMax

VisualClaw:會進化的視覺代理

VisualClaw 不只是接駁模型的工具,還把記憶、技能與影片處理串成可持續改良的代理系統。

VisualClaw icon

現時不少 vision-language agents 主要靠固定提示、整段影片送入模型,或者一次性工具調用去完成任務;作者認為這種 fixed scaffold 容易令延遲、成本同提示長度一齊上升,而且部署後幾乎唔會自己累積經驗。VisualClaw 因而提出一個 modular multimodal agent system,夾在 Claude Code、Codex、OpenClaw 同上游 LLM providers 之間,加入 retrieved memory、skill bank、self-evolution、video processing 同 evaluation hooks。

這個項目屬於框架兼工具型基建,重點唔係再訓練一個新模型,而係幫 Computer-use agents、tool-using vision-language agents 更有效處理影片、工作空間同多輪任務。配套的 VisualClawArena 則是獨立 benchmark/data release,收錄 200 個 scenario,要求代理真正在 workspace 內用影片證據、文件、動態更新與 executable checks 解題,補回一般 video-QA benchmark 對工具使用情境測試不足的缺口。

把它當成 gateway proxy,用熟悉的 OpenAI 或 Anthropic 相容介面接到現有 agent workflow,再逐步打開 skills、memory、video cascade 等模組。對已經在用 Claude Code 或 Codex 的團隊,這種接法尤其實用,因為毋須由零重寫整個代理流程。

  • 核心結構清楚:gateway design 加上 pre/post hooks,方便在提示前後插入技能、記憶與評測。
  • 創新位具體:以 hybrid encoding 處理 streaming video,配合 cascaded gate、keyframe context、hot/cold top-k injection,目標是壓低成本而保留關鍵視覺證據。
  • 會累積經驗:self-evolution 會根據失敗回合與成功記憶更新 skill bank,唔係每次都由同一套靜態提示開始。
  • 評測唔只看答對:VisualClawArena 把多輪問題、影片、workspace 操作同評估輸出綁埋一齊,更接近真實代理任務。

在 4 個 video-QA benchmarks、2 個 VLMs(Gemini 3 Flash、GPT-5.2)上,VisualClaw 對 full-frame upload 的每題 API 成本平均可減 98%,相對 offline uniform 8 frame baseline 亦再降 25.9%,同時多數設定下準確率有提升。到 VisualClawArena,配合 Codex(GPT-5.5)與 Claude Code(Sonnet 4.6)等 backend,macro accuracy 分別提升 2.9% 同 3.2%;如果你關心的是可插拔代理基建、多模態工作流,或者想為 live vision 與影片任務加上可持續進化能力,這個項目比單純模型包裝器更有研究同落地價值。

GitHub: https://github.com/UCSC-VLAA/VisualClaw

項目: https://ucsc-vlaa.github.io/VisualClaw/

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, OpenAI, Gemini, API, Video, 框架, Vibe Coding, 工具, IDE, Mac, 編程, OpenClaw, Anthropic, Skill 技能

Page 3 of 4
1 2 3 4