想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。
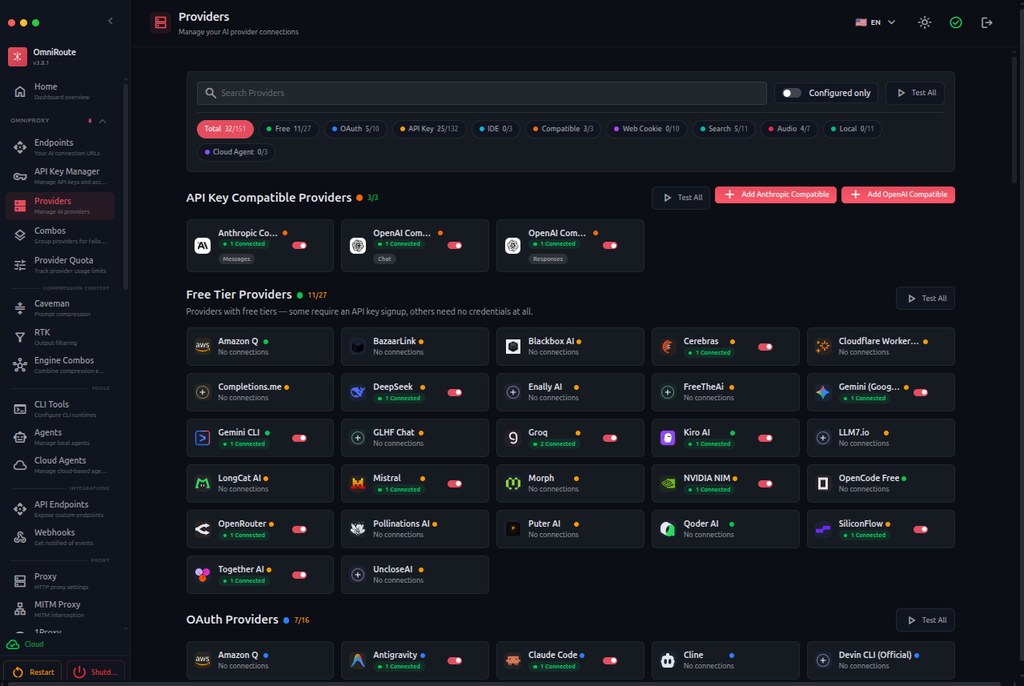
用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。
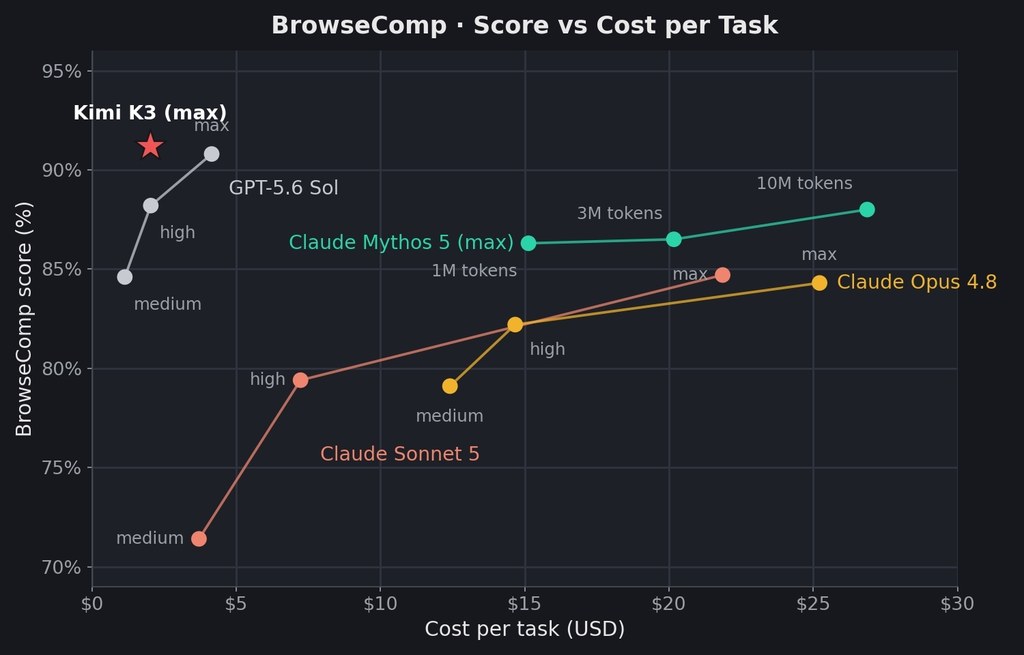
Kimi K3 的定位,不是單靠參數規模取勝,而是想在開源路線上逼近 frontier intelligence。資料提到它有 2.8T parameters,屬於首個 open 3T-class model,整體表現仍落後於 Claude Fable 5 和 GPT 5.6 Sol,但在自家 evaluation suite 內已持續超過其他被測模型,顯示它在開源陣營有明顯競爭力。
技術上,這個模型建基於 Kimi Delta Attention(KDA)同 Attention Residuals(AttnRes),目的是改善資訊在長序列與深層網絡中的流動方式;同時也擴大了 Mixture of Experts(MoE)sparsity。這種做法反映它要處理的核心矛盾:一邊維持超長 context 與多類任務能力,一邊控制推理與訓練效率。
首個 open 3T-class model,規模達 2.8T parameters
原生支援 vision,並提供 1M context window
目標場景包括 long-horizon coding、knowledge work 同 reasoning
採用 Kimi Delta Attention(KDA)、Attention Residuals(AttnRes)與 Mixture of Experts(MoE)
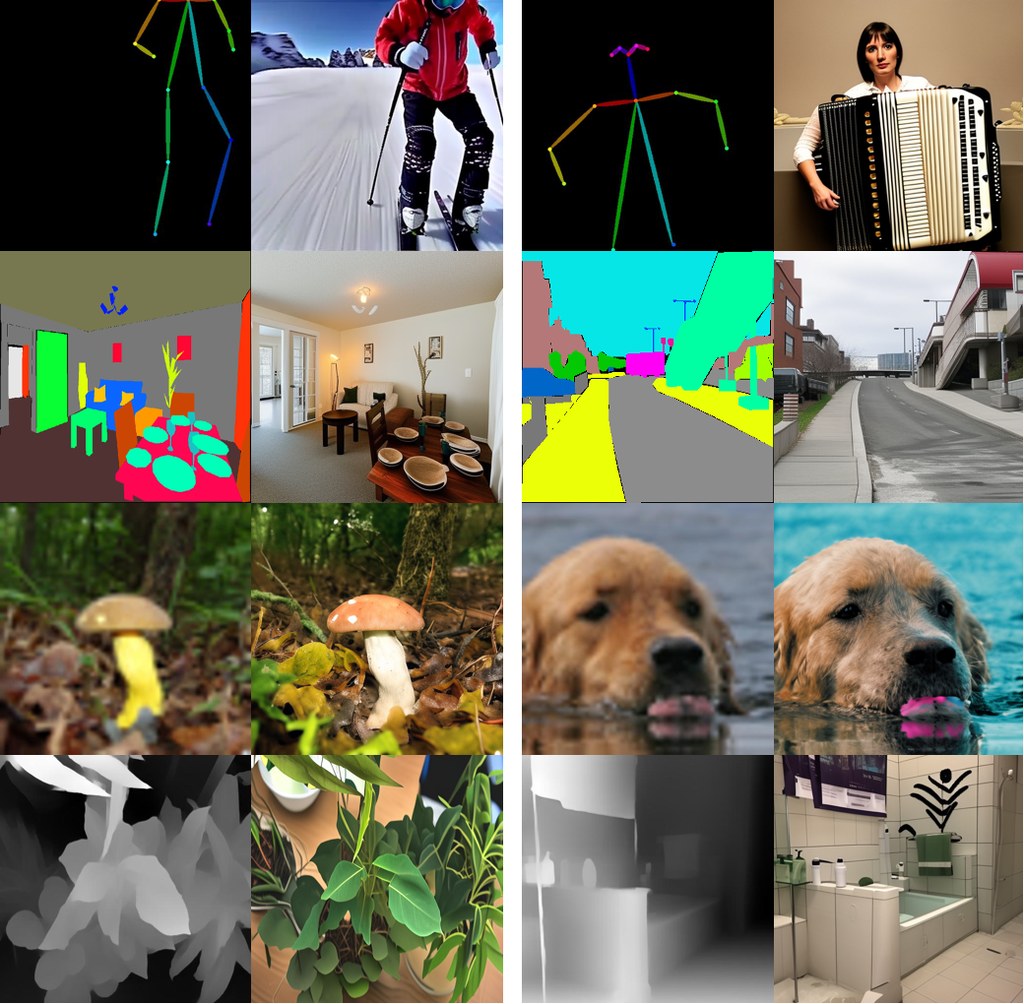
LISA 的核心做法是從側網絡的指定層提取特徵,透過一個輕量級解碼器(decoder)將其投影到分數潛在空間(score latent space),然後計算解碼器輸出與近似似然分數目標之間的距離,作為額外的正則化損失(regularization loss)。這個設計讓側網絡的特徵在條件建模中更加解耦(disentangled),且推理階段無需任何額外計算。