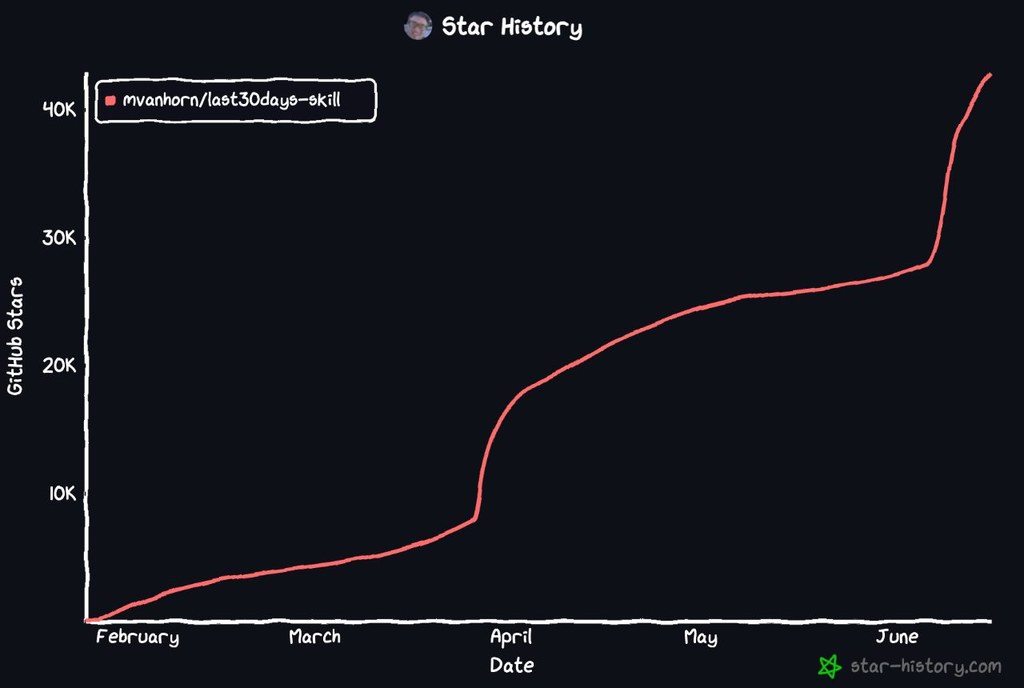
last30days-skill:用人氣做 AI 搜尋

這是一個由 AI agent 驅動的搜尋項目,把多個平台的熱度訊號整合成簡報式結果。重點不在傳統排名,而是看近 30 日有哪些內容真正在被人討論。

Repository image for mvanhorn/last30days-skill

last30days-skill 是一個 Agentic Skill 搜尋工具項目,核心做法不是依賴編輯式排序,而是把 Reddit、YouTube、TikTok、Instagram、Threads、GitHub、HN、Polymarket 等來源的互動訊號交叉比對,整理出近 30 日最受關注的資訊。它要解決的,是同一個主題分散在不同平台、普通搜尋又難以整合的問題。

這個項目的判斷邏輯相當有意思:不是只看網頁是否存在,而是看 upvotes、likes、留言、甚至真金白銀的市場訊號。對想快速了解某人物、產品、議題近期動向的人,這比傳統搜尋更接近「大家最近在講乜」。若只想先試基本能力,公開資料已可直接涵蓋 Reddit comments;再加入 API key,便可逐步打開 TikTok、Instagram、Threads、Pinterest 及 Perplexity Sonar 等來源。

YouTube transcripts 的候選池擴大了三倍,不再偏向音樂影片,較容易抓到訪談、評論與解說內容;YouTube comments 與 TikTok comments 則屬額外選項,因為每段影片都會增加額外查詢成本。這種把免費來源、付費來源與高成本來源分層處理的方式,反映它比較重視訊號品質與成本控制,而不是一味堆資料。

  • 以 AI agent-led search engine 形式整合多平台近期討論
  • 免費可用來源包括 Reddit comments,並附 upvote 數據
  • 可選接入 Perplexity Sonar、TikTok、Instagram、Threads、Pinterest
  • YouTube transcripts 強化了非音樂內容覆蓋範圍
  • 適合研究人物近況、追話題熱度、做市場觀察初步整理

如果你平日會做內容選題、品牌觀察、人物背景搜集,這個項目幾適合放入工作流程。它未必提供嚴格學術式評測,現有資訊也未見標準 benchmark 成績,但從來源設計與成本開關來看,方向相當明確:用多平台真實互動訊號,讓 AI agent 幫你先篩走雜訊。相關能力亦牽涉 Perplexity Sonar、OpenRouter,以及可承載 Agent Skills 的 Claude Code、Codex、Cursor、Copilot、Gemini CLI、OpenClaw 等環境。
GitHub: https://github.com/mvanhorn/last30days-skill

Categories: 開源, Agentic, AI productions, Gemini, API, 工具, IDE, OpenClaw, Anthropic, Skill 技能

ARGAR 直指 AI 審稿可被包裝操控

ARGAR研究一個敏感問題:論文內容不變,只改寫法,AI審稿會否被帶風向。這個項目把問題做成可重複測試的實驗框架。

ARGAR

現時不少 AI reviewer 評測,默認接受論文的摘要、敘事結構與貢獻陳述,並直接輸出分數或意見;ARGAR 指出這種固定範式未必真正在看科學內容,而可能被 presentation-level content 牽動。作者因此提出 ARGAR(Adversarial Repackaging Gaming AI Review),用 adversarial repackaging 把「內容不變、包裝改寫」變成可反覆驗證的測試流程。

這個項目較像一個研究框架加實驗工具,而不只是單一資料集;它要解決的,是 AI reviewer 有沒有被 narrative structure、abstract 與 contribution statements 系統性影響。核心做法是 closed-loop iterative search:每一輪根據 AI reviewer feedback 改 LaTeX 文字與結構,再比較新版與 baseline 的審稿結果,但 scientific content held fixed。

若想測試它的思路,最合適是先看 round N/source、round N/reviews、judge result.json 和 attack log.json。這樣可以直接觀察同一篇論文在科學內容不變下,經過不同包裝後,AI review 怎樣波動,也能看清每一輪修改決策如何形成。

  • 類型定位:研究框架兼工具,用來檢驗 AI reviewer 是否容易被論文包裝影響
  • 方法重點:只改 abstract、framing、contribution statements、narrative structure,不改 scientific content
  • 輸出結構:保留每輪 LaTeX source、review 結果、pairwise judge 比較與跨輪 attack log
  • 適合場景:AI safety、LLM evaluation、學術審稿自動化研究
  • 限制提醒:項目明確反對把結果用於真實投稿操控,定位是 controlled experiments

創新之處在於它不是討論「AI 審稿準不準」的籠統問題,而是把舊範式拆開,專門測 presentation attack 對評分的影響。從儲存庫資料看,這種設計也方便研究者重播整個攻擊過程,比只看最終分數更有分析價值。

性能數字在這份儲存庫摘要未完整展開,因此不宜代作者下結論;不過評測設計本身已很有辨識度,因為它加入 pairwise judge 與多輪 review 作比較。相關模型方面,項目透過 LiteLLM 路由不同 LLM provider,可接 OpenAI、Anthropic、AWS Bedrock 等 reviewer model、attack model 與 judge model,亦配合 ICLR、NeurIPS、ICML 風格的 review generation。

GitHub: https://github.com/xyimatvoid/ARGAR

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, 清華大學, Agentic, AI productions, 模型, OpenAI, 框架, 工具, Content Creator, IDE, 庫, 安全, Anthropic, AGI, Dataset 數據集

Firebase Studio – 雲端 Vibe 編程

Google Firebase Studio 的目標是盡量簡化開發流程,就算你是剛剛開始學寫 App 也不用擔心。只要你有基本了解,Firebase Studio 可以透過 AI 助手 Gemini 幫你寫 Code、Debug 同埋改善效能。完成了之後,無論是全方位的應用程式,抑或 API、後台、前端同埋手機 App,佢都可以幫你自動整合發佈。測試期間,你可以擁有 3 個的免費工作空間。

Google Firebase Studio 的目標是盡量簡化開發流程,就算你是剛剛開始學寫 App 也不用擔心。只要你有基本了解,Firebase Studio 可以透過 AI 助手 Gemini 幫你寫 Code、Debug 同埋改善效能。完成了之後,無論是全方位的應用程式,抑或 API、後台、前端同埋手機 App,佢都可以幫你自動整合發佈。測試期間,你可以擁有 3 個的免費工作空間。

Firebase Studio: 9 Must See Features (FREE to Use)
Categories: Agentic, Gemini, 線上服務, IDE

Page 4 of 4
1 2 3 4