內容圍繞 MCP 與 API 的差異。重點係解釋點解傳統 API 未必適合 AI agents。
內容圍繞 MCP 與 API 的差異。重點係解釋點解傳統 API 未必適合 AI agents。
A2UI 不是聊天模型,而是一套讓 AI agent 產生互動介面的開源格式與函式庫。它主打安全、可跨平台渲染,適合要把 agent 接入產品的人。
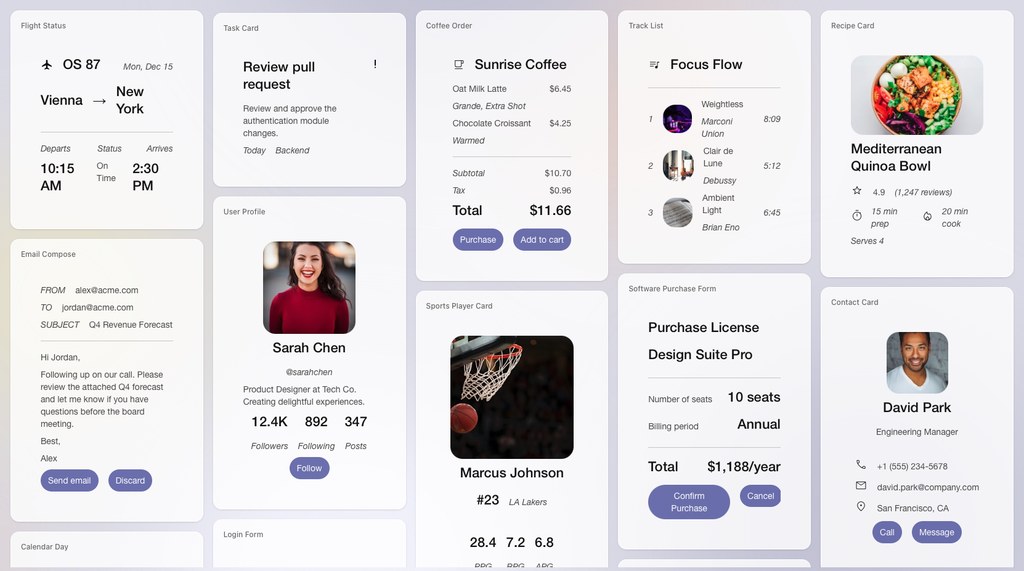
A2UI 是一個開源框架/協定格式項目,核心是讓 AI agent 用宣告式 JSON 產生可更新的互動介面。它要解決的問題很直接:agent 不只回文字,還可以安全地把表單、卡片、按鈕等 UI 交畀前端或原生客戶端渲染。
這個項目的取向,和直接讓 LLM 輸出 HTML、JavaScript,或者在前端執行 agent 生成程式碼很不同。A2UI 把介面描述同實際元件庫分開,client 只會渲染已預先信任的元件 catalog,安全性較高,但代價是自由度受 catalog 和 renderer 能力限制,並非想畫甚麼介面都可以即時做到。
現有資料顯示,A2UI 仍屬 early stage public preview,目前生產版本為 v0.9.1,v1.0 specification 則是 release candidate。部署與理解方式上,它較像一個要接入現有產品的基礎層:agent 端輸出 A2UI JSON,client 端用對應 renderer 轉成 Flutter、Angular、Lit、Web 或其他原生 UI;官方網站有 Quickstart、Client Setup、Agent Development 同 renderer 文件,但這份資料未列出完整安裝流程,亦看不到一鍵接入 OpenClaw、OpenCode、Codex、Hermes Agent、Copilot、Pi 的管理介面整合資訊。
它的優勢,在於增量更新和跨框架可攜性。README 提到 UI 會以扁平元件清單加 ID 關聯表示,這種結構對 LLM 較友善,也方便串流更新;同一份 A2UI payload 理論上可以映射到不同客戶端。相比綁死某一個前端框架的做法,這更適合多端產品、內部工具平台,或者需要跨信任邊界把 agent 能力交到用戶手上的團隊。
重點可概括為:
– 不是模型,而是讓 agent「講 UI」的協定與函式庫
– 核心賣點是安全渲染,避免直接執行 LLM 生成程式碼
– 支援增量更新,較適合串流式互動介面
– 可對接多種前端技術,但前提是要先有 renderer 和元件 catalog
– 文件已見版本演進與示範場景,公開資料未提供明確性能跑分
性能與現有內容較著重設計理念、版本演進與示範,而不是基準測試數字,所以不宜把它理解成追求速度排行榜的項目。較可能受益的是正在做 agent 產品的前端團隊、平台工程團隊,以及需要把資料收集、任務委派、跨端 UI 呈現整合起來的企業應用;相關技術脈絡則包括 AI agents、MCP、Flutter、Angular、Lit、React、SwiftUI,以及 A2A extension。
用最簡單控制流程,講清 AI Agent 點樣反覆調用模型與工具。
這是一段介紹 AI Agent 底層控制流程的教學影片。它主要用來解釋主流 Agent 為何能連續思考、調用工具並完成任務,核心其實是一個簡化版 while 迴圈。
內容重點不是堆砌框架名詞,而是把 Agent Loop 拆成幾個基本步驟:先問模型、按模型要求執行工具、把結果回填,再繼續詢問模型,直到模型不再要求工具。這種講法有助非技術讀者理解,很多看似複雜的 AI Agent,底層控制流未必複雜。
它要處理的問題,是怎樣讓語言模型由一次性回答,變成可逐步執行任務的系統。相比只靠單輪提示詞的做法,Agent Loop 多了狀態延續、工具調用與停止條件,因此更適合查資料、操作 API、分步完成工作等情境。
這類內容特別適合剛接觸 Agentic 系統、MCP、工具代理或自動化工作流的讀者,也適合寫程式的人建立正確心智模型。單靠目前提供的資料,未見具體效能數字、基準測試或完整程式實作細節,因此較適合視為概念導讀,而不是完整技術文件。
呢個項目想解決影片世界模型難以長時間記住物件身份與動作邏輯的問題。重點不在單純出片,而是把鏡頭、物件移動與一致性分開控制。
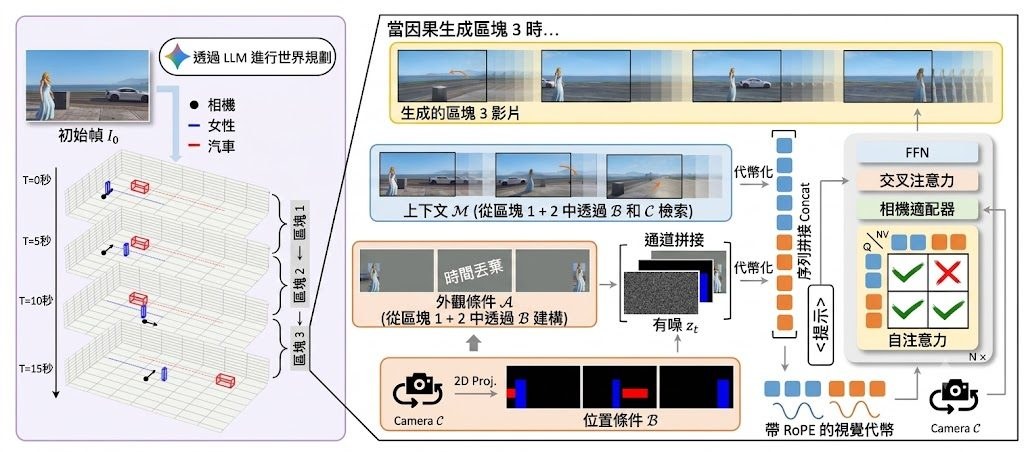
WorldDirector 是一個影片世界模型框架,屬於研究原型兼開源推理項目。它的核心任務,是讓系統在生成長片段影片時,仍能記住動態物件的身份、位置變化與鏡頭運動,減少角色或物件一離開畫面就「變樣」或失去連續性的情況。
它的做法不是直接把所有事情交畀單一生成模型處理,而是先用 Large Language Model(LLM)規劃 3D 物件軌跡與相機路線,再把規劃投影成 2D 控制訊號交畀視覺生成模組。呢種拆分令項目的取向很清晰:先保住語意層面的動作因果,再處理畫面生成,因此比起只靠像素連續性的世界模型,更重視可控性、物件恆常性同長時段一致性。
目前已公開的是完整 inference code 同 WorldDirector-14B 權重,同時亦交代依賴 Torch 2.4.0、FlashAttention,以及 Hugging Face 下載模型的流程。換句話說,現階段較適合已有 GPU 環境、懂得整理 JSON 規劃輸入的人測試;它不是裝完即用的消費級工具,而較接近可重現論文結果的研究型項目。
項目展示的例子集中在人物、車輛、鏡頭切換與長時間事件編排,重點是物件暫時離開視野後再返回,外觀仍能維持穩定。公開資訊提到它支援 persistent dynamic object memory 同 unrestricted viewpoint exploration,但未見提供完整量化基準細節,因此現階段較適合把它理解為一個方向鮮明、控制力強的世界模型方案,而不是已全面驗證的通用產品。
整體來看,WorldDirector 最有價值的地方,在於它把「世界模擬」由單純畫面續寫,推進到可描述、可規劃、可回放的控制流程。對想研究影片 world model、角色一致性與可操控鏡頭生成的人來說,呢個項目值得留意;對只想快速出片的人,現有門檻仍然偏高。
這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。
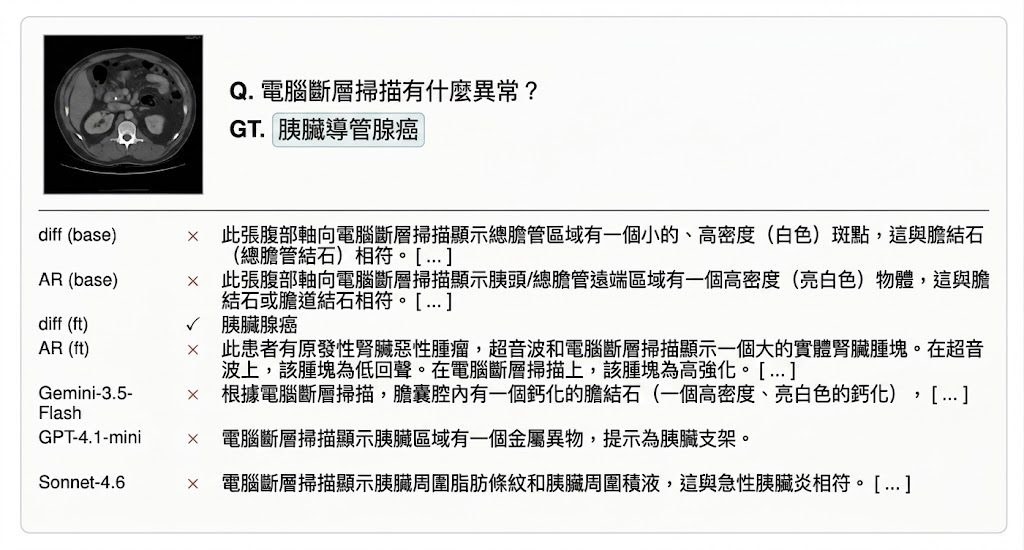
這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。
項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。
部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。
效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。
MoA 讓多個 LLM 平行作答,再交由一個模型整合。它適合較複雜的問題,但成本和延遲都會增加。
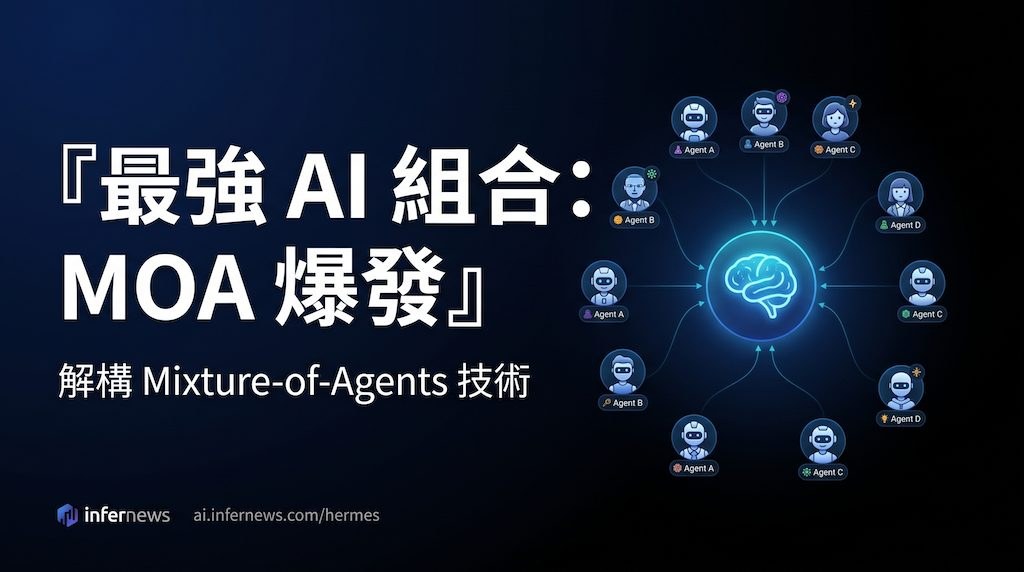
這是 Hermes MoA(Mixture of Agents,混合代理)架構。它的主要用途是讓多個 Large Language Models 同時回答同一條問題,再由一個聚合者整合各自較強的部分,輸出單一答案。
MoA 的重點不在於訓練一個新模型,而是把多個現有模型疊成一個協作流程。文件指出它依靠多樣性、互補性與聚合三個機制運作:不同模型會走出不同推理路徑,彼此可以補足盲點,最後再由較強的模型統整結果。這種做法和只用單一模型相比,目標是提升複雜任務的回答質素。
在 Hermes Agent 內,這個項目提供三種落地方式:shell 腳本、delegate_task 與 Kanban。Shell 版本最直接,做法是先把多個 proposer 的回覆收集起來,再交給 aggregator 讀取並重寫成最終答案,較適合快速驗證流程;另外兩種方式則較適合需要更穩定管理的工作流。
文件亦清楚交代取捨。MoA 的成本大約是 N+1 倍,延遲通常接近最慢 proposer 再加 aggregator 的時間,所以不適合簡單問答;但對需要比較、整合、推理的任務會更有價值。頁面同時提到在 AlpacaEval 2.0 可帶來約 65% lift,而 proposer 數量以 3 至 5 個作為較理想的平衡點。
適合想在現有 LLM 工作流上疊加協作機制的人閱讀,尤其是需要提升答案穩定性、綜合能力或多角度分析的場景。它不是單一模型的介紹,而是一種可直接套用在 Hermes Agent 的編排方法。
MemoBench專門檢查世界生成模型會否在物件離鏡後再出現時「記錯樣」。它用V-D-R流程,把畫質、一致性與語意判斷拆開量度。
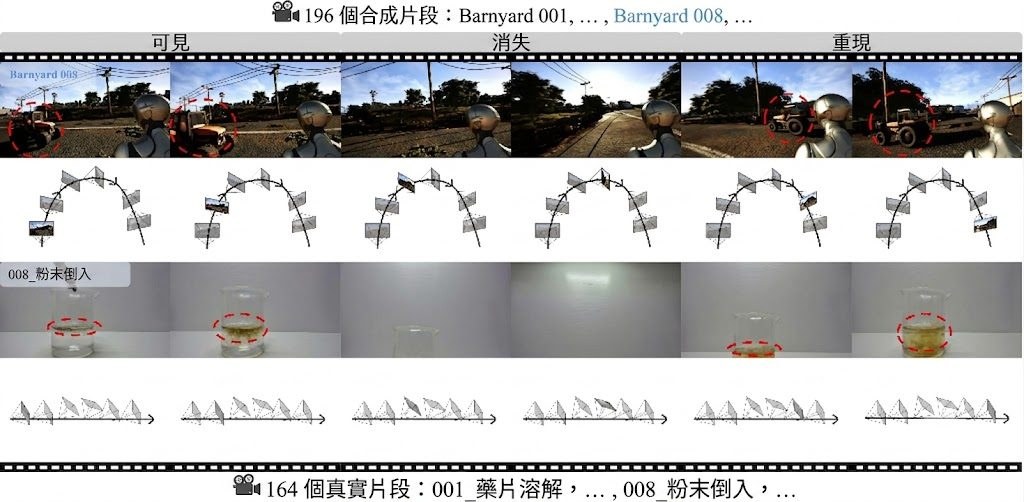
MemoBench 是一個 benchmark,屬於用來評測 world generation models 的數據集加評測工具組。它主要檢查模型在鏡頭移開再回來之後,能否把同一個物件的外觀、位置與狀態準確重建,而不是只生成一段看似流暢的影片。
現有影片生成或世界模型評測,很多時集中在畫質、動作流暢度,或者短時間一致性;作者認為這類範式未必能測到 visual memory。MemoBench 因此用 V-D-R (Visible → Disappeared → Reappear) 結構重組任務:先見到目標物件,再讓它離開視野,最後要求模型在重返視野時保持物件永久性與幾何一致性,這比單看首尾畫面更接近真正的記憶測試。
資料部分有 360 段片,分成 196 段 synthetic 與 164 段 real-world clips,並提供 V-D-R 邊界、GT camera poses、目標物件文字描述、VQA question banks 等配套。部署思路相當清楚:環境以 Linux、Python 3.11、CUDA GPU 為主,評測流程分成自動指標、Object Revisit Score (ORS),以及 VQA 三步,輸入格式是逐格 PNG 圖片;camera controllability 會用到 MapAnything,ORS 會用到 SAM-3。
它和同類 benchmark 的差異,不在於片段數量特別大,而在於把「物件消失後再出現」設成核心壓力測試,並同時覆蓋 synthetic 與真實場景。14 項指標亦不是只量畫面好不好看,還會看 temporal consistency、geometric fidelity、object permanence、camera controllability,以及 VQA-based reasoning,取向明顯偏向診斷模型缺口,而不是只做單一排行榜。
相關模型方面,官方內容提到已基準測試 8 個模型,但這份儲存庫摘要未列出完整名稱,因此較穩妥的理解是:MemoBench 重點不是提供新模型,而是提供一套可重覆的記憶一致性測試基準。對研究 world modeling、影片生成、camera-controlled generation 的團隊尤其有參考價值,因為它能幫你分辨模型是「畫得靚」,還是真正記得之前見過什麼。
這是一個協助科研論文審閱的 agentic AI 框架。它主打找出數學錯誤、檢查實驗與提出修改建議。

這是一篇介紹科研審查系統的論文,核心內容是 Google 提出的 Paper Assistant Tool(PAT) agentic AI framework,而不是可直接下載執行的 Hugging Face 模型。它的主要用途是讀取完整論文手稿,協助檢查理論推導、驗證實驗設計、指出潛在缺陷,並在投稿前提供較深入的審查意見。
頁面沒有提供 base model、參數規模、context length、GGUF 格式、mmproj、量化版本、llama.cpp、Ollama 或 LM Studio 等模型部署資訊,因此不能將它當成一般開源權重模型分析。可確認的是,PAT 採用 agentic workflow 與 inference scaling,不是單次 model call;摘要提到它藉由更長鏈路的推理流程,提升對數學錯誤的召回率。
論文給出的關鍵數字是:在 SPOT benchmark 上,PAT 對數學錯誤的 recall 較 zero-shot 提高 34%。這個結果反映它較適合處理需要多步驗證的學術內容,而非一般聊天問答。作者亦提出 AI 與人類共同參與科研評估的四個遞進層級,重點不是完全取代審稿人,而是減輕前期檢查的認知負擔,同時保留人類最終判斷。
限制亦很清楚:目前看到的是 paper page 與摘要資訊,未見公開模型檔案、推論框架支援、量化檔命名、v2 更新記錄或 chat template 細節。以技術定位來看,PAT 更接近面向科研審查流程的 AI 系統項目,與一般 instruction model 或純 fine-tune 模型的差異,在於它強調多步分析、驗證流程與人類監督整合。
這不是一般醫學問答集,而是用未解研究問題檢驗 AI 代理找證據與引用是否可信。它更重視能否誠實保留不確定性。
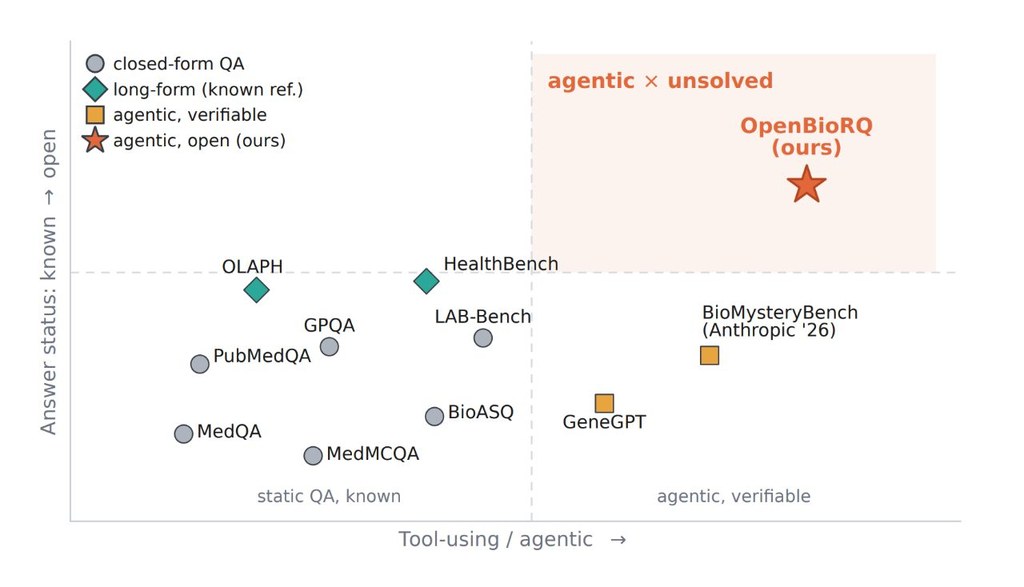
OpenBioRQ 是一個生物醫學基準資料集兼評測流程,聚焦於目前仍未解決的 biomedical / clinical research questions。它要解決的不是背答案能力,而是測試 LLMs 在 agentic tool use 情境下,能否自己找證據、正確引用文獻,並在沒有定論時保持 abstention。
現有 benchmark 多數採用固定答案 key 的問答範式,模型有機會靠記憶或線索反推標準答案,未必真的驗證過來源。OpenBioRQ 直接改用 retrieval-grounded openness:每條問題的 open_status 會用後續論文與 trial records 重新核對;難度也不是作者主觀標示,而是先讓強模型連工具一起跑,再用 pass/fail 結果界定哪些題目真的難。
項目的資料流程相當完整,從 crawl、extract、refine、dedup,到 status verification、contamination audit、agentic-eval 都有清楚分工。README 顯示它以 v3 的 12,553 題為基礎,另有 frozen core 作主要評測集;refine 步驟亦把問題整理成較自足的表述,自含性由 51.6% 提升到 85.4%,這對模型和人工評審都重要。
它和同類做法最大的分別,是把「引用可打開」與「引用真的支持答案」分開看。項目指出 agent citations 超過 99% 可以解析,但約 15.9% 其實連到錯誤論文;同時最難題組出現 agentic collapse,部分模型就算關掉工具,分數變化也不大,反映工具調用未必自然轉化成更好推理。
受惠最大的會是做醫療研究助理、文獻檢索代理、醫學 AI 評測的團隊,而不是想直接拿去做診斷的機構。它目前更像一個研究基建項目:幫人看清楚模型在高不確定、無標準答案場景下,究竟是有能力找證據,還是只是在生成看似合理的回答。
Google Research 與牛津大學團隊推出 FLAT,將影片擴散模型的潛在表示直接解碼為三角形面片,單次前向即可生成幾何準確的 3D 場景。
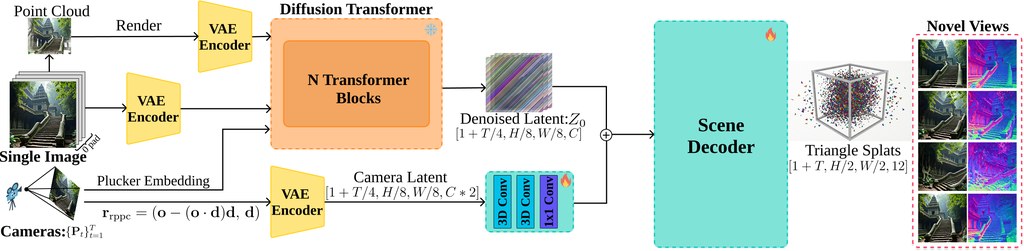
FLAT(Feedforward Latent Triangle Splatting)是一個由 Google Research、牛津大學 Visual Geometry Group 與慕尼黑工業大學共同開發的 3D 場景生成項目,主打從影片擴散模型的潛在表示中,單次前向解碼出幾何準確的三角形面片場景。
開發團隊方面,FLAT 由 Orest Kupyn、Goutam Bhat、Philipp Henzler、Fabian Manhardt、Christian Rupprecht 與 Federico Tombari 等研究員共同發表,核心作者來自 Google Research,並與牛津大學 Visual Geometry Group 及慕尼黑工業大學合作完成。
與常見做法相比,FLAT 跳過了「先生成再優化」的兩階段流程,直接從壓縮的影片擴散潛在特徵預測三角形面片,而非 3D 高斯體素。這項差異讓輸出結果在幾何精度上更貼近真實表面,同時保留視覺品質,並能直接用簡單的三角形渲染器顯示。
重點摘要:
使用方法方面,FLAT 已在 HuggingFace 上發布模型權重,並提供網頁互動示範。讀者可透過 HuggingFace 頁面取得模型,或在官方項目網站(flat-splat.github.io)直接體驗瀏覽器內的互動 Demo,拖曳畫面或使用 WASD 鍵即可在場景中移動視角。
FLAT 適合需要快速生成可匯出 3D 資產的研究人員、開發者及遊戲或圖形相關工作者,尤其在需要幾何準確性與物理交互的場景中表現突出。