PhysCaP 讓機械人用互動摸清物件物理特性

當視覺無法分辨重量或軟硬,PhysCaP會主動安排互動,讓機械人用更少動作完成操作任務。

Og image

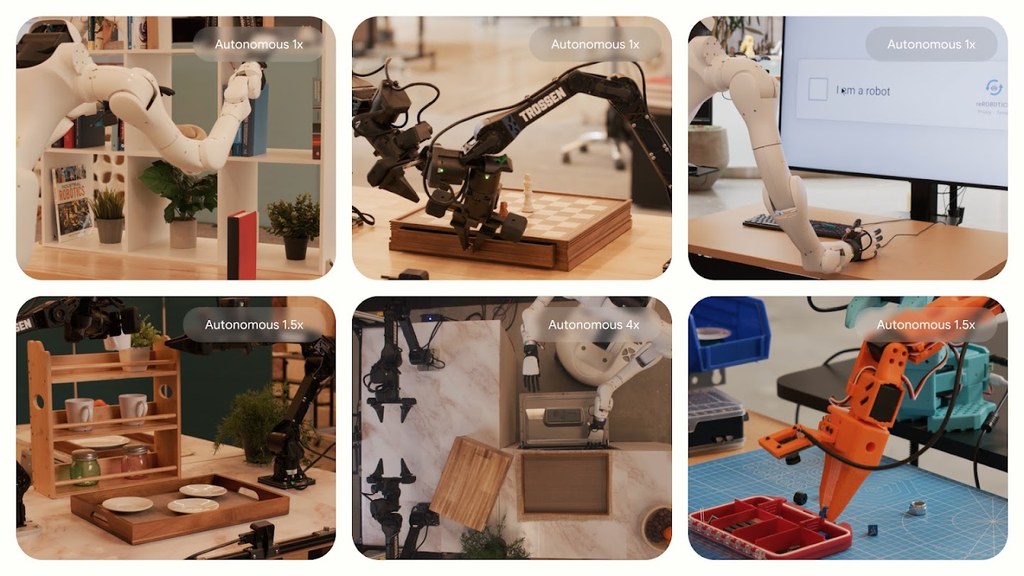
由國立台灣大學、NVIDIA Research、Google DeepMind 及國立陽明交通大學研究人員組成的團隊,推出 PhysCaP,將物理資訊探索加入 Code-as-Policy 機械人代理。

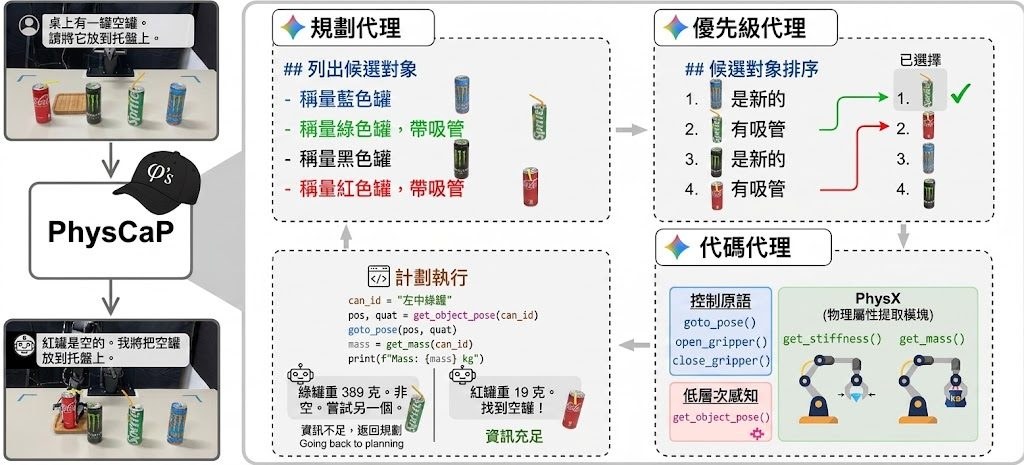
當機械人只靠相機無法分辨哪罐是空的、哪個牛油果已熟,PhysCaP會主動安排提起、夾取等互動,從動作反應推斷隱藏的重量與硬度。這個 physics-informed Code-as-Policy agents 項目,針對被動視覺不足時的機械人操作問題加入主動感知能力。

PhysCaP以雙代理探索框架配合可執行程式碼。Planner先判斷視覺資訊是否足夠,Prioritizer再按預期 information gain 排序互動,過濾不合理或重複的動作,最後呼叫 PhysX(physical property extraction modules)中的 get_mass 和 get_stiffness。

  • 透過 joint-torque 差異及 end-effector Jacobian 估算物件質量
  • 根據 gripper displacement 和 normalized motor effort 分類硬度
  • 無需額外感測硬件,直接利用 robot proprioception
  • 涵蓋找藍色方塊、辨認空罐和挑選熟牛油果
  • 模擬與真實任務中,部分結果達到 9/10 成功率

測試亦包括 LIBERO Empty Can 模擬環境。研究結果指,這種按資訊價值選擇互動的方式,在多項 benchmark 中較被動方法和直接進行互動的方法取得更高任務成功率,同時減少互動次數及執行時間;不過,推斷質量和硬度仍取決於固定提舉軌跡、重複測量及機械人本身的 proprioception。
項目主頁

Categories: Agentic, 模型訓練, Google, NVIDIA, World-Action Model, Robotic, 框架, Dataset 數據集

EnvHarness 讓靜態環境按代理弱點持續進化

EnvHarness 不改動環境內部程式碼,透過可堆疊元件調整任務、規則與觀察,讓代理獲得更有針對性的訓練。

example

Google Cloud AI Research 聯同 Washington University in St. Louis、Google Cloud、University of North Carolina at Chapel Hill 的研究人員,開發了 EnvHarness。這個開源框架處理的是大型語言模型(Large Language Model,LLM)代理面對靜態互動環境時,任務和回饋無法隨能力變化的問題;它保留原有環境及驗證器,改由外加層控制代理所見、可做的行動和起始狀態。

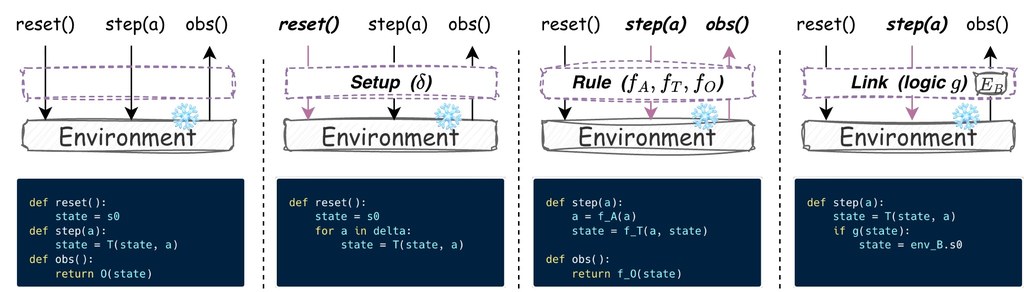
代理在同一批任務上反覆練習,往往會很快解完,環境卻不能因應弱點提供新挑戰。EnvHarness 是一個面向代理學習的開源框架,透過標準 reset/step 介面包裹固定環境,調整代理的起始狀態、可用行動與觀察內容,同時保留原有的成功判定器。

它把控制拆成三類可組合元件:Setup 負責重塑初始狀態,Rule 改變互動規則、行動限制及回饋,Link 則把另一個環境的任務接入目前流程。設計者代理會讀取目標代理的操作軌跡,診斷失誤,再以 Python 寫出元件、測試及修訂,令訓練環境隨代理能力一同調整。

• 不需修改 ALFWorld、WebArena、SWE-bench Verified 等環境的內部程式碼
• 任務與 verifier 保持來源 benchmark 的可信判定
• 元件可自由堆疊,適合針對特定弱點改造互動流程
• 可在項目提供的瀏覽器 Playground 以 Toy24Env 觀察環境狀態與代理視角

在 ALFWorld、WebArena 及 SWE-bench Verified 的 EnvHarness 訓練結果分別達到 68.3、41.6 及 52.6,展示相對基準最高 5.9 個百分點的提升。不過,效果取決於設計者代理能否準確診斷軌跡,以及改寫後的環境是否真的對應目標弱點,並非單靠套上元件就能保證改善。

它的取捨是把環境設計工作轉移到 Setup、Rule、Link 的程式編寫與反覆測試,換來跨 benchmark 重用和較低的環境改造成本。

項目主頁 · GitHub

Categories: 開源, Agentic, Google, Python, Dataset 數據集

[技術文章] Google DeepMind 用機器學習再推低矩陣乘法指數

呢篇研究唔係做新模型產品,而係用現代優化方法改寫數學證明入面最難解的一步。結果把矩陣乘法指數上界再推低少少,但背後代表這種優化已開始反過來幫理論電腦科學。

Hero image preview

由訓練大型模型到即時圖像運算,矩陣乘法都係底層最常見嘅核心操作,所以研究者一直想知道:計算兩個大型矩陣,理論上到底可以快到乜程度。呢篇來自 Google DeepMind 嘅論文,集中處理嘅唔係新硬件或者新程式庫,而係證明矩陣乘法上界時最關鍵、亦最難求解嘅優化問題,最後把矩陣乘法指數 omega(ω)嘅最佳已知上界,由 2.371339 改寫到 ω < 2.371177。

現有做法過去四十年幾乎都建基於 laser method,而最新一輪進展主要依靠 combination loss analysis。作者指出,呢條路線嘅瓶頸唔係概念本身,而係當中需要解一個極大規模、而且屬於 non-convex optimization 嘅問題;參數一多,搜尋空間會急速膨脹,令更高設定難以處理。今次嘅改動,正正係把原本嘅優化問題重新表述,令求解器可以踏入更大嘅設定範圍,再配合以 Jax 實作嘅 gradient descent 與硬件平行化,把原先主流結果使用嘅最大遞迴層級由 ℓ = 3 推進到 ℓ = 4。

呢個差異不只是多試一層咁簡單。作者提到,當 ℓ* 由 3 升到 4,可優化參數數量會由大約 2.5 萬暴增到 700 萬,代表舊有方法難以負擔嘅搜尋空間,作者改用現代機器學習優化技術後開始變得可行。單靠呢套 gradient-based 方法,已經比前一個 state-of-the-art(SOTA)上界再前進約 0.97 × 10^-4;之後再用 AlphaEvolve 進一步改良優化演算法,增幅擴大到約 1.62 × 10^-4。

文章入面最值得技術讀者留意嘅,係佢展示咗一種幾具代表性嘅研究方向:機器學習不只是拿來做預測模型,亦可以直接介入數學與理論電腦科學入面高難度嘅搜尋與證明流程。作者處理嘅核心結構,仍然圍繞 Coppersmith-Winograd tensor、遞迴分解樹、分佈參數同可行解驗證,但真正令結果向前推進嘅關鍵,在於把呢些原本難以手動或傳統數值法有效搜索嘅自由度,交畀較大規模、可平行化嘅優化程序去探索,最後再對得到嘅 omega 上界做嚴格認證。

  • 研究焦點係 combination loss analysis 入面嘅非凸優化問題,唔係推出新應用產品。
  • 作者重新表述優化問題,令求解可以由 ℓ* = 3 擴展到 ℓ* = 4。
  • 以 Jax 配合 gradient descent 與硬件平行化,處理由約 2.5 萬升到 700 萬嘅參數規模。
  • 再用 AlphaEvolve 微調優化演算法,把最新已知上界推到 ω < 2.371177。
  • 呢項成果最適合理解為「用現代優化幫理論證明前進」,而唔係直接改變一般軟件今日可見嘅運算速度。

最受用嘅讀者會係關心理論電腦科學、數值優化、機器學習方法點樣反哺基礎研究嘅人。重點係如何把大型優化程序嵌入 computer-assisted proof,並以嚴格方法確認所得上界。對研究者而言,價值唔止於再減細一個小數位,而係證明咗現代 optimization 同 AlphaEvolve 已經可以成為推進數學界限嘅有效部件。

Paper

Categories: Google

Google DeepMind 把手語 AI 放進用戶手中 涵蓋 30 種 ASL 詞彙

Google DeepMind 將手語識別 AI 整合到日常應用,讓失聰與健聽人士的溝通更自然。

A person signs with one hand while holding a smartphone, demonstrating the Gboard sign-to-text dictation feature.

聾人手語使用者日常面對的最大卡位,是怎樣讓手機或視訊鏡頭直接「讀懂」手語並即時翻譯。Google DeepMind 近期把手語 AI 從實驗室帶到實際產品中,覆蓋約 30 個美式手語(ASL)詞彙並透過 Gemini 模型支援即時回應,目標是讓聾人朋友毋須依賴真人翻譯就能完成基本對話。

這套技術並非單純的影像分類,而是結合姿態估計、語境理解與大型語言模型的能力,把手語動作轉成自然語言並維持對話節奏。比起過去只能辨識孤立詞彙的系統,現時更著重處理連續手語與多輪對話,使翻譯過程貼近真實交流節奏。

DeepMind 同時強調負責任部署,與聾人社區合作收集訓練數據,並透過小規模詞彙起步降低誤譯風險。對於依賴視訊通訊的聾人用戶來說,這項能力讓 Zoom、Meet 等場景下的溝通體驗更貼近健聽人之間的對話節奏。

這項功能適合手語使用者、聾人家屬,以及需要服務聾人客戶的企業。它並非要取代真人翻譯,而是作為日常輕量溝通的輔助工具,降低手語學習門檻並促進更即時的互動。

重點摘要:

  • 覆蓋範圍:支援約 30 個 ASL 詞彙,涵蓋日常問候與基本對話。
  • 技術核心:結合姿態估計與 Gemini 大型語言模型,處理連續手語與上下文。
  • 部署方式:整合到 Google Meet 等視訊應用,即時翻譯手語為文字或語音。
  • 負責任設計:與聾人社區協作訓練數據,從小規模詞彙起步降低誤譯風險。
  • 使用場景:聾人用戶日常視訊通話、聾人家庭成員溝通、企業客服聾人客戶。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, Video, Audio, Robotic, 安全, Skill 技能

JoyAI 把即時串流影片編輯推向 720p

影片逐幀抵達便可按文字指令修改,JoyAI-Video-Edit 以 30.19 FPS 連接即時攝影與生成式編輯。

JoyAI-Video-Edit teaser

直播畫面或上載影片不必等到完整片段準備好,便能一邊輸入自然語言指令、一邊看到修改結果。JoyAI-Video-Edit 屬於開源影片生成及影像處理模型,處理的是影片串流中延遲高、必須預先知道片長,以及難以維持連貫性的編輯流程。

它支援主體修改、局部區域調整、背景替換、風格轉換、動作改變和參考影像引導,適合互動示範、直播效果及需要即時預覽的創作工具。系統以 Multimodal Large Language Model(MLLM)條件編碼器、causal video Variational Autoencoder(VAE)及 16B-parameter Multimodal Diffusion Transformer(MMDiT)組成,逐段處理新抵達的畫面。

同類影片生成方法往往先取得完整影片,再一次過進行離線處理;JoyAI-Video-Edit 改用 autoregressive diffusion,配合 aligned autoregressive distribution matching distillation、long-horizon optimization、bounded Key-Value state(KV-state)inference 和 deployment-oriented scheduling,換取串流速度。不過,這種設計仍要留意長時間輸出可能出現的 temporal drift,而且消費級 GPU 支援仍列為待辦工作。

部署基準在 720×1280 解像度達到 30.19 FPS end-to-end throughput,代表系統已接近互動式影片處理所需的速度,但不能直接等同於所有硬件和指令下都能保持相同表現。Hugging Face 提供 JoyAI-Video-Edit checkpoint,GitHub 同時提供部署程式碼和線上 Demo,較適合具備 GPU 資源、希望整合影片工作流,或研究 Computer Vision 與串流生成的團隊。

  • 即時串流:畫面逐幀處理,不要求預先提供完整影片或固定片長。
  • 指令範圍廣:涵蓋主體、局部、背景、風格、動作及參考影像編輯。
  • 速度指標:720×1280 下達到 30.19 FPS 的完整流程吞吐量。
  • 部署取捨:透過 bounded KV-state inference 控制計算量,但消費級 GPU 支援仍未完成。
  • 適用人群:影片工具開發者、直播創作者及需要即時預覽的研究團隊。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Google, NVIDIA, Video, 蘋果, Dataset 數據集

CADENA 把 3D 網格逐步還原成 CAD 程式

想由3D mesh 反推可編輯 CAD 流程,CADENA 提供了一條幾務實的路。它唔係一次過寫完整程式,而係每步都先執行、再比較幾何差異。

Repository image for zhemdi/cadena

做 3D reverse engineering,最大痛點唔係生成一段似樣代碼,而係生成之後能否真的建出可用、可編輯、而且封閉的幾何。CADENA 屬於模型加推理流程的參考實作,目標是把 3D mesh 重建成 parametric CAD program;它採用 stepwise inference,每次只發出一個 operation,先執行目前前綴,再用目標幾何與已建幾何的差距決定下一步。

這種做法的價值,在於把「一次過輸出整段程式」改成可檢查、可回退的逐步生成。倉庫內的 inference/ 會做 vLLM 服務、per-operation expansion 同 prefix selection,rl/ 則負責 sandboxed prefix rendering 與排序分數;系統只保留能令 IoU 改善的步驟,所以多走幾步不會令結果更差。代價同樣清楚:部署要 Python 3.10+、CUDA GPU、vLLM,同時依賴 OpenCASCADE via CadQuery,環境比一般 Vision-Language 模型推理更重。

模型本身用的是 Qwen2-VL-2B policy,Hugging Face 釋出 sft 與 rl 兩個階段,當中 rl 對應 CADENA-RL。輸入不是單張截圖,而是八個視角拼成一張圖,六個軸向視圖加兩個等角視圖;目標物放在綠色通道,當前已建立幾何放在紅色通道,模型讀到的其實是尚未補齊的殘差。這種設計直接把「下一刀應該補邊度」轉成視覺訊號。

幾個值得留意的重點:
– 倉庫提供完整推理、資料集建立、評分與可視化流程,但不包含用來合成訓練語料的 rule-based program generator。
– cadgen/ 只有 DSL runtime 的執行半部,較適合做還原、測試與基準比較,唔係完整資料生產管線。
– 預設流程會由 mesh 目錄建立 inference dataset,再輸出每一步的程式、輸入圖同 built STL,方便檢查中途錯誤。
– 無效預測會被剔除:建不出來,或者結果不是 watertight,都不算有效答案。
– 評分包含 GMS、IoU、CD,而且結果會按 family 及整體一併報告,避免單一類型零件拉高平均值。

適合研究 CAD reverse engineering、幾何生成、製造前處理,或者想把 mesh 轉回可參數化編輯流程的團隊。現階段最實際的理解方式,是把 CADENA 看成一套偏研究導向、但已經有明確 benchmark、checkpoint 同 rollout 腳本的開源項目;可重現性做得不錯,不過完整訓練資料生成鏈未公開,想延伸到自家資料或重訓流程,仍要補上不少工程工夫。

GitHub · 模型

Categories: 開源, 多模態模型, Qwen, Google, NVIDIA, 框架, 3D, Python, Dataset 數據集

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

Youtube 影片

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

Gemini Robotics 2 想令機械人動作更完整

重點唔止係識睇同識答,而係令機械人連身體控制都更連貫。Gemini Robotics 2 指向的是把感知、推理同動作放入同一條工作流。

CSJxggUnu5m5TfompiXP2z7YLThhUvDn2 kBueCZv6HCEWWefUt WLzM6wxnTV1sTGqBbvmXDnOTB12W18NDr2NgFVXvHKCiTtjfXpyzuOYPJZXlg=w1440

機械人最難處理的,往往不是單一步驟,而是由看見環境、理解指令,到整個身體協調完成動作的連續過程。Gemini Robotics 2 聚焦的正是這個落差,嘗試把 whole body intelligence 帶入機械人,讓系統不只會辨識和規劃,還能更自然地連動身體控制。

Google DeepMind 把它放在 Gemini Robotics 這條 physical AI 路線之下,定位清楚偏向機械人操作與互動。相比只處理螢幕、語言或單一機械臂任務的做法,這個方向更重視整體行為是否連貫,包括感知、推理、用工具與跟環境互動能否接上同一套能力。

對研究機械人、embodied AI 同 VLA 工作流的人來說,這類項目最有參考價值的地方,在於它瞄準真實場景中的協調問題,而不是只展示單點能力。文章提供的內容仍屬簡介層面,未見完整評測細節、量化指標或部署條件,所以現階段較適合當成技術方向觀察,而不是直接當作可落地規格。

  • 把機械人的感知、推理與身體動作放到同一條能力鏈
  • 核心關注點是 whole body intelligence,而不只是語言或視覺理解
  • 屬於 Gemini Robotics 系列,延伸 Google DeepMind 的 physical AI 佈局
  • 現有公開資訊偏介紹性,性能與限制仍有待更多技術資料補充

整體來看,Gemini Robotics 2 反映出機械人模型正在由「識唔識做判斷」走向「能唔能夠完整做完一個動作」。對需要長步驟操作、工具使用與環境互動的場景,這種整合式能力會比單一模組升級更值得留意。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, NanoBanana, Video, VLA, Audio, Robotic, 安全, Skill 技能

Gemini Spark 登陸香港:AI 代你長時間跟進工作

想交低指示後由 AI 繼續處理雜務,Gemini Spark 就是朝這個方向而來。它把電郵、文件、搜尋與排程串連起來,減少你反覆催促。

Og image

最易理解 Gemini Spark 的方式,是把它看成一個會在背景持續運作的 Agentic AI 助手:你先交代目標,它再慢慢把零散工序接起來,處理那些花時間、又不想不停重複提示的工作。Google 已在香港推出這項服務,定位很清楚,就是幫用家把日常行政與資料整理自動化。

它接上的重點,不是單次問答,而是整段工作流。Gemini Spark 運行於 Google 的雲端基礎設施,能原生連接 Workspace 工具,例如 Gmail 和 Docs,毋須另外設定,就可以整理混亂的電郵往來、彙整行業消息、從舊文件抽資料做後續安排,甚至進行網上資料搜集、比較選項與完成預訂。

Google 提到,系統以 tasks、custom skills 和 schedules 這類機制去安排工作,讓用家用自然語言交代規則、例行事項與時間觸發條件,毋須寫程式。另一個分別在於,它不會因為你闔上手提電腦或鎖上手機就停下來,背景流程仍可繼續運作,較適合需要長時間跟進的文書與研究工作。

  • 支援背景持續執行,不用反覆重新提示
  • 可原生連接 Gmail、Docs 等 Workspace 工具
  • 能處理資訊整理、排程準備、網上研究與預訂類工作
  • 高風險動作前會先要求明確同意

控制權仍然留在用家手上。Google 表示,Gemini Spark 會按照用家指示運作,用家可決定何時啟用,以及容許它接觸哪些應用程式;遇到交易或發送電郵等高風險操作,系統亦會先徵求明確授權。現時香港由 Google AI Ultra 訂閱用家率先使用,Google AI Pro 用家的開放時間會在未來數星期逐步擴展。

項目主頁

Categories: Agentic, Google, Gemini, 提示詞, 框架, 香港, 工具, 編程, Skill 技能

Google 開源 GNM Head:更完整的人頭 3D 模型

做人頭 3D 建模時,最麻煩往往唔係外形,而係眼球、牙齒同舌頭呢類細節。GNM Head 把呢些結構一併納入,定位明顯唔止係傳統面部 3DMM。

GNM Teaser Image

只做臉部外殼,很多時已經唔夠用;去到動畫、重建同生成式影像控制,眼球、口腔同頭部姿態一旦分離得唔好,效果就會即刻穿崩。google/GNM 目前先開放的 GNM Head,屬於3D parametric statistical human model 項目,焦點是用更完整的人頭幾何表示,處理傳統 3D Morphable Models (3DMMs) 對內部 anatomy 覆蓋不足的問題。

這個項目的取向很鮮明:不只是追求一個可調參的人臉網格,而是把 head、face、neck、eyeballs、teeth、tongue 放進同一個生成式人體測量框架。作者在技術報告指出,現有公開模型多數只覆蓋外部幾何,亦容易受限於低保真掃描資料;GNM 則結合高解析 3D scans 與 anatomy-specific artist-made samples,並加入 ocular 同 intra-oral specialized sub-models,目的就是改善幾何品質同可控性之間的取捨。

現有儲存庫較像一個生態系入口,而唔係即開即用的單一應用程式。README 清楚列出 GNM Head 已提供 NumPy、JAX、PyTorch、TensorFlow 多後端支援,亦有 Linux、macOS、Windows 的 CI;但目前公開資訊以模型與技術報告為主,未見到很完整的產品化操作流程說明,所以較適合研究、角色生成、數碼人、3D 視覺或生成式影像控制團隊按其子目錄文件逐步接入。

  • 補足傳統 3DMM 常見缺口:不只外形,連眼球、牙齒、舌頭都可控
  • GNM Head 強調 identity、expressions、head pose 的 disentangled control
  • 同時支援 NumPy、JAX、PyTorch、TensorFlow,方便接去不同研究流程
  • 技術報告聲稱在 fitting target 3D face scans 達到 SotA 表現,但具體指標仍要回看原報告

它最吸引人的地方,在於把「可生成、可擬合、可作條件控制」三條路線拉到同一個模型家族內。現階段公開內容仍以 GNM Ecosystem 的起步版本為主,想拿來做完整 production pipeline,仍要自己判斷與現有重建、動畫或生成系統的整合成本;但作為高保真人頭 3DMM 的新基礎,這個項目的研究價值同延展空間都相當高。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Google, TensorFlow, Mac, 3D, Linux, Python, 語音, Dataset 數據集

Page 4 of 9
1 2 3 4 5 6 … 9