NotebookLM 改名 Gemini Notebook

想整理資料、寫筆記又怕內容散亂,Gemini Notebook 把熟悉的 NotebookLM 保留下來,再加深同 Google 生態整合。

Og image

做研究、整理文件同準備報告時,最麻煩往往唔係搵資料,而係點樣喺一堆來源之中保持脈絡清楚。Gemini Notebook 由 NotebookLM 更名而來,定位仍然係獨立使用的筆記與研究助手,但重點放在同 Google 服務有更深整合,並加入 secure cloud computer,令資料處理方式更貼近雲端工作流。

對一般用家而言,呢次更新最直接的改變唔係功能名稱,而係使用體驗更靠近 Gemini 系列產品。你可以把它理解成原本 NotebookLM 的延伸版本:保留原有獨立產品形態,同時更容易接上 Google 生態中的內容、帳戶與服務,適合需要長時間整理知識、追蹤文件脈絡的人。

  • 由 NotebookLM 更名為 Gemini Notebook
  • 產品仍然獨立存在,唔係單純併入另一個介面
  • 與 Google 生態整合更深,協作路徑更順
  • 加入 secure cloud computer,強調雲端處理與安全性

對常用 Google 工具做學習、研究、內容整理的人來講,呢個方向比單純改名更有意思,因為它指向的是更完整的一站式知識工作流程。

項目主頁

Categories: Google, Gemini, 安全

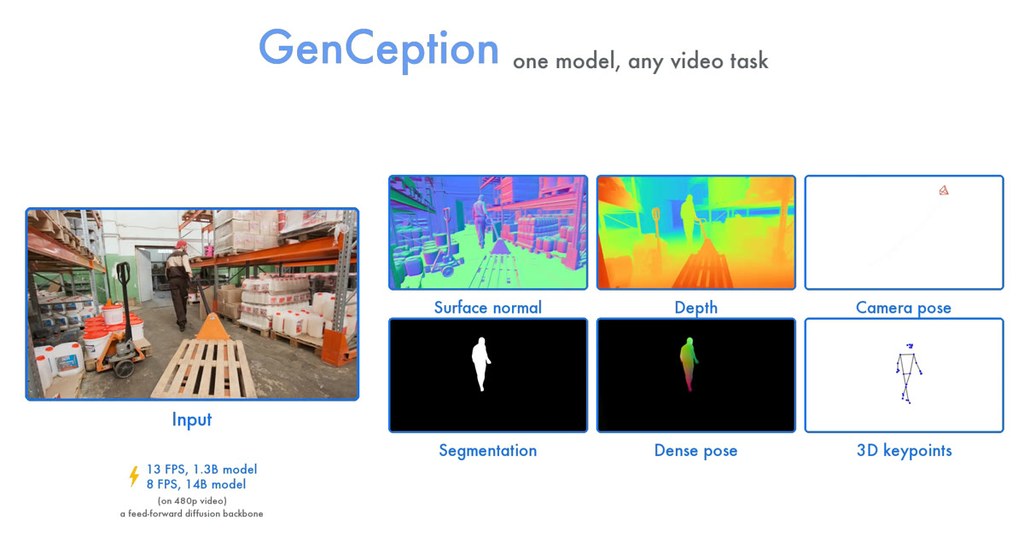
GenCeption 單一模型多種視覺任務

同一個模型就想處理深度、分割、姿態同關鍵點。GenCeption 把影片生成預訓練轉成通用視覺能力,方向相當清晰。

Og image

做影像理解時,很多人最頭痛的不是單一任務做唔到,而是每做一種任務就要換一套模型。GenCeption 屬於通用視覺模型,目標是把深度估計、法線、相機姿態、分割、2D/3D 關鍵點甚至 4D grounding 放入同一個流程,並且用文字指令控制輸出。

它處理的核心問題,是電腦視覺長期依賴任務專用模型,工作流容易分散、訓練與部署成本亦高。GenCeption 的做法,是先用 video generative diffusion model 做預訓練,吸收空間與時間上的 world priors,以及原生的 vision-language alignment,再經過 multi-task post-training,把原本偏生成式、多步驟的骨幹,改造成單步 feed-forward 推理模型。

這種路線跟常見做法最大分別,在於它不是為每個任務各自砌一個模型,而是用單一、task-agnostic architecture 應付 dense 與 sparse vision tasks。資料上亦以 synthetic data 為主,重點放在學習效率、sim-to-real transfer,以及遇到 out-of-distribution 物件類別時的泛化能力。

  • 支援多種視覺任務,包含 depth、surface normal、camera pose、segmentation、2D/3D keypoint prediction
  • 透過文字指令切換任務,保持同一模型介面
  • 把影片生成預訓練轉成 feed-forward 視覺推理,而不是停留在多步生成流程
  • 官方描述指它在多個任務上可與專用 SOTA 模型競爭,對比對象包括 DepthAnything3、D4RT、VGGT-Ω、SAM3、Sapiens、DAVID

對研究多模態模型、通用機械視覺,或者想整合複數感知任務的人來說,GenCeption 值得留意。現時公開內容仍以研究展示為主,Code 亦標示為 TBA,所以較適合先理解方法方向與能力邊界,再觀察後續開源與可重現程度。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Google, Video, 影像處理, 3D

ABot-World 把互動世界模型帶上桌面 GPU

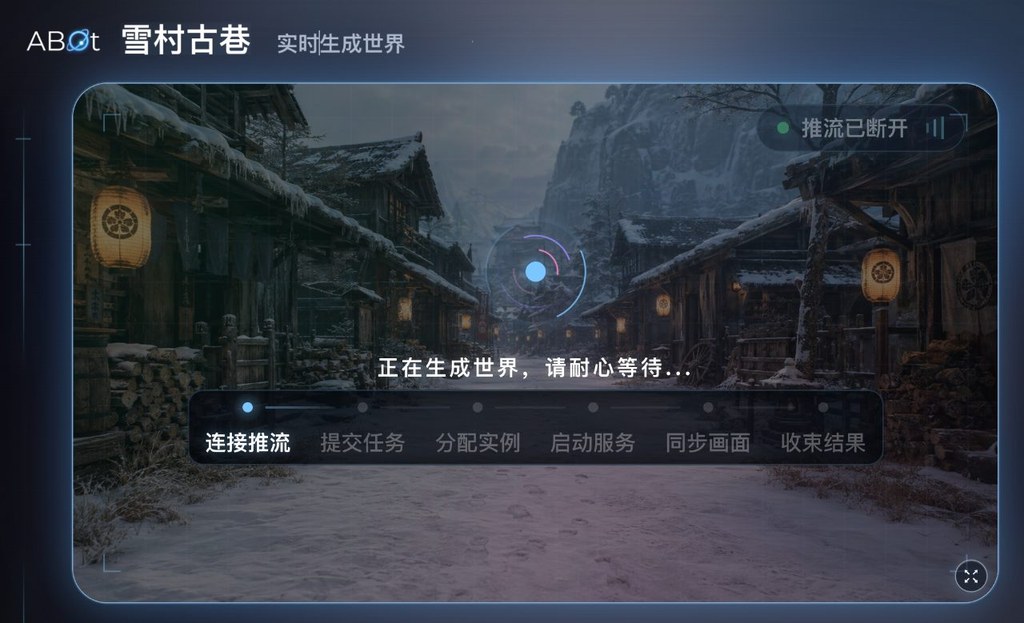
ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

[技術文章] Gemma 4:更快更慳算力的多模態開放模型

Gemma 4 想解決的,不只是模型夠唔夠大,而是點樣同時兼顧推理、多模態同部署效率。你可以把它理解成一組更貼近開發與裝置落地需要的 Gemma 新世代模型。

Hero image preview

Google 正式發佈 Gemma 4 技術報告文章:

當模型要同時處理文字、圖片同音訊,常見做法多數靠獨立 encoder 加上大型語言模型組合;能力雖然完整,但記憶體佔用、推理速度同長上下文成本都容易變重。Gemma 4 Technical Report 針對的正是呢個矛盾:唔只追求更強表現,亦想把多模態理解、推理能力同計算效率放到同一條路線上處理。

Gemma 4 屬於 open-weight、natively multimodal language models,涵蓋 dense 同 Mixture-of-Experts(MoE)架構,規模由 2.3B 到 31B。報告最值得留意的對比,在於作者唔再只沿用「更大模型加外掛模組」呢種固定範式,而是加入 thinking mode,令模型先產生 reasoning trace 再回答;同時用長上下文優化、KV cache sharing,以及在 12B 版本引入 unified, encoder-free architecture,把 raw audio 同 image patches 直接投影到 LLM embedding space。

呢種設計帶來的好處幾實際:一方面,長上下文下的記憶體壓力有機會減輕,報告提到 global KV cache footprint 最多可減 37.5%;另一方面,模型亦提供用 quantization-aware training(QAT)訓練的量化版本,盡量在不明顯犧牲品質下減少參數記憶體佔用同延遲。另有 autoregressive multi-token prediction(MTP)drafter head,配合 speculative decoding 提升解碼速度。

  • 支援文字、圖片、音訊,多個型號覆蓋不同硬件需求
  • 以 thinking mode 加強數學、編程等重推理任務
  • 透過 p-RoPE、KV cache sharing 等方法改善長上下文效率
  • 12B 型號採用 encoder-free 路線,減少獨立 encoder 帶來的記憶體碎片化

性能方面,報告指 Gemma 4 在 STEM、多模態同長上下文 benchmark 有明顯進步,亦在 Arena 等 human-rated tasks 接近更大型的 frontier open models。原始資料未提供安裝步驟或完整使用流程,但已清楚交代模型系列的核心取向:用較可控的成本,換取更接近前沿水準的多模態推理能力,並以 Apache 2.0 授權開放。

Paper

Categories: Embedding, 模型, 多模態模型, 模型訓練, Google, Gemini, Image, Audio, Dataset 數據集


Google A2UI 想讓 AI Agent 直接講出介面

A2UI 不是聊天模型,而是一套讓 AI agent 產生互動介面的開源格式與函式庫。它主打安全、可跨平台渲染,適合要把 agent 接入產品的人。

Gallery of A2UI components

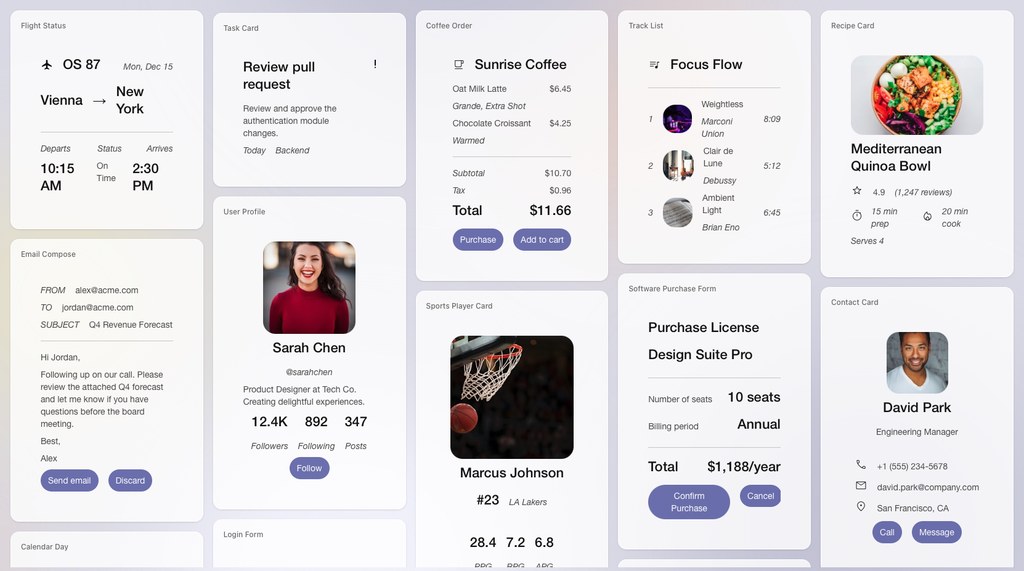
A2UI 是一個開源框架/協定格式項目,核心是讓 AI agent 用宣告式 JSON 產生可更新的互動介面。它要解決的問題很直接:agent 不只回文字,還可以安全地把表單、卡片、按鈕等 UI 交畀前端或原生客戶端渲染。

這個項目的取向,和直接讓 LLM 輸出 HTML、JavaScript,或者在前端執行 agent 生成程式碼很不同。A2UI 把介面描述同實際元件庫分開,client 只會渲染已預先信任的元件 catalog,安全性較高,但代價是自由度受 catalog 和 renderer 能力限制,並非想畫甚麼介面都可以即時做到。

現有資料顯示,A2UI 仍屬 early stage public preview,目前生產版本為 v0.9.1,v1.0 specification 則是 release candidate。部署與理解方式上,它較像一個要接入現有產品的基礎層:agent 端輸出 A2UI JSON,client 端用對應 renderer 轉成 Flutter、Angular、Lit、Web 或其他原生 UI;官方網站有 Quickstart、Client Setup、Agent Development 同 renderer 文件,但這份資料未列出完整安裝流程,亦看不到一鍵接入 OpenClaw、OpenCode、Codex、Hermes Agent、Copilot、Pi 的管理介面整合資訊。

它的優勢,在於增量更新和跨框架可攜性。README 提到 UI 會以扁平元件清單加 ID 關聯表示,這種結構對 LLM 較友善,也方便串流更新;同一份 A2UI payload 理論上可以映射到不同客戶端。相比綁死某一個前端框架的做法,這更適合多端產品、內部工具平台,或者需要跨信任邊界把 agent 能力交到用戶手上的團隊。

重點可概括為:
– 不是模型,而是讓 agent「講 UI」的協定與函式庫
– 核心賣點是安全渲染,避免直接執行 LLM 生成程式碼
– 支援增量更新,較適合串流式互動介面
– 可對接多種前端技術,但前提是要先有 renderer 和元件 catalog
– 文件已見版本演進與示範場景,公開資料未提供明確性能跑分

性能與現有內容較著重設計理念、版本演進與示範,而不是基準測試數字,所以不宜把它理解成追求速度排行榜的項目。較可能受益的是正在做 agent 產品的前端團隊、平台工程團隊,以及需要把資料收集、任務委派、跨端 UI 呈現整合起來的企業應用;相關技術脈絡則包括 AI agents、MCP、Flutter、Angular、Lit、React、SwiftUI,以及 A2A extension。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Google, 框架, OpenClaw

拆解 AI Agent Loop 核心運作

用最簡單控制流程,講清 AI Agent 點樣反覆調用模型與工具。

Og image

這是一段介紹 AI Agent 底層控制流程的教學影片。它主要用來解釋主流 Agent 為何能連續思考、調用工具並完成任務,核心其實是一個簡化版 while 迴圈。

內容重點不是堆砌框架名詞,而是把 Agent Loop 拆成幾個基本步驟:先問模型、按模型要求執行工具、把結果回填,再繼續詢問模型,直到模型不再要求工具。這種講法有助非技術讀者理解,很多看似複雜的 AI Agent,底層控制流未必複雜。

它要處理的問題,是怎樣讓語言模型由一次性回答,變成可逐步執行任務的系統。相比只靠單輪提示詞的做法,Agent Loop 多了狀態延續、工具調用與停止條件,因此更適合查資料、操作 API、分步完成工作等情境。

  • 核心概念:Agent Loop 可視為模型與工具之間的反覆回合
  • 主要流程:模型決定下一步,系統執行工具,再把結果交回模型
  • 關鍵價值:把複雜 Agent 拆成可理解、可實作的最小控制單位
  • 適用情境:想學 AI Agent、工具調用、任務自動化流程的人最受用

這類內容特別適合剛接觸 Agentic 系統、MCP、工具代理或自動化工作流的讀者,也適合寫程式的人建立正確心智模型。單靠目前提供的資料,未見具體效能數字、基準測試或完整程式實作細節,因此較適合視為概念導讀,而不是完整技術文件。

項目主頁

Categories: Agentic, MCP, Google, API, 框架, 安全

WorldDirector 14B:可控影片世界模型點樣做長時記憶

呢個項目想解決影片世界模型難以長時間記住物件身份與動作邏輯的問題。重點不在單純出片,而是把鏡頭、物件移動與一致性分開控制。

Repository image for pPetrichor/WorldDirector

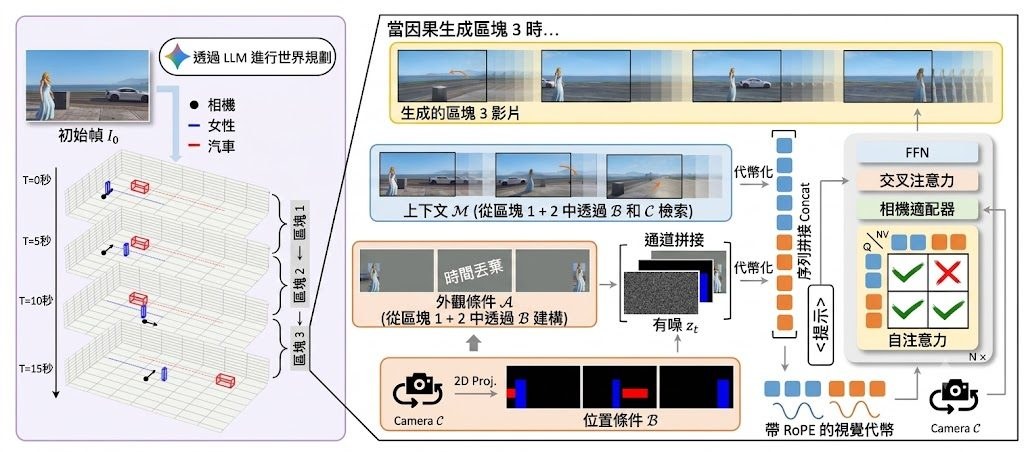
WorldDirector 是一個影片世界模型框架,屬於研究原型兼開源推理項目。它的核心任務,是讓系統在生成長片段影片時,仍能記住動態物件的身份、位置變化與鏡頭運動,減少角色或物件一離開畫面就「變樣」或失去連續性的情況。

它的做法不是直接把所有事情交畀單一生成模型處理,而是先用 Large Language Model(LLM)規劃 3D 物件軌跡與相機路線,再把規劃投影成 2D 控制訊號交畀視覺生成模組。呢種拆分令項目的取向很清晰:先保住語意層面的動作因果,再處理畫面生成,因此比起只靠像素連續性的世界模型,更重視可控性、物件恆常性同長時段一致性。

目前已公開的是完整 inference code 同 WorldDirector-14B 權重,同時亦交代依賴 Torch 2.4.0、FlashAttention,以及 Hugging Face 下載模型的流程。換句話說,現階段較適合已有 GPU 環境、懂得整理 JSON 規劃輸入的人測試;它不是裝完即用的消費級工具,而較接近可重現論文結果的研究型項目。

項目展示的例子集中在人物、車輛、鏡頭切換與長時間事件編排,重點是物件暫時離開視野後再返回,外觀仍能維持穩定。公開資訊提到它支援 persistent dynamic object memory 同 unrestricted viewpoint exploration,但未見提供完整量化基準細節,因此現階段較適合把它理解為一個方向鮮明、控制力強的世界模型方案,而不是已全面驗證的通用產品。

  • 類型定位:影片世界模型框架,主打可控生成與長時記憶
  • 主要差異:把運動規劃同視覺生成拆開,先處理 3D 語意軌跡
  • 較適合情境:研究團隊、影片生成工作流、需要鏡頭與角色一致性的實驗
  • 部署理解:需先配置依賴、下載 WorldDirector-14B,並準備符合格式的 JSON 計劃輸入
  • 相關模型:WorldDirector-14B;流程中亦依賴 Large Language Model(LLM)參與動作與鏡頭規劃

整體來看,WorldDirector 最有價值的地方,在於它把「世界模擬」由單純畫面續寫,推進到可描述、可規劃、可回放的控制流程。對想研究影片 world model、角色一致性與可操控鏡頭生成的人來說,呢個項目值得留意;對只想快速出片的人,現有門檻仍然偏高。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 世界模型, Google, NVIDIA, 3D, 蘋果

discrete_diffusion_RRG:離散擴散模型點樣寫胸肺 X 光報告

這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。

Repository image for mxvp/discrete_diffusion_RRG

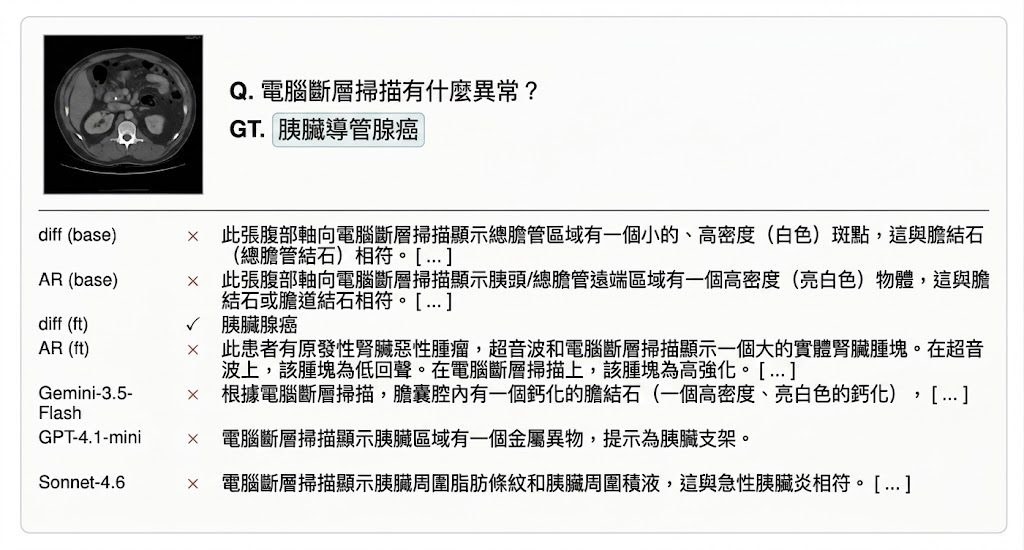
這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。
項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。

部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。

效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。

  • 類型上,它較接近研究原型加評測程式碼,不是即裝即用的臨床軟件。
  • 主要資料來源包括 VQA-RAD、SLAKE、VQA-Med 與 MIMIC-CXR。
  • 相關模型包括 DiffusionGemma-26BGemma-4-26B,並以 LoRA 方式微調。
  • any-order infill 是最有辨識度的能力,適合先固定部分報告內容,再由模型補全其餘位置。
  • 適合需要比較生成範式、研究 radiology report drafting,或想驗證 discrete diffusion 在醫療場景表現的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, Google, Gemini, API, Image, Medical醫學, Dataset 數據集

Page 3 of 6
1 2 3 4 5 6