Kimi K3.1 Pro:開放權重 1M 上下文支援長鏈路代理

完整 model weights 預定於 11 月 4 日釋出。1M-token 上下文支援編程與長鏈路代理,Kimi K3.1 Pro 亦延伸至 3D 創作及金融研究。

Og image

面對超長文件、終端機任務和多步驟研究,Kimi K3.1 Pro 以 1M-token context window 支援長鏈路代理工作,並把 coding、3D creation 與 financial research 放進 3T-class open-weight model。它是 Kimi K3 的 post-trained 版本。

訓練加入更大 post-training compute,在數百個下游領域進行 joint reinforcement learning(joint RL);RL framework、long-context inference、sandbox infrastructure 及 rollout scheduling 亦一併優化,目標是令能力提升更穩定。

  • 長上下文:1M-token context window,適合長文件及多步驟工作。
  • 代理場景:涵蓋 coding、3D creation 及 financial research。
  • 速度選項:Kimi K3.1 Pro Highspeed 標稱快 2 至 3 倍。
  • 權重安排:完整 model weights 預定於 11 月 4 日釋出。

Terminal-Bench 4.0 以資源受限終端機任務和嚴格測試評估 coding agents;K3.1 Pro 得分 65.7%,高於 GPT-6 Astra 的 58.2%,接近 Claude Opus 5.5 的 66.4%,可作為編程代理場景的參考。

模型可於 Kimi Work、Kimi Code 及 Kimi API 使用。
項目主頁

Categories: Agentic, 模型, 模型訓練, API, Image, 框架, Vibe Coding, 3D, Python, 編程, Anthropic, Kimi, 任何模型, 強化學習

FilmFlow: 虛擬電影攝影機代理

FilmFlow 讓創作者用文字指示或參考影片,為 3D 場景生成鏡頭移動。它會結合場景理解與渲染後的視覺回饋,逐步修整鏡頭位置、方向和構圖。

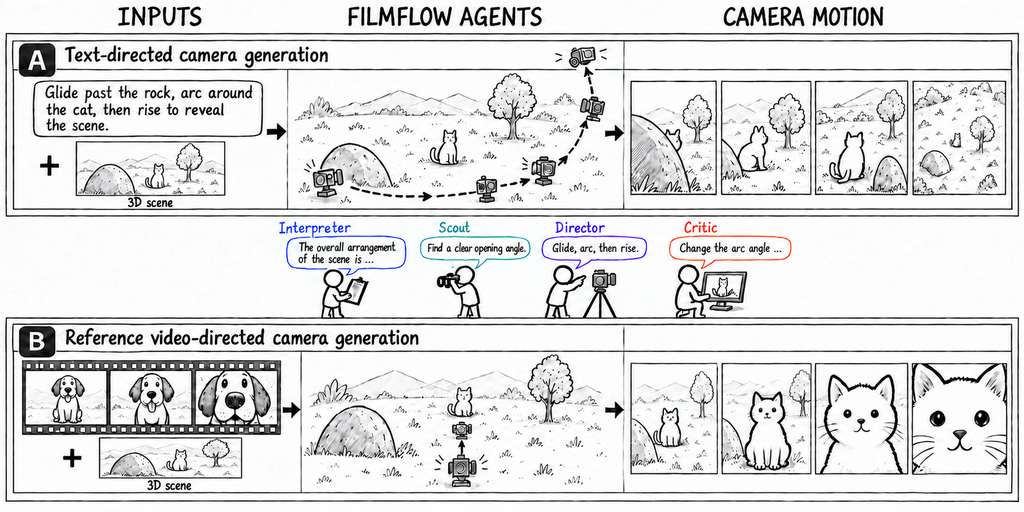
FilmFlow accepts text or a reference video and a 3D scene. Interpreter, Scout, Director, and Critic agents refine camera motion through visual feedback.

想為 3D 場景安排推鏡、環繞或特定構圖,FilmFlow 可將文字指示轉成可執行的鏡頭軌跡,也能把參考影片中的運鏡轉移到另一個場景。這套電影攝影代理系統面向動態 3D 環境,處理的是如何把拍攝意圖落實成有時間安排、能在場景中執行的鏡頭動作。

FilmFlow 由四個代理協作:Interpreter 理解場景並整理鏡頭意圖,Scout 尋找合適的起始視點,Director 安排鏡頭操作及其時間和參數,Critic 則檢視渲染結果並提供修正方向。Director 可同時組合多項基本操作,控制鏡頭平移、旋轉和取景;整個流程會根據畫面回饋反覆調整,而非只輸出一段抽象描述。

兩種輸入方式適合不同工作流程:文字導向生成讓創作者直接描述鏡頭動作與構圖要求;參考影片導向生成則適合借用既有片段的運鏡,並套用到另一個 3D 場景。這可用於虛擬場景分鏡、動畫預演及 3D 鏡頭設計,但生成效果仍取決於指示能否表達清楚,以及場景是否提供所需的視覺條件。

研究團隊同時推出 CinemaBench,涵蓋 150 個 Blender 場景、750 項文字導向任務和 60 段參考影片,用來評估文字導向與影片導向的鏡頭生成。提供的資料沒有列出基準測試成績,也未交代安裝或使用流程,因此目前可確認的是系統設計與評估集規模,不能據此判斷其性能表現。

  • 支援文字指示與參考影片兩種鏡頭生成方式。
  • 以四個代理分工處理場景理解、起始視點、鏡頭規劃和畫面檢視。
  • 可組合平移、旋轉與取景操作,並以渲染結果反覆修整。
  • 適合 3D 場景的鏡頭設計、分鏡及動畫預演。
  • CinemaBench 收錄 150 個 Blender 場景、750 項文字任務及 60 段參考影片。

項目主頁

Categories: 開源, Agentic, AI productions, Video, 框架, Content Creator, 3D, 動畫

RouteWeaver:先選工作方式,再決定呼叫哪些模型

同一個問題未必適合只問一次、逐步追問或交由多個角色協作。RouteWeaver 把「如何組織模型呼叫」也交給路由策略判斷,並以成本回饋約束選擇。

RouteWeaver logo

遇上簡單查詢,多輪推理可能徒增成本;碰到程式或需要拆解的任務,只呼叫一次模型又可能不夠。RouteWeaver 是一個大型語言模型路由框架,讓單一策略先選擇單輪、多輪或 agentic 執行模式,再安排工作模型處理子問題,嘗試同時照顧答案品質與呼叫成本。

路由策略採用 Qwen3-4B-Instruct-2507,並在六個凍結的工作模型之間分配任務。所有模式共用一套行動格式:單輪只呼叫一次;多輪會按前一次觀察結果作出兩至四次連續呼叫;agentic 模式則可在最多八次呼叫中,以角色和參照關係組織多層協作。工作模型的輸出只作為策略的上下文,不會直接接受梯度更新。

訓練方法 COMET-GRPO(COordinated Mode–Execution Training)分開比較模式選擇和模式內執行,避免只看整段任務的獎勵時,難以判斷失誤源於選錯模式,還是執行不佳。漸進式探索會先由外部指定模式,待各模式累積執行經驗後,才逐步交由策略自行選擇;另一項獎勵則把成本納入考量,令路由器不只追求答案表現。

這套做法適合需要按任務難度調整模型呼叫流程的研究團隊,以及同時處理查詢、數學、程式和知識任務的服務。單輪模式可減少簡單工作的額外呼叫;多輪及 agentic 模式則提供分步推理或角色協作空間。代價是增加了路由策略與執行流程的訓練、協調複雜度,而成本獎勵也不能單獨保證每個任務都會選到最合適模式。

  • 一個策略同時決定執行模式及工作模型路由。
  • 六個工作模型保持凍結,策略負責編排呼叫與整理答案。
  • COMET-GRPO 分開給模式決策和模式內執行評分。
  • 成本獎勵與漸進式探索,分別處理資源取捨及模式探索。

程式碼、訓練後的路由器及項目頁已公開;提供模型與資料入口。先理解方法及評估設定,再按公開程式與模型資料判斷是否符合自己的任務。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架

Socratic-Skill-Learning:Agent 技能能否真正跨任務重用?南京大學提出 SSL

SSL 讓 Agent 在導師指導下自行練習及編寫技能,並以新任務測試 transferable Skills 是否真正遷移。

NJU-LINK

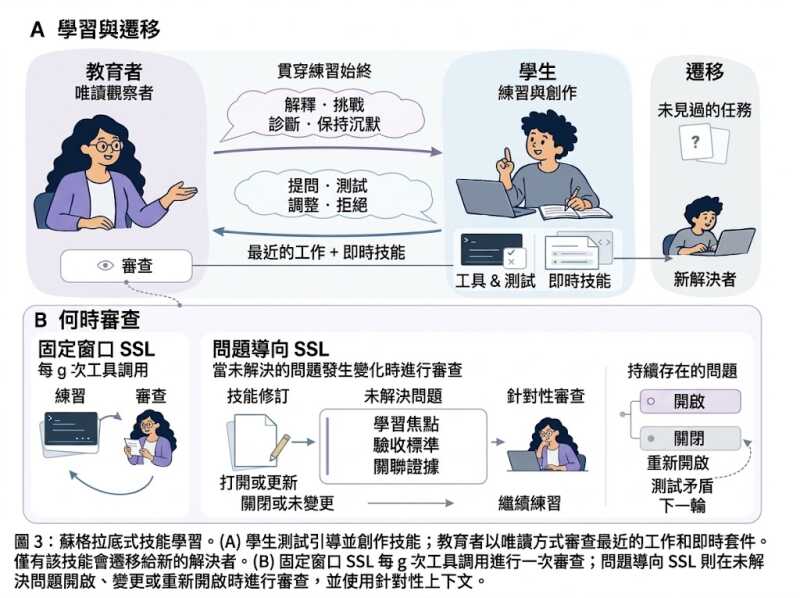
Agent 從一次任務學到的做法,未必能直接套用到新情境;SSL(Socratic Skill Learning)把這種「學會與重用」拆開,讓 Student 練習、提問及編寫 Skill,再由全新的 solver 接手未見任務。南京大學 NJU-LINK 將它定位為可重用 Agent Skills 的學習框架,關鍵不是複製完整答案,而是保留程序及其適用條件。

流程由 Educator 介入指導,但 Student 仍是環境操作者及 Skill 作者,可以質疑、測試和修改建議。Fixed-Window SSL 會按固定間隔檢視進度;Issue-Guided SSL 則追蹤仍未解決的問題,隨 Skill 版本變化集中檢視,避免每輪都重新教訓。

評測工具 SkillTransferBench 涵蓋 35 個任務系列、408 個可執行個案及 6 個領域;主評估使用 22 個系列、155 個 held-out cases,並以新 solver session 測試遷移。Fixed-Window SSL 的 utility 為 0.801,高於無 Skill 的 0.723、Trace2Skill 的 0.761,以及 SKILL-KD 的 0.751;Issue-Guided SSL 達 0.805,較 Fixed-Window SSL 節省 61.7% Educator tokens,但整體流程仍需 Node.js 22.19+、Docker 及 OpenAI-compatible API 支援。

  • 讓 Agent 自己提問、測試和修訂 Skill
  • 以未見任務及新 solver 檢查技能是否可遷移
  • 比較固定間隔與問題導向兩種複核方式
  • 提供跨 Qwen、DeepSeek、Kimi 等模型的評測

這套方法較適合研究 Agent 教學、技能記憶及長期工作流程的團隊,而不只適合聊天機器人。它沒有直接把大型模型換掉,而是處理更實際的問題:如何把一次成功任務轉成可攜、可審核的 Skill,同時控制導師介入所帶來的額外成本。

GitHub · 數據集

Categories: 開源, 南京大學, Agentic, 模型, Qwen, OpenAI, DeepSeek, API, 框架, 教學, 工具, Dataset 數據集, Kimi, Skill 技能

CoEvo-RSI:讓模型跟上會進化的 Agent Harness

CoEvoX 讓模型與執行框架同步演化,改善 AI Agent 的能力與工作流程互相錯配及自我進化(RSI - Recursive Self-Improving)的問題。

CoEvoX framework

當 Agent 的執行流程不斷改變,模型可能未學懂新要求,也可能因 Harness 限制而用不出原有能力。CoEvoX 屬於 LLM agent 的模型—Harness 共演框架,透過共同演化歷史檔案,協調模型檢查點、執行框架與實驗結果。

每輪流程由 meta-agent 編輯新 Harness,從歷史檔案選擇或合併模型 checkpoint,再用拒絕取樣軌跡進行 SFT;只有通過驗證的改善組合才會晉升。TIMR(Turn-level Interface Mismatch Rate)用來診斷逐回合的介面錯配,亦令模型選擇不再只看單一模型能力。

• Qwen3.5-9B 經 CoEvoX 調整後,部分失效歸因測試超越更大型模型
• 評估涵蓋多代理失效歸因、角色感知 text-to-SQL 及智能家居指令
• Held-out 測試避免同時參與訓練與演化選擇
• 結果並非全面領先,部分演算法生成或 When 指標仍落後其他方法

失效歸因結果中,CoEvoX 在 Hand-Crafted 的 Who、Pro 的 Who,以及 TraceElephant 的 Who 分別取得 68.39%、69.43% 和 70.78%,但在 TraceElephant When 只有 28.92%,低於 GSPO 的 38.36%。這反映共演化能改善特定工作分工,卻未必對所有推理步驟同樣有效。

項目較適合研究 recursive self-improving agents、模型訓練及 Harness 設計的團隊,用來測試模型與工作流程是否互相配合。提供的資料沒有完整安裝、執行指令或部署流程,亦不應直接假設可隨意下載;目前較合理的理解是把它視為附有實驗框架與評估方向的研究項目。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架

StreamingSwap 把影片換臉推向 20 FPS 即時串流

StreamingSwap 針對長片換臉的身份穩定與速度取捨,透過較短上下文支援單卡即時處理。

StreamingSwap

長時間影片換臉最難維持的不是單幀效果,而是身份一致、原有動作和畫面細節能否一路穩定。StreamingSwap 是一個參考圖像引導的影片換臉模型框架,處理把來源身份轉移到目標影片、同時保留目標人物屬性與動態的問題。

它分兩個階段改善速度與穩定性。Face-RoI Generation 只集中處理臉部區域,配合按噪聲程度調整身份與重建比重的 Joint Rec-ID Loss;其後以 Short-Context Rollout Training 使用模型生成的歷史畫面,減少串流生成中的誤差累積。這套方法針對換臉只改變身份、其他視覺內容大致不變的特性,補足單靠 flow-matching supervision 對身份差異不夠敏感的問題。

提供的結果包括:
– 單張 NVIDIA RTX 4090 達到 21.174 FPS 的端到端吞吐量
– 評估影片最長達 10 分鐘,並展示 19 分鐘、20 FPS 取樣的直播串流測試
– HumanFaceVid 包含 1,000 小時電影風格訓練資料,以及各 200 段短片和長片評估集
– 研究結果在身份轉移和視覺質素之間取得具競爭力的平衡,但資料建構程式和訓練資料仍標示為準備中

電影後期、直播特效和長片角色替換等情境,較能受惠於這種空間與時間上下文都較節省的做法;單卡 RTX 4090 的測試結果亦令即時串流更接近可行範圍。項目提供的是研究模型與展示資料,原始資訊未交代完整安裝指令、未有直接下載的模型權重或訓練資料,因此不宜當成已可隨意下載使用的成品。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 框架, Dataset 數據集

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

Google Harness² 讓 Agent 自我改良執行系統

Harness² 能在模型不變下,按任務改進提示詞、工具與技能,並將經驗沿用至後續任務。

Harness²

Agent 的落差往往不只來自模型能力,提示詞、工具配置、記憶和任務編排同樣影響結果。Google Research 開源的 Harness²,便是一個處理這層「執行系統」的研究框架:它固定模型權重,先按眼前任務調整 harness,再把成果與經驗帶到下一項任務。

它的核心是兩層遞迴。Task-level recursion 透過 Propose–Probe–Compose,先提出修改、在相同任務測試效果,再整合有效部分;Harnessing-level recursion 則把已採用的 harness 與有證據支持的經驗寫入持久 improvement harness,協助後續改進。這種取捨是把資源由重新訓練模型,轉向持續優化模型周邊配置。

  • 模型權重固定,主要改進 prompts、tools、memory、skills 與 orchestration。
  • 不依賴標準答案,以同一任務不同執行結果的行為差異作為回饋。
  • 支援 parallel、sequential recursion,以及 OpenCode、Codex executors。
  • 可配合 JobBench、LAB、WorkBuddy-Bench 測試。

在四種 model–harness 組合中,Harness² 為 GLM-5 與 Gemini 3.5 Flash 的基礎 harness 帶來提升:WorkBuddy-Bench 最高增加 11.5 分,JobBench 增加 4.5 分,LAB partial pass rate 增加 11.8 個百分點;提高 task-level recursion budget 還可繼續增加結果。不過,資料涵蓋三個專業 benchmark,尚不足以證明所有工具和模型組合都能受惠,而且每輪提出、測試及整合會增加執行成本。

需要多工具、複雜編排或持續接力的 Agent 團隊,較能感受到這種架構的價值;維護者可用 JobBench 流程建立環境,再按自身 executor 與評估基準測試。研究人員亦可沿用遞迴設計,但應核對額外呼叫、錯誤傳播及 improvement harness 累積錯誤等問題。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, Gemini, 提示詞, 框架, 工具, Dataset 數據集, Skill 技能

Manga2Animate 雙智能把關分鏡,動漫不走樣

把漫畫直接餵進影片模型,角色與分鏡往往走樣。Manga2Animate 改走正規動畫流程:先寫腳本、再繪分鏡,最後才生成影片,由審核智能體把關忠實度。

想用 AI 把幾頁漫畫變成連貫動畫,最常撞到的兩個卡位是:純文字輸入會讓角色外貌與畫風消失,直接把分鏡頁送進影片模型又會誤判版面、講錯故事。Manga2Aniate 屬於多智能體框架,它把整條流程切成「預處理 → 腳本與分鏡優化 → 影片生成」三個階段,第二階段是關鍵差別所在:系統先生成動畫腳本,再產出視覺分鏡,兩者各由一個 creator agent 撰寫,並由對應的 reviewer agent 對照原始漫畫頁給意見,前後跑兩輪迭代才進入成片。

預處理階段用 Magi 偵測漫畫格並排出閱讀順序、抽取文字,再由 Character Description Creator 從角色參考圖歸納出識別特徵,避免後續鏡頭換角色就認不出來。這個雙層審核機制,是它和一般 I2V(image-to-video)套法最大的分水嶺。

對動漫改編從業者、影像敘事研究者,或想快速把作品原型化的獨立創作者,這套 pipeline 提供了比端到端模型更可控的中介層。論文與用戶研究都顯示,無論是角色一致性還是跨鏡頭連貫性,輸出都較接近既有方法優勝。

重點摘要

  • 三階段流程:Magi 切格+轉錄 → 腳本與分鏡兩輪迭代 → 片段式影片生成
  • 雙智能體架構:creator 撰寫、reviewer 對照原頁把關,腳本與分鏡各有獨立審核
  • 兩種生成模式:ref 模式以角色參考為主,i2v 模式則把分鏡切成首幀再生成
  • 開源後端齊全:程式碼、評測資料與模型設定皆公開,方便重現
  • 改善既有 I2V 套法常見的「角色走樣、敘事錯位」問題,在忠實度與一致性上有所提升

需要留意的是,目前公開的程式碼屬於研究框架性質,本地重現需要自行串接影片生成後端,權重未統一打包,下載及設定流程會比一般一鍵安裝的開源項目多幾道手續。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Image, 框架, Content Creator, 動畫

PhysRSI-Eval:量度機械人自我改進能力

固定模型、不改權重,讓智能體反覆嘗試雙臂機械操作,再評估技能、工具與記憶能否持續改進。

PhysRSI-Eval overview

機械人代理能否靠一次失敗改善下一次操作,而不只是模型本身更強?PhysRSI-Eval 是一套物理遞歸自我改進(physical recursive self-improvement,Physical RSI)評測框架,透過 RoboDojo 模擬環境量度這個過程,適合研究 LLM-as-policy 與機械人學習的團隊。

框架以 K0 基準及 K1 至 K17 最佳化回合運作:K0 在沒有既有工作區下完成操作,之後每輪保留技能、工具、策略程式碼與記憶;代理收到評分和失敗原因後,再修訂工作區。整個評估涵蓋 18 項操作任務,並以 First-Attempt Performance、Efficiency、Success、Budget、Improvement 五個維度記錄成果。

儲存庫提供可在自身機器運行的參考評估迴路,但只涵蓋論文泛化研究中的四項任務。RoboDojo、Isaac Sim、資產及 Codex CLI 均須從各自來源按固定版本安裝,因此成本與環境要求不會低;代理亦沒有系統提示、Shell 或網頁搜尋,只能使用指定機械人工具。

它與一般單次成功率測試的差別,在於保留整段改進軌跡,區分首次表現、後續增益及預算消耗。雙臂 End-Effector(EEF)每次最多移動 5 cm 或 0.35 rad,執行 1 至 5 個控制步驟,每輪模型時間上限為 4,200 秒,並以達到原生成功或回合上限作結。

  • 以固定模型測量工作區改進,避免把權限限升誤當成自我改進。
  • 同時觀察首次分數、成功時間、效率及改善比例。
  • 以持久技能、工具、策略和記憶支援跨回合修訂。
  • 以固定互動預算限制比較條件。

研究結果顯示,不同系統在空間、感知及編碼能力上的強弱並不一致,亦有模型未能解決部分任務。這個基準適合比較代理設計與泛化能力,但公開程式碼只覆蓋四項任務,完整結論仍須結合論文及其餘評估設定解讀。

項目主頁 · GitHub

Categories: 開源, 模型, 框架, 工具, 庫, Dataset 數據集, Skill 技能

Page 3 of 34
1 2 3 4 5 … 34