WeVisDoc 騰訊文件圖片的端到端解析模型

騰訊 WeChat Vision 團隊開源 WeVisDoc 系列文件解析模型,以「先擴廣覆蓋、再針對性補強」的兩階段訓練框架,在 OmniDocBench v1.6 與多個 PureDocBench 軌道同時刷新端到端解析器紀錄。

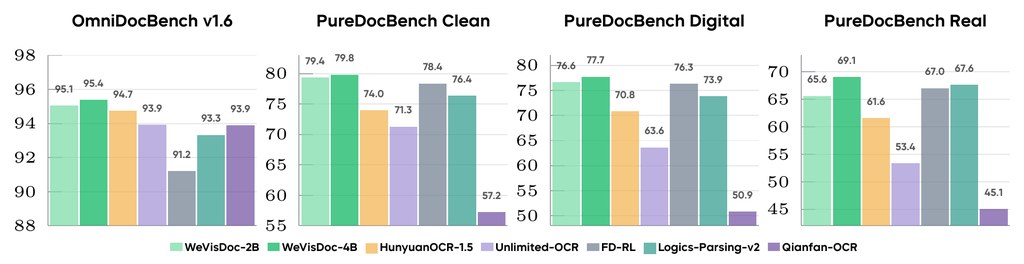
WeVisDoc-4B leads the compared end-to-end parsers across all four reported settings.

當一份文件同時夾雜模糊掃描、手寫註記、複雜表格與數學公式時,多數 OCR + 版面分析的流水線都會在交接處出錯——模型間責任不清,錯誤層層放大。騰訊 WeChat Vision 團隊開源的 WeVisDoc 系列正正針對這個痛點,把「文件頁 → 結構化 Markdown(含 LaTeX 公式、HTML 表格)」收進單一端到端模型,避免不同模組互相推卸責任。

WeVisDoc 推出 2B 與 4B 兩款模型,皆以 Qwen3-VL 為基座微調而成,覆蓋文字、公式、表格與閱讀順序四個維度。訓練方法分兩階段:Stage I 先擴大語義、結構、外觀三方面的數據覆蓋;Stage II 則用殘差診斷找出 Stage I 仍出錯的樣本,針對性地補充與重新分配訓練數據。這套做法與單純堆數據量的路線不同——它把精力集中在模型最容易跌倒的角落。

在 OmniDocBench v1.6 上,WeVisDoc-4B 取得 95.38 的 Overall 分數,三條 PureDocBench 軌道的平均分為 75.54,均為目前端到端解析器的最佳成績。在更貼近真實擷取條件的 PureDocBench Real(模擬四次實體拍攝劣化)上,相對次強基線仍拉開 1.44 分,是四個比較場景中差距最大的一項,正好對應 Stage II「在真實擷取最難看的外觀變化上獲得最大增益」的設計初衷。

對需要把大量歷史紙本文件、學術論文、表格報表轉成結構化內容的研究團隊與企業來說,WeVisDoc 提供了一個開源、可在本地用 GGUF 等格式部署的小模型選項。模型現已上載 Hugging Face,並附技術報告與互動式 Recovery Lab,方便逐頁對比 Stage I 與 Stage II 修復了哪些具體錯誤(例如被漏掉的 9×9 數獨格線)。

  • 騰訊 WeChat Vision 團隊開源的端到端文件解析模型,2B/4B 兩個規模,皆基於 Qwen3-VL 微調
  • 兩階段「數據中心」訓練框架:Stage I 擴大覆蓋、Stage II 以殘差診斷針對性補強
  • 輸出結構化 Markdown,內含 LaTeX 公式與 HTML 表格,涵蓋文字、公式、表格、閱讀順序四維度
  • WeVisDoc-4B 在 OmniDocBench v1.6 與三條 PureDocBench 軌道均居端到端解析器首位
  • 開源釋出模型權重、技術報告與互動式範例頁,方便逐頁審視修復效果
項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 模型訓練, Qwen, 框架, Dataset 數據集

JEPA-Anything 一套預測框架打通不同世界模型

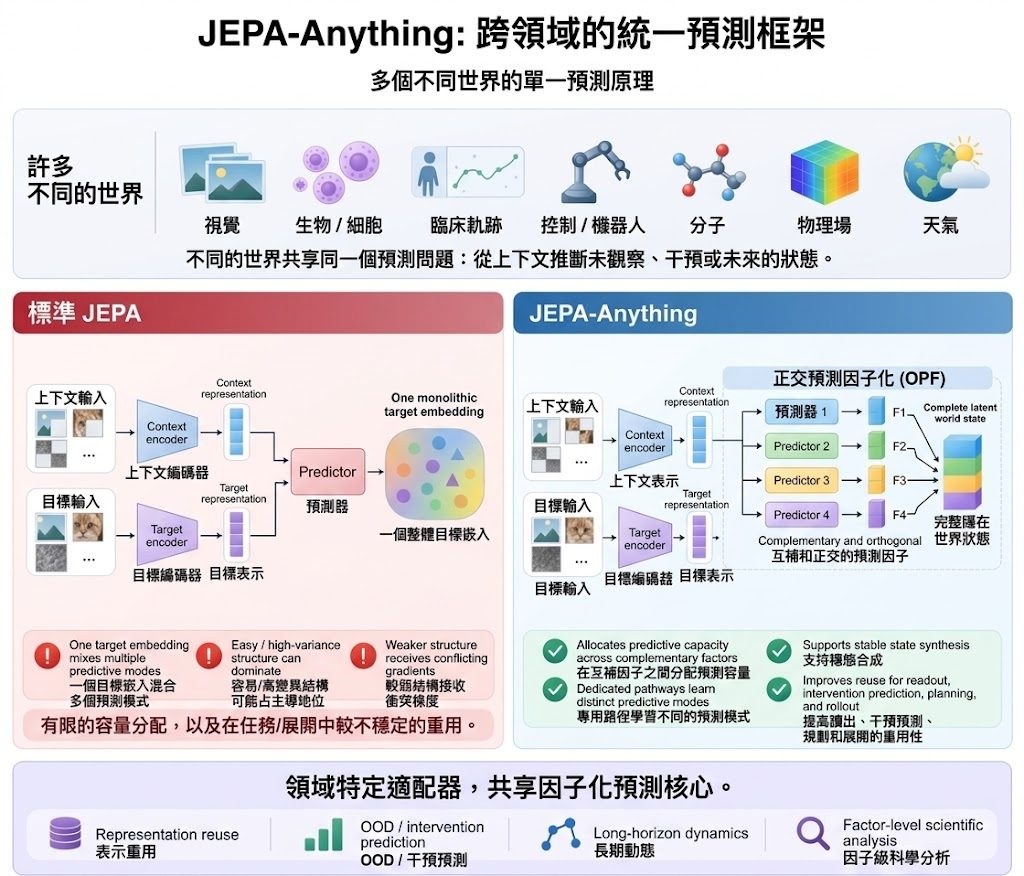
JEPA-Anything 提出 domain-agnostic 框架,把細胞、分子、物理場、控制環境、臨床軌跡等差異極大的世界,交給同一套預測原理學習。它用 Orthogonal Predictive Factorization 取代單一目標表徵,嘗試讓跨領域的世界模型有共享接口。

JEPA-Anything overview: cross-domain predictive learning and Orthogonal Predictive Factorization

世界模型的難題之一,是不同領域看似南轅北轍,卻共享同一個核心問題:能否用同一套預測學習原則,去處理完全不同的世界?Gen-Verse 的 JEPA-Anything 瞄準的正是這個長期卡位。它以 joint-embedding predictive architectures(JEPAs)為基礎,把傳統那塊「單一、整塊」的目標表徵拆開,改由一種叫 Orthogonal Predictive Factorization(OPF)的做法,把潛在的 world state 切成多個互補的預測因子,每個因子各自走一條預測路徑,最後再重組回完整狀態,作為下游讀取、干預預測、規劃與多步 rollout 的接口。

對研究者與工程團隊而言,它的價值在於允許不同領域保留各自的觀測、context–target 結構與編碼器,卻共享同一個預測核心與潛在狀態接口。換句話,領域不必共用同一個編碼器,也不必共用同一組權重,卻仍能復用同一套建模邏輯。框架內部除了可重用的 projection、objectives、baselines、representation diagnostics 外,也提供任務規格驗證與實作 scaffold 工具,並附上一個可控動力系統作為起步範例,方便團隊在自己的領域落地。

相較於針對單一領域訓練的 world model,JEPA-Anything 取捨的方向是放棄「一套權重打天下」的野心,改為提供一個結構化的共享接口與預測路徑。它對於需要把生物干預、物理定律等實驗訊號接回模型內部做分析的場景尤其有用,同時讓 out-of-distribution 預測與長程 rollout 有更清楚的表示基礎。模型權重與評估可在 Hugging Face 上的對應頁面取得。

GitHub

Categories: 開源, Embedding, 世界模型, 模型訓練, 框架, 工具

[技術文章] Coding harnesses 編程代理 : Context 管理、規劃與動作介面誰最影響表現?

同一個模型,搭配不同的 coding harness,表現可以差很遠。這份實證研究把 harness 拆成三個零件逐個測,告訴你哪個零件在邊種情況下真正有作用。

Hero image preview

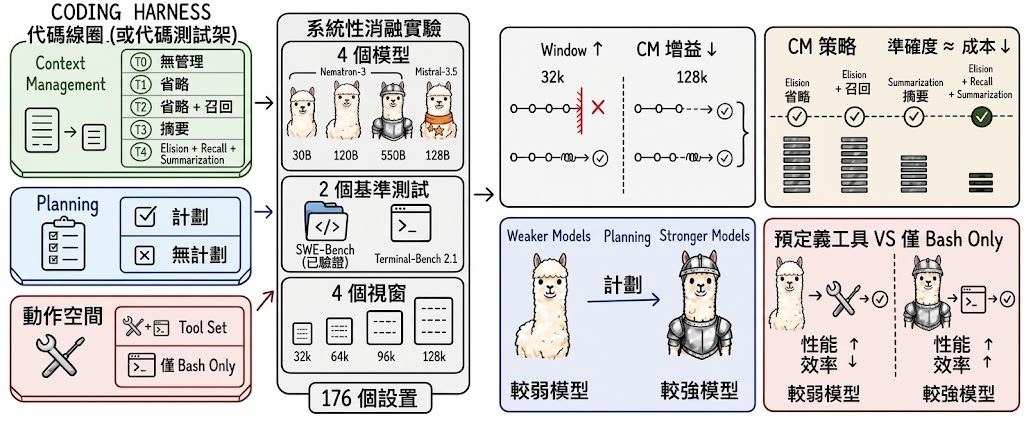
在 SWE-Bench Verified、Terminal-Bench 2.1 呢類基準上,坊間討論往往直接以「Claude 用某個 harness 表現最好」作結,例如 Cao et al. (2026) 比較後發現 Claude-Opus-4.5 配 OpenHands 最強,而 Claude-Sonnet-4.5 則在 SWE-Agent 上表現較佳。問題係,當我哋直接比較兩個完整嘅 harness,所觀察到嘅差異其實係 plan、action space、context management 三個零件同時變化嘅結果——換句話講,「邊個 harness 比較好」呢條問題,根本答唔到「邊個零件有用」。作者指出,以往研究多把 harness 視為單一系統去比,結果令個別零件嘅效用難以釐清。

為咗拆開睇,呢篇論文用咗一個輕量級 coding harness,固定執行迴圈,只改動三個零件:規劃、動作空間、上下文管理。團隊用四個模型喺 SWE-Bench Verified 同 Terminal-Bench 2.1 上測試咗 176 個配對設定,涵蓋五種上下文管理策略、四種上下文視窗預算,再加規劃同動作空間嘅針對性消融。

研究發現幾個有趣嘅條件性效果。第一,context 管理喺視窗預算愈緊嘅時候愈有價值,大部分效益其實嚟自避免 context-overflow 失敗,而非提升行為質素。第二,在眾多策略中,「先做規則式 elision、再做 LLM 摘要」呢種分階段做法整體效率最高;允許被刪內容可恢復嘅機制,模型幾乎唔會用到,亦無帶嚟準確度提升。第三,規劃嘅角色會隨模型能力變:對弱模型係準確度嘅支柱,對強模型就變成慳成本嘅工具,準確度變化唔大。第四,預定義工具對 bash 能力弱嘅模型有幫助,但 bash 能力強嘅模型只需要 bash 介面就夠,而且喺命令行主導嘅任務上成本低好多。

軌跡分析進一步解釋:context 管理延長執行軌跡但唔大幅改變行為,規劃改變軌跡停止嘅位置,動作空間就改變程式碼被寫出嚟嘅粒度。換句話講,三個零件影響嘅其實係代理行為嘅唔同面向。對從事編程代理相關工作嘅人,呢套模組化框架提供咗一個可以繼續累積、比較新零件嘅方法,亦提示設計時要按模型能力同預算做取捨,而非盲目堆砌功能。

重點摘要:

  • harness 唔應該當成單一系統去比,拆開 plan、action space、context management 三個零件先睇得清
  • context 管理喺視窗愈緊愈有用,核心係防 overflow,而非提升行為質素
  • 規則式 elision 配合 LLM 摘要嘅分階段策略,效率表現最好
  • 規劃對弱模型係必需、對強模型只係慳錢
  • bash 能力夠強嘅模型用純 bash 介面,喺 CLI 任務上可以大幅降低成本

Paper

Categories: Agentic, 框架, 軟件, 工具, 編程

GPT-Policy 把 VLM 變現場教練

GPT-Policy 讓固定的視覺語言模型在現場讀懂示範影片、目標圖與互動回饋,直接輸出可執行的機械臂動作,省去微調與重訓成本。

GPT-Policy wordmark

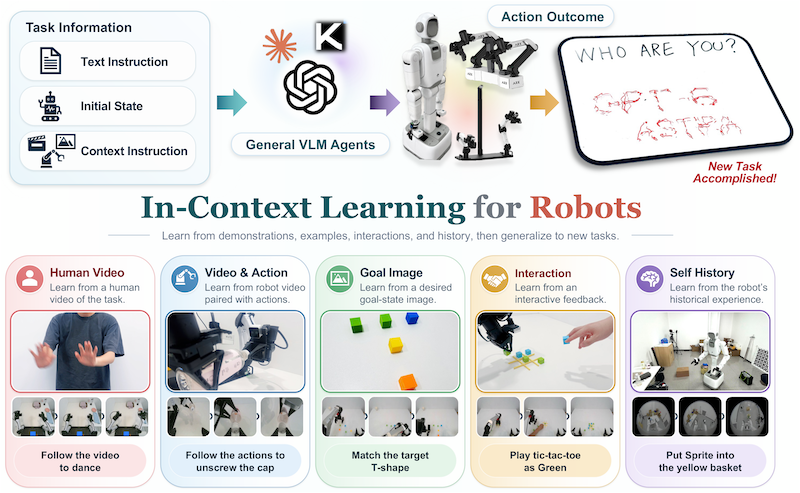
機械臂要適應新任務,傳統做法往往是收集大量數據再微調模型,成本高且迭代慢。GPT-Policy 走另一條路:保留一個固定的視覺語言模型(VLM)作為決策核心,現場把任務指令、示範影片、目標圖像、過往觀察與執行回饋打包成單一輸入,讓模型一次輸出一個結構化動作請求,再交給專屬的硬件適配器(adapter)驗證並執行。

的關鍵在於「context compiler」與「constrained controller」的分工。前者負責保留示範中與任務相關的視覺轉折,後者則檢查動作是否安全、可執行,並回報結果給 VLM 進入下一輪決策,整個過程沒有梯度更新,也不需要為新任務調整參數。對於 ARX X5 與 I2RT/YAM 兩款機械臂平台,項目已提供對應的適配器,支援笛卡兒目標、waypoint 序列、順序 IK 檢查、夾爪控制,以及 append-only 的運行記錄,方便日後追溯。

從結果來看,團隊在真實機械臂試驗中發現,即使只有人類影片而無機械臂動作標記,GPT-Policy 仍能改善任務完成率;若加上對齊的動作參考,表現會進一步提升,尤其在接觸敏感的任務上更明顯。對比同類做法,GPT-Policy 沒有走端到端策略網絡的路線,而是把通用 VLM 的推理能力當作即插即用的策略模組,取捨是更依賴適配器與閉環回饋的工程品質。

適合使用的場景包括:研究 VLM 與機器人結合的團隊、需要快速讓機械臂適應新任務示範的實驗室,以及想評估「不重訓」路線可行性的工程團隊。目前的限制在於硬件覆蓋仍集中在兩款臂,且效能高度取決於上下文編譯器能否保留關鍵視覺資訊。

重點摘要:

  • 固定 VLM 即決策核心:不微調、不重訓,靠現場上下文即時生成動作
  • context compiler + controller 雙層架構:前者保留任務相關視覺轉折,後者驗證並執行
  • 支援 ARX X5 與 I2RT/YAM:提供笛卡兒目標、IK 檢查、夾爪控制等適配器
  • 人類影片已能改善任務成功率:對齊動作參考後表現更穩,尤其接觸敏感任務
  • 定位為研究框架:適合探索通用模型在實體機器人上的即時學習能力

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, Video, Image, 影像處理, Robotic, 框架, 安全

PANORAMA 把場景描述逐個詞對應到像素

Inria 與捷克理工合作開源的 PANORAMA,能為整個場景生成描述並把每個實體精確對應到像素遮罩,並同步釋出近全幅覆蓋的人工標註基準 PanoCaps。

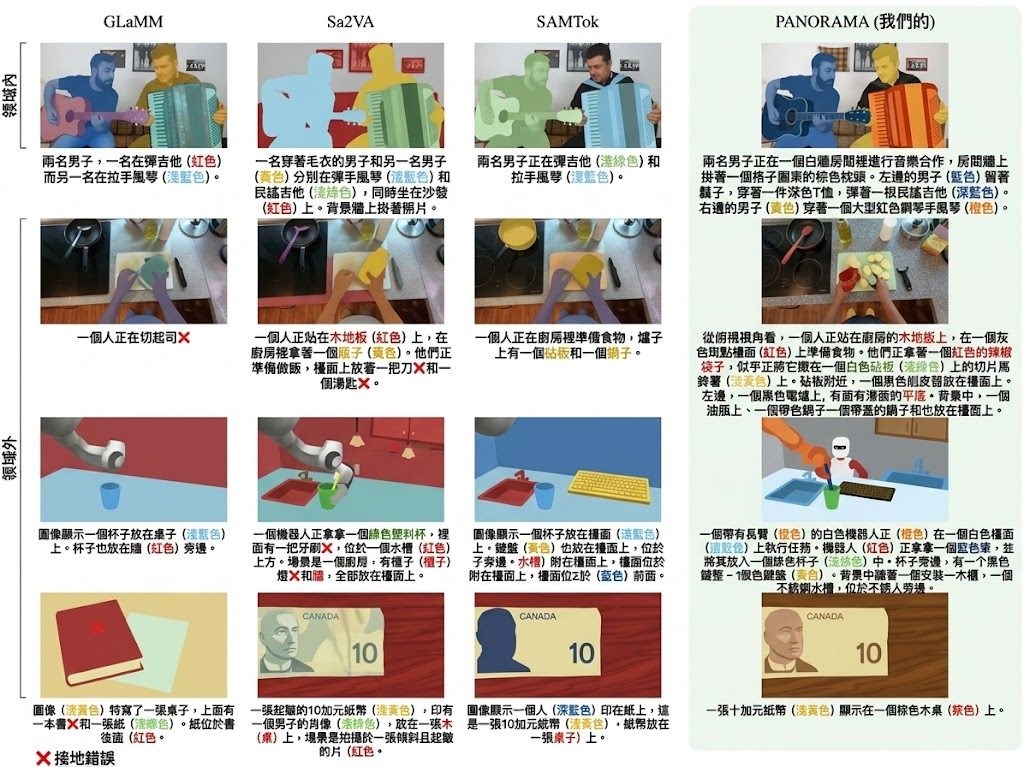
PANORAMA compared with prior grounded captioning models, in and out of domain

現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。

做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。

配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。

這個項目適合以下情境:

  • 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
  • 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
  • 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
  • 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱

對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Image, 框架, 庫, Dataset 數據集

ScienceIDE 把科學模擬變成 AI agent

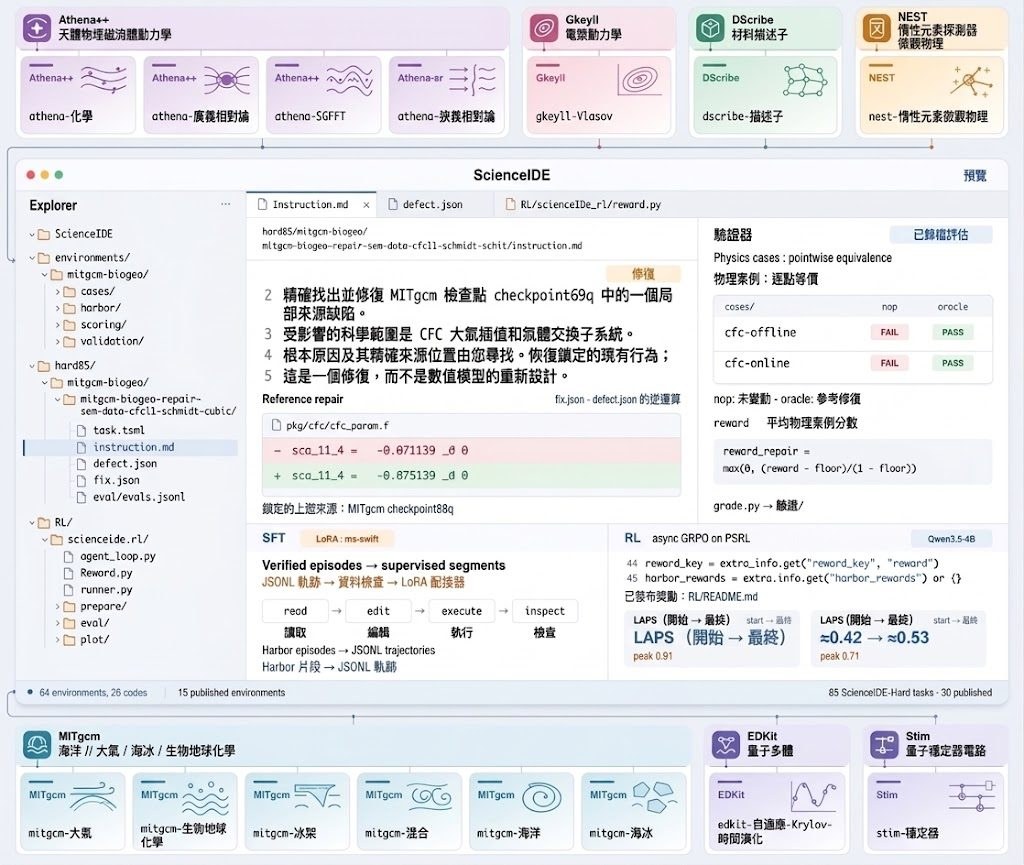
ScienceIDE 用 64 個科學模擬環境訓練 agent 修 bug、重寫函式,並釋出 4B、9B、72B 三個模型。你可以把它理解成:用真實物理模擬的數值對不對,來判斷 AI 改程式改得啱唔啱。

ide overview

大多數 code agent 訓練環境用靜態單元測試或合成題目,ScienceIDE 走一條更狠嘅路:直接搬真實科學模擬器入嚟做試煉場,等 agent 改動 pinned、未經修改嘅上游源碼,再由 verifier 重新編譯並跑原本嘅物理 case,數值要對得返先算過。換句話,reward 唔係「diff 似唔似」,而係「模擬結果啱唔啱」。呢套框架對工程團隊同做 AI for Science 研究嘅人特別有用,因為佢直接量度 agent 對物理計算嘅影響,而唔係紙上談兵。

項目提供 64 個環境同 85 條 ScienceIDE-Hard 任務,已公開 15 個,全部都附帶可量度嘅難度指標(未修復分數、編輯點數量、驗證成本、通過率),避免人為標 difficulty。Reward 設計亦幾巧妙:untouched repository 一定攞零分,等模型必須真係做嘢先有分。

團隊同時釋出 PhAI-IDE-4B、9B、72B 三個模型,覆蓋唔同算力預算。從結果睇,SFT 後 PLUTO-Particles-Dust 由 0.0 跳到 0.33;Qwen3.5-4B 經 30 步 RL,LAPS 由 0.357 升到 0.857,MITgcm-biogeo 由 0.286 升到 0.571。訓練用科學 code 唔止提升呢類任務,亦帶動一般 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。

要部署嘅人最直接嘅入口係 Hugging Face 嘅 model collection 同 GitHub repo;想理解 reward 邏輯同難度定義,paper 同項目頁有完整交代。訓練數據、開發環境同 verifier 開源,等社區可以喺真實科學 codebase 上繼續 scale up。

重點摘要:

  • 真實物理模擬做 reward:agent 改動上游源碼後,verifier 重編譯並比對物理 case 數值,唔靠 diff 相似度。
  • 64 個環境、85 條 Hard 任務:已開源 15 個,難度由可量度指標自動決定,唔靠人手標 label。
  • 三個模型規模:PhAI-IDE-4B、9B、72B 覆蓋唔同算力,訓練設定與評估條件一致。
  • 科學任務外溢到通用 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。
  • 完整開源鏈:code、environments、tasks 同模型權重同步釋出,方便研究團隊複製同擴展。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架, IDE, Dataset 數據集

HarnessVLN:不訓練也能走的統一導航框架

HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

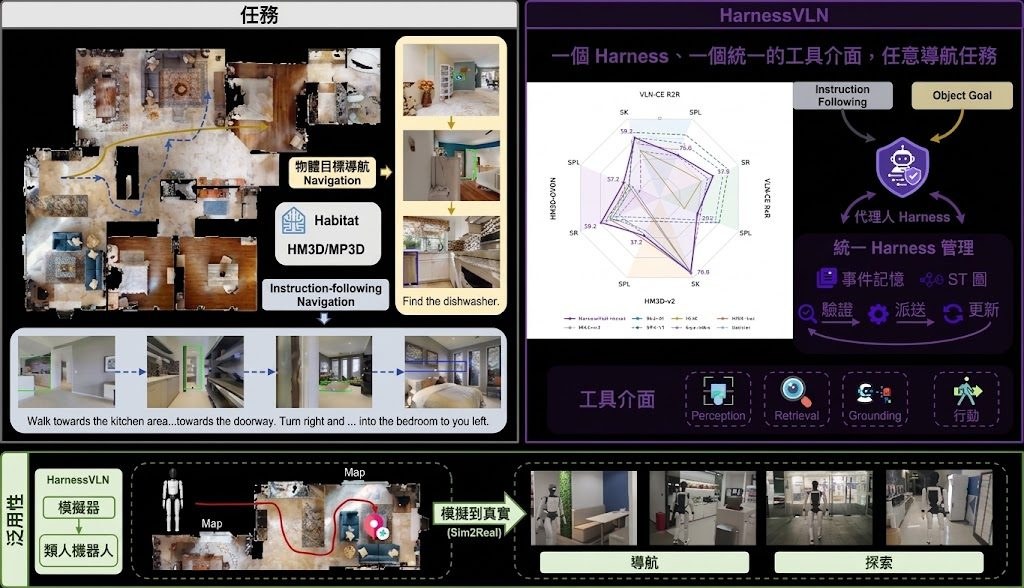
Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

awesome-ai-for-games:基礎模型開始當玩家、設計師與測試員

基礎模型在遊戲場景的角色,已經不限於落子對奕。新加坡國立大學團隊發表的120頁綜述,把AI在遊戲生命週期中的用途分成六種角色,並用同一組問題貫穿比較。

Awesome AI for Games — AI for Games in the Foundation Model Era

過去談遊戲 AI,多數人直覺想到 AlphaGo 或強化學習對奕 agent,但這個 GitHub 項目展示的視角明顯更廣。它由新加坡國立大學與南洋理工大學作者群發表,圍繞 442 篇文獻、416 篇核心著作,把基礎模型在遊戲生命週期中的角色拆成六類:玩家或 NPC、世界或玩家模型、內容與規則設計、在遊戲引擎內操作、調整運行中的遊戲,以及產出測試證據。

之所以這樣分類,原因是同一個預訓練模型可能同時擔任多個角色,但每個角色對應的接口、限制與所需證據都不同。項目用三個反覆出現的問題貫穿六個角色:邊界(由遊戲或工作流提供、由 AI 負責的部分)、遷移與重用(哪些能力與產物能跨場景複用,哪些仍綁死在特定設定)、證據(評估方法是否真正支撐了結論)。這套問法讓「會寫程式」與「會做玩家」不再混為一談。

從實際工作場景看,遊戲工作室、引擎開發者、玩家行為分析團隊,以及研究遊戲 AI 的學界,都能從這份分類地圖中快速定位自己關心的子題,例如社交協調架構 CASCADE、桌面資料視覺—動作預訓練 D2E,或者長時程 LLM agent 的 bounded-memory 測試環境 AgenticSTS。

理解這個項目最直接的方式,是把它視為一份研究地圖加書目入口:項目網站提供可搜尋的 442 條參考清單、論文圖表與影片導讀,並把同一套分析框架套到每一個角色,讓讀者比較不同子領域的成熟度。對想入門遊戲 AI 的人而言,它比單篇論文更容易判斷哪些方向已有共識、哪些仍處於早期定義階段。

重點摘要

  • 120 頁綜述、442 篇參考文獻,由新加坡國立大學與南洋理工大學團隊共同整理
  • 把基礎模型在遊戲中的角色分成六種(玩家、世界模型、設計、引擎內操作、運行中調整、測試),而非按模型架構分類
  • 用「邊界、遷移與重用、證據」三個問題貫穿所有角色,作為統一的分析視角
  • 涵蓋社交協調、桌面視覺—動作預訓練、長時程 LLM agent 測試等多條子題線索
  • 項目網站提供可搜尋書目、圖表與 90 秒影片導讀,方便快速定位子領域

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型訓練, Video, 框架

LynnReal-Omni 把十幾種影片任務塞進一個 32B 模型

一個 32B 多模態擴散 Transformer,同時做文字生影片、圖生影片、動作控制、風格遷移、影片修復同長影片串流。Flash 版本更可喺單張 H100 上 377 毫秒出 22 帧 540p 短片。

LynnReal-Omni — Standard four-step and Flash three-step multimodal generation

LynnReal-Omni 想解決嘅,係影片生成工具鏈最煩嘅一件事:每加一個任務(動作控制、參考影像、風格遷移、編輯、修復)就要疊多一個模型或多一套 pipeline。作者選擇用一個 32B 共享多模態擴散 Transformer(跟 MiniMax H3 架構)一次過承載文字生影片、圖生影片、人體與手部姿勢控制、結構控制、omni-reference、風格遷移、影片編輯、退化影片修復,以至串流式長影片生成,仲可以接駁外觀參考、可編輯 3D render、遊戲錄影等異質輸入,等 Agent 可以喺同一個模型內組合視覺條件。

對比同類做法,最大差異係「統一框架」而非「任務專用模型」。每個源帧獨立編輯再組裝成無聲 24fps 影片,每帧只需四次 DiT forward,120 帧即 480 次 forward。輸入限制清楚:24fps、寬高需為 32 倍數、目前只支援 768p(1344×768 起手)。獨立逐帧編輯會帶來亮度或形狀嘅帧間抖動,作者亦坦白標示為已知限制。

對短片創作者、遊戲或 3D 團隊、Agent 開發者來講,好處係少咗一套模型接駁嘅工程成本;Agent 可以直接用外觀參考同 3D render 嚟組裝條件。Flash 版本(27B、三步生成、輕量 VAE decoder)將單張 H100 上 22 帧 540p 由 843 毫秒壓到 377 毫秒,為實時或互動應用鋪路。

項目已提供 ComfyUI workflow 涵蓋 t2v、i2v、r2v、pose2v、v2v 幾個入口,但作者明言仲係早期 beta,質量、兼容性同 bug 仍然存在,訓練代碼、部分訓練數據同更高效 DiT 預計稍後釋出。打算用佢做關鍵流程嘅團隊,宜先以小批量預覽(--indices 0,24,48 --keep-clips)確認穩定性再評估是否引入生產。

重點摘要:
– 一個 32B DiT 模型覆蓋十幾種影片任務,Agent 可直接組合異質視覺條件
– 每源帧四次 DiT forward,120 帧共 480 次;輸入限 24fps、寬高需 32 倍數、768p
– Flash 版本用 27B 加輕量 VAE,單張 H100 上 22 帧 540p 暖機生成耗 377 毫秒
– 獨立逐帧編輯會產生帧間亮度與形狀抖動,屬已知限制
– ComfyUI 支援 t2v、i2v、r2v、pose2v、v2v,目前屬早期 beta,訓練代碼尚未開源

GitHub · 模型

Categories: 開源, ComfyUI, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 框架, 工具, Content Creator, 3D, MiniMax

AlayaVista:全景潛態驅動嘅可串流世界模型

AlayaVista 從一張透視圖出發,建立 360° 全景先驗,再隨鏡頭動態演化作為視點潛態,逐區塊渲染並局部精煉所選畫面,做流暢且高保真嘅可控影片生成。

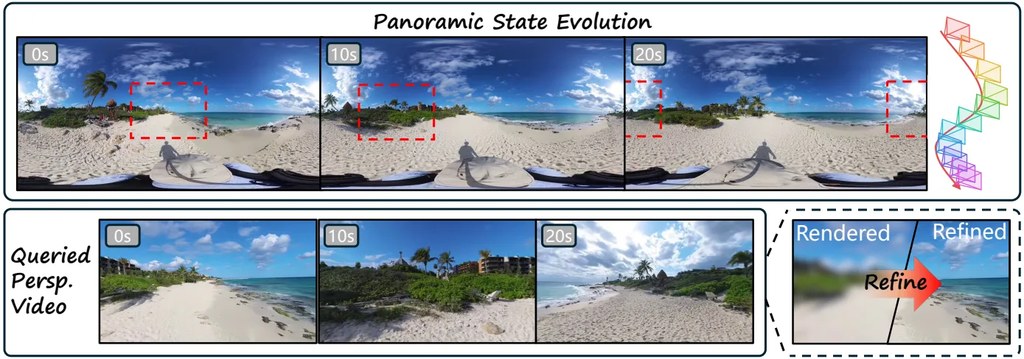
AlayaVista evolves panoramic states under camera control and renders and refines the requested perspective views.

想由一張普通圖片,邊拉鏡頭邊即時生成高質影片,而又唔丟失 360° 場景記憶?AlayaVista 就係為呢個矛盾而設計——佢屬於世界模型(World Model)類研究原型,處理嘅係可控、可串流嘅影片生成問題。

核心做法分三步:先用一張透視圖估出完整 360° 全景先驗,模擬出 VR 風格嘅場景記憶;之後鏡頭控制訊號會驅動呢啲全景潛態持續演化,保持全局一致性;最後系統只渲染用戶當前視角所在嘅區域,並用潛態視口渲染與局部精煉做高保真合成。為咗兼顧速度與質素,佢採用 chunk-autoregressive 逐區塊自迴歸生成,配合少步蒸餾(few-step distillation),令串流過程唔使逐幀重頭計,全部運算力集中在真正需要輸出嘅視窗。

比起傳統逐幀擴散或全景一次性輸出嘅做法,呢種「全景當記憶、視口當輸出」嘅分工換嚟兩個明顯取捨:視窗畫面更銳利、代價係鏡頭一轉就要重新做視口對齊;同時間全景一致性同幀率都受惠於 chunk 邊界設計,對長鏡頭平移類場景特別友好。

幾個重點摘要:

  • 全景記憶 + 局部渲染:以 360° 全景潛態維持場景上下文,鏡頭視口獨立精煉,避免整段重算。
  • 鏡頭可控串流:支援 user-controlled camera 訊號輸入,邊互動邊生成適合遊戲引擎、VR 預覽或 cinematic pre-vis。
  • 效率設計:chunk-autoregressive 加 few-step distillation,專注運算力於選定視窗。
  • 仍屬研究階段:roadmap 列明推理代碼同預訓練權重尚未釋出,目前只可睇 paper 與 project page 嘅 demo。

呢類模型對做互動敘事、VR 內容預覽、遊戲關卡 walkthrough 嘅團隊最有直接參考價值,因為佢直接處理「鏡頭會行、背景要穩」呢個常見卡位。對純做離線一鍵出片嘅用家嚟講,呢類串流設計嘅優勢未必即刻見效,但對需要低延遲、長時序一致嘅創作流程,呢條技術路線值得留意。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 框架, 教學

Page 2 of 26
1 2 3 4 … 26