EnvHarness 讓靜態環境按代理弱點持續進化

EnvHarness 不改動環境內部程式碼,透過可堆疊元件調整任務、規則與觀察,讓代理獲得更有針對性的訓練。

example

Google Cloud AI Research 聯同 Washington University in St. Louis、Google Cloud、University of North Carolina at Chapel Hill 的研究人員,開發了 EnvHarness。這個開源框架處理的是大型語言模型(Large Language Model,LLM)代理面對靜態互動環境時,任務和回饋無法隨能力變化的問題;它保留原有環境及驗證器,改由外加層控制代理所見、可做的行動和起始狀態。

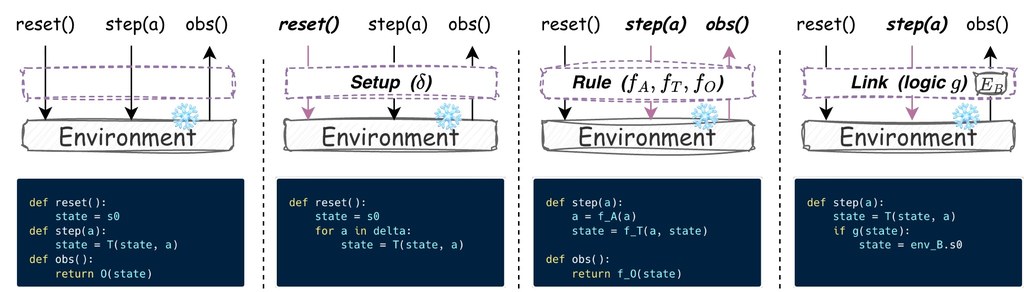
代理在同一批任務上反覆練習,往往會很快解完,環境卻不能因應弱點提供新挑戰。EnvHarness 是一個面向代理學習的開源框架,透過標準 reset/step 介面包裹固定環境,調整代理的起始狀態、可用行動與觀察內容,同時保留原有的成功判定器。

它把控制拆成三類可組合元件:Setup 負責重塑初始狀態,Rule 改變互動規則、行動限制及回饋,Link 則把另一個環境的任務接入目前流程。設計者代理會讀取目標代理的操作軌跡,診斷失誤,再以 Python 寫出元件、測試及修訂,令訓練環境隨代理能力一同調整。

• 不需修改 ALFWorld、WebArena、SWE-bench Verified 等環境的內部程式碼
• 任務與 verifier 保持來源 benchmark 的可信判定
• 元件可自由堆疊,適合針對特定弱點改造互動流程
• 可在項目提供的瀏覽器 Playground 以 Toy24Env 觀察環境狀態與代理視角

在 ALFWorld、WebArena 及 SWE-bench Verified 的 EnvHarness 訓練結果分別達到 68.3、41.6 及 52.6,展示相對基準最高 5.9 個百分點的提升。不過,效果取決於設計者代理能否準確診斷軌跡,以及改寫後的環境是否真的對應目標弱點,並非單靠套上元件就能保證改善。

它的取捨是把環境設計工作轉移到 Setup、Rule、Link 的程式編寫與反覆測試,換來跨 benchmark 重用和較低的環境改造成本。
項目主頁 · GitHub

Categories: 開源, Agentic, Google, Python, Dataset 數據集

FACET-Terminal:讓終端任務由可執行環境先行生成

FACET 把技能、Docker 環境、解法與驗證器連成同一狀態,產出可真正執行驗證的終端任務。

FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis

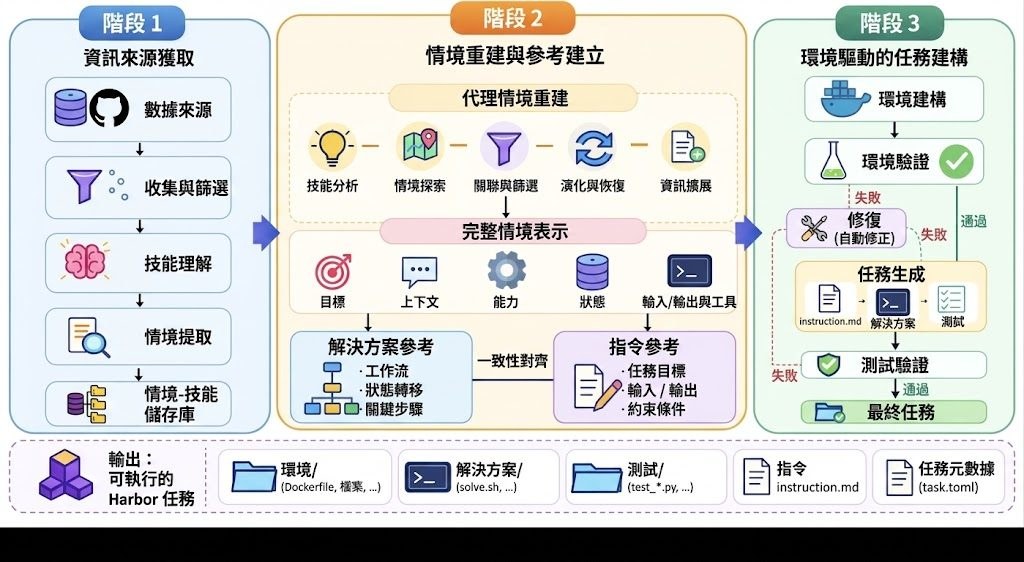
終端 AI Agent 最怕指令寫得合理,環境、解法和驗證器卻互相對不上。FACET(Fine-grained Agentic Construction of Executable Tasks)是一套終端任務合成框架,先建立並修復 Docker 環境,再讓指令、參考解法和驗證器共享同一套執行狀態,處理複雜任務難以穩定測試的問題。

項目由 71,341 個來源技能整理出 7,852 條場景—技能種子,最後取得 6,078 個通過執行驗證的任務,並從成功 rollout 篩選約 1.2K 條完整軌跡,用於監督微調 Qwen3.5 系列模型。環境中的檔案、路徑、套件、連接埠、資料結構和測試資料會沿流程傳遞,減少純文字交接造成的落差。

資源包括 FACET-Terminal-Tasks-6k 數據集,以及 FACET-Terminal-Qwen3.5-4B、9B 和 27B 模型。要重現任務合成流程,需要 Python 3.11–3.13、uv、Docker 和模型 API;配置與 Python 程式集中在 facet/,並提供 FORWARD、REVERSE、JOINT 三種生成策略作比較。

Terminal-Bench 2.1 的三次獨立執行平均結果顯示,4B、9B、27B 模型分別由 17.60、27.34、40.82 提升至 24.72、35.58、47.57;4B 相對提升 40.5%,27B 更接近同設定下 Qwen3.5-397B 的 49.06。這批數據規模仍然有限,任務質素亦依賴 Docker 環境和驗證器是否正確,較適合研究 Agent 訓練、Terminal-Bench 評測及需要可重現終端操作的團隊。

  • 資料基礎:6,078 個通過執行驗證的任務
  • 生成方式:環境先行,指令、解法與驗證器共享狀態
  • 公開模型:Qwen3.5 4B、9B、27B
  • 評測結果:27B 在 Terminal-Bench 2.1 達 47.57
  • 適合場景:終端 Agent 訓練、任務合成及可重現評測

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 模型訓練, API, Python, 中國, Dataset 數據集

RapidLiDAR:單次前向傳播做到 10 Hz 嘅 LiDAR 場景補全

佢將稀疏嘅部分點雲一次性還原成稠密場景,主打即時同可調速度,適合對延遲敏感嘅自動駕駛同機器人開發者。

Repository image for AzharSindhi/RapidLiDAR

對做自動駕駛或機械人感知嘅人嚟講,LiDAR 場景補全最頭痛嘅唔係質素,而係慢——好多現有方法要幾百毫秒先出一幀,根本追唔上車規或即時反應嘅需求。RapidLiDAR 嘅定位就喺呢度:佢設計成一個端到端、單次前向傳播嘅補全模型,目標係跑到接近 10 Hz,同時保留可調速度同可調節輸出密度嘅彈性。

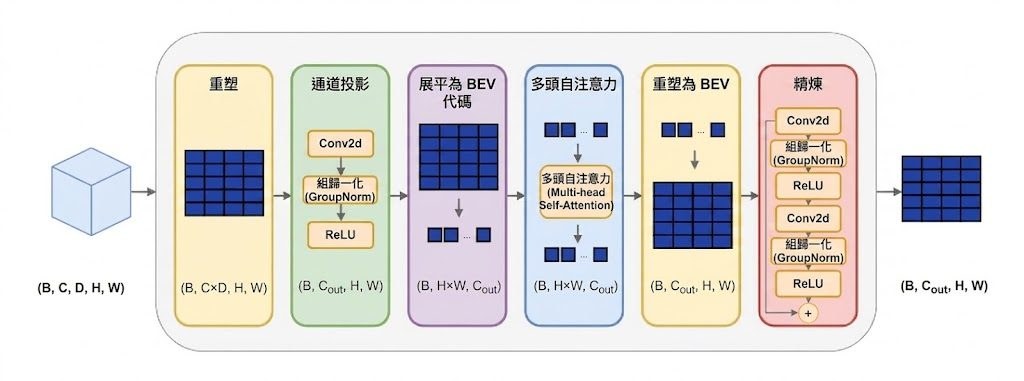
做法上,佢先用體素化抽取多尺度 3D 特徵,再透過一個自注意力 BEV 頭產生密集 2D 特徵圖。Adaptive Initialization Module 會預測一個空間變化嘅位移,把稀疏點雲「撐開」做粗略初始化;之後 Multi-Scale Reconstruction Module 用可變形注意力(deformable attention)將每點特徵同多尺度 BEV 特徵對齊做精修。如果想再稠密仲可以加一個可選嘅 Refinement Network 喺凍結嘅主模型上做上採樣,倍率為 κ。

換句話講,舊方法通常分開做初始化同迭代 refinement,或者用兩階段網絡先粗後細;RapidLiDAR 將呢幾步壓入一次前向,靠 BEV 座標化同可變形注意力同時兼顧效率同幾何一致性。代價係依賴 SemanticKITTI 風格嘅資料 loader,需要 .npy 格式嘅 GT 同 input 配對,唔係 out-of-the-box 處理原始 Velodyne 掃描。

適合做自動駕駛 stack、實時 SLAM、機械人感知原型,或者想喺邊緣裝置上試稠密 LiDAR 預測嘅團隊。原文強調即時性為 10 Hz,具體 mIoU 或 Chamfer distance 等數字未在 README 完整列出,安裝需 CUDA 12.4 同 PyTorch 2.4.1,並要自行 JIT 編譯 Chamfer distance CUDA extension。

GitHub · Paper

Categories: 開源, 模型, 視覺模型, NVIDIA, Robotic, 3D, Python, Dataset 數據集

SemComp-Bench:影片生成評測由「似樣」走向真正完成任務

SemComp-Bench 不只看生成影片是否逼真,還檢查指定結果有否完成,以及關鍵語義是否仍然保留。

Repository image for Kelly372/SemComp-Bench

一段影片畫面流暢、物件外觀相近,不代表它真的完成了指令。SemComp-Bench(Benchmarking Semantic Task Completion in Video Generation)把評測焦點放在「結果有否做到」和「是否仍然保留與任務相關的語義」;GitHub 項目則是一套用來建立 SemComp-Data 的資料處理管線,處理影片篩選、狀態定位、指令整理和結果標註。

由原始影片到可評測資料,流程分成 9 個階段:先按標題過濾及分類任務,再定位 reference frame 與 outcome state,檢查畫面質素和狀態順序,產生中英雙語的簡短及詳細指令,最後抽取 outcome-centric clips、標註 semantic alignment types,並描述結果狀態。這種做法把評測所需的參考畫面、指令和完成結果放在同一段真實影片脈絡中,較適合檢查模型是否真的做到指定改變,而不只是產生看似合理的畫面。

項目屬於影片生成評測的資料集建構工具,實際解決的是把零散影片整理成可驗證、可重複評分的任務樣本。SemComp-Bench 目前提供 1,273 個結構化樣本、6 個真實世界領域、60 個 SemComp-Core cases,平均 outcome-centric clip 約 4.03 秒,並配有兩種指令、四類 reference alignment types,以及 27 個評測取樣畫面。

使用者需要 Python 3.10 或更新版本、ffmpeg、ffprobe,以及供第 2 至第 5 和第 7 至第 9 階段使用的 multimodal model service;第 6 階段的 ImageBind inference 建議使用支援 CUDA 的環境。原始影片、模型權重、服務憑證和執行輸出均不隨儲存庫提供,因此較適合研究團隊按自己的影片及模型服務重建資料,而不是下載後即時取得完整數據集。

  • 以 outcome achievement 配合 semantic grounding,避免只用畫質或 prompt alignment 判斷成功
  • 透過 reference frame、outcome state 和短片建立完整評測三元組
  • 1 至 7 階段通常會輸出 snapshot、excluded set,技術失敗另有 error.parquet
  • 可用 tests/ 的離線回歸測試檢查處理流程
  • splitting/ 含改編自 Panda-70M 和 ImageBind 的元件,非商業授權限制需要先審閱

對研究生成影片、製作評測數據,或需要分析任務完成率的團隊而言,這套管線提供了清楚的重建入口;但它依賴外部多模態模型服務和本地媒體資源,資料建立成本與授權審查仍是採用前必須計算的部分。

項目主頁 · GitHub · 數據集

Categories: 開源, 視覺模型, 多模態模型, NVIDIA, Video, Python, Dataset 數據集

Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

TRACE-Bench 拆解多參考生圖失誤來源

多張參考圖生成得似,未必代表每個要求都做對。TRACE-Bench把失誤拆成可追蹤能力,方便看清模型真正卡在哪裏。

Og image

生成圖片時同時引用多張參考圖,最難的地方往往唔係畫面夠唔夠完整,而係模型有冇準確保留指定主體、抽出正確屬性,再綁到啱嘅目標上。TRACE-Bench屬於 Multi-Reference Image Generation Benchmark,處理的正是這類「成品看似合理,但細節要求逐項出錯」的評估問題。它不再只用一個總分判斷好壞,而是把每條提示拆成可追蹤的能力步驟,讓研究者知道錯誤發生在身份保留、屬性抽離、屬性綁定,還是多元素構圖。

這個基準最核心的做法,是用四個原子操作統一資料建構、評分與診斷流程:Anchor負責鎖定並保留參考主體的身份特徵,Disentangle負責把某個屬性從原本載體抽離,Apply負責把抽出的屬性自然地套到指定目標,Compose則負責在空間、關係或整體場景限制下安排多個內容。TRACE-Bench把每個 prompt 表達成 compositional formula,令多參考生成不再只按「風格轉移」或「主體組合」這類粗分類來看,而是按能力需求逐層拆解。

它和常見 benchmark 的差異,在於評估單位由任務類型改成能力組合。原有做法容易出現覆蓋不足、案例難度難比較、失敗原因不透明等問題;TRACE-Bench則把同一套公式結構用於案例生成與對齊評分,並要求參考資訊有精準 grounding。資料規模方面,這個 benchmark 約有1,600個 evaluation cases、631個公式模板、約4,000張 reference images,覆蓋1至8個 operator slots,並評估了9個領先模型。現有結果顯示,真正的瓶頸主要落在 attribute disentanglement 同 binding,不是單純的場景級 composition。

對模型研究、影像生成工作流設計,甚至要挑選評測方法的團隊來說,TRACE-Bench的價值在於它能把「生成得唔錯」這種籠統印象拆成具體能力地圖。當案例失敗時,它還會用遞迴簡化方式做 diagnosis,逐步定位干擾來自哪一個參考需求。對於想改進多圖條件生成、測試 reference-following 能力,或者分析模型為何經常把屬性套錯對象的人,這種可追溯結構比單一總分更有用。

  • 用四個操作符描述多參考生成:Anchor、Disentangle、Apply、Compose。
  • 每個 prompt 都可寫成 compositional formula,方便控制複雜度與對齊評分。
  • 約1,600個案例涵蓋1至8個 operator slots,資料來自約4,000張參考圖。
  • 九個模型的評估結果指出,屬性抽離與屬性綁定比場景構圖更常成為瓶頸。
  • 原始資料聚焦 benchmark 設計與診斷方法,未提供一般讀者可直接下載或部署的完整使用流程。

整體來看,TRACE-Bench不是再增加一批「看圖感覺差不多」的測試題,而是把多參考生圖最難處理的依賴關係寫成可分析、可比較、可回溯的結構。當模型要同時記住誰是誰、哪個屬性要抽出、又要套到哪個實體上時,這套方法更能反映能力上限與失誤模式,也讓後續改進有更清晰的落點。

項目主頁

Categories: AI productions, Image, 框架, Dataset 數據集

HarnessEval-W 讓世界模型評測留下可核查推理鏈

世界模型評測不再只給一個分數,HarnessEval-W把每次判斷拆成可追溯的證據樹,讓物理與因果錯誤更容易核對。

HarnessEval logo

當世界模型生成一段互動場景,真正難判斷的往往不是畫面是否漂亮,而是物理、因果和世界狀態有沒有隨行動正確演變。HarnessEval-W 屬於開源的 agentified benchmark,實際處理的是如何把這些需要理解上下文的評測工作,轉化成可檢查、可重現的判斷流程。

它借用 Large Language Model(LLM)生態常見的 harness 思路,先按每個 evaluation case 的初始世界、action 和 probe intent 分解問題,再由具備不同工具與上下文的 specialized sub-agents 分工判斷,最後由 parent agent 驗證證據並整合 verdict。每次評測都會留下 evidence tree,記錄測試內容、視覺依據和完整推理鏈,研究團隊可以追查分數由何而來,而不是只接受一個難以解釋的 scalar score。

  • 支援 330 個 evaluation cases、5,940 次 scored rollouts
  • 以 11 個 specialized evaluation skills 覆蓋品質、轉換與持續性
  • 涵蓋 18 個 world models,並提供 leaderboard 與可執行評測程式
  • 包含 harnesseval-metrics,以及 physical-plausibility backend harnesseval-pavrm

HarnessEval-W 在 intentional transition 上與人類 Bradley–Terry ranking 的 Spearman correlation 為 0.93;physical transition 的 pairwise accuracy 達 71.7%,高於 WBench 的 31.9%。重複評測的結果範圍亦較 WBench 窄 4.9 倍,但這些數字仍取決於案例設計、技能路由和代理判斷品質,不能直接視為所有世界模型任務的通用排名。

項目提供固定 plans、benchmark 資源、metric backends 和可延伸的 skill library;團隊可以先重現既有 cases,再提交新世界、新 action、新 probe family 或新 skill。它較適合研究世界模型、建立可審計評測流程,或需要比較物理合理性與狀態持續性的團隊;對只想快速取得單一分數的測試流程而言,完整證據樹會增加運算與整合成本,但換來更清楚的錯誤定位能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, 世界模型, 庫, Dataset 數據集, Skill 技能

PACE-Bench:專測機械環境變化下的自我演化能力

PACE-Bench 針對環境突變後的適應力做評測,重點不是能否第一次做對,而是能否把原本成功的設計改到再次通關。你可以把它理解成一個用物理模擬驗證自我修正能力的基準。

S-01 Bridge Construction: source design passes, fails after mutation, self-evolves, and passes the target environment

PACE-Bench 是一個用來測試自我演化 agents 的基準,核心問題是:當原本可行的 code-driven design 因為環境改動而失效,系統能否靠互動回饋把它改回可行。它更像是在驗證適應能力,而唔只是看一次性解題。

這個項目把 144 組 source-to-target 配對放入 6 類物理場景,要求 agent 先在 source 環境成功,再在 hidden mutation 後的 target 環境重新修正。每次修訂都要經過執行驗證,JSON 會保存,--save-gif 亦可記錄每次通過驗證的嘗試動畫。

同類評測多數固定執行條件,PACE-Bench 直接把變化放進任務核心,逼系統面對失敗後的再設計。它用 OpenAI-compatible endpoint 跑模型,--base-url、--model、--api-key 與 --workers 這些參數都對應實際部署需要,較適合拿來接自家推理服務做批量評估。

從公開結果看,Reflexion 在 Pass@2 上領先,但 Tree-of-Thoughts 在成本效率更高,說明多做自我修正不一定換到更好的性價比。這類基準特別適合做具身智能、仿真控制、研究自我修正流程的團隊,用來檢查模型在新條件下是否真能靠回饋改對,而唔係只係記住舊解法。

  • 針對環境突變後的適應能力,不是單次解題
  • 以執行驗證驅動每次修訂,結果可重現
  • 支援接入 OpenAI-compatible 服務做評測
  • 結果顯示準確率與成本效率未必同步提升
  • 適合研究 self-evolving agents、控制與物理模擬

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, Qwen, API, Dataset 數據集

Tencent UI-Mate 桌面操作示範變成可重用工作流

開源權重的通用 GUI 智能體:環境驅動訓練 + 上下文演示學習——流程演示一次即可,不必把所有約定寫進提示。

UI Mate icon

很多桌面任務難寫成一段完整提示,問題不在指令太短,而是在檔名規則、視窗擺位、公司流程這些細節往往靠示範更容易講清。UI-Mate 就是朝這個位置切入的開源 GUI agent 項目:它在原生桌面看螢幕畫面,用鍵盤和滑鼠跨應用程式執行長流程工作,並且支援把一次人手操作示範轉成可重用工作流。

UI-Mate 把示範當成建議。當畫面內容、資料、視窗狀態或任務目標有變化,代理仍會按即時畫面重新判斷,避免變成只懂重播錄製腳本的 Computer-use agents(CUAs)。這個取捨很重要,因為它直接回應了 GUI 自動化最常見的失敗位:流程相似,但畫面從來不會完全一樣。

訓練方法亦反映它想處理真實環境,而不只是跑單一 benchmark。項目提到 closed-loop data engine,會串連任務合成、環境建構、rollout、驗證與 filtering,再用 capability tree 補回覆蓋不足的能力;同時支援 Ubuntu、Windows 和 macOS 的統一 rollout layer,並以 asynchronous group-relative optimization 處理長而且變化大的 rollout。整體方向很清晰:先把可執行環境和驗證機制搭好,再談代理怎樣學會跨系統做事。

公開結果亦有參考價值。UI-Mate 在 OSWorld-Verified 達到 77.0%,WindowsAgentArena 為 66.2%,而 OSWorkerBench 嚴格成功率 41.0%、progress 76.9%;加入一次 same-task demonstration 後,OSWorker self-demo strict success 由 17.2% 升到 35.4%。這些數字未必代表它已經能穩定接手所有桌面工作,但至少說明示範式引導不只是概念包裝,對長流程任務有明顯幫助。

  • 屬於開源 GUI agent 項目,重點是處理跨應用、跨作業系統的長流程桌面任務
  • 核心差異在於支援 in-context demonstrations,把一次示範整理成可重用工作流
  • 示範不是腳本重播,代理會按 live screenshot 即場重新規劃
  • 較適合需要固定流程但畫面與資料經常變動的團隊、營運與辦公自動化場景
  • 目前已公開模型與結果,但 OSWorkerBench 等配套仍有部分內容標示為 Coming Soon

部署與理解方式上,現有資料較接近研究原型加可試權重,而不是開箱即用的完整產品。官方已放出 code、weights、technical report 和 Try App,較合理的看法是先把它當成可驗證 demonstration-guided GUI agent 能力的開源基線,再看後續 benchmark、資料集與工具鏈是否補齊。對研究 GUI agent、企業桌面自動化,或者想比較文字指令與示範引導差異的團隊,這個項目很值得跟進。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, Mac, Linux, Dataset 數據集, UI/UX

ClawGym:為 Claw 類代理搭建可訓練環境

ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

Page 9 of 29
1 … 7 8 9 10 11 … 29