GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

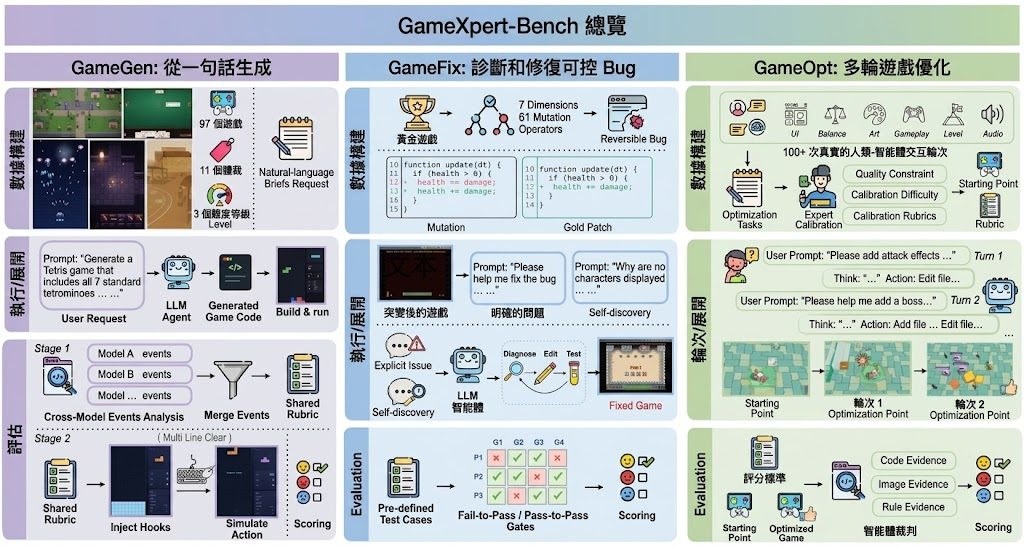
這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

PhysCaP 讓機械人用互動摸清物件物理特性

當視覺無法分辨重量或軟硬,PhysCaP會主動安排互動,讓機械人用更少動作完成操作任務。

Og image

由國立台灣大學、NVIDIA Research、Google DeepMind 及國立陽明交通大學研究人員組成的團隊,推出 PhysCaP,將物理資訊探索加入 Code-as-Policy 機械人代理。

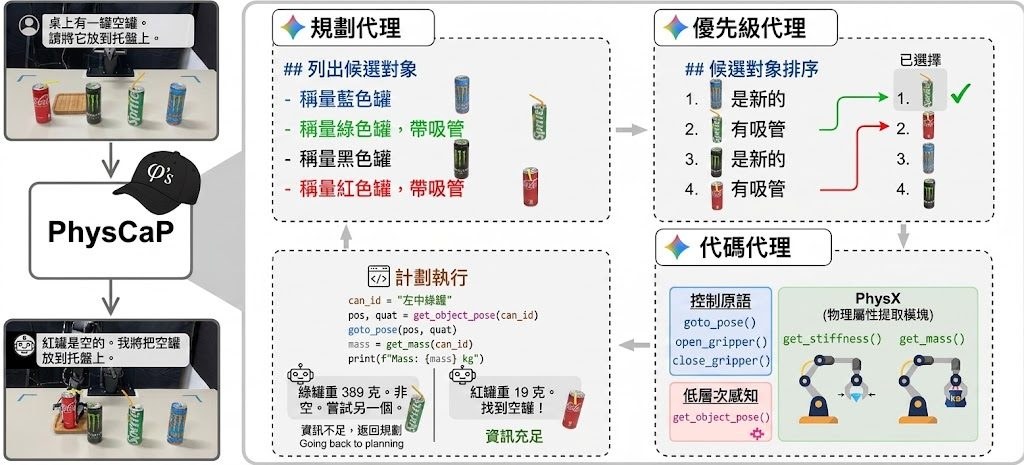
當機械人只靠相機無法分辨哪罐是空的、哪個牛油果已熟,PhysCaP會主動安排提起、夾取等互動,從動作反應推斷隱藏的重量與硬度。這個 physics-informed Code-as-Policy agents 項目,針對被動視覺不足時的機械人操作問題加入主動感知能力。

PhysCaP以雙代理探索框架配合可執行程式碼。Planner先判斷視覺資訊是否足夠,Prioritizer再按預期 information gain 排序互動,過濾不合理或重複的動作,最後呼叫 PhysX(physical property extraction modules)中的 get_mass 和 get_stiffness。

  • 透過 joint-torque 差異及 end-effector Jacobian 估算物件質量
  • 根據 gripper displacement 和 normalized motor effort 分類硬度
  • 無需額外感測硬件,直接利用 robot proprioception
  • 涵蓋找藍色方塊、辨認空罐和挑選熟牛油果
  • 模擬與真實任務中,部分結果達到 9/10 成功率

測試亦包括 LIBERO Empty Can 模擬環境。研究結果指,這種按資訊價值選擇互動的方式,在多項 benchmark 中較被動方法和直接進行互動的方法取得更高任務成功率,同時減少互動次數及執行時間;不過,推斷質量和硬度仍取決於固定提舉軌跡、重複測量及機械人本身的 proprioception。

項目主頁

Categories: Agentic, 模型訓練, Google, NVIDIA, World-Action Model, Robotic, 框架, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

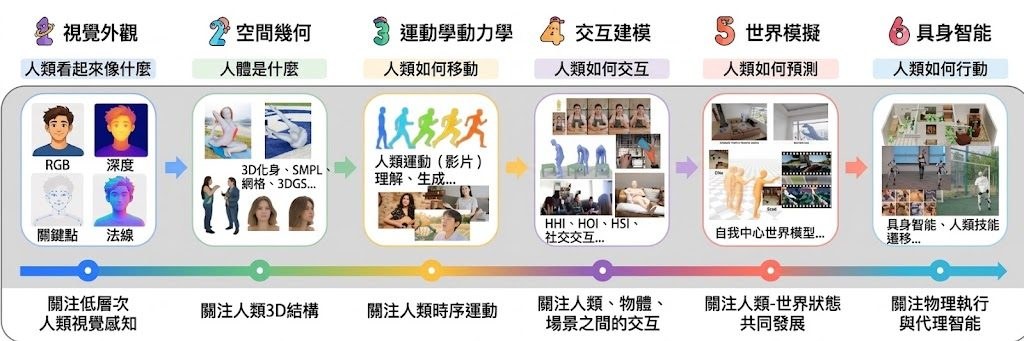
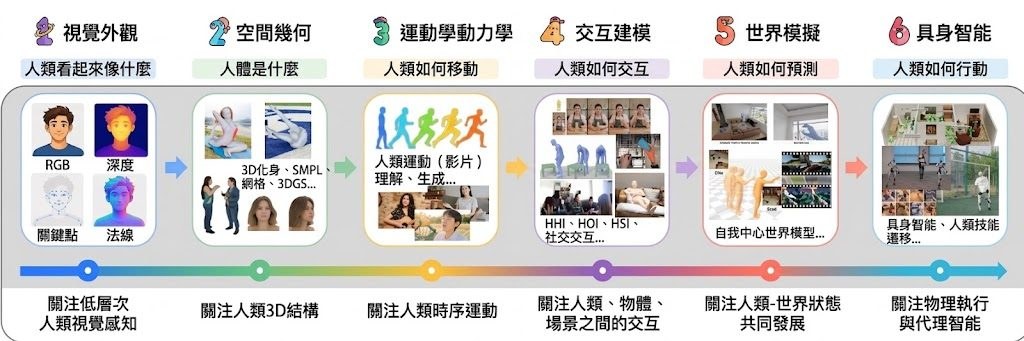
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

UniSpace:把理解、生成與編輯放進同一視覺空間

UniSpace 嘗試用同一套視覺表示處理影像理解、生成與編輯,但首個程式版本仍未包含訓練流程。

UniSpace logo

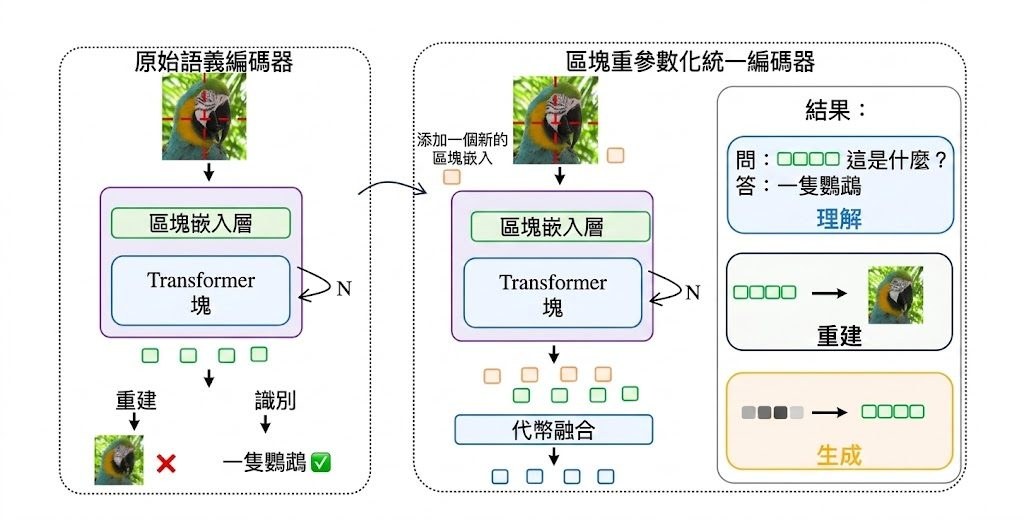
影像模型往往要在語意理解與畫面細節之間取捨,UniSpace 以統一視覺表示同時處理理解、生成和指令式編輯,定位是多模態模型及推理評估項目。它由 patch-reparameterized vision encoders 和 Qwen3-8B Mixture-of-Transformers 組成,前者保留預訓練模型的語意能力,再補足重建與生成所需的細節。

三款 encoder 分別是 PR-SigLIP2、PR-DINOv2 和 PR-Qwen-ViT;UniSpace 則使用配備 Qwen-based patch-reparameterized tokenizer 的視覺空間。這種分工讓同一套表示可以連接理解、文字生成影像及影像編輯,但也代表模型效果取決於 encoder、tokenizer 和多模態 backbone 能否協調工作。

ImageNet-1K 256 × 256 重建測試使用 50,000 張驗證影像,PR-DINOv2 取得最高 PSNR 30.84、SSIM 0.90 和最低 rFID 0.14。生成測試同樣使用 50,000 個樣本;PR-DINOv2 配合 Classifier-Free Guidance (CFG) 後,gFID 為 1.877、IS 為 274.16,但 Recall 由 0.637 降至 0.605,反映畫面品質與覆蓋範圍之間仍有取捨。

目前最需要留意的是可重現性,而不是安裝難度。儲存庫屬於 paper-time landing release,首個程式版本只會提供 inference 和 evaluation,訓練程式及內部數據管線不公開;在預期檔案和 checkpoints 尚未完整發布前,fresh clone 不能直接執行命令。研究團隊、模型評測人員和需要比較視覺 encoder 的開發者可先參考固定 seed、採樣步數及評測規則,待穩定版本發布後再驗證結果。

  • 能力範圍: 統一支援影像理解、生成與 instruction-based editing。
  • 模型關係: PR-SigLIP2、PR-DINOv2、PR-Qwen-ViT 提供視覺表示,Qwen3-8B Mixture-of-Transformers 負責多模態處理。
  • 評測結果: PR-DINOv2 重建 rFID 0.14,UniSpace GenEval 整體分數 0.84,DPG-Bench 為 86.49。
  • 限制: 目前欠缺可由 fresh clone 直接執行的完整程式、訓練流程及內部數據管線。

項目主頁 · GitHub

Categories: 開源, 多模態模型, Qwen, Clone, Dataset 數據集

OmniAssistBench:以多輪互動評測即時影片助手的表現

OmniAssistBench 以 LLM-as-a-Judge 固定互動路徑測試 Omni-LLMs 的多輪影片助手能力,涵蓋685組開放式問答、7類任務,影片含自然語音、打字或手寫提示。評分顯示 Gemini-3-Pro 以66.4分領先。

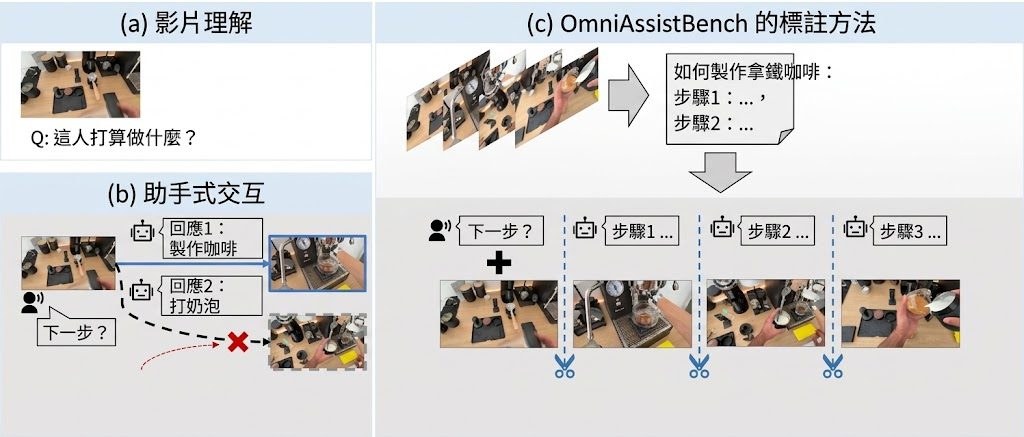
OmniAssistBench proposes an annotation pipeline which allows annotators to build test samples from existing Internet vid

當影片助手的回答會改變使用者下一步行動,傳統只對固定影片問答的測試便難以反映真實體驗。OmniAssistBench 屬於 Omni-LLMs 的影片助手評測基準及數據集,透過固定互動路徑,處理多輪對話中影片內容會隨模型回應變化的問題。

項目涵蓋 685 組開放式問答,分成 Basic Tier 與 Advanced Tier,涉及社交理解、時間感知、手勢提示、程序指導及主動回應等 7 類主要任務和 16 類細分任務。影片取材自運動、煮食、講課、DIY 及談話節目,另有 3 個自行拍攝案例,每個平均超過 15 輪互動;問題會以自然語音、打字或手寫方式嵌入影片,而不是只放文字提示。

  • 以影片連同對應音訊輸入模型,再按互動回合回答問題
  • 由專家先整理影片步驟,再剪輯片段及加入字幕,固定測試路徑
  • 評分採用 LLM-as-a-Judge,原始 0 至 5 分再換算為 0 至 100
  • 建立數據集耗用超過 1,000 小時專家工時

這種做法比靜態影片問答更貼近助手場景,但固定路徑亦代表其他合理回應未必能在同一測試中獲得充分反映。Project homepage 的排行榜顯示,Gemini-3-Pro 整體得分為 66.4,Gemini-2.5-Pro 為 64.6,商用及開源 Omni-LLMs 都只達部分正確,反映可靠的即時影片助手仍有明顯改進空間。

研究團隊來自南京大學、南開大學及 University of Waterloo。測試者需要按照項目提供的評測流程處理影片和音訊,相關 Dataset、Project Page 及評估程式碼可供查閱;正式採用前應先確認版本、存取權限及評分流程是否已更新。

項目主頁 · GitHub

Categories: 開源, 南京大學, 字節跳動, Qwen, Gemini, Dataset 數據集

AgentMercury 生成可驗證商業世界

把企業情境轉成可執行環境,讓AI代理在多服務流程中訓練,再轉移到未見過的評測項目。

Og image

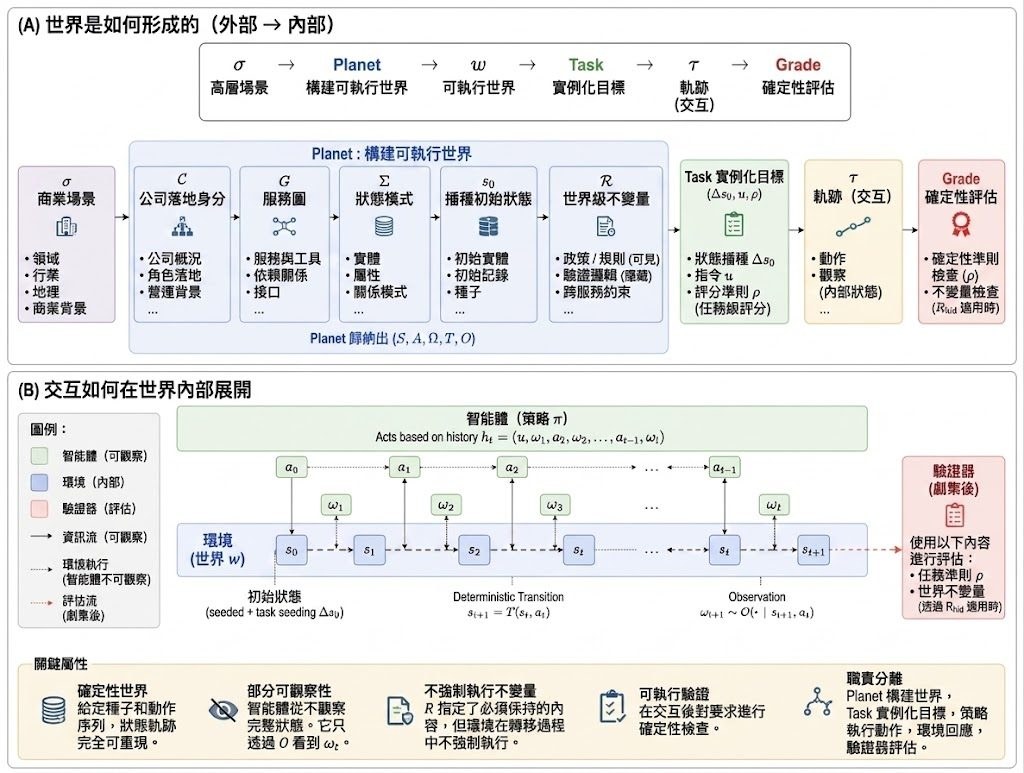
當AI代理要處理跨部門企業流程,難點往往不只在於選擇工具,還要在多個服務之間維持一致狀態,最後交出可以核實的結果。AgentMercury是一個用於訓練 Computer-use agents(CUAs)的環境生成項目,讓高層次商業情境直接變成可執行、可重播和可驗證的虛擬世界,代理可以在其中進行多輪操作,而系統會按完成後的狀態計算獎勵。

常見做法會先為指定任務或 benchmark 手工建立環境,環境自然只覆蓋測試者預先想到的流程。AgentMercury則把環境建構本身交給 Planet:它由公司身份、服務圖、資料表結構、初始狀態和跨服務不變條件組成一個完整世界,再由 Task 在共享世界上加入不同目標和評分規則。一個世界可以承載多個任務,減少每個新流程都要重新造環境的成本。

驗證條件主要以環境資料庫上的 SQL 形式執行。代理完成一輪操作後,系統會根據任務 rubric 和隱藏的不變條件,對整條 trajectory 進行確定性評分;環境不會在每一步替代理判斷對錯,代理必須自行處理跨服務要求,完成後才接受檢查。這種安排讓結果可以重播,也令 Reinforcement Learning(RL)訓練得到較穩定的回饋。

目前項目整理出4,783個 executable worlds,涵蓋14個產業和50個國家,包含13.98M seeded state rows、842種工具和43,300個可驗證 RL 任務。典型世界約有13項服務、65種工具、31張狀態表,以及約15個以 SQL 編寫的 deterministic verifiers;訓練資料涉及4,326個公司環境,但 Qwen3.5-4B 的報告只使用其中3,200個任務取得梯度,仍覆蓋53.5%的環境、62.9%的產業和75.8%的工具。

項目以 Qwen3.5-4B 和 Qwen3.5-35B-A3B 進行 RL 訓練,代理透過 Model Context Protocol(MCP)操作即時形式的商業軟件,並以 GRPO(Group Relative Policy Optimization)為主要優化方法,SAO 則作為另一種選項。Qwen3.5-4B 的平均獎勵約由0.25升至0.53,截斷回應比例由78%降至3%;在未參與訓練的 EnterpriseOps-Gym 八個企業領域,平均分數由12.3升至15.7,增幅為27.6%。35B-A3B 使用 GRPO 和 SAO 後,平均分數分別由24.8升至28.1及28.3,但結果仍屬項目所報告的訓練和評測範圍,未代表代理已能可靠處理所有企業工作。

  • 將高層次商業情境編譯成可執行世界,而不是只為單一任務造環境
  • 以共享資料庫、SQL 驗證條件和可重播評分檢查跨服務結果
  • 提供4,783個環境、842種工具和43,300個可驗證 RL 任務
  • Qwen3.5 系列在多輪 MCP 工具操作訓練後,獎勵和未見領域表現均有改善
  • 仍需留意合成環境與真實企業軟件之間的差距,以及評測範圍有限的問題

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, Qwen, Dataset 數據集

[技術文章]LLM 媲美 Embedding,成本卻高逾 1431 倍

LLM已能追上頂尖Embedding模型,但搜尋系統未必值得因此承受高昂成本。

Hugging Face

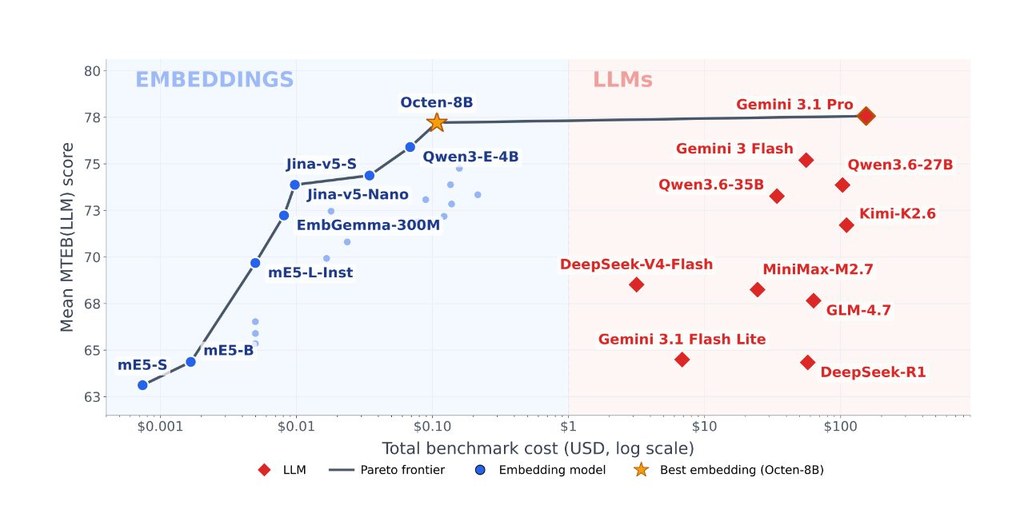
做語意搜尋、分類或文件聚類時,LLM已能在多項測試追上專門的文字嵌入模型;但每次評測成本最高相差1,431倍,令「是否應取代Embedding pipeline」成為成本與能力之間的取捨。本頁屬研究論文內容,並非可直接下載的單一模型頁面;未有提供可確認的 base model 或 fine-tuned from 資訊,因此無法判定某個模型的原始基礎模型。

研究比較10個、來自6個家族的 large language models (LLMs),以及26個參數量由118M至14B的 embedding models,測試涵蓋37項 MTEB(LLM) 任務,包括分類、semantic textual similarity (STS)、聚類、pair classification 和 retrieval。最佳 LLM Gemini 3.1 Pro 得分77.6,最佳 embedding model 得分77.2,差距只有0.4分。

  • Embedding models 在分類、相似度和聚類表現較合適
  • LLM 在需要推理的 retrieval 任務較有優勢
  • LLM 每次 benchmark pass 成本約154美元,embedding model 約0.11美元
  • 開源 LLM 在同一 GPU 上慢約2.5至736倍
  • reasoning tokens 佔 LLM inference 成本28%至81%

研究亦指出,降低 reasoning budget 對多數模型的 retrieval 品質沒有明顯傷害,反映混合式流程更合理:以 embedding model 負責大部分相似度搜尋,再把需要理解語境或多步推理的查詢交給 LLM。

Paper

Categories: Embedding, Qwen, Gemini, LLaMa, Ollama, Dataset 數據集, Kimi

video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, Agentic, AI productions, OpenAI, Video, Anthropic, Dataset 數據集, Skill 技能

WithEveryone 多人合照不再撞臉

復旦大學、騰訊混元與香港大學研究團隊,嘗試一次保留五至十個人物身份的群組生成。

WithEveryone teaser

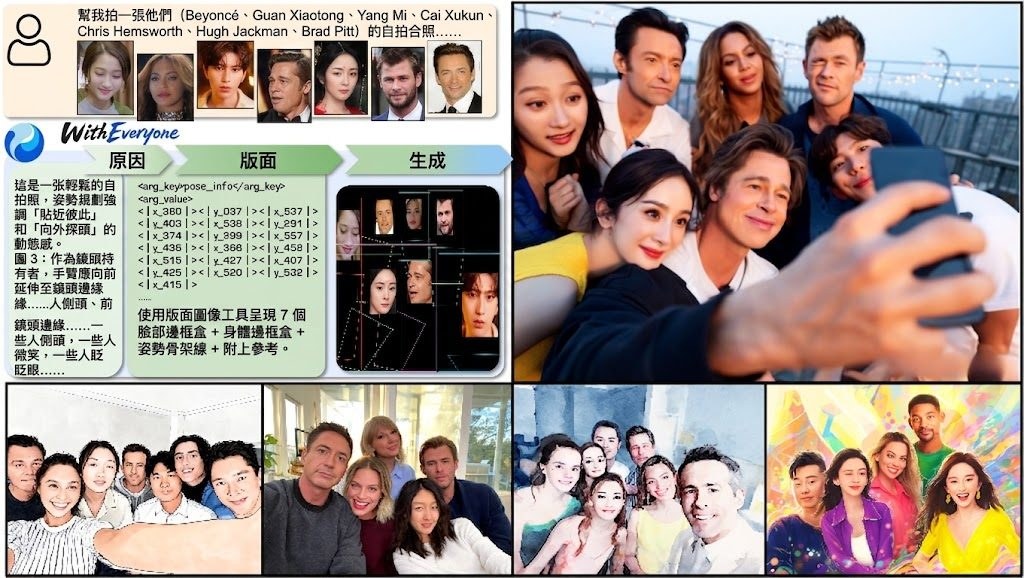
復旦大學、騰訊混元(Hunyuan)及香港大學的研究團隊共同開發 WithEveryone,針對 AI 生成多人合照時人物身份容易混淆的問題,讓五至十個參考身份可以同時出現在連貫場景中。它屬於群組影像生成研究項目,核心價值是維持每個人「誰是誰」的對應關係,而不只是增加畫面人物數量。

系統會把每個參考人物轉換成獨立的 identity token,再透過 Layout CoT 預先推理人物、臉部、身體區域與姿勢的位置,最後交由 renderer 生成視覺條件。Layout-Grounded ID Loss 會在指定臉部區域提供身份監督,ID Representation Forcing 則要求模型在合成前先為每個身份建立預測,減少多人場景中的錯配。

研究展示提供了 63 組生成結果,並在 identity-disjoint benchmark 上比較身份保真度與複製參考圖程度:WithEveryone 的 ArcFace similarity 為 0.614,高於 GPT-Image-2 的 0.566;Copy-paste score 為 0.055,低於 GPT-Image-2 的 0.169。這表示它一方面維持人物特徵,另一方面較少直接照搬參考圖,但目前資料未提供更完整的速度、硬件需求或不同人數下的細分結果。

目前 GitHub 儲存庫尚未提供可下載的研究版 checkpoint,亦沒有完整安裝及測試流程。原因是研究版本依賴的 foundation model 授權不容許公開 checkpoint;團隊正以支援開源發佈的 foundation model 訓練新版本,待程式碼及 checkpoint 準備好後才會分享。
  • 支援五至十個參考身份的群組影像生成
  • 以 identity token 綁定人物,配合身份感知的版面推理
  • 透過 Layout-Grounded ID Loss 監督指定臉部區域
  • 研究結果在 ArcFace similarity 及 Copy-paste score 上勝過 GPT-Image-2
  • 現階段只能閱讀研究展示,未能按儲存庫資料自行安裝重現

對需要製作多人宣傳照、角色群像或指定人物場景的影像研究團隊,這個方法提供了比單純堆疊參考圖更完整的身份與構圖處理思路。一般創作者暫時仍要等待開源版本,因為未公開 checkpoint 令項目現階段更接近研究展示,而不是可即時採用的生成工具。

項目主頁 · GitHub

Categories: 開源, 香港大學, 騰訊, 模型, 多模態模型, Image, 香港, Dataset 數據集

Page 8 of 29
1 … 6 7 8 9 10 … 29