SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

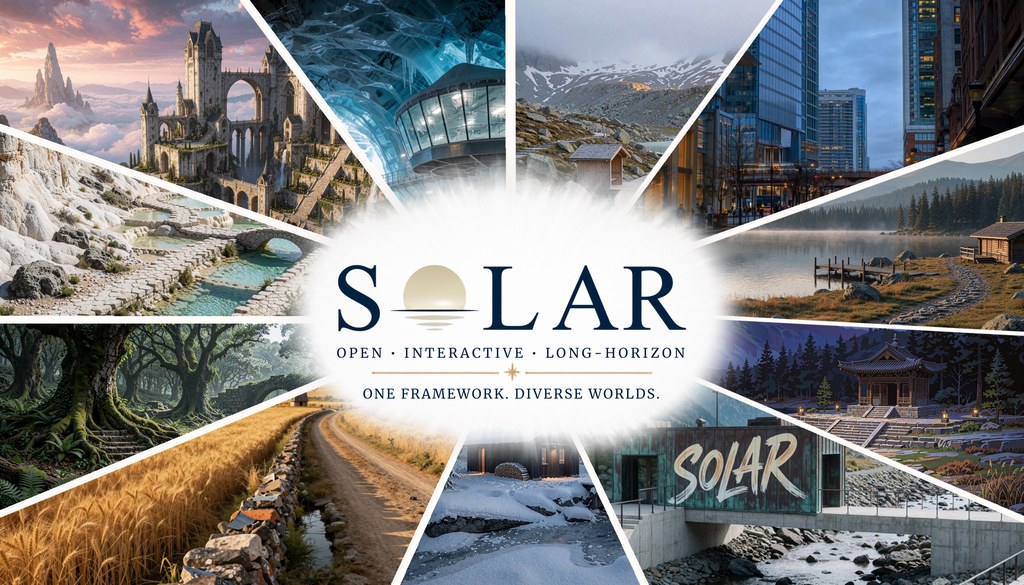
SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。
項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

AREX-Skill 把 GitHub 知識變成可執行技能

AREX-Skill 將熱門 GitHub 儲存庫整理成可驗證、可執行的技能,讓 Coding Agent 在複雜機器學習研究任務中少走彎路。

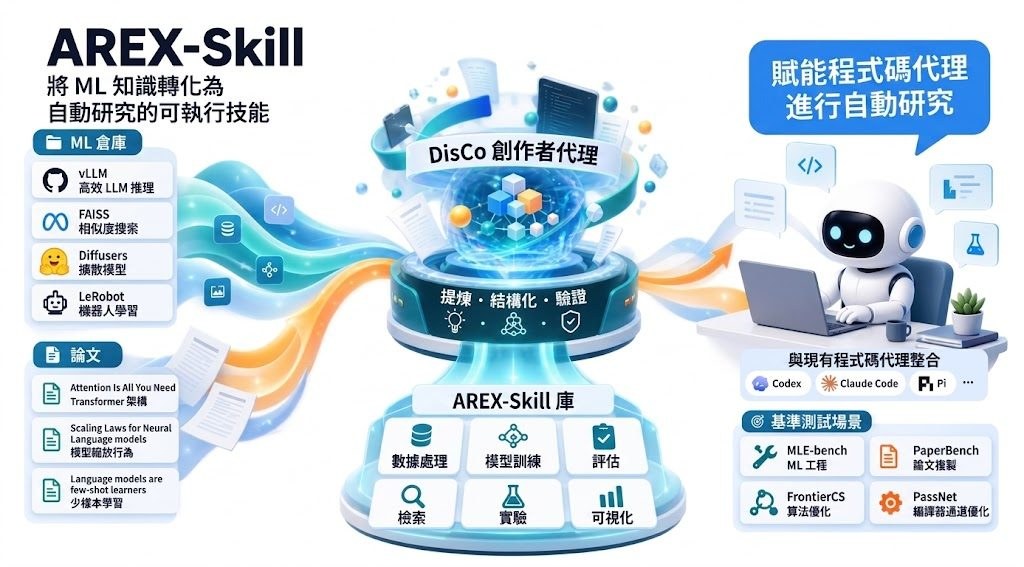
AREX-Skill turns repository and paper knowledge into executable skills for coding agents and autonomous ML research

面對需要查閱多個儲存庫、重現研究流程和逐步驗證結果的工作,AREX-Skill 將分散在 GitHub 的操作知識整理成可重用程序、檢查方法和技能圖譜。它屬於面向 Coding Agent 的開源技能庫與工作流工具,實際處理的是代理有模型能力卻欠缺項目脈絡和操作經驗的問題。

AREX-Skill 已從 1,000 多個熱門機器學習儲存庫提煉超過 5,000 個經驗證、可執行的 skills,並可整合 Codex、Claude Code、Pi 等 Coding Agent。使用時可按任務由 router 從技能庫收窄至相關分支,再由代理執行;DisCo 則負責將儲存庫知識建立、驗證和匯出成技能。

  • 技能包含程序與檢查,而不只是文字說明
  • 技能圖譜協助代理處理跨學科機器學習研究
  • DisCo Meta Skills 支援挑選及使用 Creator meta skills
  • Refreshing Repo Skills 提供維護和更新清單

相較於每次由代理重新閱讀 README、程式碼和論文,技能化做法可把重複的操作步驟預先整理,並將預算集中到較困難的推理工作;代價是技能需要隨儲存庫更新而刷新,覆蓋範圍和驗證品質亦會直接影響結果。儲存庫目前提供 Demo、技能目錄、repository catalog 及 DisCo CLI 文件,適合研究團隊、Coding Agent 使用者,以及需要重現多個 ML 項目的開發者。

GitHub

Categories: 開源, Agentic, Vibe Coding, 編程, Anthropic, Dataset 數據集, Skill 技能

FastH3 Live:單張消費級 GPU 跑出無限 AI 直播

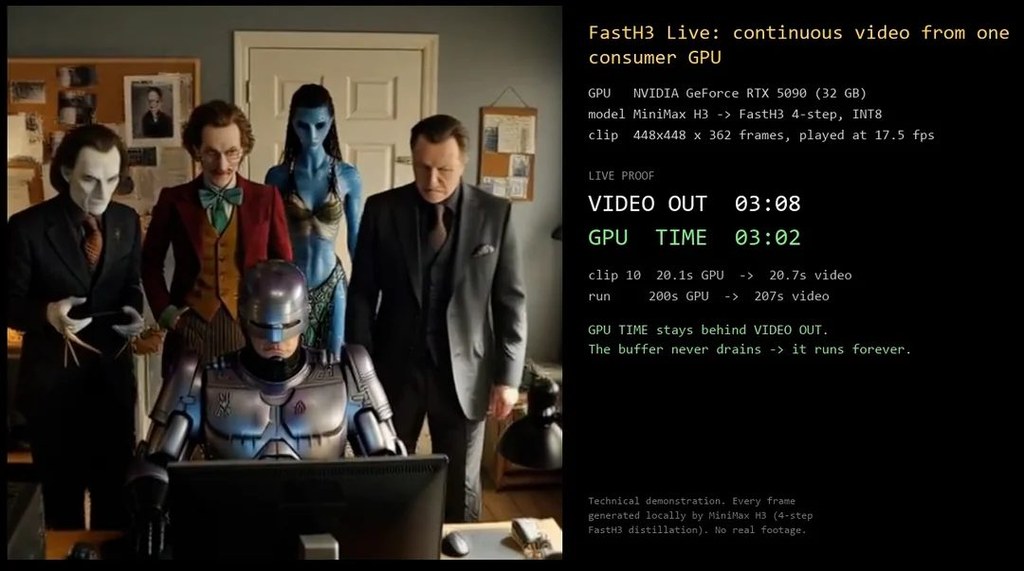
FastH3 Live 將 MiniMax-H3 蒸餾成 4 步模型,配合重定時與 ComfyUI 串流伺服器,用一張 RTX 5090 就能長開 448×448 18fps 嘅無限影片加音訊直播。

Hero image preview

喺消費級硬件上長開一段無止境嘅 AI 影片頻道,一直係文字轉視頻工作流嘅痛點——雲端成本高、本地生成速度慢,仲要面對提示詞同角色一致性嘅限制。FastH3 Live 就係圍繞呢個矛盾設計:佢將 MiniMax-H3 經過 4 步 DMD2 蒸餾成 FastH3,配合一套本地串流伺服器,令生成同播放可以同步進行,前一段影片播放期間,模型已經喺度產出下一段。

整個項目以 ComfyUI 作為運行環境,並喺單張 RTX 5090(32GB、Windows 11)上完成測試。v1.1.0 版本將解析度提升至 448×448、幀率達到 18fps,相比 v1.0.0 嘅 512×288 12fps 有明顯進步。音訊部分亦同步串流,用戶只要用 VLC 指向本地 URL,就可以一直接收新嘅短片,支援多位觀眾同時連線同斷線重連。

對於內容創作者、ComfyUI 用戶或者想試文字轉視頻嘅人來說,呢套工具最直接嘅吸引力係「無限直播」呢個使用場景。項目內附 321 個場景提示詞、503 個已驗證可用嘅角色清單,使用時可以快速組合出唔同長度嘅段落,唔需要每次由零開始寫 prompt。

需要注意嘅限制亦都幾清楚:相關權重屬於 MiniMax-H3 社群授權,適用範圍排除歐盟、英國、韓國同美國,下載前需要確認所在地。

項目主頁 · 數據集

Categories: 開源, ComfyUI, Agentic, 視頻模型, Video, Dataset 數據集, MiniMax

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

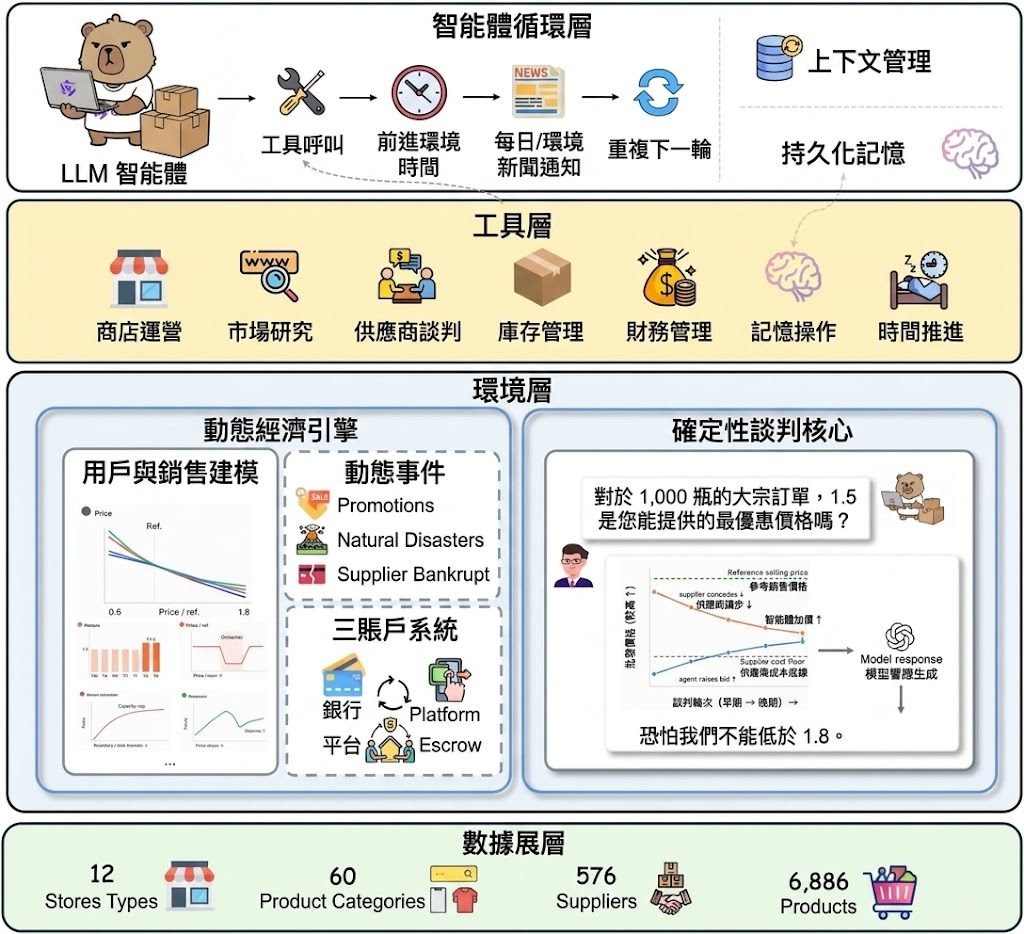
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

ReFlowSET 影像翻譯模型,衛星影像新標準

ReFlowSET瞄準 SAR 影像難讀這個老問題,唔再沿用 latent diffusion model 的天花板。它用高保真 latent 空間配合 flow matching,換來更快取樣同更穩定畫質。

Repository image for KAIST-VICLab/ReFlowSET

落雨、夜晚甚至雲層遮擋時,Synthetic Aperture Radar(SAR)仍然影到地表,但訊號雜訊同幾何外觀都令判讀門檻偏高。ReFlowSET 屬於影像翻譯模型項目,處理的是 SAR-to-EO image translation:把 SAR 影像轉成較接近光學 Earth Observation(EO)影像的表達,方便人看,也方便接到後續視覺流程。

它沒有沿用常見的 latent diffusion model 微調路線,而是保留凍結的 FLUX.2 autoencoder,改用從零開始訓練的 conditional flow-matching transformer。這個選擇直接避開舊方法受限於原有 autoencoder 重建上限的問題,同時把生成放進較高保真的 latent space 內處理;代價是主體模型仍然相當大,DiT 達 509M 參數,訓練門檻不算低。

訓練時,模型會根據 SAR latent 去預測由隨機噪聲走向 EO latent 的線性 flow velocity,並加入 representation alignment,將中途特徵對齊到凍結的 DINOv3 ViT-L/16 teacher。呢個 teacher 同 REPA projector 只在訓練期間使用,推理時會移除,所以正式生成流程比訓練結構簡潔,亦解釋到它點樣兼顧語義對齊同推理效率。

項目在 QXS-SAROPT 與 SAR2Opt 上,團隊把十五種早前方法放到同一 protocol 同 evaluator 之下重訓比較,ReFlowSET 取得兩個資料集最佳 DISTS,並在 SAR2Opt 拿到最佳 FID 與 LPIPS。它亦提供四步取樣設定,速度約比五十步版本快 11 倍,較適合想測試 SAR 轉光學可視化、遙感分析前處理,或研究生成品質與延遲取捨的團隊。

  • 以 frozen FLUX.2 autoencoder 加 conditional flow-matching transformer 重建 SAR-to-EO 流程
  • 用 DINOv3 ViT-L/16 做 representation alignment,但 teacher 不會帶入推理
  • 在 QXS-SAROPT 與 SAR2Opt 拿到最佳 DISTS,SAR2Opt 亦有最佳 FID 與 LPIPS
  • 四步取樣版本大幅縮短生成時間,適合做速度與畫質折衷測試
  • 已公開 PyTorch 實作、論文預印本與預訓練模型,較適合研究型團隊直接驗證

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Image, Python, Dataset 數據集

GeoNeXt 把影片生成模型當幾何學習:統一深度與法向量估計

GeoNeXt 把現成的影片生成模型改造成單一架構,同時預測單目深度與表面法向量;只需五萬九千筆訓練樣本,就能做到跨場景的零樣本遷移。

GeoNeXt framework

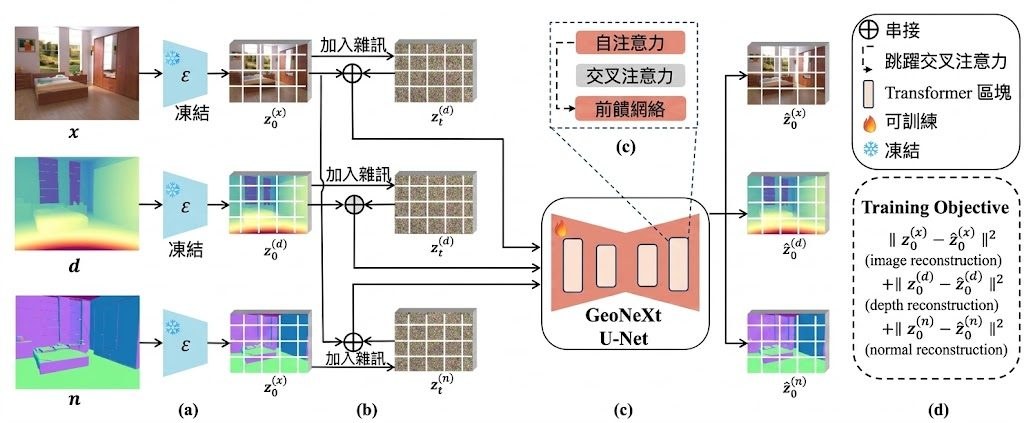
過往要從一張 RGB 影像同時取得深度圖與表面法向量,往往要靠兩個獨立網路串接,幾何一致性也容易在接縫處走樣。GeoNeXt 的切入點是把這些幾何訊號當成影片生成模型的「下一幀」:以 Stable Video Diffusion 為骨幹,把 RGB、深度、法向量一起送進 VAE 潛空間,在同一條去噪軌跡上共同生成,讓外觀與幾何從訓練開始就互相對齊。

兩個權重版本都放在 Hugging Face:GeoNeXt-Wan 約 1.42B 參數,GeoNeXt-SVD 約 1.52B 參數,兩者都能輸出深度與法向量。本地跑推論需要一張 24 GB VRAM 的 CUDA GPU,並透過 Conda 建立獨立環境;首次執行會自動從 Hub 下載所需的 checkpoint、base model 與 VAE,之後會從本地快取載入,因此斷網或重複測試時可直接用 –checkpoint、–base-model、–vae-model 指向本地檔案。

從應用角度,3D 重建、AR/VR 場景理解、機器人視覺等需要一致幾何的工作流都會受惠;研究員也能把它當作零樣本基準,與 GeoWizard 等專用模型直接比較深度、法向量及重建網格品質。

重點摘要:

  • 新意:把幾何估計重新表述為影片模型的下一幀預測,讓 RGB、深度、法向量共享同一條去噪軌跡。
  • 規模:以 Stable Video Diffusion 為基礎,提供 Wan 與 SVD 兩組約 1.4B–1.5B 參數的權重。
  • 數據效率:只用 59K 訓練樣本,就在多個基準上做到強健的零樣本泛化。
  • 硬體門檻:24 GB VRAM 的 CUDA GPU 即可推論,兩個版本需分開建立 Conda 環境。
  • 差異:相比串接兩個專用網路,單一模型同時輸出深度與法向量,有助於改善跨通道的一致性。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 世界模型, Video, Robotic, 3D, Dataset 數據集

Code as World: 用於物理推理的智能體

它把物理世界拆成可執行的程式表示,再用代理式流程反覆驗證與修正。你可以把它理解成一套把影像觀察轉成可推演世界模型的方法。

MirroS logo

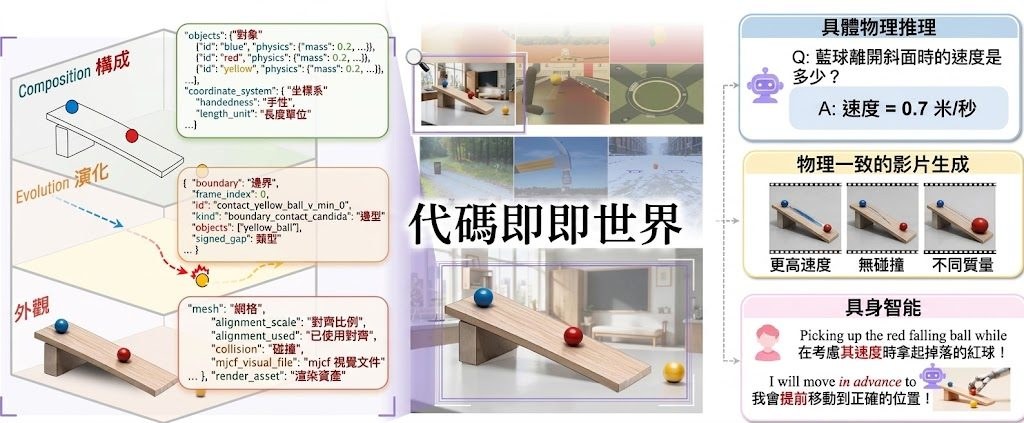
Code-as-World 是一個面向物理推理的研究項目,核心做法不是直接死記像素,而是把世界整理成可執行的程式表示。這樣做的目的很直接:讓模型不只看見畫面,還能整理出物件、狀態、動態規則與彼此關係,方便後續推演和檢查。

它的做法帶有明顯的工具與模型結合味道,提供 Code-as-World-VL-4B 和 Code-as-World-VL-9B 的本地推理與 QuantiPhy 評估。倉庫也提到可用 Python 3.10 或 3.11 在 CUDA 主機上安裝,代表它比較像研究團隊可重現實驗與推理流程的發佈形式,而不是單純示範頁。

和一般只靠像素特徵做判斷的做法相比,這個項目更著重可執行、可驗證、可調整的世界表示。代價是系統會更複雜,因為它要同時處理抽象、組合、模擬與一致性檢查,但換來的是更適合做反事實推演、診斷與物理場景理解。

  • 把物理世界表成程式,方便模擬和驗證
  • 支援本地推理與 QuantiPhy 評估
  • 4B、9B 版本已釋出,方便比較尺度效應
  • 適合做物理推理、世界模型與多模態研究
  • 量化結果顯示,較大模型的平均 MRA 有提升

對做多模態模型、世界模型、機械推理或具身智能的團隊,這類方法會比較有吸引力,因為它把感知和可執行結構連起來。若工作重點是要從影片或觀測中抽出可重用的物理表示,而不是只做單次辨識,這個項目提供了一條相當具辨識度的路線。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, NVIDIA, Dataset 數據集

Breeze TTS 2:低延遲語音生成再推一級

Breeze TTS 2 把即時語音互動、聲線設計同語氣控制放埋一齊,主打低延遲同高可塑性。它較適合要做配音、語音代理或互動內容嘅團隊。

BreezeBlue

Breeze TTS 2 係一個文字轉語音(text-to-speech, TTS)模型,重點唔止係把文字讀出,而係處理即時互動入面最難平衡嘅兩件事:聲音要自然,回應又要夠快。佢支援 Voice Clone、Voice Design 同 Voice Direction,代表可以由參考錄音複製聲線,亦可以純靠自然語言描述去設計新聲線,再按指令調整語氣、節奏同表達。

對內容製作、語音代理、遊戲角色配音同多語言產品來講,呢種做法比單純 TTS 更有彈性。文本內仲可以插入 Vocal Events,例如笑聲、咳嗽、清嗓子呢類表情提示,令生成聲音更接近真人演繹,而唔係只係平鋪直敘讀稿。

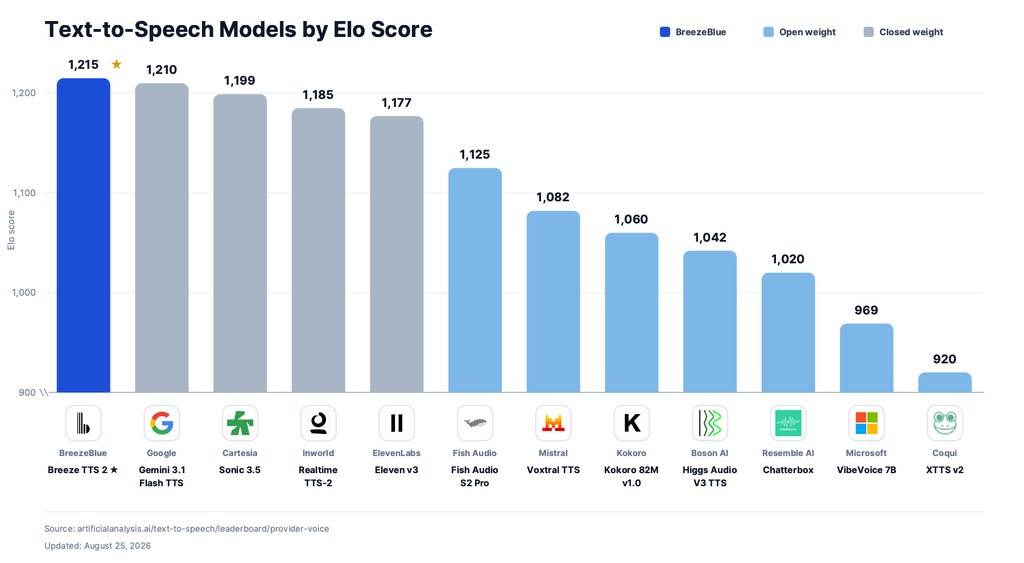
項目資料顯示,佢喺 Artificial Analysis TTS leaderboard 排名第一嘅 open-weight 模型,亦聲稱喺部分測試中超越商業系統。低延遲係另一個賣點:warming 後喺 NVIDIA H100 可做到少於 40 ms 的 time to first audio,RTF 約 0.32,適合即時對話場景。

不過,repo 同時寫明模型權重、衍生模型同 self-hosted outputs 只限研究同非商業用途,呢點對想直接落地嘅團隊影響好大。代碼層面提供 PyTorch inference code,但原始資料未交代完整安裝流程或部署細節,較合理嘅理解方式係先把佢視為一個面向研究與產品原型驗證的高性能 TTS 模型。

  • 支援參考錄音複製聲線,亦支援純文字描述設計新聲線
  • 可以用指令調整語氣、情緒、語速同演繹方式
  • 低延遲串流適合即時語音互動同 voice agent
  • 在 open-weight TTS 基準中聲稱領先,但授權限制較嚴
  • 適合配音、互動內容、多語言語音產品同研究團隊

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, Agentic, 模型, NVIDIA, Audio, Clone, Python, 語音, Dataset 數據集

MMLVE-Agent 點樣唔再搞亂多鏡頭影片

過往 AI 影片編輯碰到多鏡頭長片就容易認錯人、漏改背景。MMLVE-Agent 用 LLM 與 VLM 協作,把每個鏡頭拆開處理,再靠全局記憶鎖住主體身份。

MMLVE-Agent framework

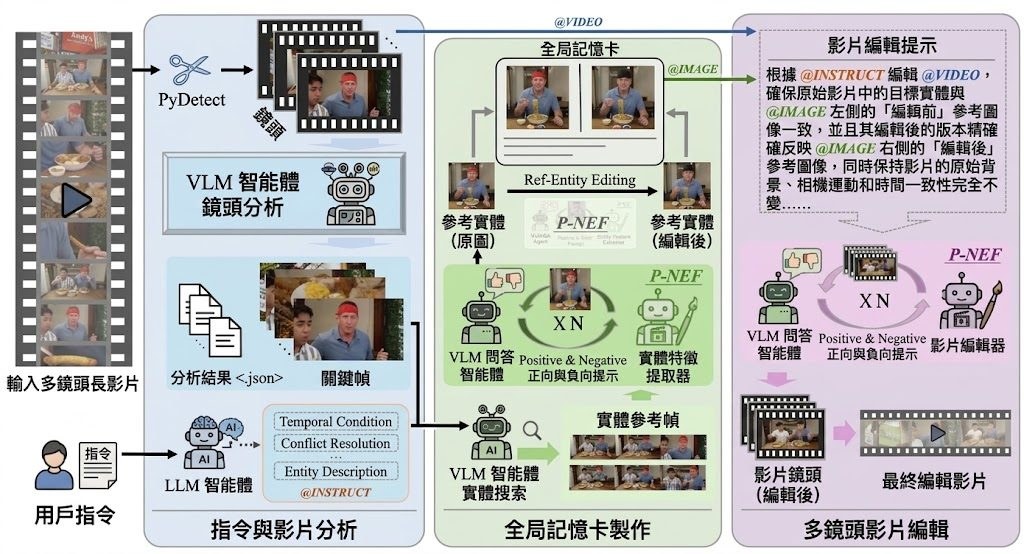
用一句「將男人嘅紅色衫變成藍色」就改完成條片、每個鏡頭都認得返同一個人——呢個係南開大學同騰訊團隊提出嘅 MMLVE-Agent 想要解決嘅痛點。過往影片編輯模型主要處理單鏡頭或幾秒短片,落到幾分鐘、橫跨多個鏡頭嘅長片就容易出現主體身份斷裂、編輯幻覺同時間連續性受損。呢個項目本質係一個異構多智能體框架,結合 LLM 做指令解析、VLM 做鏡頭級拆解同評估,再透過全局記憶卡(Global Memory Card)將 top-k 關鍵幀合成統一參考,確保主體身份唔會跨鏡頭走樣。

團隊同時定義咗 MMLVE 任務嘅三個核心目標:跨鏡頭編輯一致性(CSEC)、多指令解耦(MID)以及對非目標區域嘅零破壞(ZDSS)。其中 Pos-Neg Editing Feedback(P-NEF)令 VLM 評估器可以同時輸出負向提示同正向提示,主動修正錯誤同時保留應有細節,取代坊間常見嘅單向反饋機制。佢哋亦同步推出 MMLVE-Bench 數據集,涵蓋密集異質指令同稀疏隨機分佈嘅實體,對應真實影片剪接場景。

團隊聲稱喺呢個基準上超越咗 Seedance 2.0 等閉源方案,特別喺消除編輯幻覺同保持時空連貫性方面。不過要留意,原始資料只提供項目頁、論文同 benchmark 數據集,並無公開模型權重或安裝入口,想實際部署嘅讀者需要留意後續開源進度。

重點摘要:

  • MMLVE-Agent 係一個多智能體影片編輯框架,專門處理多鏡頭長片嘅自然語言指令編輯
  • 核心創新在於全局記憶卡同正負反饋機制,前者鎖定跨鏡頭主體身份,後者主動修正編輯錯誤
  • 同步推出 MMLVE-Bench 數據集,涵蓋高密度指令同稀疏實體分佈等真實場景
  • 團隊報告在自建基準上超越 Seedance 2.0 等閉源方案
  • 原始資料未提供模型下載或部署方式,實際可用性有待後續開源進度確認

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 視覺模型, 影像處理, Dataset 數據集

UrbanGround 開源:真實香港城市級 3D 沙盒多模態智能體

UrbanGround 是一個以香港全境 3D 地理數據搭建的城市級模擬環境,可直接用第一人稱遊玩,亦可讓 MLLM 智能體透過程式介面操作同一個世界。

UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City

UrbanGround 由一個學術團隊在 GitHub 上開源,整個項目的野心在於把「真實城市規模」這件事帶進多模態智能體(Multimodal Large Language Model, MLLM)的研究裡。它以香港的 3D Visualisation Map 為底層地理數據,搭配 Unity 場景提供第一人稱連續移動、碰撞與日夜、天氣、行人等動態變化,使用者可以直接以 WASD 鍵盤操作在城市裡行走、爬樓梯、找地點、切換視角,亦可以交由 AI 智能體透過程式介面(HTTP API)取得 RGB 觀察、物理動作與地圖資訊,自行決策。

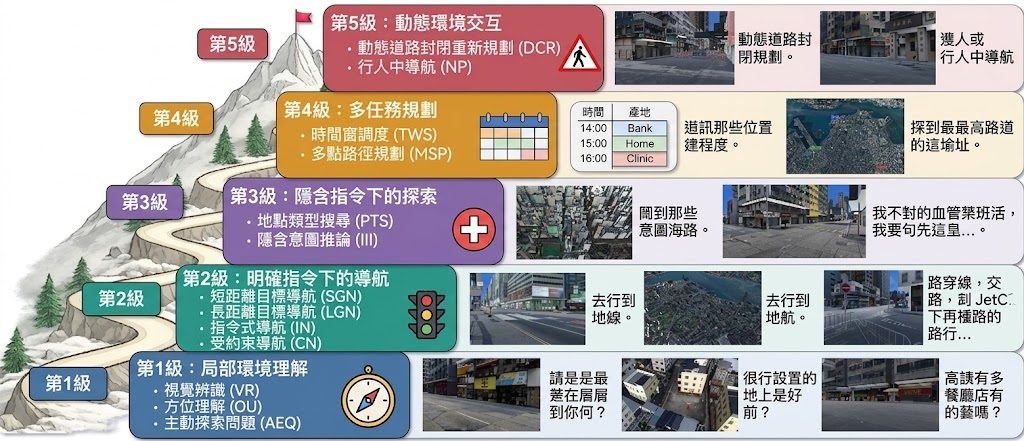
這個環境和過往以小型合成場景或封閉遊戲引擎為主的做法相比,核心差異在於「規模」與「真實地理閉環」:智能體看到的不是抽象方塊,而是一座真實城市的街道、樓宇、地形,並且觀察、動作、地圖三者來自同一個介面,方便研究者設計貼近真實導航、空間感知與任務規劃的測試。整個項目同時釋出網頁版、macOS、Windows 與 Linux 原生版本,並附上多個由五個能力層級組成的評測任務,供 MLLM 在感知與行動兩端做系統性比較。

對研究 MLLM 空間智能、城市導航或數字孿生的團隊來說,UrbanGround 提供了一個比手工搭建的小場景更貼近現實的測試場;對一般玩家或開發者而言,它也是一個能在瀏覽器直接探索香港街景的實驗性沙盒。需要留意的是,網頁版首次載入完整 Unity 場景在繁忙時段或慢速網絡下需時約 3 至 5 分鐘,作者建議從 GitHub 下載並在本地網絡提供 tile 數據以加快速度。目前場景仍有「模糊或不完整幾何」以及「車輛與行人種類有限」等已知限制,相關修正在路線圖中。

重點摘要:

  • 真實城市規模:以香港全境 3D 地理數據驅動,非抽象小型合成場景。
  • 雙操作介面:第一人稱玩家與 MLLM 智能體共享同一套 RGB 觀察與動作 API。
  • 跨平台發佈:提供網頁版與 macOS、Windows、Linux 原生應用。
  • 結構化評測:內建多層級任務,用於量度多模態智能體在感知與行動上的能力。
  • 已知限制:場景幾何仍有缺損,車輛與行人種類待擴充。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 多模態模型, API, 香港, Mac, 3D, Linux, Dataset 數據集

Page 6 of 29
1 … 4 5 6 7 8 … 29