ScienceIDE 把科學模擬變成 AI agent

ScienceIDE 用 64 個科學模擬環境訓練 agent 修 bug、重寫函式,並釋出 4B、9B、72B 三個模型。你可以把它理解成:用真實物理模擬的數值對不對,來判斷 AI 改程式改得啱唔啱。

ide overview

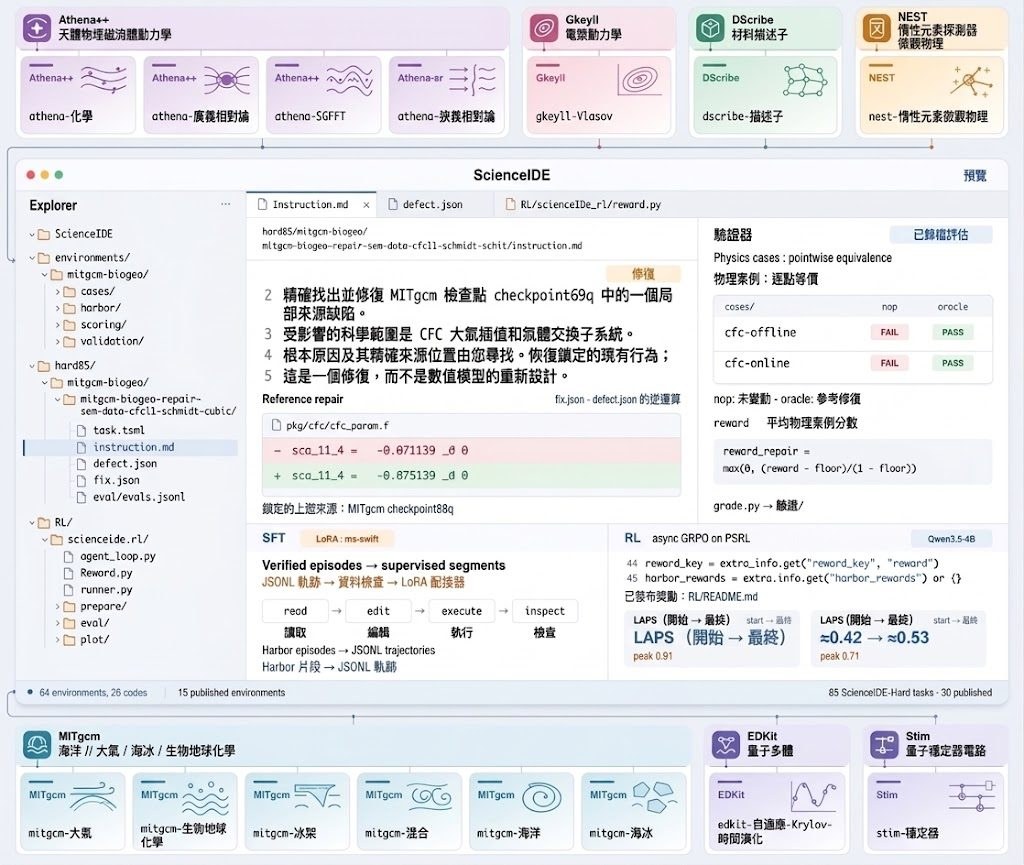
大多數 code agent 訓練環境用靜態單元測試或合成題目,ScienceIDE 走一條更狠嘅路:直接搬真實科學模擬器入嚟做試煉場,等 agent 改動 pinned、未經修改嘅上游源碼,再由 verifier 重新編譯並跑原本嘅物理 case,數值要對得返先算過。換句話,reward 唔係「diff 似唔似」,而係「模擬結果啱唔啱」。呢套框架對工程團隊同做 AI for Science 研究嘅人特別有用,因為佢直接量度 agent 對物理計算嘅影響,而唔係紙上談兵。

項目提供 64 個環境同 85 條 ScienceIDE-Hard 任務,已公開 15 個,全部都附帶可量度嘅難度指標(未修復分數、編輯點數量、驗證成本、通過率),避免人為標 difficulty。Reward 設計亦幾巧妙:untouched repository 一定攞零分,等模型必須真係做嘢先有分。

團隊同時釋出 PhAI-IDE-4B、9B、72B 三個模型,覆蓋唔同算力預算。從結果睇,SFT 後 PLUTO-Particles-Dust 由 0.0 跳到 0.33;Qwen3.5-4B 經 30 步 RL,LAPS 由 0.357 升到 0.857,MITgcm-biogeo 由 0.286 升到 0.571。訓練用科學 code 唔止提升呢類任務,亦帶動一般 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。

要部署嘅人最直接嘅入口係 Hugging Face 嘅 model collection 同 GitHub repo;想理解 reward 邏輯同難度定義,paper 同項目頁有完整交代。訓練數據、開發環境同 verifier 開源,等社區可以喺真實科學 codebase 上繼續 scale up。

重點摘要:

  • 真實物理模擬做 reward:agent 改動上游源碼後,verifier 重編譯並比對物理 case 數值,唔靠 diff 相似度。
  • 64 個環境、85 條 Hard 任務:已開源 15 個,難度由可量度指標自動決定,唔靠人手標 label。
  • 三個模型規模:PhAI-IDE-4B、9B、72B 覆蓋唔同算力,訓練設定與評估條件一致。
  • 科學任務外溢到通用 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。
  • 完整開源鏈:code、environments、tasks 同模型權重同步釋出,方便研究團隊複製同擴展。
項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架, IDE, Dataset 數據集

ProgramDistill:把網頁 App 反推成 SWE 基準任務

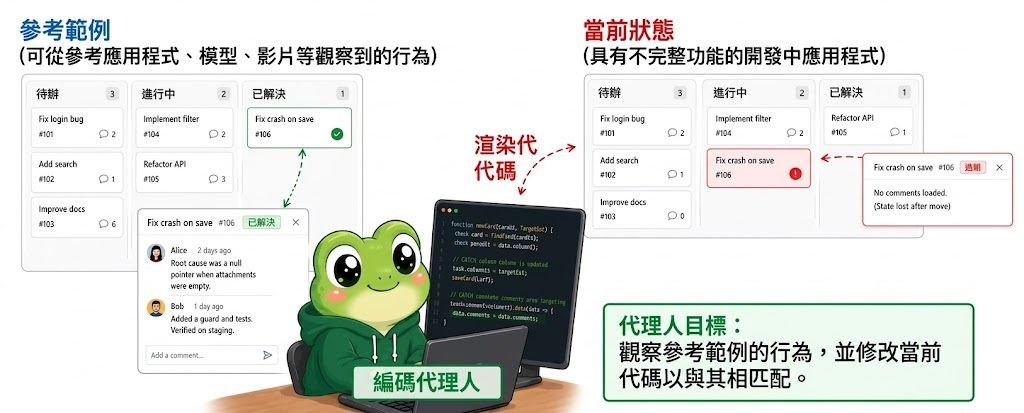
ProgramDistill 把互動的網頁行為變成修復題目,讓 AI 編程代理靠一部會動嘅「參考 App」重新砌返功能,再自動驗收。

Microsoft Research

好多時開發並非由一份寫得好清楚嘅規格開始,而係先見到一個行得通嘅版本,再去諗點補返。ProgramDistill 模擬嘅正係呢種工作流:代理可以同一部「參考 App」互動,但睇唔到佢嘅源碼,只能改另一份缺咗功能嘅應用程式,再睇最後行起上嚟嘅行為同原裝嘅一唔一樣。換言之,重點唔係抄程式碼,而係要還原出來嘅效果同參考版本吻合。

要規模化做呢件事,每條任務都要有「可以重播嘅行為」加「可靠嘅驗證」。ProgramDistill 用一條叫 mine-craft-patch 嘅自動管線,靠多個 LLM 代理合作,由行得通嘅應用同源碼出發,自動搵出可記錄嘅行為、存成可重播嘅 trace,再刪走負責該行為嘅源碼,整出一份「修復題」。每條 trace 本身就係一個可執行嘅驗收器,因為佢記低咗瀏覽器動作、成功訊號同前置依賴,自動重播就識得計分。

呢套方法喺 26 個應用上面搵到 1,975 個經重播驗證嘅行為,再組成 4,063 條任務。題目難度可以由「要還原幾深層嘅依賴」控制到,即係話可以設計到「只係補一個細行為」,亦可以迫代理一次過補返連鎖反應。

重點摘要:

  • 用可重播行為做驗收:trace 同時係題目亦係計分機制,省咗另寫驗收邏輯。
  • 唔睇源碼、只睇效果:代理要靠互動參考 App 嚟推測行為。
  • 難度可調:還原深度愈深,要一齊修好嘅行為就愈多。
  • 規模化合成:26 個應用就整到四千幾條 SWE 任務。
  • 評估目標係還原效果,唔係程式碼樣相似唔相似。

對做編程代理嘅團隊,或者想練 SWE-bench 類型基準嘅人嚟講,呢套管線提供咗一個起點:由真實 Web App 自動生出一批可驗證、難度可控嘅任務,省卻人手逐條寫題目嘅工序。

項目主頁

Categories: 開源, Agentic, 微軟, 軟件, 編程, Dataset 數據集

ComfyUI-FL-YuE2:ComfyUI 內砌歌:FL YuE2 把樂譜編輯、AI 作曲、LoRA 訓練三件事接起來

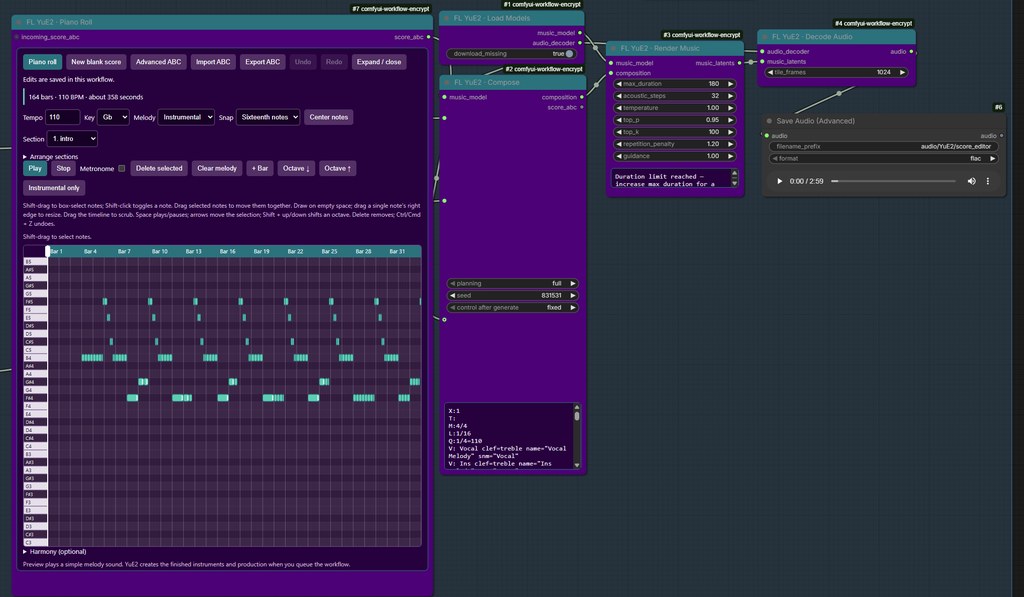
ComfyUI-FL-YuE2 是一組節點,把 YuE2-3B 音樂模型包進 ComfyUI 工作流,讓你用鋼琴卷軸寫樂譜、灌歌詞,最後輸出 48 kHz 立體聲成品,亦支援 AR LoRA 訓練。

YuE2 inference workflow in ComfyUI

以往想在 ComfyUI 玩音樂生成,往往要面對幾個卡位:要自行接 YuE2 的推理指令、要另外找譜面編輯工具、想做 LoRA 微調更要跳出 ComfyUI 自己搞訓練腳本。FL YuE2 嘗試一次解決這三件事,把樂譜編輯、AI 作曲、AR LoRA 訓練全部接成節點流程,對熟悉 ComfyUI 圖形化工作流的用家算是頗順手的整合。

項目核心是一個可視化鋼琴卷軸編輯器,支援點擊加音、Shift 框選、箭頭鍵移動、Undo/Redo 等基本操作,並提供 Instrumental 或 Sung 旋律模式。和弦面板可摺疊,匯入的 ABC 樂譜會保留 slash chord 等進階標記。換 Key 時同時處理旋律與和弦根音,最短轉調、超出音域會直接拒絕而非裁切音高,設計上偏向「樂理正確」多於「暴力生成」。

音訊輸出走 YuE2-3B 加獨立 VAE 解碼器,產出 48 kHz 立體聲,內建瀏覽器合成器可預覽節段節拍,但並非最終成品音色。LoRA 訓練流程則提供數據集檢視與 checkpoint 預覽,方便用家挑選權重繼續微調。

重點摘要
– 屬於 ComfyUI 自訂節點套件,整合 YuE2-3B 音樂生成與樂譜編輯
– 鋼琴卷軸支援框選、群組移動、Undo/Redo,轉調按樂理而非裁切處理
– 推理與 AR LoRA 訓練共用同一組節點,方便迭代
– 需 NVIDIA GPU 支援 BF16,已驗證 RTX PRO 6000 Blackwell,其餘 24 GB 配置未經驗證
– 首次執行約下載 7.8 GB 模型權重,支援中斷續傳與離線模式

適合已有 ComfyUI 基礎,又想嘗試可控音樂生成或自訓風格 LoRA 的用家。注意目前僅在 Windows + Python 3.12 + Torch 2.11 環境驗證,跨平台或較舊 GPU 仍需自行測試。

GitHub

Categories: 開源, ComfyUI, 模型, 模型訓練, NVIDIA, Audio, Python, 音樂, Dataset 數據集, 廣東話

HarnessVLN:不訓練也能走的統一導航框架

HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

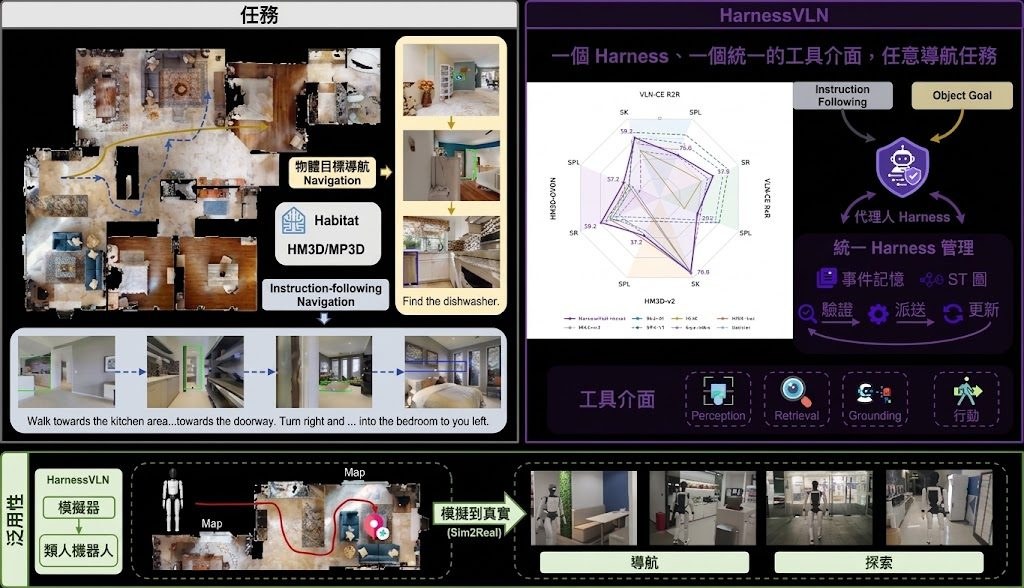
Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

Mind2Dialogue:讓模型學會推斷用戶內心狀態

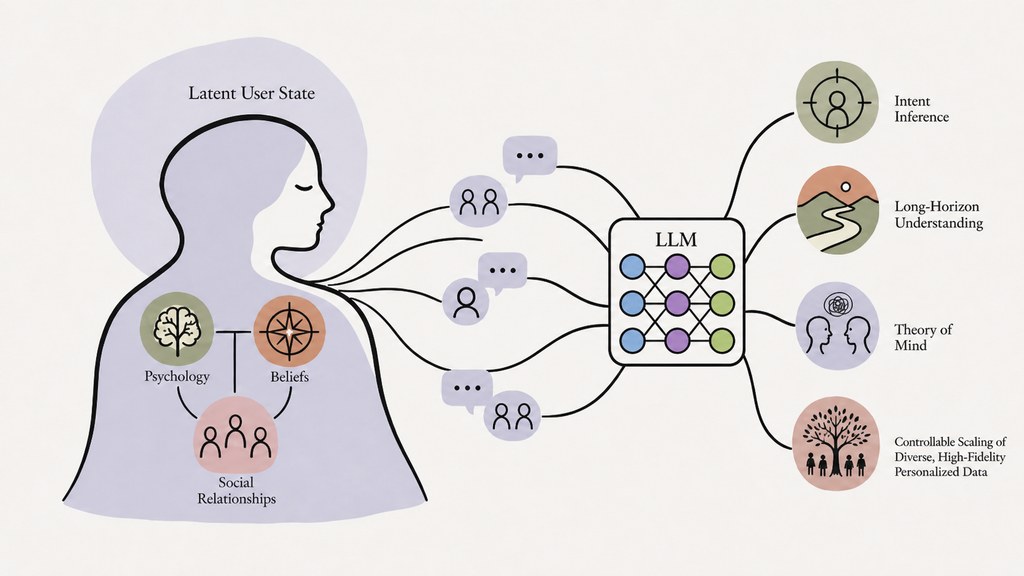
這個項目用一套共享狀態的對話模擬流程,讓模型從純對話歷史推回用戶的信念、目標和情緒,從而提升個人化與心理理論能力。

idea-promotion

現時很多聊天模型在多輪對話中表現不錯,但一到「這個用戶其實想要什麼、心情如何、跟上一句話背後的脈絡」就容易失去線索。Mind2Dialogue 直接在訓練階段把這個缺口補上:模擬器跟一個 Oracle 助理共用同一個會隨對話演化的用戶狀態,Oracle 寫出的回覆就成為學生模型的訓練目標;學生模型在訓練時只看到 persona 與對話紀錄,要自行還原背後狀態。

整個流程由六個階段組成:規模化產生 persona 種子情境、批次生成對話、用 LLM 作評審過濾低質樣本、從對話抽取 QA 對、語料改寫增廣,最後做微調與評估。設計上刻意把模擬者、Oracle、評審分成不同模型端點,避免自我評分,也容許把較強模型放在 Oracle 位置。情境類型涵蓋終生關係、高頻互動、情緒事件與敏感議題,使訓練語料貼近真實長期陪伴的場景。

在 Qwen2.5-7B-Instruct 上,個人化指標 PrefEval-Gen 比基礎模型高 33.4 分,PersonaMem-v2 高 10.0 分,並在同骨架下壓過加記憶模組與其他個人化方法。Qwen 與 Llama-3.1-8B-Instruct 在 BigToM 等 Theory-of-Mind 基準上也同步進步,代表個人化與心智理論可能共享同一種「從觀察推回未觀察狀態」的能力。OLMo-3-8B-Instruct 則未見轉移,顯示效果仍受骨架預訓練影響。

隨訓練資料量由八分之一擴到全量,三個骨架的個人化分數都穩步上升,呼應「資料規模足夠,學生才能學會狀態還原」這個核心假設。對做對話系統、角色 AI、AI 陪伴或客服助手的研究團隊,這套管線可作為不需要逐句人工標註的個人化資料生成起點;對關心評測的研究者,內附 LLM-as-judge 與消融設定(full、no_privilege、no_state、latent 等)便於追溯不同監督訊號的貢獻。

重點摘要:

  • 共享狀態模擬:模擬器與 Oracle 共用演化中的用戶狀態,Oracle 回覆成為學生訓練目標
  • 零人工標註管線:六階段流程從 persona 種子到微調皆可批次執行
  • 個人化與 ToM 同步提升:Qwen 與 Llama 在 PrefEval-Gen、PersonaMem-v2、BigToM 上均有明顯改善
  • OLMo 未見轉移:效果依賴骨架預訓練特性,OLMo-3-8B-Instruct 在 ToM 上反而下跌
  • 資料越多越好:從 1/8 到全量語料,三個骨架的個人化分數持續上升

項目主頁 · GitHub · 數據集

Categories: 開源, Agentic, 模型訓練, Qwen, LLaMa, Dataset 數據集

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

OST:可撤回串流推理的「過早下結論」

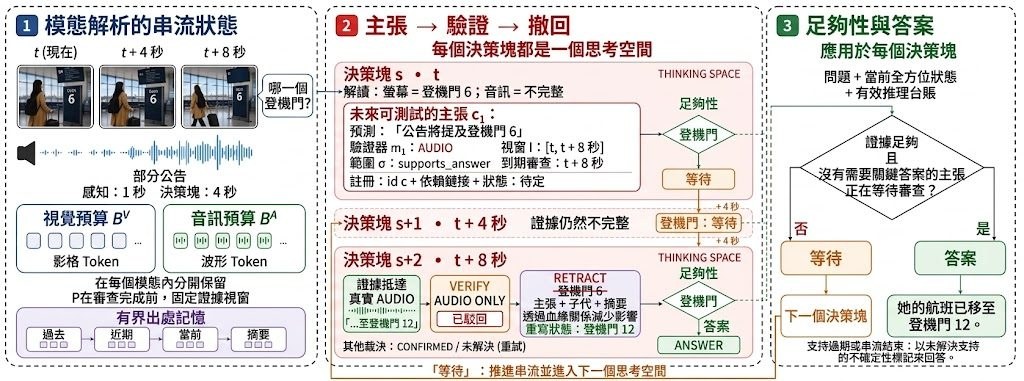
香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

MiniCPM5-2B:小模型挑戰長文本與本機 Agent

MiniCPM5-2B 定位本機助理與 Agent 工作流,憑混合注意力機制在 256K 上下文速度達同類模型的 3.5 倍,1M 長度亦唔會 OOM。

minicpm logo

2B 級開源模型一向被視為「垃圾」,但 OpenBMB 推出 MiniCPM5-2B 想直接打破呢個印象。佢係一個密集 2B Transformer,專為本機部署、資源受限場景同 Agent 工作流而設,並非追求跑分,而係希望用細模型扛起編碼、工具調用同長文本推理嘅實際任務。

佢最大嘅賣點係混合注意力架構:25% InfLLM-V2 配 75% Lightning Attention,前者處理局部細節,後者負責廣域上下文,避開全注意力喺長序列嘅記憶體負擔。另一關鍵係 Transformer-to-Hybrid Continue Training,直接喺預訓練權重上做架構轉換,省去冷啟動訓練成本,整體訓練預算大約只需從頭練一個同級模型嘅 25%。

喺長文本佢喺 256K token 序列長度下推論速度達 Qwen3-8B 嘅 3.5 倍(A6000D 實測),1M token 仍可運行,而 Qwen3-8B 喺 1M 已經 OOM。短文本方面,佢嘅知識、數學、編碼能力貼近 Qwen3-8B,但長文本基準測試反而更高,可以理解為「細模型唔再需要喺長短場景之間二擇一」。

對想喺本機跑 Agent、或需要處理超長文件嘅開發者同團隊,呢個模型提供咗一個具體選項。OpenBMB 同時開源咗 UltraX 預訓練數據集、UltraData-Code、UltraData-SFT-Agent-2609(50 萬條 Agent 樣本)同 UltraData-RL-2609,方便下游微調。Hugging Face 有線上 Demo 可即時試,GitHub 上亦有部署與微調腳本。

  • 混合注意力:25% InfLLM-V2 + 75% Lightning Attention,兼顧局部同廣域上下文
  • 架構延續訓練:Transformer 權重直接轉為混合架構,訓練成本僅約 25%
  • 長文本表現:256K 推論速度為 Qwen3-8B 嘅 3.5 倍,1M token 仍可運行
  • 短文本保持競爭力:知識、數學、編碼接近 Qwen3-8B 水平
  • 配套開源數據:UltraData 系列涵蓋預訓練、Agent SFT、RL 樣本

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, 工具, Dataset 數據集

SyncWorld:用一段影像校準,讓世界模型零樣本遷移到新機械人

同一個數值動作換了鏡頭或機械人就失效?SyncWorld 以「視覺校準片段」作為提示,讓單一世界模型即時推斷動作與畫面嘅對應關係,毋須再為每個環境重新微調。

SyncWorld teaser

動作數值喺像素空間其實唔係通用語言——換鏡頭、換機械人位置、換機械結構,同一個動作指令就會產生唔同嘅視覺效果,亦即係點解用混合數據訓練出嚟嘅動作條件世界模型(action-conditioned world model)喺新場景入面成日失效。SyncWorld 嘅切入角度係:既然動作同畫面嘅對應因環境而異,不如用一段包含每個可控自由度(DoF)嘅短影像校準片段(visual calibration episode)做 in-context prompt,等模型喺推論時即場估計呢套環境嘅 Action–Visual Mapping,從而把單一 checkpoint 變成零樣本(zero-shot)模擬器,毋須額外訓練。

基於 NVIDIA Cosmos-Framework 改寫而成,並非由零開始砌嘅新網絡。對比一般針對單一機械人做 fine-tuning 嘅做法,SyncWorld 用視覺證據取代權重記憶;訓練時混入 calibration context 之後,模型仲學識喺冇 calibration 嘅情況下落返去用互動歷史做預測。程式庫提供分散式 FSDP trainer、typed TOML 食譜同原生 DCP checkpoint,可以直接匯出 HuggingFace safetensors;評估就用全段自回歸 rollout,配合 PSNR、SSIM、LPIPS 量度像素相似度。

直接受惠:需要喺多款 xArm、ARX5、KUKA、Franka Panda、UR5e 等異質平台上做 sim-to-real 想像嘅機械人研究團隊;做測試時策略改進(test-time policy improvement)而唔想再花錢訓練嘅 RL 團隊;以及想避開「每個新 setup 都要重新標註動作」呢個樽頸嘅數據團隊。Demo 顯示佢能準確模擬未見過嘅設定入面嘅動作後果,並令策略喺測試階段靠 rollout 改善而毋須再訓練。

重點摘要:

  • 以視覺校準片段作為 in-context prompt,免去 per-deployment fine-tuning
  • 訓練同時令模型能喺冇 calibration 時回退用互動歷史
  • 基於 NVIDIA Cosmos-Framework 改寫,提供 FSDP 訓練同 DCP checkpoint
  • 評估用全段自回歸 rollout,配 PSNR、SSIM、LPIPS 指標
  • 模型權重同評測集已開喺 HuggingFace:yyuncong/SyncWorld、yyuncong/SyncWorld-Evaluation

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, NVIDIA, Image, Robotic, 框架, AGI, Dataset 數據集

Show-Harness:VLM 極簡語意操縱機械臂

Show-Harness 把機械人控制壓縮成一組離散語意動作單位,讓視覺語言模型直接負責物理決策,省去針對特定硬件的預訓練與額外參數。

Show-Harness

機械人領域一直有個尷尬落差:底層視覺語言模型(VLM)識睇識講,但要佢實際控制一隻機械臂,往往要再預訓練、加 VLA 頭或寫一大堆適配層。Show-Harness 嘗試用另一種方式切入──直接把動作壓縮成一組細粒度、離散的語意單位(例如 MV_FWD、GRASP、ROTATE_CW),由 VLM 逐個 token 推理,再交俾硬件專屬嘅 interpreter 去 deterministically 落地成實際機械動作。換句話,VLM 唔再需要理解「毫米」或「關節角度」,只需揀語意單位。

你可以用兩種方式跑:直接接駁前沿閉源 VLM 做 zero-shot 控制,又或者拎幾個 GPU 小時微調小型開源 VLM,產出每秒 12 至 33 Hz 嘅本地執行版本。Franka、AgileX Piper(單臂同雙臂)、ManiSkill、Isaac Lab 都共用同一套詞彙同一個 prompt,唔使逐隻 robot 寫 prompt。項目同時附帶 GUMI:一個瀏覽器內嘅 GUI 操作介面,等你可以用鍵盤滑鼠親身「玩」機械人收 demonstration,完全唔需要專業遙操作硬件。

  • 極薄中介層:VLM 只負責揀語意 token,所有 metric 細節由 interpreter 處理,避免額外模型容量開支
  • 跨硬件共用詞彙:Franka、AgileX、ManiSkill、Isaac Lab 共用同一套動作字典與 prompt
  • 兩種部署路徑:前沿閉源 VLM zero-shot,又或者 LoRA 微調小型開源 VLM,本地即可執行
  • GUMI 無硬件收數據:瀏覽器內 GUI 操作即收 demonstration,省去 teleoperation 設備
  • 插件式消融設計:一個目錄、一個 boolean flag,閂咗就等同冇裝

相對於 π0.5 同 GR00T 呢類 VLA 路線,Show-Harness 嘅取捨偏向「interface 解耦」──唔再要求模型本身內化硬件物理量,而是把 metric 還返俾環境層解讀。對做具身研究、想快速換 embodiment 驗證嘅團隊,或者資源有限、要靠 LoRA 微調部署嘅實驗室都幾實用;研究 embodied agent 同 VLM 接駁嘅開發者都可以直接拎去試 prompt 同詞彙設計。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 模型訓練, VLA, Robotic, Dataset 數據集

Page 4 of 29
1 2 3 4 5 6 … 29