ReChannel:用生成模型做密集預測

同一張圖直接讀出深度、法線、去背甚至文字指向分割,ReChannel把 text-to-image 模型變成實用視覺讀取器。它吸引人的地方,不在於加大模型,而是幾乎只靠輕量 LoRA 與線性頭完成轉向。

demo

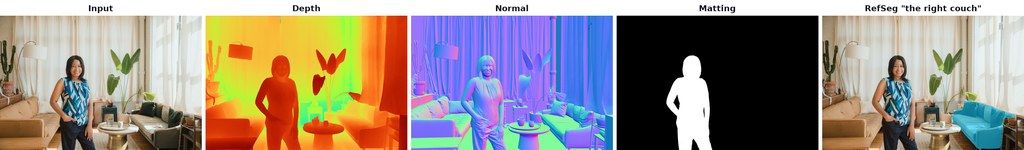
一張 RGB 圖像想同時拿到深度、surface normal、matting 同 referring segmentation,通常意味住要換幾套模型;ReChannel偏偏反其道而行,將預訓練 text-to-image DiT 的空間 token 直接改作密集預測讀出。這不是完整訓練流程釋出,而是偏向 inference/質性展示的 GitHub 項目,定位很清楚:展示 FLUX-Klein 骨幹除咗生圖,亦可以做 pixel-space dense prediction。

它的類型更接近研究型模型讀出方法+推理示範工具,實際解決的是「可否沿用生成模型已有的空間表示,避免為每個密集任務重建一套重型解碼器」。做法上,骨幹維持 frozen,只為每個任務加 LoRA,再配一個 token-local linear head;標量任務頭部大約 33K 參數,surface normals 約 99K,沒有 convolution、沒有 upsampling,也沒有 target-side VAE decoder。

同類方法很多會把功夫放在額外解碼器或多尺度結構,ReChannel的取向剛好相反:盡量把空間結構留在 DiT token field 內,最後只做通道重映射。這種設計夠輕,但取捨亦直接,現有儲存庫沒有完整 benchmark pipeline,姿態估計亦未放入最小示範,所以更適合用來理解方法潛力,而非直接拿來做嚴格橫向比較。

  • 支援單張圖片推理,可輸出 depth、normal、matting、refseg,refseg 需要輸入文字描述
  • 依賴 CUDA GPU,首次執行會自動下載 black-forest-labs/FLUX.2-klein-base-4B 與對應 LoRA、線性頭權重
  • depth、normal、matting 會保留長寬比並可用 horizontal-flip TTA;refseg 固定在 512² 單次前向
  • 已公開的是 demo/inference 版本,不是論文表格所用的完整評測流程

受益最大的人,會是研究 dense prediction、生成模型再利用、或者想測試 LoRA 能否把同一骨幹轉成多任務視覺讀出的團隊。相關模型核心是 black-forest-labs/FLUX.2-klein-base-4B,再疊加每任務 LoRA adapters;對想研究生成模型表示能否外借到視覺理解工序的人,這個項目相當值得留意。
GitHub

Categories: 開源, 香港科技大學, NVIDIA, Stable Diffusion, Image, 影像處理, txt2img, Dataset 數據集

PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

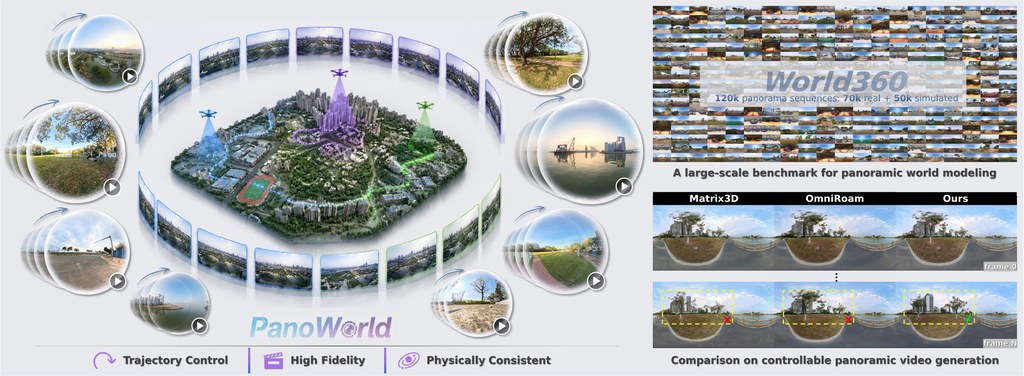
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC) 與 Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。

項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

Needle 想把微型 AI 帶落手機同手錶

Needle唔係追求萬能對話,而係集中做好 function call。26M 參數做到可本地微調,方向相當鮮明。

Logo

想喺手機、手錶或者眼鏡一類裝置放入可用嘅個人 AI,卡位往往唔係模型夠唔夠大,而係夠唔夠細、夠唔夠快,仲要肯做工具呼叫。Needle 就係朝呢個位置落手:一個以 Simple Attention Network 為核心嘅微型模型項目,重點處理 single-shot function call,目標唔係長篇對話,而係幫個人 AI 更穩定咁叫工具做事。

呢個項目最值得留意嘅地方,在於佢將 Gemini 3.1 蒸餾到 26M 參數,並且保留到可以喺 Mac/PC 本地 finetune 嘅路線。對開發者同產品團隊嚟講,意思好直接:你未必要綁死雲端大模型,亦可以先用開放權重同資料生成流程,試自己嘅工具介面、指令格式同 function schema,再按需要微調。

Cactus Needle - The 26M Function Calling Model

同類小模型通常會喺「尺寸、速度、泛化能力」之間拉扯,Needle 明顯揀咗功能導向呢一邊。README 已經講得很坦白:佢喺 single-shot function call 勝過 FunctionGemma-270m、Qwen-0.6B、Graninte-350m、LFM2.5-350m,但呢類較大模型喺對話範圍同容量上仍然更強,所以 Needle 比較似一把專用工具,而唔係通才助手。

  • 類型上屬於開源模型項目,集中解決小裝置上嘅 function call 效率與部署成本。
  • 權重同 dataset generation 都已開放,適合拿來測試自家工具鏈同微調流程。
  • 生產環境配合 Cactus,可達 6000 toks/sec prefill 同 1200 decode speed,取向非常著重吞吐。
  • 預訓練用 16 TPU v6e 跑 200B tokens,之後再用 2B tokens 嘅 single-shot function call dataset 做 post-training。

模型結構亦反映咗呢種取向:Simple Attention Network 採用 encoder-decoder 佈局,配合 GQA+RoPE、Cross Attn、ZCRMSNorm 同 shared embedding,目的係用更細規模支撐工具呼叫輸出。要留意嘅限制同樣清楚,小模型本身比較 finicky,對資料格式、工具定義同微調質素會更敏感;需要穩定多輪對話或者更廣知識覆蓋嘅場景,仍然未必係 Needle 最合適。

GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Qwen, Gemini, Mac, Dataset 數據集

DrugGen-2:把疾病上下文拉進分子生成流程

你可以在指定疾病與蛋白靶點後,讓模型直接吐出候選藥物分子。DrugGen-2 補上了以往只針對靶點或通用性質做生成的盲區。

Logo

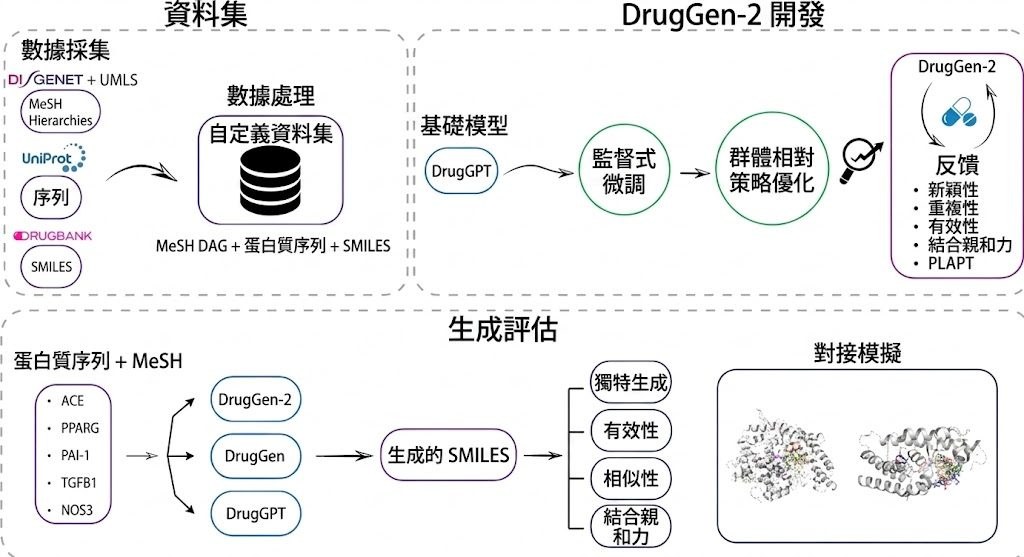
很多老牌分子生成模型只盯着單一蛋白靶點或通用化學性質做條件生成,往往忽略了同一個靶點在不同疾病背景下行為可能完全不同。DrugGen-2 正是針對這個落差而來,它是一個用 MeSH DAG(疾病本體層級結構)加上蛋白序列做條件輸入的語言模型,輸出端直接給出 SMILES 結構,既支援 de novo 設計,也能用於藥物再利用篩選。

這個項目屬於開源模型與訓練框架的混合體,背後以 liyuesen/druggpt 為基底,先做 Supervised Fine-Tuning(SFT),再用 Group Relative Policy Optimization(GRPO)做強化學習微調,整個流程跑在 Hugging Face transformers 與 TRL 上。作者認為舊做法把疾病與靶點切割看待,於是提出以疾病為錨點重新組織資料的 framing,這也是它和同類工具最大的差異點。

對做計算化學、藥物篩選前期探索或想快速做假說驗證的研究團隊來說,這類輸入比直接丟一個蛋白 ID 更貼近真實用藥情境。要部署的話只要 clone 倉庫、安裝 requirements,再透過 Python API 或 CLI 餵入疾病名稱、MeSH ID 與 Uniprot 序列即可生成候選分子,預訓練權重已放在 Hugging Face 上方便取用。

不過要留意,模型表現仍受限於 alimotahharynia/approved_disease_target_drug 訓練集的覆蓋範圍,對冷門疾病或新興靶點的泛化能力尚未有公開 benchmark 直接驗證。它比較適合作為初期探索與假說排序的輔助,而非取代濕實驗驗證的工具。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, API, Clone, Medical醫學, Python, Dataset 數據集

Canvas360 把全景生成拉回可用水平

全景圖最易穿崩嘅位置,往往唔係畫質,而係左右接縫同空間感。Canvas360 針對呢個痛點落手,想令文字生成同後續修補都更連貫。

teaser

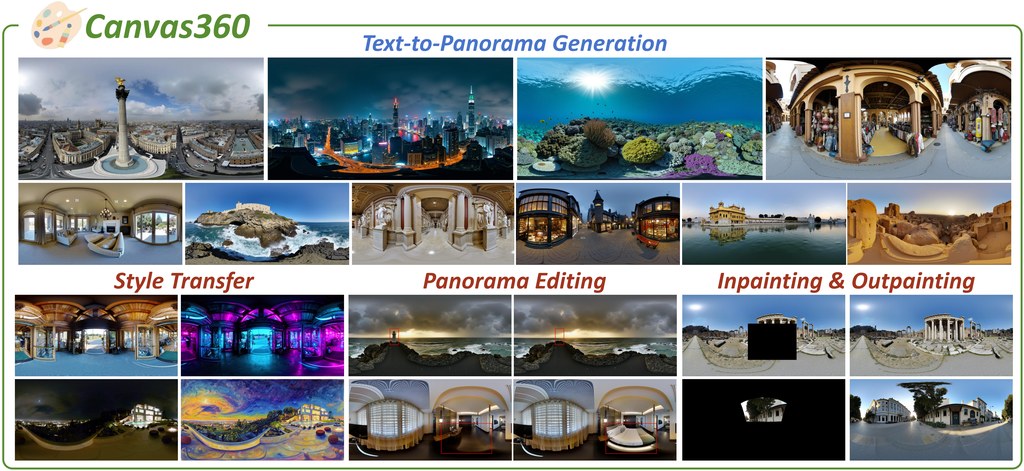
最值得留意嘅地方,在於佢唔只想生成一張闊圖,而係想處理 360 度全景最常見嘅破綻:左右邊界接唔上、透視變形唔自然、補圖後空間結構散開。Canvas360 屬於影像生成框架,建基於 FLUX,處理嘅係 text-to-panorama image generation,同時延伸到 inpainting、outpainting、editing 同 style transfer 呢類全景工作流。

現有做法多數先把全景當成一般平面圖片生成,再靠後處理減少接縫;作者認為呢種範式忽略咗 panoramic projection 本身嘅幾何特性,所以容易喺邊界、深度關係同局部結構出現錯位。Canvas360 用 two-stage framework 重組呢件事:先做 geometry-aware pretraining,引入 parallel RGB-depth pretraining,再配合 continuous position encoding、circular latent padding 同 per-block feature synchronization,將 360 度連續性直接放入模型學習過程。

同類項目相比,Canvas360 嘅取向唔係單純追求更華麗嘅畫面,而係優先修正全景生成最影響可用性嘅一致性問題。項目亦補上 Canvas360Dataset,提供 1M paired panoramic samples,支援 style transfer、inpainting、outpainting 同 editing,反映作者唔止做單一模型改良,仲想連訓練資料結構一併補強。

  • 核心定位係 FLUX-based framework,主打 text-to-panorama image generation 同全景補全
  • 關鍵方法包括 geometry-aware pretraining、continuous position encoding、circular latent padding
  • 已公開 inference code 同 training code,但 model weights 與 online demo 仍然未釋出
  • 需要 base model black-forest-labs/FLUX.1-dev,並可配合自備 LoRA 跑生成或下游任務
  • 相關比較對象包括 PanFusion、SMGD、PAR、WorldGen、HunyuanWorld、DiT360,以及 FLUX.1-Kontext-dev、FLUX.2-dev、Qwen-Image-Edit

測試同現階段較接近研究型項目而唔係即開即用服務。儲存庫已提供 inference.py 同 inference_downstream.py,代表你可以在本地環境配好 PyTorch、依賴套件、FLUX.1-dev 存取權同 LoRA 後,直接驗證文字生成全景,或者試全景補圖與延展;不過權重未公開,所以現時更適合研究團隊、全景影像工具開發者,或者想研究 360 度生成方法嘅人先行閱讀同跟進。現有介紹強調結果比多個舊方法更少接縫瑕疵、結構更清晰,但儲存庫內容未見完整量化指標表,判斷性能仍要等論文與權重進一步公開後先更穩陣。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型, 視覺模型, 模型訓練, Stable Diffusion, Image, 影像模型, 框架, Python, Dataset 數據集

UniClawBench 點樣測主動式代理

要比較主動式 AI agents,單看單輪答題已經唔夠。UniClawBench把工具操作、瀏覽器、檔案同 GUI 流程放入同一個閉環評測。

UniClawBench

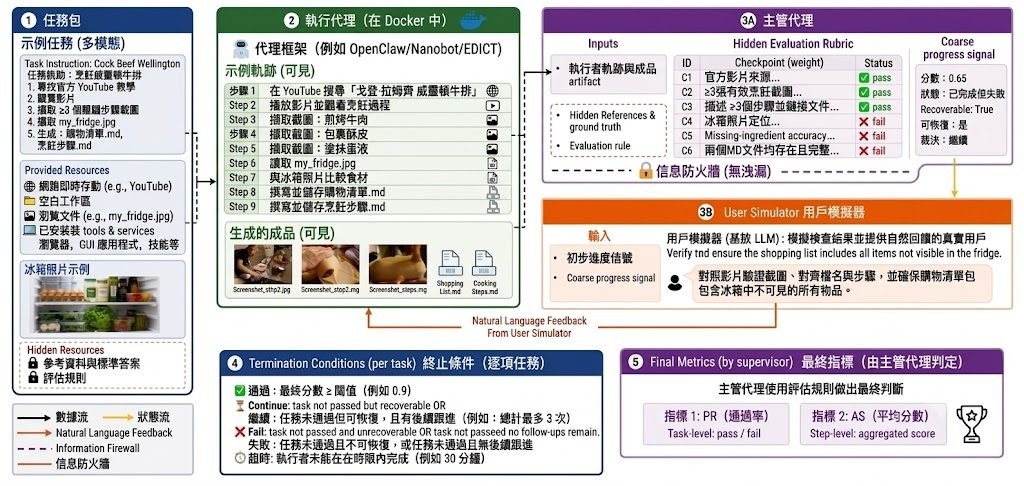
比起只問模型識唔識答,UniClawBench更在意代理能否一路做、一路修正,直到完成整個工作流。它屬於benchmark 項目,針對 proactive AI agents 在真實工具、瀏覽器、檔案處理與桌面 GUI 任務中的完成能力,補足傳統單步評測難以反映連續操作表現的缺口。

現有做法常把 agent evaluation 壓縮成靜態問答、固定軌跡重播,或者只看最後答案;作者明確改用 three-role closed-loop evaluation framework,將 executor、hidden answer supervisor 同 public user simulator 分開。呢個設計的重點,是同時檢查代理點樣行動、途中有冇偏離、收到回饋後能否繼續修正,而唔係只計一次輸出啱唔啱。

公開版本提供 400 個雙語任務,英文與中文各 200 個,覆蓋 Skill Usage、Exploration、Long Context、Multimodal、Cross Platform 五類能力。部署思路亦算清晰:倉庫已放入 packaged task resources、Docker-based runtimes、distributed dispatch scripts,同埋可檢視 leaderboard、trace、artifacts 與 timeline 的 WebUI;要跑測試,核心其實是先填好 executor、Codex provider 同 API keys 相關設定檔,再用它的執行環境批次評估。

  • 用 three-role 閉環評測取代一次性答題
  • 任務同時涉及 browser、files、GUI apps 與其他工具
  • 400 個雙語任務,較易檢查跨語言穩定性
  • WebUI 可回看 traces、artifacts 同示範流程

從補充資料看,作者想指出的取向幾鮮明:framework choice 對能力表現的影響,往往比 model choice 更大,而 long-context 與 multimodal 仍是主要瓶頸。相關模型與組合亦有列出,例如 GPT-5.4、Claude Opus-4.8、Kimi-2.6,並配合 OpenClaw、EDICT、Nanobot 等框架比較;對研究 agent system、企業內部自動化流程,或者想建立較完整評測流水線的團隊,這個項目的參考價值高過單純看排行榜。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, Agentic, 多模態模型, OpenAI, API, 框架, OpenClaw, Anthropic, Dataset 數據集, Skill 技能

RCORE 為什麼我打不開抽屜

同一個抽屜,模型可能只見到物件就判成「關上」。RCORE 針對這種偏差補上時序線索,重點不在多記類別,而是少走錯路。

RCORE teaser

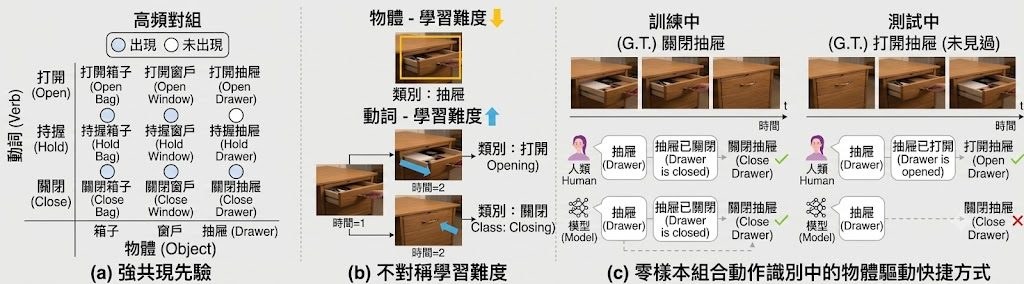
見到抽屜就猜「關上」、見到杯就猜「拿起」,正是 Zero-Shot Compositional Action Recognition (ZS-CAR) 最容易失手的位置。RCORE 是一個研究型模型項目,處理的是新 verb–object 組合辨識,核心不是再加更多標籤,而是壓低模型依賴物件類別走捷徑的傾向。

現有做法多數沿用已見過的共現關係去推斷動作,作者指出這種 fixed compositional supervision 會令模型把 object 當成近路,忽略影片中的 temporal evidence。RCORE 的回應很直接:用 CPR(Co-occurrence Prior Regularization)補足原本缺席的組合監督,同時把常見配對當成 hard negatives;再用 TORC(Temporal Order Regularization for Composition)迫使 verb 表徵對時間順序敏感,而不是學成靜態語意。

這個取向的價值,在於它不是單純追求更強 backbone,而是修正 ZS-CAR 的學習偏差。論文亦加入 FSP、FCP 與 Compositional Gap 這幾個診斷指標,不只看最後準確率,亦檢查模型是否真的較少受 co-occurrence patterns 牽引;已公開資訊指出,它在 Sth-com 與 EK100-com 都能改善 compositional generalization。

  • 重點放在減少 object-driven shortcuts,不是單靠物件猜動詞
  • CPR 針對訓練配對偏斜,TORC 針對時序線索不足
  • 準備 Python 3.10、requirements,以及特定 tokenizer 詞彙檔
  • InternVideo2 1B backbone 依賴 flash-attn,CLIP / InternVideo2-Base 則較易測試

部署與測試方式偏向研究流程:先安裝相依套件、準備資料,再跑 training 與 evaluation;它較適合做影片理解、組合泛化或 benchmark 分析的團隊,而不是即插即用的產品工具。相關模型與骨幹包括 CLIP、InternVideo2-Base、InternVideo2 1B;對於想研究模型為何會「看錯動作」的人,RCORE 比單看分數更有參考價值。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, Qwen, VLA, Robotic, Python, Dataset 數據集

Video-Oasis 想重做影片理解評測

不少影片 benchmark 分數看似漂亮,其實未必真係考到影片理解。Video-Oasis 把焦點放回評測本身,專門拆解捷徑題與真正需要時序證據的題目。

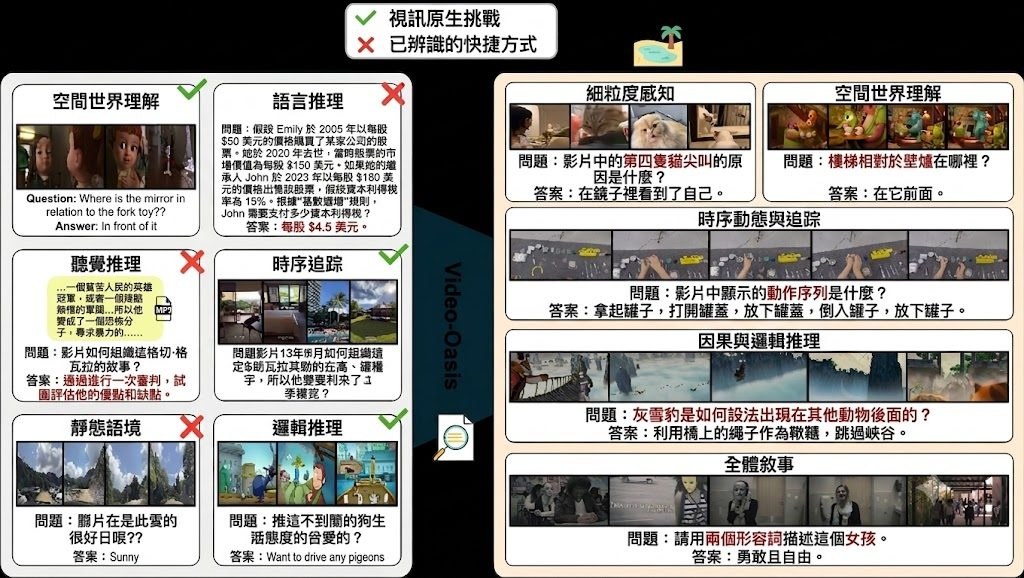
video native challenges

高分未必代表模型真係睇得懂影片,呢個項目正正針對呢個落差。Video-Oasis 屬於資料集與評測項目,重點不是再加一份題庫,而是重新檢查現有 video benchmark 到底有幾多題目真的需要 visual grounding 與 temporal reasoning,避免模型只靠文字線索、單幀畫面或靜態背景就答中。

普遍做法是把不同影片問答 benchmark 直接合併比較,作者認為這種固定範式忽略了「是否真係需要影片」這個前提。Video-Oasis 先整理 14 個 benchmark、24,416 個 QA samples,再用共享的 visual 與 temporal criteria 審視題目,結果指出約 55% 樣本可被 non-video shortcuts 解開,之後再萃取出 11,033 個較具代表性的 Video-Native 挑戰。

它和同類 benchmark 最大分別,在於不是追求覆蓋更多題型,而是先清理評測污染。官方資料提到五類 video-native challenges 才是核心難點,而現時模型在這部分表現仍然偏弱,最佳模型 Gemini-2.5 Pro 只有 46.7%,接近 chance 25.63% 之上不遠,說明這套評測更能拉開「答得中」與「真理解」之間的差距。

  • 涵蓋 14 個 benchmark,任務由 perception 延伸到 reasoning,片段長度由幾秒到數小時
  • 以 shared visual and temporal criteria 重新審核題目,不是單純拼接舊 benchmark
  • 約 55% QA samples 可用 non-video shortcuts 解答,真正 video-native 部分約佔 45%
  • 評測流程建基於 lmms-eval,並支援透過 huggingface_hub 下載模型
  • README 已提供資料下載、影片修復與目錄整理方式,但完整程式碼仍標示為 coming soon

部署理解上,它較像一個研究型 benchmark workflow:你要先準備 Python 3.12、CUDA-compatible GPUs、torch、vllm 0.11.0 與 transformers 4.57.0,再下載各 benchmark 影片、用 ffmpeg 腳本修復損毀檔案,之後透過內建 lmms-eval 跑 vqa_total 或 v_oasis 任務。現階段較適合做模型評測、研究比較,或者幫團隊檢查自家 video model 是否只是在 benchmark 上「識考試」,未必適合作為即裝即用的應用工具。

項目預設支援可由 huggingface_hub 下載的模型,示例提到 Eagle2.5-8B;成績說明中則點名 Gemini-2.5 Pro 為目前最佳表現者。整體來看,Video-Oasis 最有價值的地方不是再造一個排行榜,而是把影片理解評測裡最容易被忽略的捷徑問題公開化,令後續模型比較更可信。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 視覺模型, 視頻模型, NVIDIA, Gemini, Video, Python, Dataset 數據集

PhyMRI-SR:MRI 超解像唔只靠放大

PhyMRI-SR 針對 MRI 超解像入面常見的取捨:解析度愈高,訊噪比未必愈好。它唔係單純補像,而係把 MRI 成像物理一併放入重建流程。

Repository image for weilihua0205/PhyMRI-SR

做 MRI 超解像時,問題往往唔係「放大得夠唔夠」,而係高解析度同 SNR 會互相拉扯。PhyMRI-SR 把這個矛盾放到核心處理;它屬於一個醫學影像超解像模型/研究項目,目標不是盲目追求最高輸入解析度,而是找出更有結構資訊的重建位置。

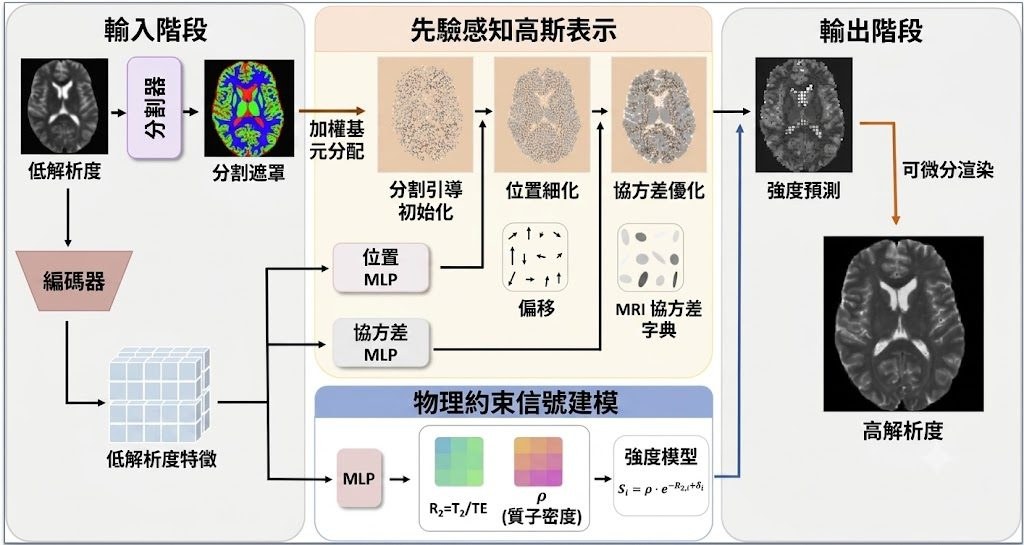
現有做法多數把低解析度 MRI 當成一般影像放大;作者認為這種 fixed paradigm 忽略 MRI acquisition physics,亦未必對應最有資訊量的輸入條件。PhyMRI-SR 因而改用 physics-aware Gaussian splatting,把組織先驗、MR signal equations 同 continuous-scale super-resolution 合併,嘗試沿住 resolution-SNR spectrum 找到更合理的平衡點。

它不是直接生成高解像圖,而是先經 segmentation-guided primitive allocation 分配 Gaussian primitives,再由 prior-aware representation 預測位置偏移與協方差,之後用 physics-constrained signal modeling 根據 tissue properties(例如 alpha、R2)計算訊號強度,最後經 differentiable splatting 合成影像。另加 meta-learning-based adaptation,用來縮窄 synthetic training 與真實 low-field MRI 之間的 domain gap。

  • 與一般影像式 SR 比較,重點放在物理一致性,唔係純粹視覺銳化
  • 支援 arbitrary-resolution 輸入,同 continuous-scale MRI super-resolution 取向一致
  • 結構上結合 segmentation、Gaussian representation 同 MR signal equations
  • 結果顯示最佳表現未必出現在最高輸入解析度,回應作者的核心假設

項目列出 simulated 與 real multi-resolution MRI datasets 的比較:模擬資料在 x0.7 時錄得 PSNR 28.10 dB、SSIM 0.9234、HFEN 0.3051、DISTS 0.1148;真實資料在 x0.76 時取得最低 HFEN 0.4570,其他指標亦有競爭力。這類結果較適合醫學影像研究、MRI 重建與超解像團隊參考;部署與測試細節仍需回到 GitHub 程式碼確認,但整體定位已很清楚:它不是通用修圖工具,而是面向 MRI 成像規律的專門方法。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, 影像處理, Medical醫學, Meta, 中國, Dataset 數據集

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

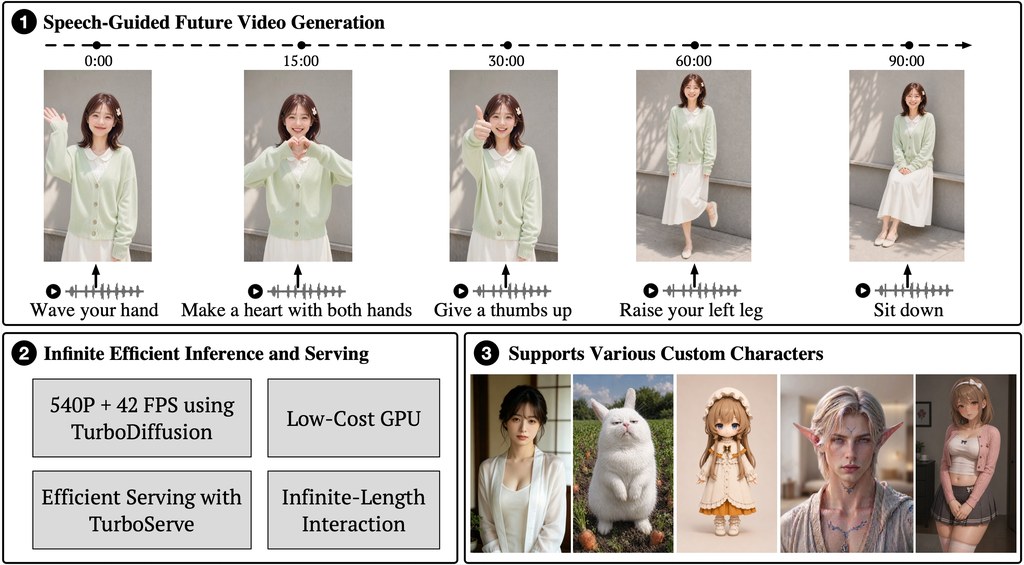
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

Page 20 of 29
1 … 18 19 20 21 22 … 29