RoboSPA 用 280 個難度變體幫你壓力測試

RoboSPA 是浙江大學團隊針對 Vision-Language-Action 模型推出的診斷式基準,透過逐步拉高空間歧義與程序步數,揭開現有機器人策略在精準定位與長程規劃上的短板。

Repository image for fanzhenxuan/RoboSPA

當 VLA(Vision-Language-Action)模型在乾淨、短任務的環境中跑出不錯的成功率,要怎樣才知道它是真正「理解」指令,還是只是剛好蒙對?RoboSPA 給出的答案是:把場景弄得更亂、把步驟拉得更長,然後看模型從第幾關開始崩潰。這是一個基準與數據集項目,建基於 RoboTwin 2.0 模擬框架(SAPIEN + CuRobo),由浙江大學主導,已獲 EMNLP 2026 收錄。

它把 56 個基礎任務各衍生出五個難度級別(L1–L5),共 280 個變體,覆蓋五種機械臂實體(Franka、Piper、UR5、Aloha-AgileX、ARX-X5),總計 527K 條軌跡、約 108M 步數、997 小時互動影片。Spatial 維度持續加入外觀相近的候選物,Procedural 維度則逐步疊加子目標、執行順序、重複次數與記憶需求。

與只看最終二元成敗的傳統做法相比,RoboSPA 額外提供兩個診斷指標:空間任務用 ONTA(Object-Normalized Target Accuracy) 衡量模型能否在「看起來都像」的物件中選對目標,並以 chance-corrected 方式扣掉隨機命中;程序任務則用 Progress Score(PS) 計算實際完成的子目標比例,反映模型在中途卡住或跳步的真實狀況。

適合機器人實驗室、VLA 模型開發者,以及需要評估策略可擴展性的團隊。支援自帶策略接入,數據與代碼均已公開。研究端在多個代表性 VLA 模型上的結果顯示,空間關係、低階精細動作與長程記憶仍然是明顯瓶頸。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, Video, VLA, 框架, 中國, Dataset 數據集

Marigold V2:把擴散 Transformer 改成一步深度估計模型

只要一張普通 RGB 相片,就即時輸出高質素深度圖,連毛髮和髮絲等幼節都保留到。Marigold V2 把預訓練擴散 Transformer 改造為單步密集預測模型的開源項目,一張消費級 GPU 一星期內就能完成微調。

Project website

過去做單目深度估計,要麼靠傳統監督學習,要麼用擴散模型疊好多步去噪,兩者都唔易兼顧細節同效率。華為 Bayer Lab 開源 Marigold V2 走第三條路:直接把預訓練嘅擴散 Transformer(DiT)當成單步密集預測器,重新微調之後輸出深度、透視深度、法線、反照率等多種密集模態,毋須反覆去噪。對從業人員嚟講,呢個改動意味住一張普通 RGB 相可以即時變成帶細節嘅深度圖,毋須等幾秒去疊步驟,毛髮邊緣同髮絲呢類幼節都保留得到,貼近 SOTA 水準。

模型家族同訓練成本:每個 checkpoint 包含一組 rank-128 LoRA 適配器,配合 4-bit 量化嘅 DiT 主體,個別任務仲會附帶微調過嘅 VAE 解碼器。底層凍結嘅基礎模型會另外下載。整個微調流程用單張消費級 GPU 少於一星期就完成到,對個人開發者同細型實驗室都係可觸及嘅範圍。

程式碼結構清晰,方便二次開發:倉庫用 manifest graph 加 transform list 嘅方式定義數據集,網絡組件同損失函數都係讀寫 batch dict 嘅有序步驟,數據集定義、網絡圖、損失圖、優化排程四個層次分得幾開。對想擴展到新任務嘅人嚟講,只要跟住呢個結構加步驟就得,唔使由零砌起。

對比傳統多步擴散深度估計,Marigold V2 犧牲咗迭代式去噪嘅靈活性,但換嚟一步推理嘅速度同細節還原度;對比純監督方法,佢借用咗擴散模型對紋理同邊界嘅先天理解力,再加 LoRA 保持輕量。同一批權重仲可以用喺 metric depth completion 等下游任務,一個模型覆蓋多個密集預測場景。

**適合做 AR/VR、3D 重建、影像合成嘅中小團隊,或者想低成本試驗新密集預測任務嘅研究者,都會覺得呢個 setup 幾啱手。HuggingFace 上有對應嘅 demo 空間可以直接試,權重同訓練推理碼都已開源。

項目主頁 · GitHub · 模型

Categories: 開源, 華為, 模型, 模型訓練, Qwen, Image, 3D, 庫, Dataset 數據集

OpenWAM-α 把世界模型與動作模型拆開重組

來自XPolicyLab等團隊的開源研究棧OpenWAM,把世界–動作模型(World-Action Models)拆解成可替換模組,並以約6,400小時第一人稱與機器人資料訓練出OpenWAM-α,在八個模擬基準與真機實驗均取得頂尖表現。

OpenWAM

如果你是做機器人策略或世界模型研究,大概都有過這種經驗:想換一個視覺編碼器、想試不同動作頭的耦合方式,結果整個訓練流程都要重寫,因為生成骨幹、視覺表示、架構、推論步驟和訓練資料全綁在一起。OpenWAM正是針對這種「綁死」的痛點而來。它是一個開源研究棧,把世界–動作模型(World-Action Models,簡稱WAMs)的設計空間拆成可組合模組,並用統一介面串接訓練、推論、部署與評估。

這個項目分成三層。OpenWAM-Infra提供模組化基礎設施,讓研究者可以像堆積木一樣替換模型、表示、訓練與評估設定;OpenWAM-Study則透過控制變量實驗,回答三個核心問題:應該從什麼預訓練骨幹繼承知識、世界學習與動作學習如何耦合、以及兩者如何隨規模擴展。基於這些結論,作者訓練出OpenWAM-α,一個以約6,400小時(5.185億幀)第一人稱人類與機器人資料預訓練的開放模型,並在涵蓋單臂、雙臂到靈巧手的八個模擬基準,以及真機實驗中維持頂尖水準。

架構由Hydra配置檔驅動,預設採用wan22 ti2v 5B作為影片骨幹,並搭配獨立的動作頭(如ActionDiT或共享動作骨幹),視覺編碼器則可在VAE、DINOv3、V-JEPA 2.1之間切換。基準測試覆蓋RoboTwin、LIBERO、LIBERO-plus、RoboCasa365、RoboCasa GR1、VLABench等主流環境,研究者可以直接用提供的評估客戶端跑對比。

  • 定位:開源研究棧,專門解決世界–動作模型設計選擇難以分離比較的問題
  • 核心貢獻:把生成骨幹、動作頭、視覺表示等模組化,並用控制實驗歸納出三條設計原則
  • 預訓練模型:OpenWAM-α基於約6,400小時第一人稱與機器人資料訓練,在八個模擬基準及真機均表現頂尖
  • 適用對象:機器人策略學習、世界模型研究團隊,以及需要可重現基準對比環境的從業者
  • 配套資源:模型已上傳Hugging Face,並提供完整的訓練、推論、部署腳本

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港大學, 模型, 世界模型, 模型訓練, Video, World-Action Model, 庫, Dataset 數據集

TANGO:人形機器人穿越凌亂房間,全靠語言指令

TANGO 是一個讓人形機器人聽到自然語言指令後,自動調整手腳、軀幹與步態避開雜物的全身控制框架,可以理解成把機械人導航從「會走」升級成「會穿過沙發底下」。

TANGO architecture and data-generation pipeline.

如果叫一部人形機械人從客廳走到廚房,但途中堆滿紙箱、雜物、窄縫,一般導航演算法只懂「規劃路徑」,對它來說幾乎等於廢武功,因為雙腳、雙手、腰部其實要邊行邊配合地形郁動。TANGO(whole-body Vision-Language-Action model)正正為這種場景而設計:收到一句自然語言指令,加上前置與向下望的 RGB 影像後,模型直接輸出 29 個自由度(29-DoF)的全身關節角度,配合 6D 底盤旋轉表示,令機械人能夠一邊行、一邊擺手收腹避開障礙。

訓練數據全部來自模擬器,背後有一套名為 Plan-Edit-Track 的流水線:先用全局路徑規劃,再做全身逆向運動學(Kinematics)動作生成,接住用障礙感知編輯避開擺位,最後用強化學習追蹤確保動作真實做得出嚟。訓練集基於 VLNVerse 與 SAGE-3D 場景,再加入側向、貼地、頂部等多類障礙,務求貼近真實家居亂況。

TANGO💃🏻 Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model

模型結構本身亦幾講究:底層係一個 70 億參數(7B)的視覺語言骨幹,配搭一個用 flow-matching(流匹配)訓練嘅 MM-DiT(Multi-Modal Diffusion Transformer,多模態擴散 Transformer)動作專家,再加一個低階全身追蹤器負責即時執行。部署時 VLA(Vision-Language-Action,視覺語言動作)模型喺伺服器低頻運行,追蹤器喺機械人 onboard 高頻運行,做到實時反應。

實驗結果方面,TANGO 喺模擬與真機測試都提升咗語言導航表現,最重要係零樣本遷移(zero-shot transfer)直接落 Unitree G1(宇樹 G1)人形機械人,唔使額外真實數據再訓練。對研究 VLA、機器人導航或人形機械人部署嘅團隊嚟講,呢套 pipeline 連數據生成到模型結構都幾值得拆解。

重點摘要:
– 語言指令直接對應全身 29-DoF 動作,涵蓋手、軀幹、步態協調
– Plan-Edit-Track 流水線全模擬訓練,配合 VLNVerse 與 SAGE-3D 場景生成
– 採用 7B 視覺語言骨幹 + flow-matching MM-DiT 動作專家雙模組設計
– 伺服器跑 VLA、機械人 onboard 跑追蹤器,支援實時控制
– 零樣本遷移至 Unitree G1,無需真實訓練數據

項目主頁

Categories: 香港大學, 模型, 視覺模型, 多模態模型, 模型訓練, Video, VLA, Robotic, 框架, Dataset 數據集

CosmoH2G 將人手示範轉成機械夾具軌跡

CosmoH2G 針對旋轉、翻轉等複雜空間動作,把人手示範轉換成機械夾具可執行的軌跡;其資料集包含 6,189 組配對示範。

dataset

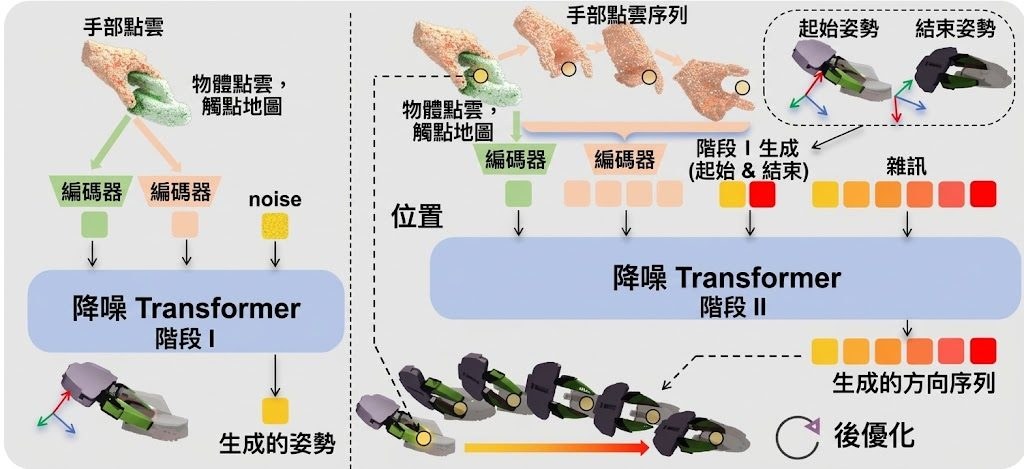
人手示範雖然直觀,但當動作包含旋轉、翻轉或複雜空間路徑時,機械夾具往往難以直接模仿。CosmoH2G 是一套面向機械人操作的資料集與基準方法,專門處理 hand-to-gripper transfer:研究團隊同步記錄人手和手持機械夾具的動作,建立可配對的 RGB-D、3D 物件點雲、手部網格及夾具動作資料。

資料集共有 6,189 個配對示範、涵蓋 1,254 件物件,規模足以支援複雜空間操作的研究。與只適合平面移動的做法相比,CosmoH2G 把重點放在細緻的手部姿勢和空間運動,並以手持夾具示範減少人與機械裝置之間的動作轉換落差。

方法分兩階段處理完整軌跡。Stage I 先預測起點和終點等稀疏關鍵幀,把複雜動作濃縮成較容易學習的目標;Stage II 再以關鍵幀為條件生成連續的夾具姿態序列。系統亦保留夾具姿態的學習結果,再利用抓取啟發式與運動學一致性修正位置,減少旋轉和翻轉過程中的累積偏差。

在模擬及真實機械人實驗中,能穩定轉移旋轉等複雜動作,並明顯勝過傳統基準。適合研究機械人模仿學習、操作資料集、3D 手部追蹤,以及需要處理非平面夾具運動的團隊。程式碼和資料集在項目網站標示為即將推出,現階段較適合先評估方法和收集流程,部署細節仍要等官方發佈。

  • 6,189 組人手與夾具配對示範,涵蓋 1,254 件物件。
  • 專注旋轉、翻轉和其他細緻空間軌跡,而非平面搬運。
  • 兩階段先學關鍵幀,再生成完整連續動作。
  • 以抓取啟發式和運動學一致性降低累積漂移。
  • 適合機械人模仿學習、資料集研究及操作策略開發。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 視覺模型, 模型訓練, Robotic, 3D, Dataset 數據集

MovieGrid 把長片拆成方格生成,解決多鏡頭一致性

來自 UC Santa Cruz 等院校的 MovieGrid 框架,把長片拆成空間方格同步生成,目標是同時兼顧鏡頭內連續動作與跨鏡頭視覺一致性。

Repository image for jwmao1/moviegrid

MovieGrid 針對的痛點很直接:現有影片生成模型傾向犧牲多鏡頭敘事完整性來換取單鏡頭內的動作連貫,而傳統把整段故事沿時間軸壓縮的做法,更會加深這個偏差。

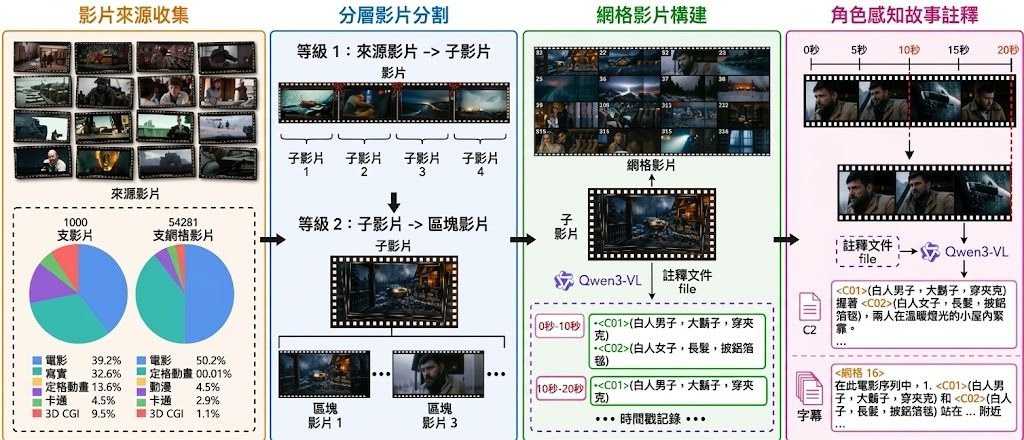
核心做法是把一段長影片切成分佈於空間方格上的短片段,每格只負責少量鏡頭與較短的時間跨度,從而降低單格需要建模的轉場數量;同時所有格子會被聯合生成,並透過 Grid Embedding、角色感知的 Story Prompt 以及 Grid Boundary Loss 來維持格與格之間的銜接。訓練時採用的 Noise-Free Random-Grid Training,會隨機保留部分格子作為乾淨視覺上下文,引導其餘格子的去噪過程。

項目以 Wan2.2-TI2V-5B 作為基座模型,並配搭自家構建的 MGLV 資料集——從 1,000 段長片萃取出 54K 條方格影片,每條都附有角色級故事標註。在等量 token 預算下,MovieGrid 在 1,616 幀長片裡可生成比 Temporal Packing 基線多 6.05 倍的鏡頭,並在自建基準上取得 0.9131 的鏡頭內一致性與 0.5914 的跨鏡頭一致性,分別優於 HoloCine 與 StoryMem。

目前已開源 16 格與 64 格的訓練與推理配置,以及對應的 MovieGrid-16、MovieGrid-64 LoRA 權重;環境需以 Python 3.10 搭配官方 Wan2.2 倉庫安裝。對需要批量產出多鏡頭短片、廣告分鏡或敘事預覽的團隊,這套框架提供了比單時間軸方案更可擴展的路徑,但生成品質仍受基座模型與資料規模所限,未來計劃加入 first frame 與 storyboard 條件控制。

重點摘要:
– 核心方法:將長片切成空間方格短片段並聯合生成,減輕每格時間跨度負擔。
– 關鍵機制:Grid Embedding、角色感知 Story Prompt、Grid Boundary Loss 與 Noise-Free Random-Grid Training。
– 基座與資料:基於 Wan2.2-TI2V-5B,配搭自建 MGLV 資料集共 54K 條方格影片。
– 開源狀態:已釋出 16 格與 64 格的推理配置、訓練代碼,以及對應 LoRA 權重。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, Embedding, 模型, 模型訓練, Video, 框架, Python, 庫, Dataset 數據集

Perplexity 開源 Lily:Mac 本地推理專用提速引擎

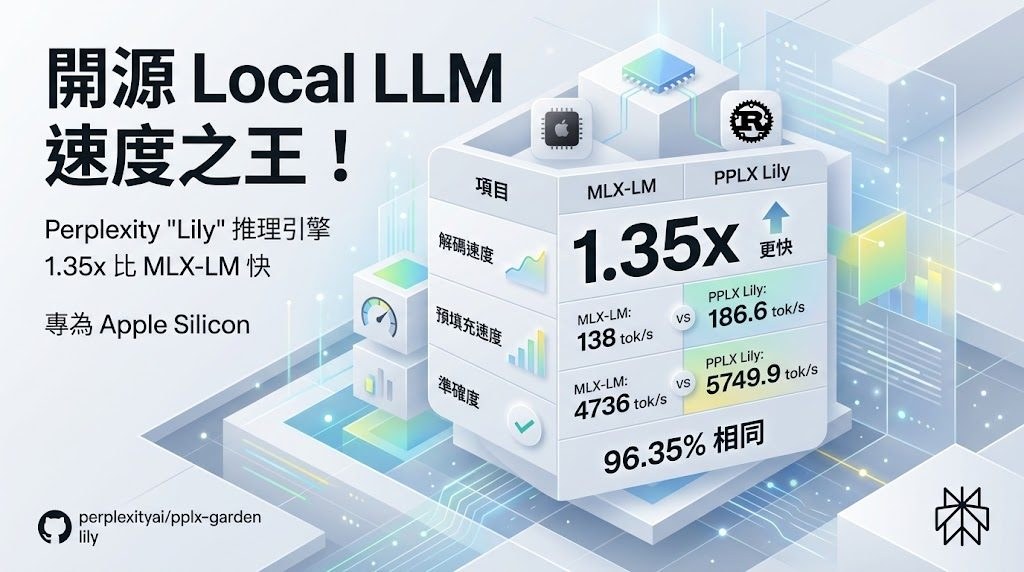
Perplexity 推出針對 Apple Silicon 與 Qwen3.6-35B-A3B 的本地推論引擎 Lily,繞過 PyTorch 與 MLX,以 Rust 和自訂 Metal kernels 改善預填充及解碼效率。

Repository image for perplexityai/pplx-garden

當大型模型開始負責處理 Mac 上的私人檔案與應用程式,本地推論速度就不再只是開發者實驗的指標。Perplexity 開源嘅 pplx-garden 入面,Lily 以工具項目形式處理 Apple Silicon 上 Qwen3.6-35B-A3B 的推論,目標係令提示詞處理及文字生成更快,並透過 OpenAI-compatible HTTP API 串接聊天流程。

Lily 唔似 MLX-LM 般追求支援多款模型,而係集中服務 Qwen3.6-35B-A3B:Rust runtime 負責載入 checkpoint、管理 session state 同生成迴圈,自訂 Metal kernels 就處理模型特定運算。呢種單一進程、模型與 runtime 共同協調嘅做法,減少通用 kernel 帶來嘅額外調度,亦避開 PyTorch 和 MLX execution path。

pplx-garden 不只是 Mac 本地推論工具。fabric-lib 提供 RDMA TransferEngine,同時涵蓋 P2P MoE dispatch 與 combine kernel;pplx-unigram 則係針對 Unigram tokenizer 嘅 CPU encoder。相關內容亦包括 trillion-parameter model 喺 AWS EFA 上嘅部署,以及 RL post-training 權重轉移、分離式 prefill 和 decode 等系統研究,顯示儲存庫涵蓋由裝置端推論到分散式 LLM infrastructure 嘅多個瓶頸。

適合需要喺 Mac 處理敏感資料、又希望保留本地生成能力嘅開發者及研究團隊;需要 RDMA、MoE 溝通或 tokenizer 優化嘅系統工程人員亦可參考相關元件。現有資料集中講述 Lily 分別量度 prefill throughput 同 decode throughput。

重點摘要:
– Lily 專為 Apple Silicon 與 Qwen3.6-35B-A3B 設計,支援 OpenAI-compatible HTTP API。
– 以 Rust runtime 配合自訂 Metal kernels,分開處理 prefill 同 decode。
– 不經 PyTorch 或 MLX execution path,代價係模型及硬件支援範圍較專門。
– fabric-lib 同 p2p-all-to-all 面向 RDMA、MoE dispatch 與 combine 等分散式推論問題。
– 效能應按裝置、上下文及生成負載實測,不能只依賴官方定位作比較。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, OpenAI, API, 提示詞, 工具, Mac, Python, 庫, 蘋果, Dataset 數據集

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

VibeVoice-ASR-Streaming-7B 即時辨識與轉錄合而為一

Microsoft Research團隊將講者辨識加入串流語音轉錄,讓語音助手更快知道誰在說甚麼。

Hugging Face

Microsoft Research 聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。

模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。

VibeVoice-ASR-Streaming 會交錯處理固定大小的audio chunks,並加入少量lookahead,讓模型在保留未來聲音片段作判斷的同時,逐步產生轉錄結果。固定分塊有助控制處理延遲,但lookahead 與分塊大小之間仍要取捨:前者越多,講者切換及語句判斷可能更穩定,回應時間亦可能增加。

  • 以單一LLM-based端到端模型同步處理ASR與speaker attribution
  • 使用固定大小audio chunks及少量lookahead支援串流輸出
  • 針對即時語音助手及agents的低延遲需求設計
  • 量化檔案、推論框架、硬體需求及效能指標尚未在提供內容中交代

項目主頁 · Paper · 模型

Categories: Agentic, 微軟, Audio, Discord, LLaMa, Ollama, 語音, Dataset 數據集

Hojo-ASR-Multi-V1:廣東話語音識別引擎

基於 Qwen3-4B-Instruct-2507 微調而成的多語言語音辨識模型,覆蓋歐亞九種語言,嘈雜環境與口語修正都有對應訓練。

Og image

如果你聽過一段嘈雜環境裡帶口音嘅外語對話,想即時轉成文字,Hojo-ASR-Multi-V1 就係針對呢類場景設計嘅。它並非由零訓練嘅語音模型,而係喺 Qwen/Qwen3-4B-Instruct-2507 之上做微調,把語音編碼器接駁到大語言模型嘅解碼端,形成 Encoder-Adapter-LLM 嘅典型結構,再加入多幀聲學融合模組去保留細粒度嘅聲音特徵。訓練過程分階段進行並結合強化學習,所以喺噪音、非標準發音、講錯即改口呢類真實情境下都唔會輕易崩潰。

多語言覆蓋係佢最突出嘅賣點。官方公布支援德、法、西、葡、意、日、阿拉伯、韓、俄等九種主要語言,並加入咗普通話、英語、廣東話同四川話等方言支援。從公開評測結果睇,佢喺多個 CoVoST、MLS 同 FLEURS 基準上都錄得相當低嘅 WER,例如意大利 FLEURS 2.30、法語 MLS 2.95、德語 CoVoST 3.85,整體表現平穩。

喺使用層面,開發者可以透過 PyPI 上嘅 hojo-asr 套件快速部署,亦支援 Hugging Face Transformers 後端。HOJO_ASR.load_model 介面可以直接接收 wav 檔案路徑、scp 清單或原始音訊 bytes,配合 CUDA 設備做批次推論。授權用 Apache-2.0,並提供商業整合支援,方便團隊接入產品線。

由於佢建基於 Qwen3-4B 體量,運行門檻比傳統大型 ASR 親民得多,但仍然需要 GPU 推論以維持批次速度。

重點摘要:

  • 基礎模型:以 Qwen/Qwen3-4B-Instruct-2507 為骨幹,採用 Encoder-Adapter-LLM 架構
  • 語言覆蓋:歐亞九國主要語言,加普通話、英語、廣東話、四川話
  • 訓練方式:多階段模組化訓練結合強化學習,針對噪音同口語修正優化
  • 評測表現:CoVoST、MLS、FLEURS 多語言 WER 普遍處於 2–5 區間
  • 部署方式:pip install hojo-asr 後用 HOJO_ASR.load_model 載入,支援檔案路徑、scp 或 bytes 輸入

需要留意嘅係,頁面並未提供 GGUF 量化檔案或本地推論引擎資訊,目前主要以 transformers 後端配合 GPU 運行;如果你想喺純 CPU 或邊緣裝置上使用,就要留意後續會唔會補上量化版本。

項目主頁

Categories: 開源, 模型, Qwen, Audio, 庫, 語音, Dataset 數據集, 廣東話

Page 5 of 29
1 … 3 4 5 6 7 … 29