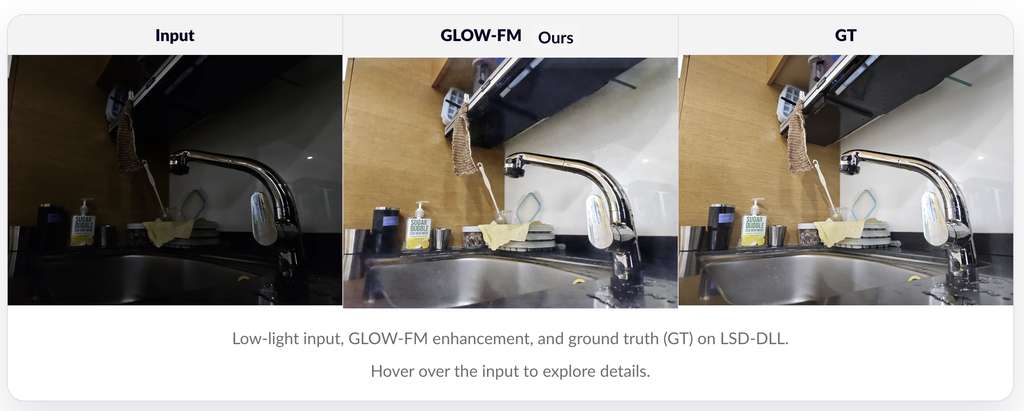
GLOW-FM:單步提升低光影像質素

GLOW-FM 把低光影像增強壓縮至一次網絡運算,兼顧生成質感與推理效率,適合資源有限的影像處理場景。

Low-light kitchen scene

低光相片往往同時缺乏細節和自然色彩,逐步生成雖然有助改善觀感,卻增加運算成本。GLOW-FM 是一個低光影像增強(Low-Light Image Enhancement, LLIE)模型項目,透過一次網絡評估恢復影像,處理高質素與低延遲之間的取捨。

項目把影像先映射到緊湊的 latent space,再由輕量 Tiny-VAE 和 Hourglass Diffusion Transformer(HDiT)合作完成修復。HDiT 以 Terminal Velocity Matching(TVM)訓練,推理時只需一步;GLOW-FM-S 的公開規模為 34 GFLOPs 及 9.1M 參數,對邊緣裝置或需要批量處理的工作流程較有吸引力。

  • 一次 function evaluation,避免傳統 diffusion 反覆採樣
  • 在 LSD-DLL 等資料集展示具競爭力的影像質素
  • TVM 專門用於低光增強,並與其他單步目標作比較
  • 跨資料集結果在比較方法中具較強泛化能力

GLOW-FM 延續曾於 NTIRE 2026 Low-Light Image Enhancement Challenge 取得第一名的 LFM-LLIE,但更集中處理效率與單步推理。儲存庫要求 Python 3.11 或 3.12,以及具 CUDA 支援的 PyTorch 環境;README 提供 setup.sh 和依賴安裝方向,但目前提供的資料未足以確認預訓練權重、完整推理指令或 CPU 執行方案。研究團隊、影像增強開發者,以及需要在 GPU 資源受限環境處理夜景相片的團隊,可先按其環境要求建立測試環境,再核對模型權重和推理流程。
項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, NVIDIA, Image, 影像處理, Python, 庫, Dataset 數據集

CodeSpecWeave:寫碼容易,了解需求才是關鍵

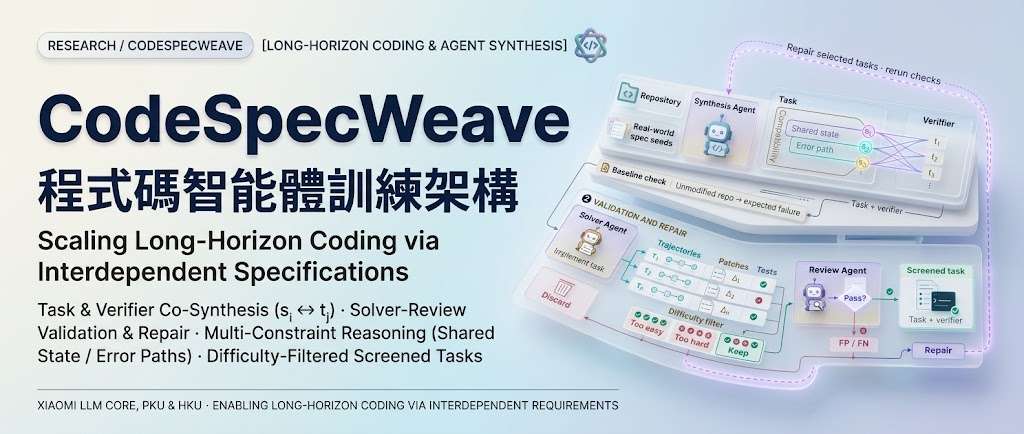
CodeSpecWeave 將互相影響的軟件要求編織成可執行訓練任務,測試編程代理能否維持整體行為一致。

Paper pipeline: task and verifier synthesis, baseline check, solver trials, difficulty filtering, trajectory review, and repair followed by revalidation.

新增一項功能,可能同時改變狀態、介面、錯誤處理路徑和執行次序。CodeSpecWeave 是一個面向 Computer-use agents 的編程代理訓練與評測項目,處理的正是這類不能逐項解決的長流程編程工作,要求代理在同一份實作中兼顧互相牽動的限制。

項目建立更貼近真實軟體工程的任務,用來訓練與評估 AI 程式開發代理(coding agents)。它不是一般的寫程式工具或線上 IDE,而是一套「產生開發任務、建立驗證測試、訓練及評估 AI」的研究框架。

網站用交易分配功能作例子:AI 不只要依金額比例分配資源,還必須同時確保總量守恆、最低分配額、四捨五入順序穩定,以及保留舊版單一收款人的行為。某一項需求單獨看似做對,整個功能仍可能不符合規格。

CodeSpecWeave 因此刻意讓需求共享狀態、執行路徑及生命週期限制,測試 AI 能不能把整組約束一起處理,而不是只寫出局部正確的程式碼。

  • 將獨立要求連結成 shared decision space
  • 同時檢查功能語意、狀態一致性和介面兼容
  • 以 executable tests 評估跨要求的聯合推理
  • 涵蓋真實 repository 與保留作評測的工程任務

項目主頁

Categories: 北京大學, Agentic, 模型, 模型訓練, World-Action Model, 香港, 軟件, 編程, Dataset 數據集, 小米-Xiaomi

RGB MoCap:把影片動作變成可編輯角色動畫

拍一段影片即可重建人體動作,再修正接觸點、套用角色並匯出動畫。

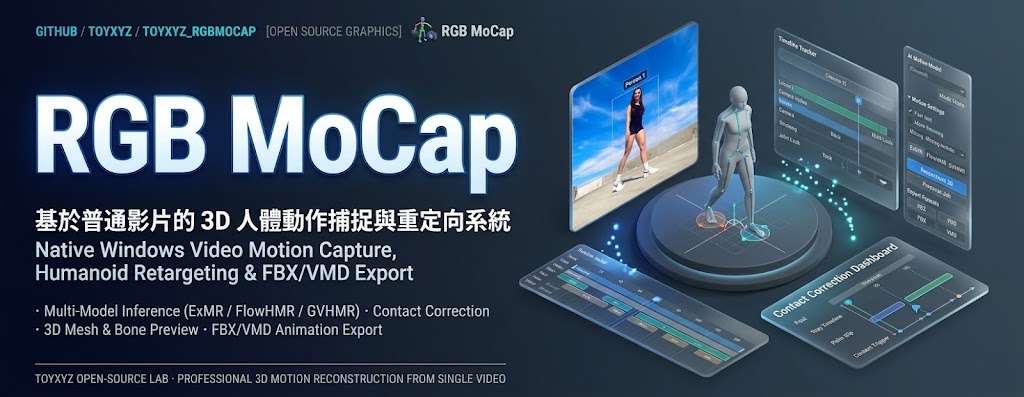
RGB MoCap workspace showing video tracking and a 3D motion preview

拍攝一段人物影片後,RGB MoCap 會重建人體動作,讓你在 3D 預覽中檢查身體網格與骨骼,再輸出可編輯的人體動畫。這個項目屬於本地運行的 Windows 動作捕捉工具,主要處理由普通影片取得角色動作、修正滑步,以及套用到不同角色格式的工作。

它不只追蹤身體,還提供腳掌和手掌接觸修正,接觸時間可以手動調整;動作可重新套用到 Mixamo FBX、VRM 和 PMX 人形角色,並輸出 FBX,亦可選擇是否連同網格一併匯出。多個 AI 模型的結果能分開保存,方便比較和重做。

安裝需要 Git for Windows、Blender、FFmpeg,以及 ExMR、FlowHMR、GVHMR 等模型運行環境;模型權重和註冊的人體檔案要在 Model Manager 另行準備,部分模型需要帳戶登記和手動下載。MAMMA 與 PromptHMR 屬於可選運行環境,另需 Visual Studio 2022 C++ Build Tools、Windows SDK 和 CUDA Toolkit 12.8;PEAR 則可用於 webcam 或影片中的單人即時身體及手指骨骼預覽。

  • AI 處理在本機完成,適合重視素材私隱的 Windows 使用者
  • 支援多人重建、動作骨骼預覽和 Multi Cam MoCap 工作流程
  • 接觸修正可減少滑步,但仍需人工檢查時間點和追蹤結果
  • 角色重定向涵蓋 Mixamo FBX、VRM、PMX,方便接入 3D 製作流程

提供安裝、更新、模型準備和恢復指引,也附有動作捕捉及角色重定向示例。適合視為可本地測試的製作工具,而不是已有完整性能保證的商用捕捉系統;動畫師、VRM/PMX 角色創作者,以及需要把影片動作帶入 Blender 的團隊會較容易受益。

GitHub

Categories: 開源, AI productions, 模型, NVIDIA, API, Video, 工具, Content Creator, 3D, 庫, 動畫, Dataset 數據集

agent-desktop:讓 AI 代理讀取並操作桌面應用程式

以 OS accessibility tree 取代像素定位,讓 AI 代理操作桌面應用程式並逐步核對結果。

Repository image for vercel-labs/agent-desktop

要讓 AI 代理操作桌面應用程式,agent-desktop 讀取 OS accessibility tree,以 ref 指向按鈕、輸入框等元素,再用 JSON snapshot 核對結果。這個跨 macOS、Windows、Linux 的 CLI 與 C library 不靠 pixel matching,將控制循環留在 agent。

可透過 npm 安裝並先確認 version;macOS 要 Accessibility permission,Linux 要 graphical session 及 at-spi2-core,Windows 受終端機 integrity level 限制。macOS command host 保留 native accessibility objects,減低舊 identifier 誤連到已移除元素的風險。

  • 適合:需要 AI 控制桌面軟件、並自行編排 agent 的團隊。
  • 限制:沒有 benchmark 或成功率;JEV helper 與 native CLI 分開,headless calls 亦禁止 foreground activation 和 synthesized input。
  • 私隱:snapshot、screenshots、剪貼簿及 debug artifacts 可能含私人內容,不應放入公開 logs。

項目更像桌面操作底層而非完整代理,是否適合取決於目標程式的 accessibility 支援、權限和資料處理方式。

GitHub

Categories: 開源, Agentic, 軟件, Mac, Linux, 庫, Dataset 數據集

AskStream:讓模型主動追問影片的缺失資訊

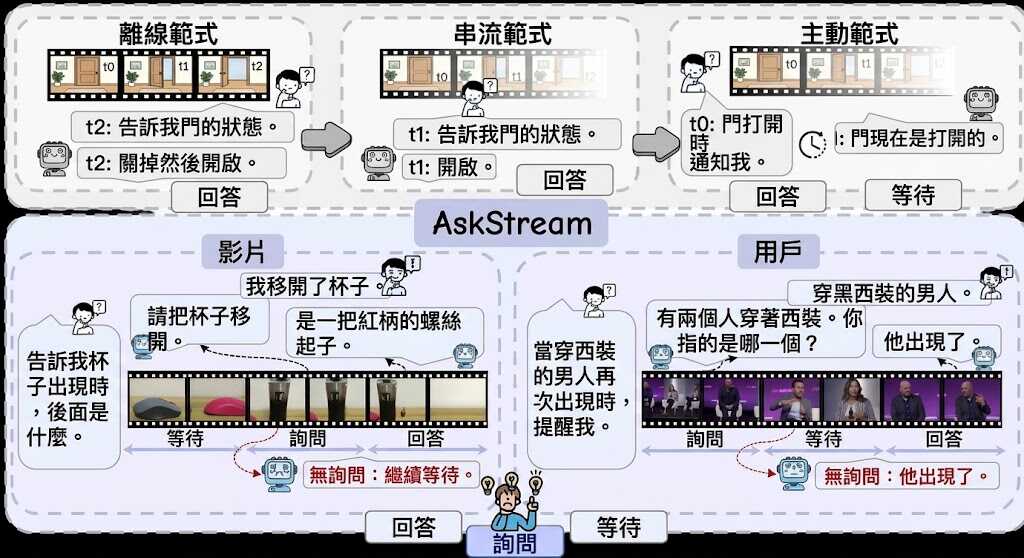
串流影片未必會自然提供完整答案,AskStream 讓模型在等待與回答之外,判斷何時應該主動提問。

AskStream Logo

串流影片問答遇到畫面缺失、問題含糊或個人資料不足時,模型往往只能繼續等待,甚至猜出答案。AskStream 是一個串流影片理解 benchmark 與資料集,把 WAIT、ASK、ANSWER 放進多輪互動流程,實際測試模型能否找出不確定性、問對問題,再在資訊足夠時回答。

它涵蓋 Food & Dining、Sports、Clothing、Daily Life、Film & TV、Repair、Education、Travel 和 Technology 九類影片,共 438 段影片、1,401 條問題,以及 2,714 個人工標註的 frame-level time windows。每段影片平均有 3.2 個互動回合,資料再按 Video Uncertainty 和 User Uncertainty 拆成四類任務、八個 subtasks,適合檢查模型是只懂回答,還是懂得主動索取缺少的證據。

  • 同時評估 When to Ask、What to Ask、When to Answer 和 What to Answer
  • 支援 multiple-choice 及 open-ended 評測
  • Ask-F1 同時反映提問時機、提問內容和回答決策
  • 最強模型目前只有 52.18% Ask-F1,主動尋找資訊仍然困難

使用者可從 GitHub、Hugging Face dataset、論文及 project page 了解資料和評測入口;提供的資料沒有列出完整安裝流程、推理程式或硬件要求,因此不能據此承諾特定 GPU、記憶體配置或本地執行方式。研究團隊、影片理解模型開發者和多模態 agent 評測項目較適合採用它,尤其是需要處理直播、教學、維修或含個人背景問題的場景。它的價值不在單次答案準確度,而在揭示模型何時應該停止等待、向誰問甚麼,以及取得資訊後能否及時作答。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 教學, 中國, Dataset 數據集

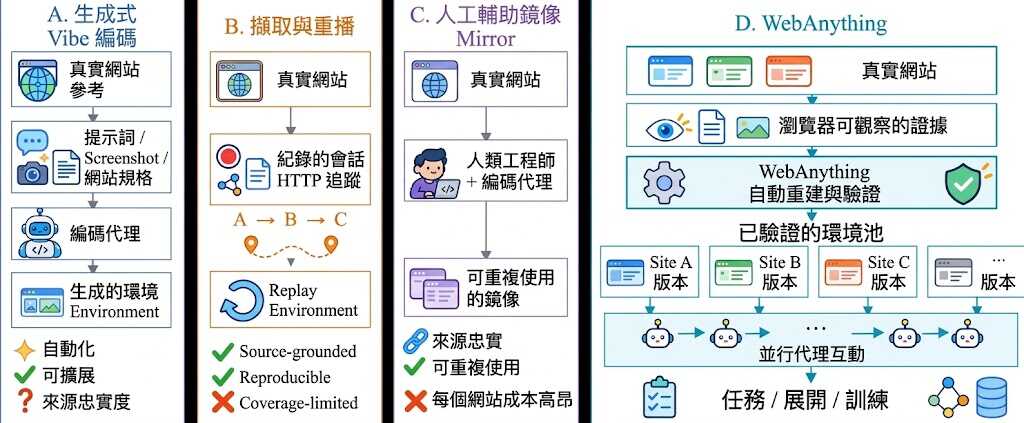
WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

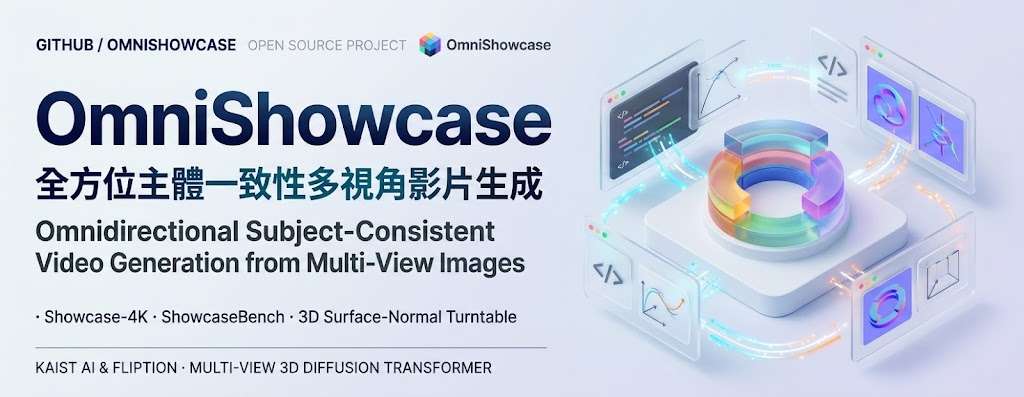
OmniShowcase:維持物件形態生成 360°影片運鏡

幾張多角度參考圖,就能引導 Wan2.1 生成沿不同鏡頭路徑移動的物件影片,並盡量保持外觀與立體結構一致。現階段程式碼與資料集尚未公開,硬件需求亦未交代。

Repository image for justin4ai/OmniShowcase

想把一件商品或角色放進不同場景,再沿環繞鏡頭拍成影片,難處是視角轉到參考圖以外時,物件外形容易走樣。OmniShowcase 是一個影片生成模型項目,利用少量多視角圖片生成同一物件的影片,鏡頭路徑涵蓋完整 360° 環繞,目標是維持物件身份與 3D 結構。

它以 Wan2.1 image-to-video 模型為基礎,透過輕量 LoRA 調整生成模型。流程會由四張參考圖重建物件,再渲染成一組表面法線圖作為條件;生成影片時,鏡頭不必逐格對齊這組法線圖,提示詞可指定其他運鏡路徑。這令模型能沿指定路徑生成影片,而不只是重播固定的旋轉角度。

  • Showcase-4K 是合成訓練資料集,涵蓋 12 種鏡頭運動及 88 種路徑配置。
  • ShowcaseBench 是評測資料集,提供影片對應的來源網格與鏡頭參數,方便檢查生成結果。
  • 項目展示環繞、螺旋下降、弧線移動、推近及拉遠等運鏡;目前提供的資訊未列出量化評測分數。
  • 訓練資料、評測集、推理程式碼及訓練程式碼均尚待公開,暫時未能按文件安裝或執行。

這種方法適合商品展示、角色視覺化及需要多角度鏡頭素材的內容製作,也可供研究多視角條件影片生成的團隊參考。代價是生成品質依賴參考圖的 3D 重建與表面法線條件。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 提示詞, 3D, Dataset 數據集, LoRA

Continual Learning Exam:測試 AI 能否把工作經驗帶到下一項任務

AI 助理完成一項工作後,能否記住檔案、工具、規則和偏好,並在後續任務派上用場?Continual Learning Exam 以跨五個階段的專業工作流程測試這種能力。

Continual Learning Exam — CLE

完成眼前任務不代表 AI 助理學會了經驗:它還要在後續工作中找回先前接觸過的檔案、工具、規則或使用者偏好。Continual Learning Exam(CLE)是一套持續學習評測基準,透過相連的專業任務,檢驗代理能否累積並重用這些資訊。

每項任務分成五個相連階段,後續階段可能需要運用先前累積的知識。完整基準涵蓋 12 個領域、89 種專業角色及 120 項由 50 多位領域專家撰寫的任務,共有 600 個階段;CLE Lite 則提供 20 項任務及 100 個階段,並公開任務卡、輸入檔案和執行環境,方便研究團隊先行測試。

CLE 提供兩種評測方式:Direct 讓代理直接執行全部五個階段;CLE Trial 1 和 Trial 2 則要求代理通過當前階段,才繼續前進,Trial 2 另加入診斷回饋及一次修訂。這個安排能比較代理在不同流程下的完成情況,也能觀察回饋是否改善結果,但不應把單次任務得分直接視為代理已具備穩定、通用的長期學習能力。

公開結果中,最佳配置完成了 47.7% 的階段;加入診斷回饋和一次修訂後,完成分數的中位增幅為 5.3 個百分點。這些數字反映任務完成度仍有明顯提升空間,也提醒使用者把評測結果視為比較代理配置的依據,而非對日常工作成效的保證。

CLE 適合研究代理記憶、工具使用與跨任務學習的團隊,也適合評估專業工作流程的開發者。可以先用 CLE Lite 的任務套件和 Harbor 執行環境測試代理,再按需要比較 Direct、Trial 1 與 Trial 2;完整基準、排行榜及研究論文則可用來進一步查看任務分布和評測結果。

  • 以五個相連階段檢驗經驗能否在後續工作中重用。
  • 完整基準涵蓋 120 項任務、12 個領域及 89 種專業角色。
  • CLE Lite 提供 20 項任務與 100 個階段,可先行測試。
  • Trial 2 加入診斷回饋和一次修訂,最佳配置完成 47.7% 的階段。

項目主頁 · GitHub

Categories: 開源, 工具, Dataset 數據集

Continual Learning Exam:測試 AI 能否把工作經驗帶到下一項任務

AI 助理完成一項工作後,能否記住檔案、工具、規則和偏好,並在後續任務派上用場?Continual Learning Exam 以跨五個階段的專業工作流程測試這種能力。

Continual Learning Exam — CLE

完成眼前任務不代表 AI 助理學會了經驗:它還要在後續工作中找回先前接觸過的檔案、工具、規則或使用者偏好。Continual Learning Exam(CLE)是一套持續學習評測基準,透過相連的專業任務,檢驗代理能否累積並重用這些資訊。

每項任務分成五個相連階段,後續階段可能需要運用先前累積的知識。完整基準涵蓋 12 個領域、89 種專業角色及 120 項由 50 多位領域專家撰寫的任務,共有 600 個階段;CLE Lite 則提供 20 項任務及 100 個階段,並公開任務卡、輸入檔案和執行環境,方便研究團隊先行測試。

CLE 提供兩種評測方式:Direct 讓代理直接執行全部五個階段;CLE Trial 1 和 Trial 2 則要求代理通過當前階段,才繼續前進,Trial 2 另加入診斷回饋及一次修訂。這個安排能比較代理在不同流程下的完成情況,也能觀察回饋是否改善結果,但不應把單次任務得分直接視為代理已具備穩定、通用的長期學習能力。

公開結果中,最佳配置完成了 47.7% 的階段;加入診斷回饋和一次修訂後,完成分數的中位增幅為 5.3 個百分點。這些數字反映任務完成度仍有明顯提升空間,也提醒使用者把評測結果視為比較代理配置的依據,而非對日常工作成效的保證。

CLE 適合研究代理記憶、工具使用與跨任務學習的團隊,也適合評估專業工作流程的開發者。可以先用 CLE Lite 的任務套件和 Harbor 執行環境測試代理,再按需要比較 Direct、Trial 1 與 Trial 2;完整基準、排行榜及研究論文則可用來進一步查看任務分布和評測結果。

  • 以五個相連階段檢驗經驗能否在後續工作中重用。
  • 完整基準涵蓋 120 項任務、12 個領域及 89 種專業角色。
  • CLE Lite 提供 20 項任務與 100 個階段,可先行測試。
  • Trial 2 加入診斷回饋和一次修訂,最佳配置完成 47.7% 的階段。

項目主頁 · GitHub

Categories: 開源, 工具, Dataset 數據集

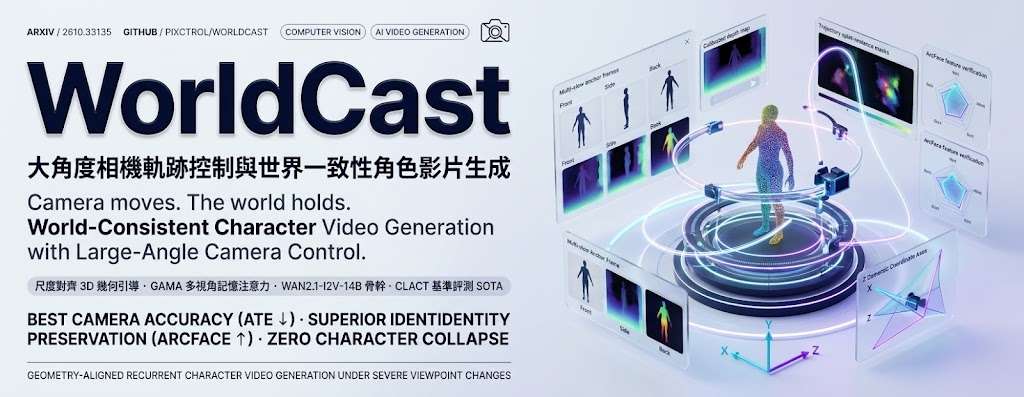
WorldCast 讓角色跟隨大角度鏡頭仍保持一致

只需一張參考圖、鏡頭軌跡及最多四張不同角度的錨點圖,WorldCast 便可生成保持角色身份的影片。

logo

只提供一張參考圖、目標鏡頭軌跡,以及 1 至 4 張不同視角的角色錨點圖,WorldCast 便能生成跟隨多角度運鏡的角色影片,同時減少轉換視角時身份走樣。這個開源模型項目針對的是影片生成中「鏡頭要郁得大」與「角色外觀要保持」難以兼顧的問題。

它以 Wan2.1-I2V-14B-720P 作為基礎模型,再加入 scale-aligned geometric guidance 和 Geometry-Aligned Memory Attention(GAMA)。前者把初始畫面轉成具校準深度的彩色 3D 點雲,沿目標軌跡渲染出 RGB 引導與 coverage mask;後者透過 Umeyama alignment 對齊多視角角色記憶,將相關特徵注入影片 token,補足新視角內容。

  • 支援 360° 鏡頭移動
  • 使用多視角 anchor images 維持角色身份
  • CLACT 包含 80,000 個訓練樣本及 42 個評測場景
  • 以 ATE、MEt3R 和影像品質比較結果

GitHub 已提供 inference code 和示範案例,但 WorldCast checkpoint、CLACT dataset 及 training code 尚未公開,因此下載 Wan2.1 基礎權重後仍未能完整執行示範。推理建議使用 Python 3.10 或以上、bf16,以及至少 48 GB 顯存;解析度和影片幀數提高後,記憶體需求亦會增加。

結果以較低的 ATE 和 MEt3R 對應更準確的鏡頭控制及跨視角一致性,影像質素則維持具競爭力。電影預視、角色廣告、遊戲過場及需要指定運鏡的生成影片工作流較適合採用。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, Content Creator, 3D, Python, Dataset 數據集

Page 3 of 39
1 2 3 4 5 … 39