EvoWorld:讓鏡頭外世界持續演化並保留因果變化

EvoWorld 將 VLM 推理與視覺渲染結合,處理影片中離開視野的物件如何繼續變化,並在鏡頭返回時保留合理反應。

EvoWorld logo

鏡頭轉開後,世界唔應該停唔轉。EvoWorld 是一套生成式影片系統,專門處理「Out-of-Sight World Evolution」(鏡頭外世界演化):物件離開畫面後仍會參與事件,等鏡頭再次回到同一人物或場景,變化亦要延續落去。

LTX-2.5 負責輸出影片:EvoWorld 作為 visual renderer,將條件轉成 896 × 512、24 fps 影片。

EvoWorld 負責「鏡頭外發生咗乜」:透過視覺語言模型做推理,再配合影片生成器,令鏡頭移開後嘅事件仍然可以發展;鏡頭返轉頭時,呈現合理嘅事件結果,而唔係只還原之前見到嘅畫面。

  • 支援事件觸發的世界演化,可由用戶指定中途發生的事件。
  • 重現原本的人物與場景,維持身份及整體連續性。
  • 渲染鏡頭外動態與因果反應,而不只是重播舊有畫面。
  • EvoWorld-Data 提供約 12,000 段影片,涵蓋 65 種事件、63 種場景及 14 種反應類型。
  • EvoWorld-Bench 設有 120 個測試案例,評估事件、重訪與反應的完整流程。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, Gemini, Video, 提示詞, 框架, Linux, Python, LTX, Dataset 數據集

Arete-27B:後訓練調整政治敏感議題

模型怎樣回答政治問題,也可以透過訓練改變。Nous Research 嘗試強化西方價值觀,但未證明偏差已消除。

Og image

Nous Research (Hermes Agent 開發團隊) 針對模型回答政治敏感問題時的拒答、迴避與敘事立場,推出 Arete-27B。這個模型以阿里巴巴的 Qwen3.8-27B 為基礎,透過後訓練強化團隊所稱的「西方價值觀」。

團隊表示,曾觀察到原模型以中國共產黨(Chinese Communist Party,CCP)的框架作答。其做法是調整模型權重中的行為,而非只在對話中加入提示詞;這代表改變價值取向,不等於令模型變得中立。

  • 以 803 條提示詞、七個價值類別量度變化。
  • 列出模型權重 Arete-27B。
  • 列出評測 Propaganda_Eval 與訓練數據 arete-data-pairs。

「中國開源模型的意識形態偏見層,其實非常薄,而且是在最後階段才被強行貼上去的(The bias layer is shallow. It is applied late, it is applied thin)。」

只要 5,000 萬 tokens 的精準數據,就能把原廠花大代價做的政治對齊剝離得一乾二淨。

這對整個開源世界來說是個極具象徵意義的信號:只要權重是開源的(Open-weight),價值觀的主導權就永遠在使用者手裡。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 提示詞, 框架, 中國, Dataset 數據集

NPCBench:檢測模型能否串連鼻咽癌診療全程

模型答對單題,不代表能為同一位病人作出前後一致的診療判斷。NPCBench 把鼻咽癌知識、影像、治療決策與病程追蹤放進同一套評測。

NPCBench overview

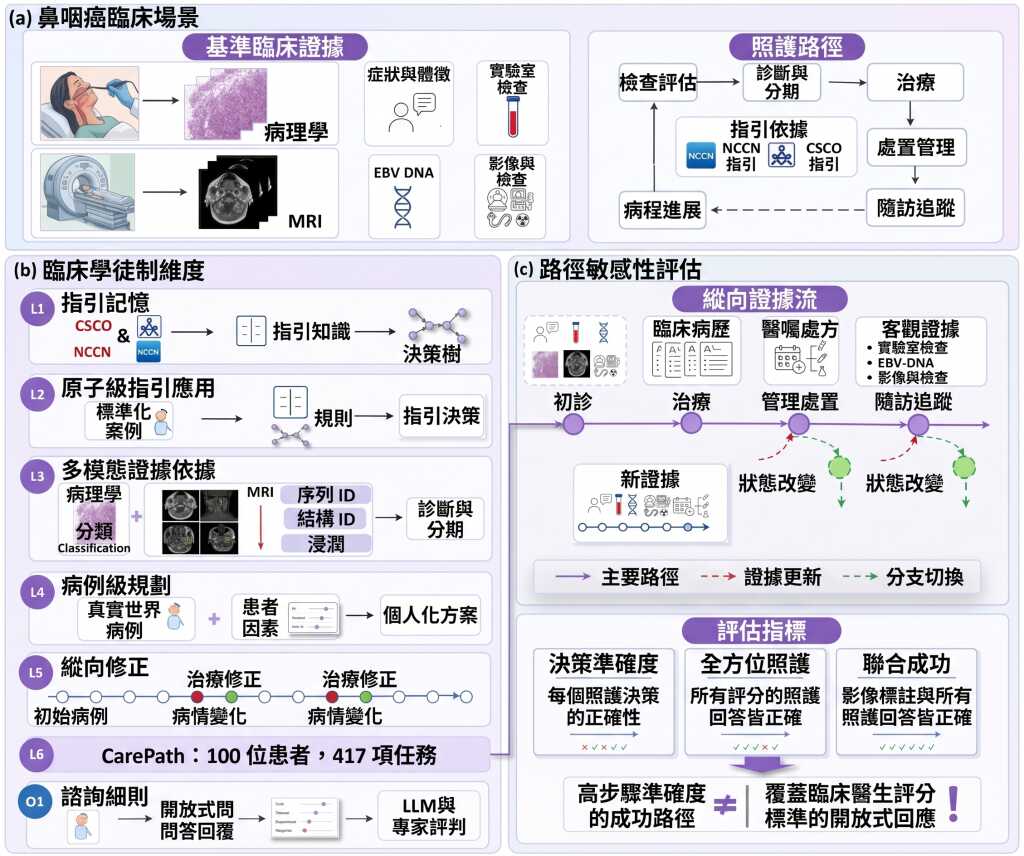
答對鼻咽癌知識題,未必代表模型能制定合適方案,或隨病情變化修正判斷。NPCBench 是一套醫療 AI 評測基準,涵蓋指引知識、影像判讀、臨床決策及專科諮詢,嘗試檢驗模型能否把這些能力連接到病人的診療流程中。

不少醫療基準把能力拆成知識問答、單張影像判讀或靜態病例題,逐題計分;這種方式較難看出模型能否整合多模態證據,或在病程改變時更新決策。NPCBench 改以近似專科培訓測試,並加入縱向病例與 CarePath 評估,要求同一病人的病理、MRI T 分期及各項照護決策全部正確,才算聯合成功。

資料集包含 4,777 項分階段及諮詢題目,另有 100 名病人的 CarePath 病例,共 417 項診斷與照護評分任務。項目亦提供 MRI 延伸評測指南、醫師一致性校準,以及可用已發布預測結果重現主要結果表的 CPU 指令;研究比較了 30 個模型,並以配對控制檢視證據依據、病程中的判斷修正及諮詢評分。

結果反映單項能力與完整診療流程之間存在落差:在 21 個多模態模型中,嚴格 CarePath 聯合成功率最高為 23%。這令 NPCBench 適合研究醫療模型評測、腫瘤照護工作流程及多模態臨床推理的團隊;但它聚焦鼻咽癌,分數不能直接推廣至其他疾病或真實臨床成效。

  • 評測範圍由指引知識延伸至影像、決策、病程追蹤及專科諮詢。
  • CarePath 以病人為單位,要求多項診斷與照護答案同時正確。
  • 研究比較 30 個模型,並納入配對控制與醫師一致性校準。
  • 嚴格 CarePath 評估中,多模態模型最高成功率為 23%。

使用者可按任務下載相應題目,為每題提交模型答案,再以提供的評分工具輸出分數;Python 3.10 或更新版本即可執行。多選題需要提交完整選項集合,L1、L2、L4 等任務有各自的題目檔與評分命令,MRI 延伸測試則另有資料處理及推理設定指南。

GitHub · Paper

Categories: 開源, 香港理工大學, 多模態模型, Image, 香港, 工具, Medical醫學, 中國, Dataset 數據集

VidDub:用兩步去噪讓影片嘴形跟隨新配音

換了配音,嘴形也要跟着改。VidDub 嘗試保留人物與場景,同時縮短影片生成所需步驟。

VidDub

替訪談或角色影片換上新配音,VidDub 這套音訊驅動影片配音系統會調整嘴形,目標是保留原有人物、頭部姿態與背景,適合需要沿用原片表演的創作流程。

原音重建訓練會要求模型重現錄下的嘴形,換成另一段說話後便可能形成衝突。VidDub 以 replacement-aware cross-audio supervision,在替換語音樣本中遮蔽原嘴部的重建監督,改由聲畫同步訊號引導發音動作。

完整上下文教師模型再經蒸餾訓練出兩步去噪學生模型,壓縮生成步驟。項目報告單張 H20 達 11.3 FPS,但限於輸入已完成預處理的測量,不能視為端到端即時速度。

  • 長片透過重疊窗口推理。
  • 提供模型權重與訓練程式碼。
  • 可透過社群示範或 OpenDub 應用體驗。

三個訓練種子的實驗中,移除衝突嘴部監督令替換音訊 Sync-C 同步評分提升 0.833±0.04。配音團隊仍宜用自己的素材檢查嘴形、人物一致性及長片接縫;同步分數不足以代表整段成片品質。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 語音, Dataset 數據集

VeriSpoof 偵測深偽語音並追查來源

VeriSpoof 不只判斷錄音是真是假,也能比對生成來源、定位合成片段,並用可核對的短句解釋判斷依據。

VeriSpoof: beyond real or fake

面對疑似深偽語音,單一真假分數往往不足以支援鑑證;調查者還要追查生成系統、比較兩段錄音是否同源,並確認結論依據。VeriSpoof 是一個語音鑑證音訊語言模型項目,以同一組權重處理這些問題,並將判斷寫成可對照音訊與資料標籤的短句。

它不另設偵測或來源驗證專用輸出頭,而是比較模型對不同答案句子的可能性,將差值用作分數。解釋可涵蓋頻寬、訊噪比、音量、聲道影響、合成片段位置與來源特徵;這令使用者能檢查模型提出的線索,而非只收到「真」或「假」的結論。

VeriSpoof-Plus 在 Speech-DF-Arena 的 14 個測試集取得 2.14% pooled EER,在 28 個系統中排第三,並在開放權重系統中排名第一。同一組權重亦能比較訓練時未見過的生成器來源,EER 為 6.2%;在 PartialEdit 測試中,經推理的理由能找出 99.6% 的局部偽造片段,一步作答則為 78.4%。

項目同時提供 VeriSpoof-Base 和 VeriSpoof-Plus 模型、推理套件、線上示範及 VeriSpoof-Bench 資料集;可先用示範查看錄音分析結果,再以推理套件離線處理測試音訊。訓練只更新 2.85B 參數中的 29.7M,項目稱可在一張 24 GB GPU 上完成訓練,但這不代表推理資源需求相同。

  • 一套權重支援真假判斷、來源比對與語音鑑證解釋。
  • 局部偽造定位有助檢查整段錄音中只被修改的部分。
  • 開放權重版本在指定基準取得具競爭力的結果,不能直接推論為適用所有語言、錄音條件或生成器。
  • 鑑證團隊與研究人員可用示範、離線推理套件及基準資料集檢查輸出;關鍵判斷仍應回到音訊與來源證據核實。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, Qwen, Audio, 語音, Dataset 數據集

WebHarbor:把真實網站變成可重現的 GUI Agent 測試場

WebHarbor 將 153 個網站還原成可重複使用的本地環境,讓 GUI web agents 能測試登入、購物及資料操作。

Repository image for aiming-lab/WebHarbor

要測試 GUI web agents 是否真的懂得操作網站,單靠會變動的公開網頁往往難以重現結果。WebHarbor 把 153 個流行網站製成 Docker 化本地鏡像,連同完整登入流程、資料庫和多模態圖片內容,屬於面向訓練與評估的環境及資料集項目。

它處理的不只是點擊連結,3,518 個 tasks 涵蓋購物車、結帳、帳戶操作等較深層流程;資料庫可在不到一秒內重設,適合反覆進行強化學習 rollout。沒有網絡噪音、內容漂移或地區封鎖,測試結果較容易比較,但建立鏡像和維護網站功能亦帶來不小工程成本。

• 153 個可執行的 Docker 網站環境
• 3,518 個評估及訓練 tasks
• 支援登入、資料庫和圖片內容
• 環境可按 agents 能力增加難度
• WebHarbor-4B 在 WebVoyager 及 Online-Mind2Web 平均取得 75.8 分

WebHarbor-4B 是建基於這些合成環境和 tasks 訓練的 GUI web agent,並非與環境分開提供的獨立示範模型。項目聲稱它在 4B 規模開源 GUI web agent 中取得最佳成績,但這個比較仍取決於所選基準和評測設定,不能直接代表所有真實網站任務。

研究 GUI agents、建立強化學習流程,或需要可重現瀏覽器測試的團隊較容易受益。使用者可從 Docker 鏡像、Hugging Face 環境及 tasks 開始組建測試流程;項目文件未列出完整硬件需求及每個網站鏡像的維護策略,正式採用前仍要核對資源成本和環境覆蓋範圍。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 模型訓練, Image, 庫, Dataset 數據集, 強化學習

Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

CoworkOS:2D/3D 網頁任務統一工作流

複雜項目往往要跨多日推進,也需要人手覆核和中途調整。CoworkOS 讓 AI 代理接手分工與持續監察,並保留進度、記錄及待審核成果。
CoworkOS: geometric wordmark, fixed OS frame and illustrated desktop workspace

從研究、文件到 CAD 和 Blender,CoworkOS 讓人與 AI 代理在同一工作空間協作,處理需要多步推進、跨日跟進的工作。它屬於開源 AI 協作執行框架,目標是把任務由規劃、分工一路帶到可檢查的成果;長時間運行的 Jobs 會保留狀態和日誌,遇到等待或中斷後仍可接續處理。

代理工作分成三層:Main Agent 制定計劃、分派任務及檢查成果;Coordinator Runtime 負責派送子任務並追蹤進度;可選用的 Subagents 則執行範圍明確的工作。模型負責決定任務策略,執行環境則維持協調、回饋和工作連續性,避免把多代理協作的管理全交由模型自行處理。

CoworkOS 把 CLI、搜尋、檔案和 MCP 接到文件編輯器、簡報、CAD 與 Blender 等工具,人和代理可以共同修改文件、模型及場景。階層式工作空間和語意記憶用來延續項目脈絡;候選修改會保留版本資訊,讓人先檢查再整合。這種做法適合需要覆核、追蹤及中途改方向的團隊,但可用工具和模型服務的實際配合仍會影響工作流程。

研究團隊也可用同一套機制建立長期監察迴圈,例如分析模型失誤、改善訓練資料、執行訓練及驗證結果。配套研究報告記錄了 Qwen3.6-35B-A3B 經五輪後訓練後,在八個基準的平均分由 33.19 升至 42.95;這是特定實驗結果,各任務仍有升跌,不能直接視為其他模型或工作流程的保證。

  • Jobs 保留長時間任務的狀態與日誌,方便中斷後繼續監察。
  • Main Agent、Coordinator Runtime 和 Subagents 分別負責規劃、協調與執行。
  • 人與代理可共同處理文件、簡報、CAD 模型及 Blender 場景。
  • 候選修改可先經人手檢查,再整合到項目成果。

CoworkOS 面向使用 macOS 的研究人員及需要多工具協作的團隊,支援 Apple Silicon,並要求 macOS 14 或以上及 Node.js 22.19.0 或以上。儲存庫資料提及可透過 npm 安裝,亦提供文件、展示及即時示範連結,開始部署前,仍需查閱項目文件確認模型服務與工作空間的配置方式。

項目主頁 · GitHub
Categories: 開源, 北京大學, Agentic, MCP, 模型, 模型訓練, Qwen, 框架, 工具, Mac, 庫, 中國, 蘋果, Dataset 數據集

387 篇獨特論文與資源,關於影片生成遇上 Harness

想了解 AI 影片生成如何由單次生成走向規劃、互動和持續改進,這份研究索引整理了 387 篇論文與相關資源,並提供三條互補的閱讀路徑。

Video Rebirth

由創作影片、探索生成世界,到改進生成系統,研究者關心的問題各不相同。Awesome Agentic Video Generation 是一份論文與資源索引,整理 Agent harness 如何連接目標、工具、記憶、回饋與執行流程,協助讀者追蹤 Agentic Video Generation、Agentic World Modeling 和 Recursive Self-Improvement(RSI)相關研究。

三條閱讀路徑分別聚焦影片創作流程、生成世界中的行動與狀態,以及資料整理、模型訓練、評估和改進程序。它們代表不同研究情境,而非能力排名;同一項資源亦可能出現在多條路徑中,387 是去重後的總數。

索引收錄的題目涵蓋從創作簡報規劃影片、生成鏡頭和後期剪輯,到讓代理在生成世界中行動並維持狀態。例如 CutVerse 聚焦媒體後期剪輯的 GUI agents benchmark;CineAGI 探討以 LLM 編排多模態生成及跨場景整合。這些題目讓讀者可以按工作流程或研究問題尋找相關方向,但索引本身不代表每個項目都已證明具備 RSI。

  • 創作:查找規劃、素材、鏡頭生成、剪輯與來源追蹤相關研究。
  • 互動:追蹤動作條件影片、語意控制、狀態記憶及互動世界評估。
  • 改進:了解資料、訓練、評估和 harness 改進如何支援未來的 RSI 研究。
  • 延伸閱讀:資源連結通往論文或項目;整理者亦提供貢獻入口,方便提交新資源。

對研究者、影片生成系統開發團隊,以及需要快速掌握相關文獻的讀者,這份索引可作為分類閱讀的起點。它的價值在於整理與導覽,而非提供可直接執行的影片生成工具。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, World-Action Model, 工具, Dataset 數據集

ReGap-Bench:視覺與推理分開評測

模型看見物件,不代表能逐步追蹤它們。ReGap-Bench 用可配對的視覺參照,測出多模態推理究竟卡在哪裏。

Teaser

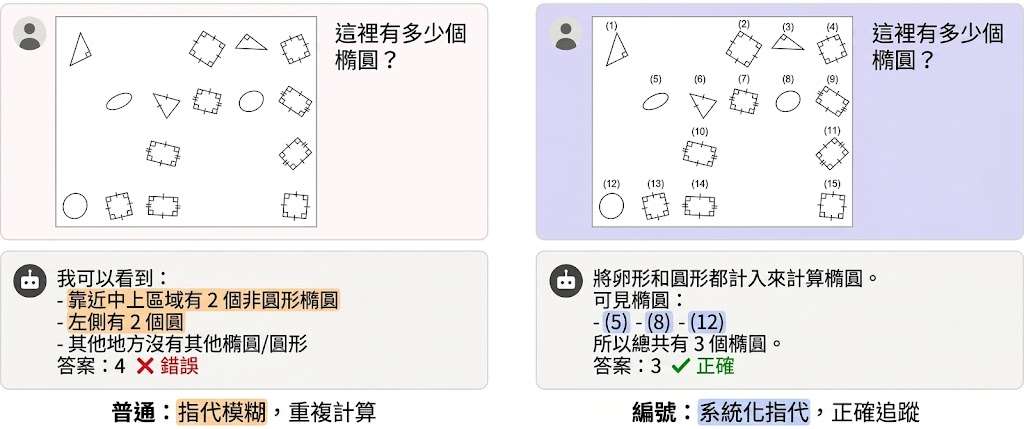
模型明明看見圖中所有物件,數數時卻會重複計算;ReGap-Bench 是一個針對 multimodal large language models(MLLMs)的資料集與評測項目,專門檢查語言推理能否正確對應視覺中的物件、區域和位置,並將問題命名為 reference gap。

它把同一場景、問題和答案固定,只更換額外參照,形成 paired reference-intervention benchmark。編號讓物件可以被索引,陰影標示有界區域,網格線則協助定位、追蹤邊界和比較位移;參照是否配合任務,會直接影響推理結果。

  • 涵蓋 shape counting、angle ranking、size ranking、clock ranking 和 transformation prediction 五項任務
  • 共 200 個場景及 3,400 張圖片,設有 plain、numbering、shading 和 grid 條件
  • task-matched references 可令所有受測模型在所有任務提升,最高達 25%
  • mismatched references 幫助有限,甚至會令表現下降

測試可用 OpenAI、Google Gemini API,亦可透過 vLLM 執行 Qwen3.5;後者需要 GPU,API 模型則只需設定相應金鑰。Python 3.10 環境和 requirements 已列明,輸出會保存到 outputs,方便比較同一模型在不同參照條件下的差異。

ReGap-Bench 的價值不在於再加一個總分,而是把視覺感知和語言推理之間的接合問題單獨拉出來。結果支持一個務實判斷:改善模型未必只靠更強的視覺編碼器,為任務建立合適的外部視覺參照,也可能成為不需重新訓練的 visual skill;不過參照錯配會反過來干擾模型,因此它更適合研究團隊、MLLM 評測人員和需要分析多步視覺推理失誤的開發者。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, 模型, 多模態模型, 模型訓練, Qwen, Google, OpenAI, Gemini, API, Image, Python, Dataset 數據集, Skill 技能

Page 2 of 39
1 2 3 4 … 39