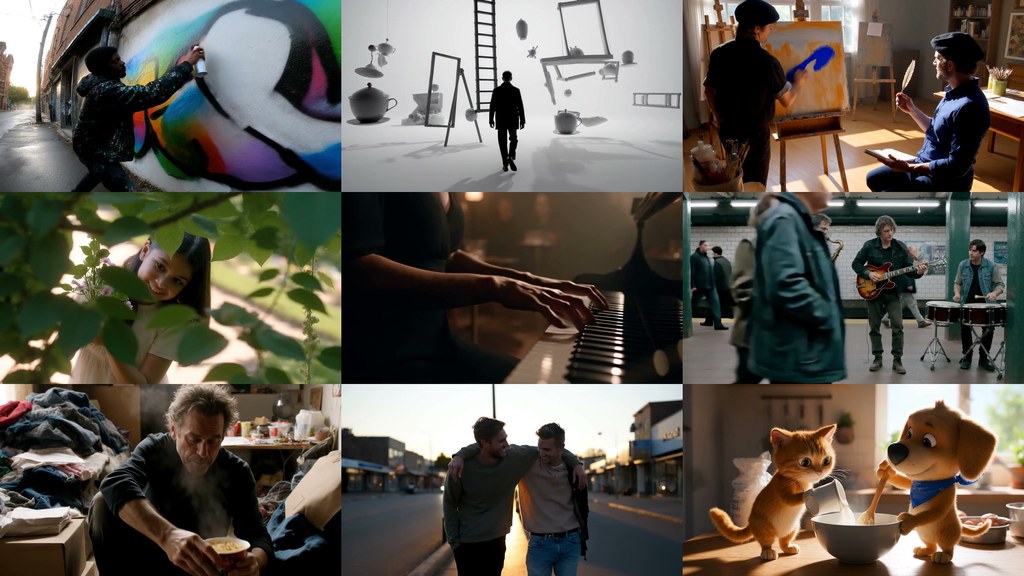
[教學影片]MiniMax H3 六格分鏡生成多鏡頭 AI 影片

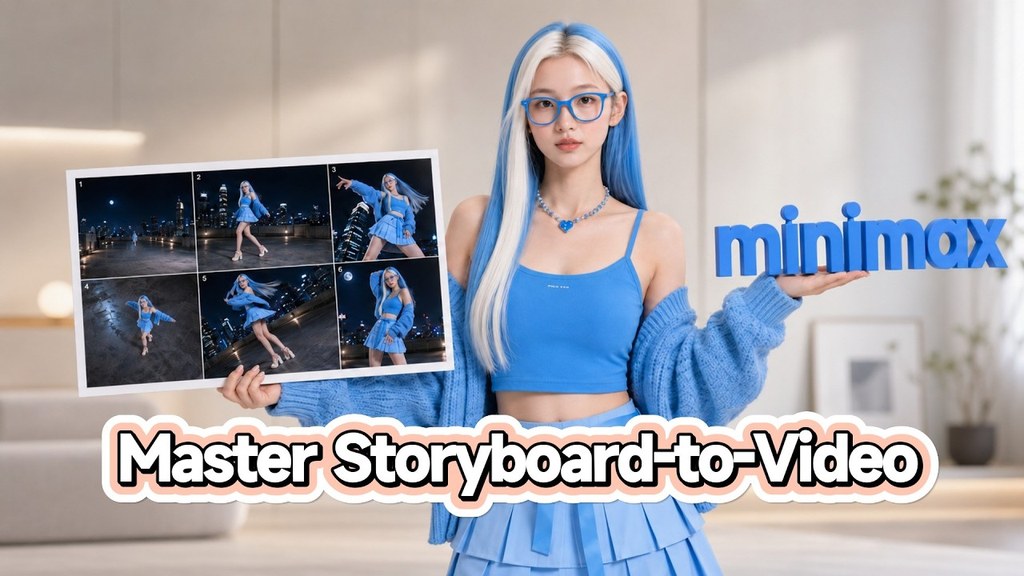
MiniMax H3 加入六格分鏡網格參考功能,用戶可直接餵故事板圖,再生成多鏡頭連貫短片,解決單鏡頭 AI 影片動作細節不足的問題。

Og image

AI 影片生成最常見的痛點之一,是鏡頭內動作幅度細,剪接起來又欠缺段落感。MiniMax H3 這次加入的 6-Grid Reference(六格分鏡網格)功能,嘗試從輸入端就解決這個問題:使用者把一張包含六格分鏡的故事板圖丟入模型,H3 會按格子內容分別生成對應鏡頭,再組成一條多鏡頭短片,避免單次生成只能「前後郁幾吋」的局限。

對熟悉影視分鏡流程的人來說,這等於把前期 storyboard 直接搬進生成管線。對一般創作者而言,操作門檻也比逐個鏡頭獨立 prompt 再拼接低很多——畫好六格、寫好提示詞,剩下的運鏡與節奏交給模型處理。

以下是這次教學與功能值得留意的幾個重點:

  • 六格分鏡直接餵入:以一張 2×3 或 3×2 的網格圖作為視覺參考,模型按格生成對應鏡頭,無需逐個 cut 分開生成。
  • 多鏡頭連貫輸出:最終成品會包含多個 shot,而非單一長鏡頭,方便直接接上剪接流程。
  • 適合分鏡先行的工作流:對動畫短片、廣告腳本、遊戲過場等已有 storyboard 習慣的團隊特別受用。
  • 降低逐鏡 prompt 成本:一次輸入即可覆蓋多個鏡頭,減少重複描述角色、場景、風格的工序。
  • 與 H3 既有能力整合:可與 H3 的角色一致性與風格控制一併使用,保持多鏡頭之間的人物與美術統一。

教學影片示範的工作流程大致是:先準備好六格分鏡圖,每格代表一個鏡頭的構圖與動作重點,提示詞內描述場景氛圍與鏡頭運動方向,再由 H3 一次過輸出。對於想快速測試分鏡概念、或者要把動畫前期視覺化的人,這條工作流比起從零開始寫分鏡 prompt 更直觀。

需要留意的是,六格分鏡的格數、比例與每格內容差異會直接影響成品質素,每格的構圖與動作如果太擠迫或太模糊,模型理解鏡頭意圖時容易出錯。建議先用簡潔構圖測試,再逐步加入複雜元素。

影片主頁ComfyUI 工作流特別版 H3 模型

Categories: 開源, ComfyUI, AI productions, 多模態模型, Video, MiniMax

JoyAI-Echo: 拓展長音訊視訊生成技術

它把文字轉影片做成可跨鏡頭延續的音畫生成流程,重點不只是一段片,而是人物、聲音同場景連貫下去。ComfyUI 節點版本可配合官方推理管線,方便逐鏡調整。

JoyAI-Echo generated video gallery

JoyAI-Echo 是一個面向 text-to-video(T2V)同多鏡頭長片段生成的模型項目,處理的是短提示詞難以撐住長篇敘事、角色外觀與聲音容易斷裂的問題。它的做法不是單段出片,而係用跨鏡頭 memory 去維持故事連貫,連動音畫一致性。

官方說明強調它走 full bf16 precision,唔採用 GGUF quantization,目標係貼近正式推理管線的輸出。現階段支援 T2V,同多鏡頭長視頻;image-to-video(I2V)未支援。另有 ComfyUI_JoyAI_Echo 節點包,適合想喺工作流入面逐鏡改 prompt、即時預覽、再串接後續鏡頭嘅人。

  • 可做長篇音畫故事,展示例子去到 10 分鐘
  • 支援少步數生成,長片與 causal world model 都偏向快速推理
  • cross-shot memory 會保留角色外觀、聲線同連貫性
  • ComfyUI 版本方便分鏡調整,同官方管線保持一致
  • 目前重點在 T2V,多鏡頭長片段,未覆蓋 I2V

它和一般單段影片模型最大分別,在於將「一段生成得像」推進到「多段接得住」。如果要放進實驗室、內容團隊,或者做互動世界、長敘事原型,這種可續接的記憶機制會比只看單次輸出更實用;但代價是對 GPU 記憶體要求高,官方節點提到 48GB VRAM 同 GPU memory hot-swap 才較穩陣。

項目主頁 · GitHub

Categories: 開源, ComfyUI, 多模態模型, 視頻模型, 世界模型, Video, Image, Audio

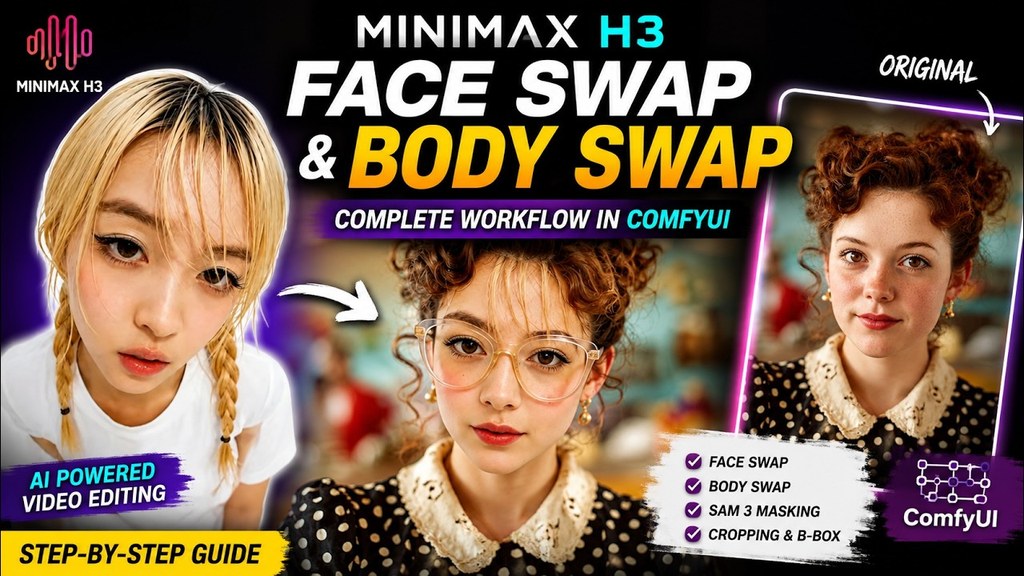
MiniMax H3 在 ComfyUI 實現換臉換身工作流

MiniMax H3 配合 ComfyUI 自訂節點,示範如何建立換臉與換身流程,方便整理影像生成工作流。

Og image

由換臉延伸到換身,影片示範 MiniMax H3 在 ComfyUI 中處理人物影像替換的完整流程,重點放在如何把不同步驟串連起來,減少使用者自行摸索節點配置的時間。

流程以 ComfyUI 為操作環境,並配合 custom nodes 建立 Face Swap 和 Body Swap 工作流。對需要處理人物素材、測試影像生成效果,或想將換臉與換身加入現有影像項目的創作者,這類示範可作為起點。

影片涵蓋的內容包括:
– MiniMax H3 在 ComfyUI 中的工作流安排
– Face Swap 換臉流程
– Body Swap 換身流程
– custom nodes 的配合方式
– 從輸入素材到結果輸出的完整操作示範

使用者仍需按素材類型、節點版本及本地環境調整設定,並留意人物影像替換涉及的肖像權與授權問題。

項目主頁

Categories: 開源, ComfyUI, 教學, 安全, MiniMax, UI/UX

ComfyUI-MiniMaxH3-Contex-Loop:讓 MiniMax H3 多場景影片可重試續作

把多場景影片拆成可審核、可重試的製作流程,減少一次渲染失敗便要由頭再做的浪費。

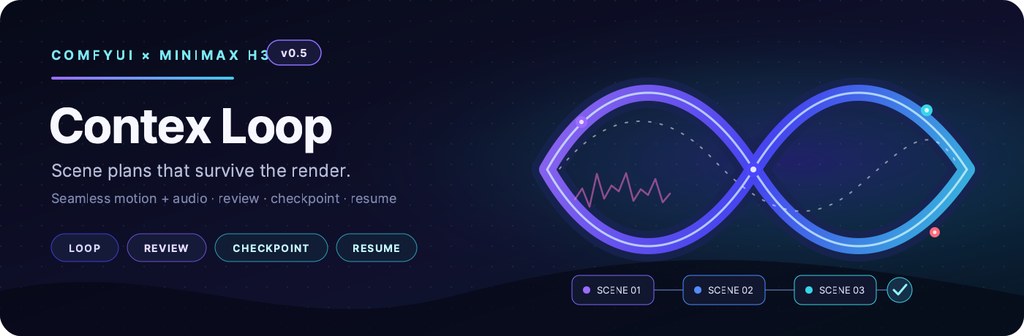
MiniMax H3 Contex Loop v0.5 — scene plans that survive the render

多場景影片最麻煩的地方,往往不是生成單一鏡頭,而是其中一幕出錯後要重做整段流程。ComfyUI-MiniMaxH3-Contex-Loop 是一套開源 ComfyUI 工作流工具,利用一個可重用的 sampling body,按 scene Plan 逐幕生成 MiniMax H3 影片,並把已接受的片段從磁碟組合起來。

每個場景都可以獨立設定提示詞、seed、時間、圖片、動態影片及音訊參考;Review Gate 會讓使用者選擇批准、重試、reroll 或提早停止。candidate_count 亦可為單一場景生成多個候選,最後由使用者揀選指定 take,減少整條工作流反覆排隊的成本。

  • 支援中斷後 resume、partial assembly 及 atomic checkpoints
  • 可延續現有片段,處理 inpainting 和 two-ended bridges
  • Guide 與 protected AV-prefix transitions 有助維持畫面、動態及聲音連接
  • 支援 latent-to-PNG export,並可從已儲存資產恢復製作

v0.5 要求較新的 ComfyUI,包含原生 Add Guide for MiniMax H3。FFmpeg 放在 PATH 會較方便,沒有時可由 ComfyUI 內置 PyAV 處理 review 和 assembly,因此硬件、模型配置及渲染時間仍然是主要限制。倉庫目前以 main 作為支援的 0.5 發行線,已儲存的 0.4 workflows 和 checkpoints 仍然支援,較適合把生成流程分段管理的影片創作者及技術團隊。

GitHub

Categories: 開源, ComfyUI, AI productions, Video, Image, 框架, MiniMax

Comfy-mcp:讓 AI 直接操控本地工作流

Comfy MCP 把本地 GPU、模型與自訂節點交給 AI 管理,令 ComfyUI 工作流可以用自然語言建立、執行及修改。

Comfy

由 MiniMac Code、Claude、Cursor、Codex 等 AI agent 用自然語言建立並執行本地 ComfyUI 工作流,正是 Comfy MCP 提供的核心能力。它屬於 Model Context Protocol(MCP)伺服器,透過 comfy-cli 連接使用者自己的 ComfyUI,處理模型、節點、工作流與輸出圖片之間原本較繁複的操作。

使用者需要先有本地 ComfyUI 及 Python ≥3.10,再把 Comfy MCP 設定到支援 MCP 的客戶端。連接後,AI 可以讀取目前安裝的節點、自訂節點、模型及 GPU,搜尋可用模板,驗證工作流圖表,修改模板欄位,提交非同步工作,監察、取消工作,以及收集輸出的 PNG 檔案。

它和只依賴固定模型目錄或靜態工作流範例的做法不同,會按本機真正載入的內容作判斷,亦能在下載模型前檢查硬件是否有足夠能力。這減少了模型版本、節點依賴和顯存不相容帶來的失敗,但生成速度、可用模型和成功率仍然取決於 GPU、ComfyUI 安裝狀態、自訂節點及工作流本身;項目資料未提供統一基準測試數據。

較適合經常製作影像或影片工作流、需要反覆試驗模型的創作者,以及想把本地 GPU 納入 AI agent 流程的開發團隊。Comfy Cloud 與本地連線可以同時使用,代理可按硬件和任務需要選擇位置,形成雲端彈性與本地模型控制之間的折衷。

  • 自然語言操作:建立、編輯、驗證及執行 ComfyUI 工作流。
  • 讀取本機環境:辨識 GPU、模型、模板及包括自訂節點在內的已載入節點。
  • 完整工作管理:支援提交、等待、監察、取消及讀取失敗結果。
  • 本地與雲端並用:同一個 MCP 連線可按任務需要配合兩種環境。

項目主頁 · GitHub · Skills

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, IDE, Python, Skill 技能

Comfyui-MMH3-UltimateUpscale:長片放大不再受顯存牽制

ComfyUI 新增單節點升頻方案,讓 MiniMax H3 長片在有限 VRAM 顯示卡上處理,同時保留原有音訊。

Repository image for bbaudio-2025/Comfyui-MMH3-UltimateUpscale

長片、高解像度加上有限 VRAM(Video Random Access Memory)通常意味著要大幅降低輸出要求,但 Comfyui-MMH3-UltimateUpscale 把 MiniMax H3 的 AV latent 放進單一 ComfyUI 節點處理,目標是完成升頻而不破壞音訊。它屬於 ComfyUI 自訂工具,實際解決的是標準升頻節點無法理解 H3 視訊與音訊巢狀 latent 結構的問題。

節點會先以 temporal chunking 把長片切成重疊時間區段,再按需要進行 latent upscale,之後以 spatial tiling 分割畫面,逐塊完成 diffusion sampling,最後分別進行 spatial stitching 和 temporal stitching。每次只處理一個 tile,峰值顯存取決於單塊大小,而不是整段影片的長度或完整輸出解像度,代價是切割、重疊與拼接會增加處理時間及流程複雜度。

升頻有兩條路線:MMH3 Latent Upscale with Model Params 會載入 minimax h3 latent upscaler 3d .safetensors checkpoint,以 H3 3D model-based upscaler 改善 latent;MMH3 Latent Upscale Params 則只用 nearest、bilinear、area 或 bicubic 插值,不需額外模型,較省資源但不會補回模型推斷的細節。兩者都保留 32-channel audio,音訊部分不會重新取樣。

  • 長片可用 temporal chunking 分段處理
  • 高解像度可用 spatial tiling 控制顯存峰值
  • 單一 MMH3 Ultimate Upscale 節點包辦整個流程
  • 3D 模型升頻與免模型插值可按硬件取捨
  • 輸入必須是已完成去噪的 MiniMax H3 AV latent

這個項目較適合已經用 MiniMax H3 產生影片、但顯示卡顯存不足以一次處理完整片段的 ComfyUI 使用者,也適合需要保留同步音訊的影片製作流程。測試時應由較短片段及較細 tile 開始,確認模型 checkpoint、H3 節點及拼接結果正常,再逐步增加時間分塊和輸出解像度;它降低的是顯存門檻,並不代表長片升頻可以即時完成。

GitHub

Categories: 開源, ComfyUI, Video, Audio, MiniMax

MiniMax H3 整合成單一節點,ComfyUI 剪走繁瑣接線

把 MiniMax H3 的影片流程收成一個節點,省去搭工作流和找模組的時間。它更像一個整合入口,讓生成、延伸、關鍵幀同音訊驅動集中處理。

Buy Me a Coffee at ko-fi.com

在 ComfyUI 裡要跑 MiniMax H3 影片流程,最麻煩往往不是模型本身,而是工作流太碎。ComfyUI-ALLinONE-MinimaxH3 把這套流程收成單一節點,屬於 ComfyUI 的工具項目,目標是把文字生成影片、圖片轉影片、參考圖驅動、音訊帶動嘴型同影片延伸放進同一個入口。

安裝方式很直接:放入 ComfyUI/custom_nodes/ 後重啟 ComfyUI,再在畫布搜尋 ALL in ONE MiniMaxH3。項目主打幾個模式,包括 Image、T2V、I2V、R2V、Audio Drive、Keyframes、Extend 同 Chain,實際用法是先揀模式,再輸入 prompt 或參考素材,由節點接管後續流程。

官方 MiniMax H3 原生工作流、ComfyUI-H3-Motion-Context-MultiRef、MiniMax H3 Turbo pack,同埋 H3 Studio 的圖片模式都被包進同一個介面,對需要反覆試片段、接續鏡頭、處理多參考素材的影片製作流程特別實用。

  • 支援 T2V、I2V、R2V、Audio Drive、Keyframes、Extend、Chain
  • Chain 用 H3 Motion Context 做多段續接,走 latent path,避免重新編碼
  • 內建歷史、收藏同預覽,方便回看 prompt 同結果
  • 亦有 RTX / Seed2VR Video Super Resolution 的 upscale 接口
  • 作者標明仍屬 Beta,兼容性要跟指定版本和模型清單對齊

目前較適合已經在 ComfyUI 裡做影片生成、又不想每次重砌圖的人。官方工作流仍然是底層來源,呢個項目更像把常用路徑包成一個操作面,方便快速試片、改參考圖同續接片段。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

ComfyUI_MiniMaxH3_Director:一次過生成多段影片的導演台

想做長片、多段生成又唔想逐段接節點,這個項目把 MiniMax H3 的分鏡、取樣和輸出收在同一個 ComfyUI 工作流核心。

MiniMaxH3Director 工作流截图

做長影片時,最麻煩往往唔係單段生成,而係分鏡、續接、音畫輸出要分開處理。AIMixer/ComfyUI_MiniMaxH3_Director 針對的正是這個卡位:它屬於 ComfyUI 的影片生成節點插件,將 MiniMax H3 的多段規劃、條件編碼、採樣解碼和匯出合併成一個導演台,讓長視頻與多段音視頻生成流程集中管理。

它的價值不只在於把功能堆在一起,而是把幾種常見工作流放進同一個操作面。無論是 t2v、i2v、fl2v、r2v、v2v 還是 rv2v,都可沿用同一套時間軸邏輯;當中首尾幀、參考素材組、源片改寫和選擇性重跑都已經整理好,對需要反覆改段落、補鏡頭或保留原聲的創作者會實用得多。

安裝方式也算直接,前提是 ComfyUI 要升級到 v0.30.0 或以上,並已具備官方 MiniMax H3 支援。之後可用 ComfyUI Manager 透過 Git URL 安裝,或手動放進 custom_nodes,再按需要補上 scenedetectopencv-python-headlessimageio-ffmpeg 這些依賴;模型權重與示例工作流則需另外下載。要留意的是,CLIP Loader 的 type 必須設為 minimax,而 fl2va / ref2va UNET 亦要按任務類型配對。

跟一般把多個節點逐個串起來的做法相比,這個項目明顯偏向把影片導演流程封裝成一個較完整的工作台,代價是你仍然要跟官方 MiniMax H3 節點規格保持一致,並理解不同模式背後用的是 MiniMaxH3ImageToVideoMiniMaxH3ReferenceToVideoMiniMaxH3SigmaShiftKSampler 與 AV 分離解碼鏈路。重點放在長片分段銜接、段間運動延續與原生立體聲輸出,較適合已經在 ComfyUI 內做影片生成、希望減少手動接線和重複操作的團隊。

  • 把多段時間軸、生成、解碼、匯出收進單一節點
  • 支援 t2v、i2v、fl2v、r2v、v2v、rv2v 多種模式
  • 可做選擇性重跑,未勾選片段可用快取或原片填補
  • 依賴官方 MiniMax H3 節點,環境版本與模型配對要設好
  • 原生輸出立體聲音頻,適合長片與多段音視頻工作流

GitHub

Categories: 開源, ComfyUI, MiniMax

MiniMax H3 Turbo:4 步加速的影音生成 LoRA

MiniMax H3 的 ComfyUI 加速 LoRA,把 10 秒影片生成壓到固定 4 步。它適合要在速度、畫質和可控性之間取平衡的 T2V 與 I2V 工作流。

Og image

MiniMax H3 Turbo 走的是 ComfyUI 用途的加速路線,核心價值在於把 MiniMax H3 的文本生成影片(Text-to-Video, T2V)和圖像轉影片(Image-to-Video, I2V)流程固定到 4-step Euler 推理。它不是獨立模型,而是要配合 Comfy-Org/MiniMax-H3 的 BF16 base model 使用;頁面未提供更完整的 base model 參數規模或訓練細節,所以不能再往下猜。

這種設計的取捨很直接:步數少,生成時間通常更短,但對動作細節和穩定性的容錯也會更窄。頁面列出的比較都在同一個 BF16 base model、同一輸入與 10 秒、約 0.9MP 解析度條件下做,LoRA strength 固定 1.0;不同場景下,時間大概落在 174 到 190 秒之間,速度提升存在,但不是壓倒性。

重點摘要:
– 支援 T2V 與 I2V,I2V 走第一幀路徑,亦可用最後一幀收尾
– 固定 4-step Euler,重點是縮短推理流程而非擴大模型能力
– 需要配對 Comfy-Org/MiniMax-H3 的 BF16 base model
– 頁面未列出 GGUF、mmproj、上下文長度或量化檔案資訊
– 與 lightx2v LoRA 的比較屬同級加速方案,差距主要體現在時間與輸出取向

從檔案描述看,這個項目是 LoRA,不是完整 diffusion checkpoint,所以它的定位比較像「推理策略補丁」而不是全新模型。頁面也沒有提供 llama.cpp、Ollama 或 LM Studio 的支援資訊,顯示它主要面向 ComfyUI 工作流,而不是通用本地推理框架。

檔案命名上,頁面強調這是 v2 類型的更新版本脈絡;因此可確認的只有它圍繞 H3 的 joint audio-video diffusion path,並以固定 4 步作為加速契約。若要和原始 base model 比,差別不在功能範圍,而在於把生成速度和步數控制收緊,換取更快的工作流回饋。

模型

Categories: 開源, ComfyUI, 數字人, 視覺模型, 視頻模型, Video, Image, Audio, MiniMax

ComfyUI-Spectrum-MiniMax-H3:為 H3 加速 33%

將 1056x608 影片生成由 685 秒縮短至 464 秒,避開昂貴的 transformer 重算。它屬近似加速,但影片細節可能走樣。

Repository image for xmarre/ComfyUI-Spectrum-MiniMax-H3

每次跑 MiniMax H3 都要付出完整 transformer 計算成本,對要反覆試 prompt、鏡頭動作同參考音訊的人來說,等待本身就是工作流瓶頸。xmarre/ComfyUI-Spectrum-MiniMax-H3 針對的正是這一步:它屬於 ComfyUI 自訂節點工具,會在部分 solver steps 直接預測 post-transformer hidden features,減少原生 MiniMax H3 audio-video model 的重計算次數。

實測生成 1056×608 影片由 685 秒縮短至 464 秒。加入這 Node 後可惜仍未能解決「廣東話」問題!

它不是把整個模型 shortcut 掉,而是用 Chebyshev ridge model 去擬合已經算出的 hidden features,再對未來步數作 spectral forecasting;但當前步的 output heads、video reconstruction、audio reconstruction、sigma mapping 同回傳結構仍然照常執行。這個取捨很務實,因為它換到的是抽樣成本下降,不是完全無損加速,所以 README 已經講明輸出不會與原生 MiniMax H3 bit-identical。

作者後來把預設路徑改成 offline_smoothing_replay,核心原因不是追求更高畫質,而是先救回音訊品質。早期單次流程會令語音清晰度、自然度同穩定性下降,甚至出現 doubled syllables 同 stuttering;現時預設把 audio_blend_weight 維持在 0,並以第二次無 transformer 的 replay 處理 video blend,目的就是切斷後段 video-to-audio feedback 對聲音的干擾。不過,畫面軌跡仍可能改變,動作、視線、時間點,甚至眼睛、手指、四肢細節都有機會走樣。

安裝十分簡單,適合願意做 exact-seed A/B 比對的創作者、工作流調校者,或者已經在 ComfyUI 內使用 MiniMax H3 的團隊。README 也提到舊版 workflow 可能要手動開啟 offline_smoothing_replay,而且 broader checkpoints、prompts、samplers 同 reference inputs 仍未完成足夠驗證,現階段更像是一個有方向、有明確修正策略,但仍需按素材類型逐步確認的加速方案。

  • 以 spectral forecasting 預測部分 future solver steps,重點是減少 MiniMax H3 最昂貴的 transformer evaluations。
  • 保留當前步的原生輸出頭與音畫重建流程,因此屬於近似加速,不是無損複製原生結果。
  • 預設改用 offline_smoothing_replay,主要是修正早期版本對語音自然度與穩定性的破壞。
  • 音訊路線暫時較保守,但視覺結果仍可能出現 motion、pose 與細節結構偏移。
  • 較適合已在 ComfyUI 工作流內做反覆測試、願意接受 A/B 驗證成本的使用情境。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

Page 3 of 8
1 2 3 4 5 8