LLM-as-a-Verifier 點樣重寫代理評分

當代理唔只要答得啱,仲要一步步做得穩,粗略打分已經唔夠。LLM-as-a-Verifier把評估拆細,令挑選、追蹤同訓練都更有依據。

LLM-as-a-Verifier

代理系統最常見的瓶頸,唔係生成唔到答案,而係你難以知道它每一步到底做得幾好。LLM-as-a-Verifier屬於開源框架,針對的正是呢個問題:它唔只為最終結果打一次分,而係用更細緻的方式為候選答案、行動步驟同任務準則提供可量化回饋。

現有做法不少仍然依賴單次判斷、粗粒度分數,或者只看最終成敗;作者認為呢種固定範式會忽略不確定性,亦難以支援 progress tracking 同 reinforcement learning。LLM-as-a-Verifier改用三個核心設計重組驗證流程:score granularity、repeated evaluation 同 criteria decomposition,並且直接對 LLM score tokens 的完整 logprob distribution 取期望值,而唔係只取單一輸出。

呢個取向令它同一般 judge-style 評分器有明顯分野。它重點唔在於產生一句評語,而係產生可反覆比較、可分解、可累積的 fine-grained feedback,所以可以用於 Best-of-N selection、pairwise compare,同埋逐步追蹤代理行為變化。README 亦展示了 Python 套件 llm-verifier 的基本用法;安裝方式有提供,但更完整的部署細節主要放在官方文件,而某些流程亦需要 VERTEX_API_KEY 或可回傳 logprobs 的 OpenAI-compatible server。

  • 支援任何 modality 的驗證框架,定位比單一 benchmark judge 更廣
  • 方法核心是細粒度評分、重複驗證、按 criteria 拆解準則
  • 可直接用於 selection、compare、track,同時連到 reinforcement learning
  • 官方列出 Terminal-Bench V2、SWE-Bench Verified、MedAgentBench、RoboRewardBench 等結果
  • 相關模型與服務包括 Qwen/Qwen3.5-9B、Qwen3-8B、Gemini 2.5 Pro,以及 OpenAI-compatible server

表現上,項目聲稱在多個 agentic benchmarks 達到 state-of-the-art,包括 Terminal-Bench V2 86.5%、SWE-Bench Verified 78.2%、RoboRewardBench 87.4%、MedAgentBench 73.3%,亦提到在 LIBERO 配合 SAC 微調 pi 0 policy 時,sample efficiency 約高 1.8 倍。呢類數字反映它較適合研究團隊、代理平台開發者,同埋想將評估訊號接入訓練迴路的人;單純只想要一個最終分數的團隊,未必需要用到它整套驗證尺度。
項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, NVIDIA, OpenAI, Gemini, Medical醫學, Python, Anthropic, Dataset 數據集

TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

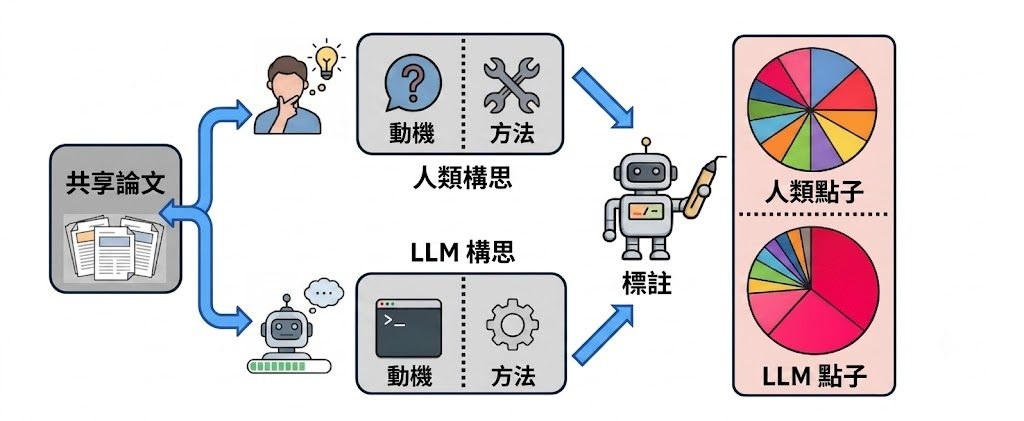
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.py 同 label_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generation 與 labeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集

AgenticDataBench:數據代理基準點樣睇

這是一個評測 data agents 的 benchmark。它用真實任務同技能標註,檢查模型是否真係識做數據工作。

example

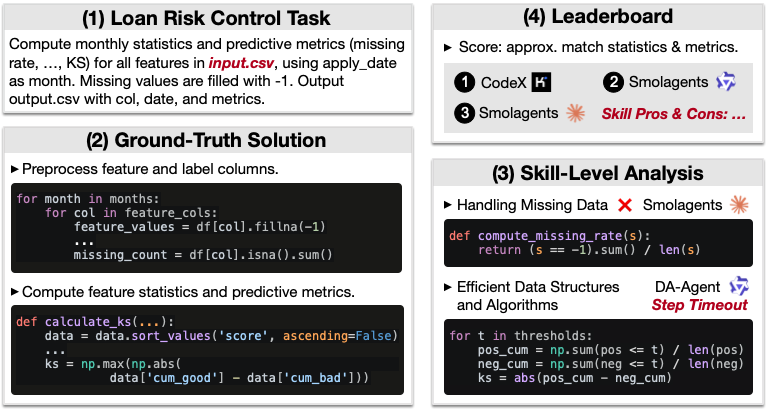
AgenticDataBench 是一個用來評測 data agents 的 benchmark,而唔係直接幫人做分析的模型或應用。它要解決的是:LLM-based data agents 能否穩定完成 data science workflow,並且用可比較、可重現的方式量度表現。

現有做法多數只用零散任務、單一資料集,或者只看最終答案,較難知道代理究竟卡在哪個步驟。這個項目改用 344 個任務、15 個領域,再配合細緻的 skill labels 同 ground-truth,將問題拆成可重用的 data science skills,例如缺失值處理一類操作模式,令評測唔只得總分,仲可以見到技能層面的強弱。

部署同理解方式都幾直接:資料集可由 HuggingFace 下載後放入 testbed/datasets/,任務、gold 標註同結果目錄已經分開,另外保留咗 98 個 private test tasks 維持 leaderboard 的可信度。README 亦提到需要設定 API keys,反映它主要係一個開放測試台,方便用不同 agent harness 跑同一批任務,而唔係單機即開即用的終端工具。

同類 benchmark 相比,它的取向唔係追求最少題目下的快速排行,而係強調真實性、技能覆蓋率同冗餘控制。項目一方面收錄真實 B2B fintech use cases,另一方面用 skill-aligned hierarchical clustering 同系統化生成流程補足缺少真實任務的領域,這種做法的代價是建置與維護較重,但換來更完整的比較基線。

  • 覆蓋 15 個領域,包含真實 B2B fintech 任務
  • 提供 tasks、ground-truth、skills 同 results 結構化內容
  • 支援比較不同 agent harness,如 Smolagents、DA-Agent、Claude Code、CodeX
  • 已列出 Qwen3.5-397B-A17B、Kimi-K2.5、Claude Sonnet 4.6 的初步實驗

這個項目最適合做 data agent 研發、模型選型同內部驗證的團隊,也適合研究人員用來檢查代理在哪類 data skills 失分。性能資訊目前以 leaderboard 結果為主,重點不只是 accuracy,仲包括 skill-level insight;相關模型至少包括 Qwen3.5-397B-A17B、Kimi-K2.5 同 Claude Sonnet 4.6。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, Agentic, Qwen, API, Anthropic, Dataset 數據集, Skill 技能

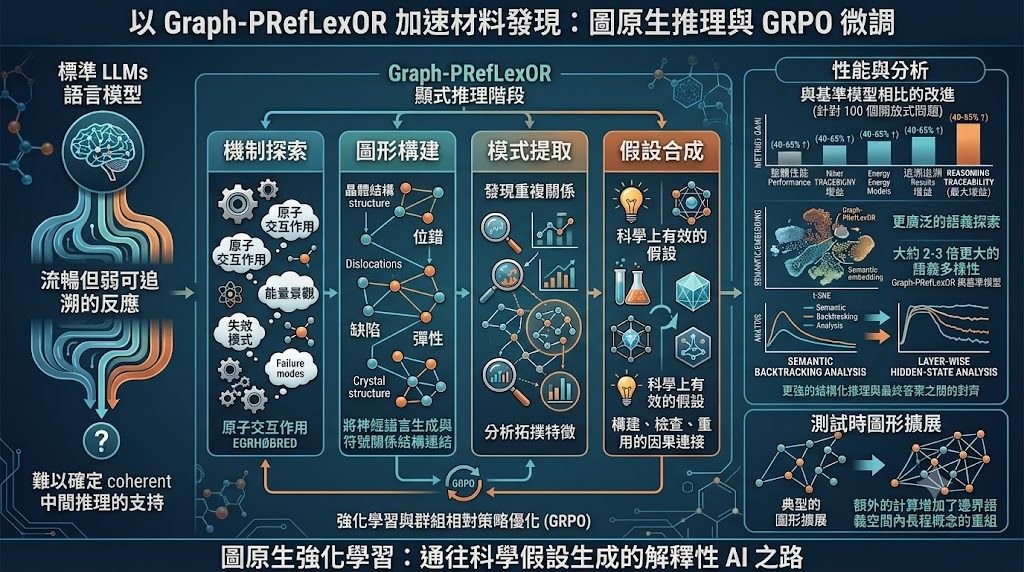
Graph-GRPO:教模型先畫知識圖再作答

這是一個訓練語言模型的開源項目,重點是先整理知識圖,再輸出答案。它想改善純文字推理難以追蹤思路的問題。

Repository image for lamm-mit/graph-preflexor-grpo

這是一個用來訓練語言模型的推理項目,核心屬於模型訓練流程兼研究原型。它要解決的問題,是模型回答問題時往往只輸出文字結論,推理結構難以檢查;Graph-GRPO 先要求模型把概念、關係與規律整理成 knowledge graph,再整合成答案。

現有做法多數依賴 chain-of-thought 或一般文字式 reasoning,把中間思路寫成自然語言。作者認為這種範式雖然靈活,但節點、因果、約束與抽象規律不易固定表示,因此提出 graph-native 的訓練方式:先用 ORPO(Odds Ratio Preference Optimization)或 SFT(Supervised Fine-Tuning)學格式,再用 Graph-GRPO 做強化學習,直接獎勵正確性、格式完整度與 graph utility。

項目的設計相當明確:節點類型限制為 entity、attribute、process、event、outcome、law、claim,關係亦只保留 12 種 verbs,並用 Pydantic 做結構化解析與 schema validation。這種取向的好處是輸出較易驗證,甚至能自動修補無效 graph;代價是表達自由度較低,未必適合非常開放、需要細膩語氣或鬆散聯想的回應。

部署與理解方式也算清楚,整個流程分成資料生成、run_orpo_graph 或 SFT 訓練,再進入 run_grpo_graph 強化階段,並以 LoRA 疊加在基礎模型上。README 亦提到可透過 OpenAI-compatible endpoint 驅動 ideation engine,把多輪生成的 graph_json 累積成可擴展知識圖,用於創意探索、問題延伸與比較不同前沿模型的表現。

  • 適合想研究可追蹤推理、結構化回答與可驗證中間步驟的團隊
  • 已釋出相關模型,基礎模型包括 Qwen-8B 與 Llama-3.2-3B-Instruct
  • 獎勵設計公開列出 correctness、format、graph utility 三部分權重
  • 亮點不在單純答得快,而在於把 reasoning 過程轉成可檢查的 graph object

在目前提供的內容中的性能不算完整,較明確的是訓練路徑、輸出結構與後續 ideation 用途,而 supporting context 另提到這條路線也延伸到 scientific hypothesis generation。整體來看,這個項目較適合研究型開發者、做 Agentic workflow 的團隊,以及想把 LLM 回答過程由黑盒文字轉成結構化證據鏈的人使用。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型訓練, Qwen, OpenAI, API, KnowledgeGraph, LLaMa, Anthropic, Meta, Dataset 數據集

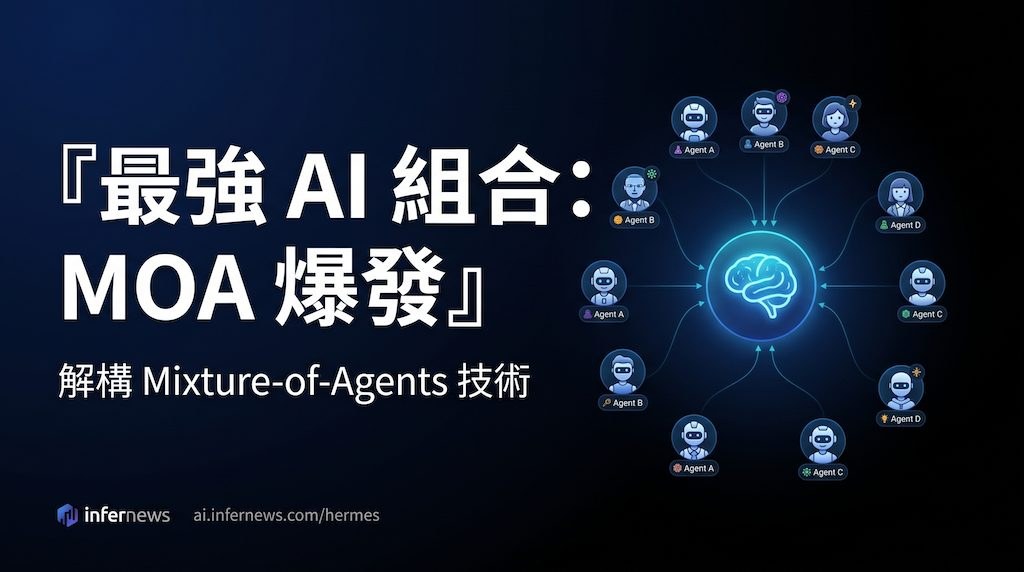
Hermes MoA 協作提升答案質素

MoA 讓多個 LLM 平行作答,再交由一個模型整合。它適合較複雜的問題,但成本和延遲都會增加。

Hero image preview

這是 Hermes MoA(Mixture of Agents,混合代理)架構。它的主要用途是讓多個 Large Language Models 同時回答同一條問題,再由一個聚合者整合各自較強的部分,輸出單一答案。

MoA 的重點不在於訓練一個新模型,而是把多個現有模型疊成一個協作流程。文件指出它依靠多樣性、互補性與聚合三個機制運作:不同模型會走出不同推理路徑,彼此可以補足盲點,最後再由較強的模型統整結果。這種做法和只用單一模型相比,目標是提升複雜任務的回答質素。

在 Hermes Agent 內,這個項目提供三種落地方式:shell 腳本、delegate_task 與 Kanban。Shell 版本最直接,做法是先把多個 proposer 的回覆收集起來,再交給 aggregator 讀取並重寫成最終答案,較適合快速驗證流程;另外兩種方式則較適合需要更穩定管理的工作流。

文件亦清楚交代取捨。MoA 的成本大約是 N+1 倍,延遲通常接近最慢 proposer 再加 aggregator 的時間,所以不適合簡單問答;但對需要比較、整合、推理的任務會更有價值。頁面同時提到在 AlpacaEval 2.0 可帶來約 65% lift,而 proposer 數量以 3 至 5 個作為較理想的平衡點。

  • 核心流程是平行提議者 + 單一聚合者
  • 主要價值在於結合不同模型的長處
  • Hermes Agent 支援 shell、delegate_task、Kanban 三種實作
  • 成本與延遲明顯上升,較適合複雜任務
  • 示例有 anthropic/claude-sonnet-4、openai/gpt-4o、google/gemini-2.5-pro、deepseek/deepseek-chat

適合想在現有 LLM 工作流上疊加協作機制的人閱讀,尤其是需要提升答案穩定性、綜合能力或多角度分析的場景。它不是單一模型的介紹,而是一種可直接套用在 Hermes Agent 的編排方法。

項目主頁

Categories: Agentic, Google, OpenAI, DeepSeek, Gemini, 框架, Anthropic, Dataset 數據集

Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

Headroom in action

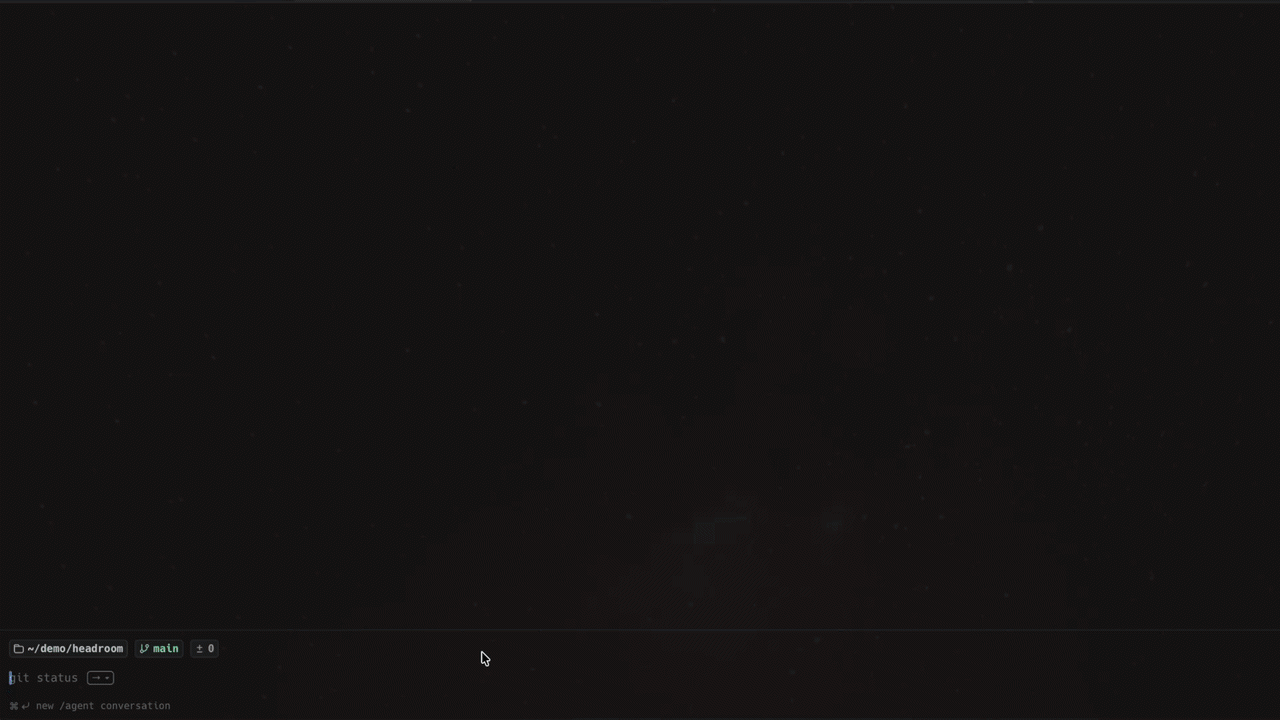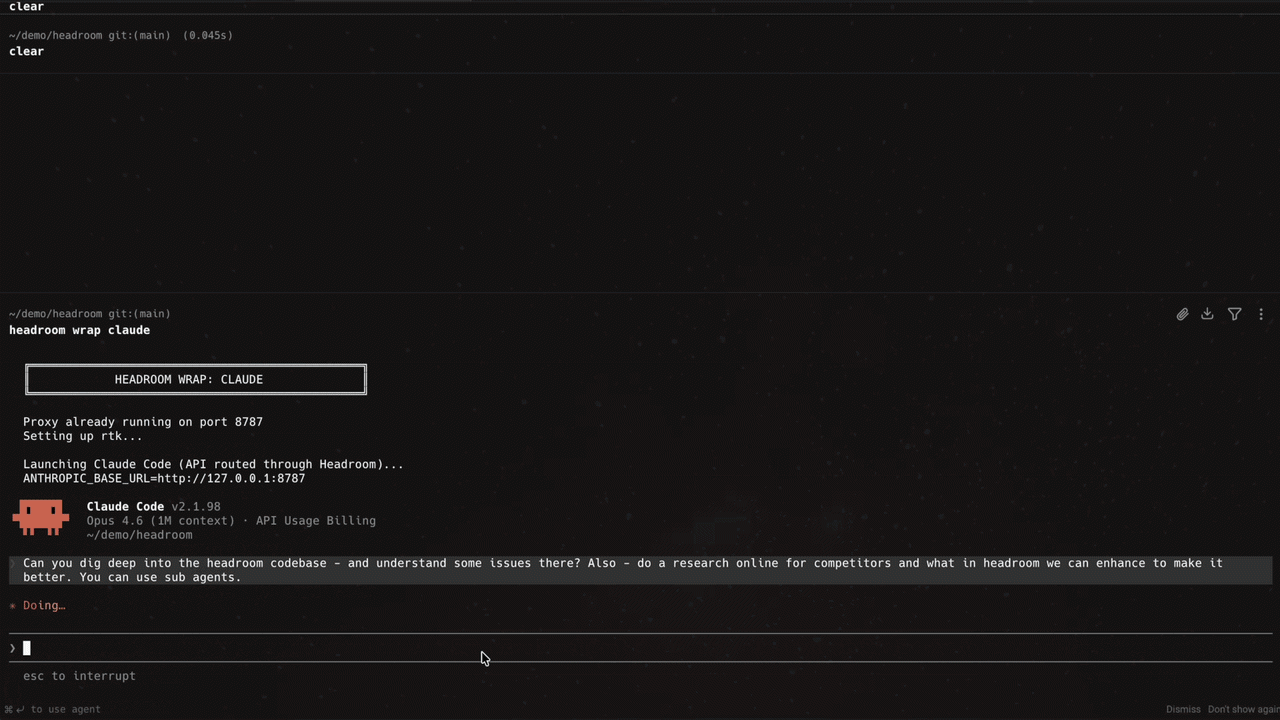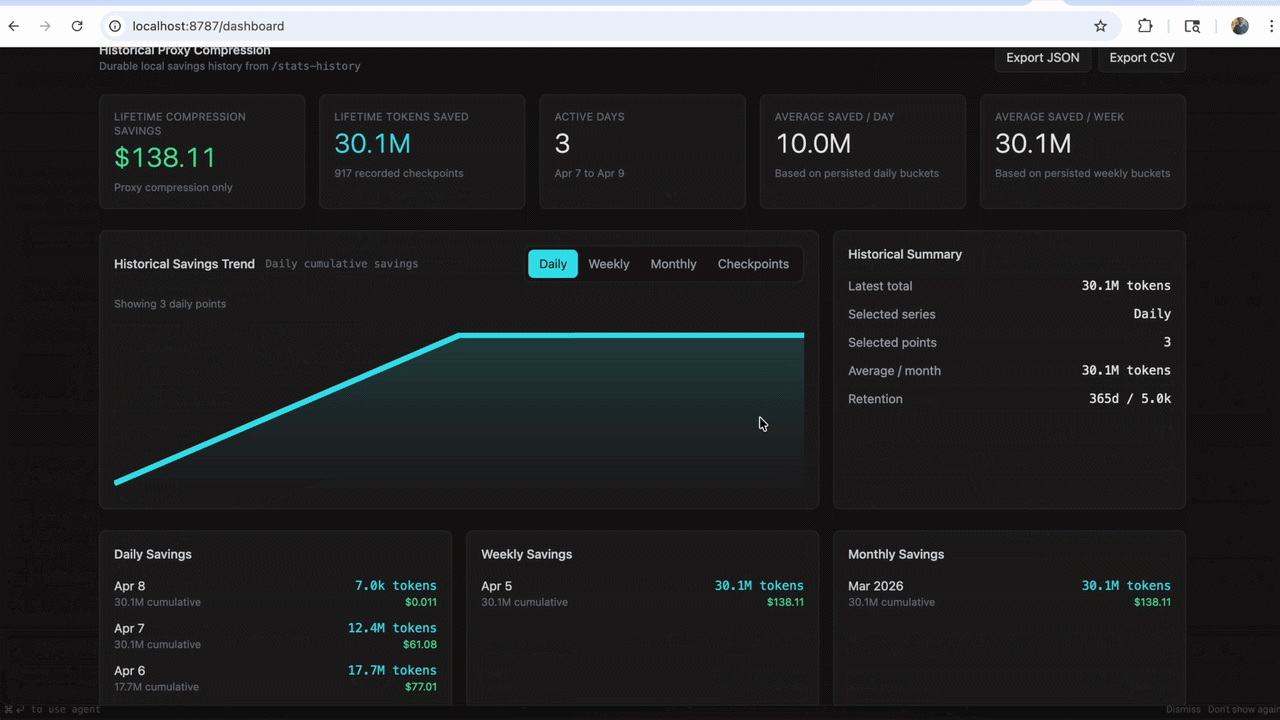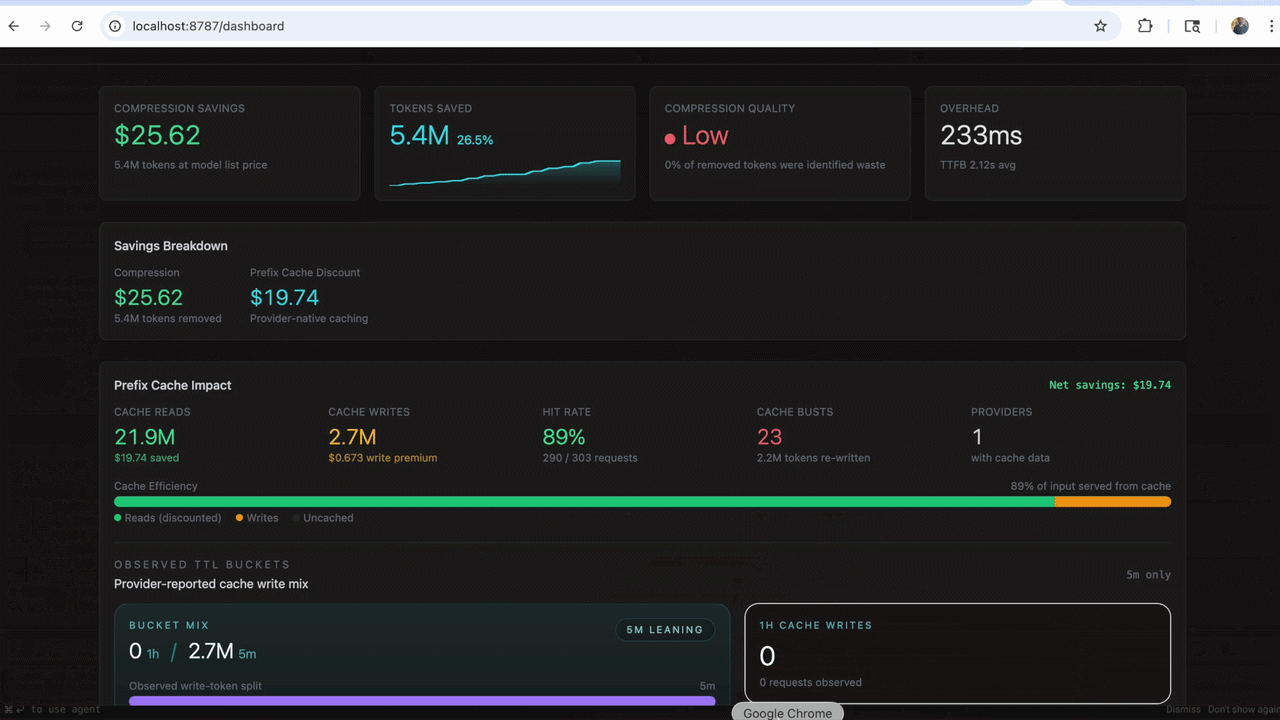
Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。

GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, 庫, 編程, Anthropic

OpenMontage:AI 代理拍片流程

OpenMontage 想把 AI coding assistant 變成自動化影片製作流程。它重點不只生圖做片,亦會搜集真實動態素材再完成剪輯。

影片製作最花時間的,往往不是按下生成按鈕,而是串接研究、腳本、素材、配音與剪接。OpenMontage Studio 是一個由 AI agents 驅動的創意工作空間,處理影片、圖片、音訊、動畫與 3D 內容,亦可從既有素材開始完成單一任務。

它把製作拆成 8 個階段及 1 個審批關卡:Brief、Research、Script、Scene Plan、The Gate、Narration、Music、Compose 與 Render。系統會先整理受眾、时长、語氣與訊息,再研究產品畫面、參考影片及競爭對手,繼而產出附旁白與 B-roll 指示的劇本。The Gate 會列出將使用的素材、模型、旁白及音樂,待確認或修改後才繼續製作。

  • 研究與定位資料會寫入 decision log,保留決策依據。
  • 場景可混合採用現有素材、素材庫、Stock 素材或生成內容。
  • 旁白可按句子加入修改意見,不必重寫整篇內容。
  • 音樂可按氣氛、每分鐘拍數及能量配對,亦可另行生成。
  • 製作可在 OpenMontage Studio、Claude Code 或 ChatGPT Codex 進行。

這種做法適合已有品牌資料、產品錄影或商品素材的團隊,可由一個構思直接建立完整短片,也可只處理配音、音訊清理或視覺生成。代價是製作仍需經過 The Gate 審批,AI 的研究、定位與場景選擇亦不代表最終成品必然準確;創作者仍要核對品牌訊息、素材授權及輸出質素。

GitHub

Categories: 開源, Agentic, 微軟, Video, Image, txt2img, Content Creator, IDE, Anthropic

ConvFill:即時語音代理的雙模型方案

ConvFill 用本地小模型先開口,再由雲端大模型補上答案。它想解決語音代理常見的「快但唔夠準,準但唔夠快」拉扯。

Teaser

ConvFill 是一個用來建立語音代理的開源系統與研究原型。能夠實現即時回應和準確回答——這兩個目標通常難以兼顧。它將本地運行的小型快速語言模型與在後台進行繁重推理的大型雲端模型相結合,使代理能夠立即開始對話,並在資訊可用時自動填充合理的答案。此程式碼庫包含完整的系統、一個即時語音演示、七個即用型模型以及訓練您自己的模型所需的一切資源。

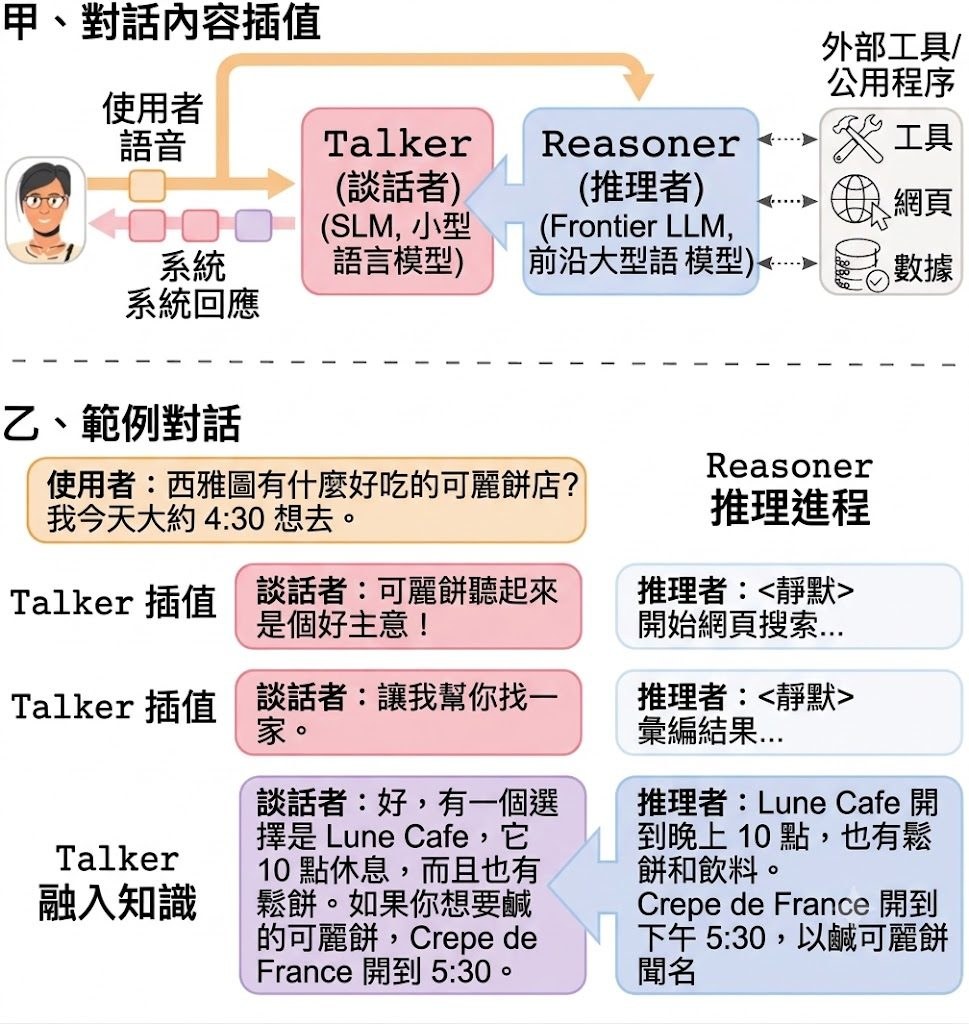
現有做法通常要麼直接等大型模型完整生成,回應較慢;要麼改用較小模型追求低延遲,但複雜查詢、文件搜尋同工具調用能力會明顯下降。ConvFill 提出 conversational infill 這個新任務,將 Talker 與 Reasoner 分工:Talker 先即時說話,Reasoner 在背景處理慢工序,再把精簡知識流式交回 Talker 融入回答。

ConvFill 不是單純做語音介面,而是重新安排推理時序。Talker 可用 135M 到 1.7B 參數的小模型,在手提電腦或手機本地運行;Reasoner 則可接 Claude、GPT 或 Gemini。儲存庫已提供 live voice demo、七個現成模型,以及訓練自家 Talker 所需內容,理解上可視為「本地即時對話層 + 雲端能力層」的組合。

  • 內置七個已微調 Talker,涵蓋 Qwen、Llama、Gemma、SmolLM 家族
  • 配套 ConvFill dataset,含 290,571 個經驗證訓練樣本,覆蓋六個領域
  • Reasoner 可替換為 Claude、OpenAI 或 Gemini,毋須為更換 Reasoner 重新訓練
  • 論文指出系統可維持 millisecond-level time-to-first-response,準確度與對應 frontier Reasoner 的差距縮至 6.3% 內

受益最明顯的,會是想做客服、助理、查詢式語音介面或需要邊說邊找資料的團隊。它未必適合完全離線、又要求深度推理的場景,因為關鍵能力仍依賴雲端 Reasoner;但對希望保留本地回應速度,同時接入大模型能力的項目,這套設計比單模型方案更有工程上的彈性。

GitHub · Paper

Categories: 開源, 模型, Qwen, OpenAI, Gemini, LLaMa, 語音, Anthropic, 蘋果, Dataset 數據集

LLM 組合唔一定勝過最佳單模

呢個 Hugging Face Space重點唔係新模型,而係用統計上限分析多模型編排何時無明顯收益。

Og image

這是一個 Hugging Face Space,用來展示多個大型語言模型組合策略的分析結果,而不是可下載微調模型;頁面亦無提供 base model,因為它本身並非基於某個基礎模型微調而成。它主要回答一個很實際的問題:把多個 LLM 放入 routing、voting、cascade 或 mixture-of-agents(MoA)之後,是否真能穩定超越單一最佳模型。

核心結論圍繞 β = P(all wrong),即所有模型在同一題一起答錯的機率。文中指出,凡是輸出仍然只能選自成員模型答案的策略,理論上準確率上限就是 1 − β;常見的 pairwise error correlation ρ 即使相同,亦未必能反映 β,所以只看模型之間「錯得是否相似」並不足以估算可提升空間。

這個項目的價值,在於它把模型編排問題由「多加幾個模型會否更準」轉成「這些模型是否在不同題目上出錯」。作者用 67 個 frontier models、21 個供應商資料說明:就算是多樣化模型池,all-wrong tail 仍比單靠相關性模型估算更高;在 open-ended mathematics、execution-graded code 這類可檢查任務,多模型通常難以大幅勝過最強單模,除非有很強的 query-level routing signal。

  • 這不是生成模型權重頁,沒有參數規模、context length、GGUF、mmproj 或量化檔案清單
  • 不涉及 llama.cpp、Ollama、LM Studio 部署,亦無 Q4_K_M 一類量化建議
  • 方法重點是用 Clopper–Pearson bound 先估計 β 上限,再判斷是否值得訓練 router
  • 與 Self-MoA 類做法相比,低 ρ 且真正「錯題互補」的模型組合更有機會帶來收益

對技術決策者而言,這個 Space 更像一個模型編排可行性檢查工具。它提醒人不要把 orchestration 當成免費性能加成:當共同失敗率高,多模型系統增加的可能只是成本、延遲與系統複雜度,而非可觀準確率提升。

項目主頁 · Paper

Categories: Agentic, Qwen, OpenAI, DeepSeek, Gemini, 工具, LLaMa, Ollama, Anthropic

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

Page 7 of 8
1 … 5 6 7 8