TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

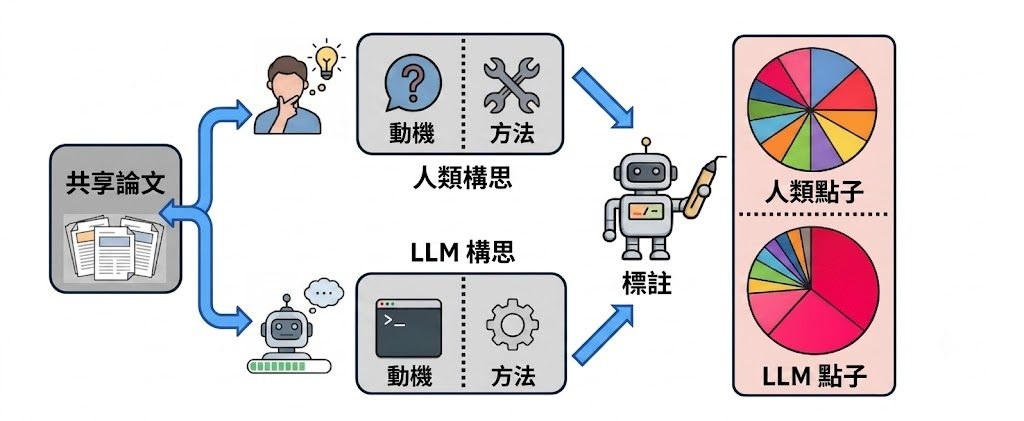
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.pylabel_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generationlabeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集

RDM:一步生成影像的新取向

RDM 係一個一步式影像生成研究項目,目標係用一次網絡推理,做出接近多步模型質素的圖像。

iRDM post-trains four-step FLUX.2 [klein] into a one-step generator at matched quality; GenEval and PickScore climb past

RDM 是一個一步式影像生成研究項目,也是面向 one-step visual generation 的訓練方法。它要解決的問題很直接:把原本需要多次採樣的生成流程,壓縮成一次 network evaluation,仍然盡量保住影像質素。

現有做法通常會依賴 online teacher、adversary,或者追蹤 trajectory 來蒸餾多步生成器;作者認為這類範式訓練成本高、流程複雜,亦容易被單一訊號牽著走。RDM 改用 Representation Distribution Matching,把生成圖與真實圖在多個 frozen pretrained encoders 之下的特徵分佈對齊,核心比較方式是 squared MMD with a Gaussian kernel,同時配合 Nyström attraction、within-batch repulsion,以及 joint image-text law。

這個取向和同類方法的差異,在於它不靠 online teacher、no adversary、no trajectory,訓練邏輯更像直接校準「生成分佈是否接近真實分佈」。作者亦刻意不用單一 encoder,而是用一組 frozen encoders(10 train + 4 held out),再用 proportional Lagrangian controller 平衡各個表示空間,這個設計明顯是想減少模型只迎合某一種評分器的問題。

README 已交代基本理解方式:安裝後可用 ImageNet-256 影像樹做訓練與驗證,也可沿 FLUX text-to-image 路線配合 COCO、GenEval、Pick-a-Pic 做評測;另有 Hugging Face demo 與 checkpoints,可直接看輸出效果。部署上它較像研究型訓練框架,不是即開即用的終端應用,較適合有 GPU 資源、想重現論文結果或做後訓練實驗的團隊。

性能數字有辨識度。RDM 報稱達到 one-step ImageNet state of the art,SW_r14 為 1.30;在 FLUX.2 [klein] 的 post-training 路線中,one-step 模型於 GenEval 達到 0.826,高於 four-step teacher 的 0.794,PickScore 亦升到 22.76,高過 teacher 的 22.58。相關模型與組件包括 FLUX.2 [klein]、open_clip、DreamSim,以及多個 frozen pretrained encoders;整體更適合關注模型訓練、生成效率與影像評測方法的研究或產品項目。

  • 項目類型:研究型訓練方法/框架,重點在一步式影像生成
  • 核心差異:不用 online teacher、adversary、trajectory,改做分佈匹配
  • 測試方式:可用 ImageNet-256、COCO、GenEval、Pick-a-Pic 驗證結果
  • 主要取捨:流程更乾淨,但仍需要資料準備、GPU 資源與完整評測環境
  • 受益情境:想把多步生成器壓成單步模型的研究團隊與影像生成項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型訓練, Stable Diffusion, Image, 影像模型, txt2img, 框架, Dataset 數據集

MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

MrFlow framework

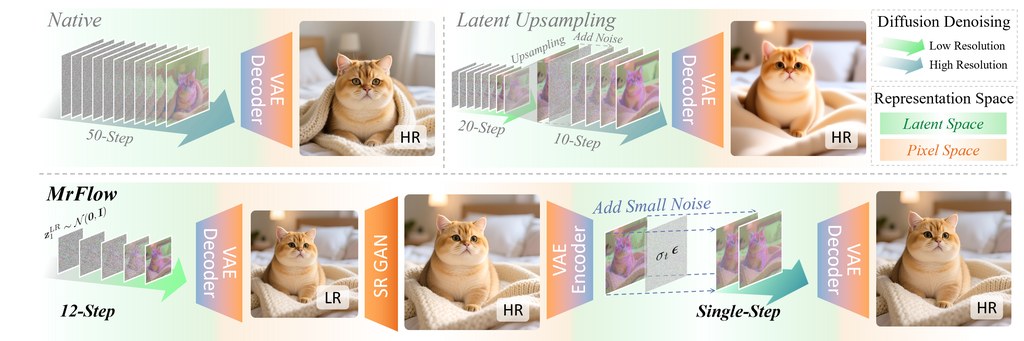
MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。

GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

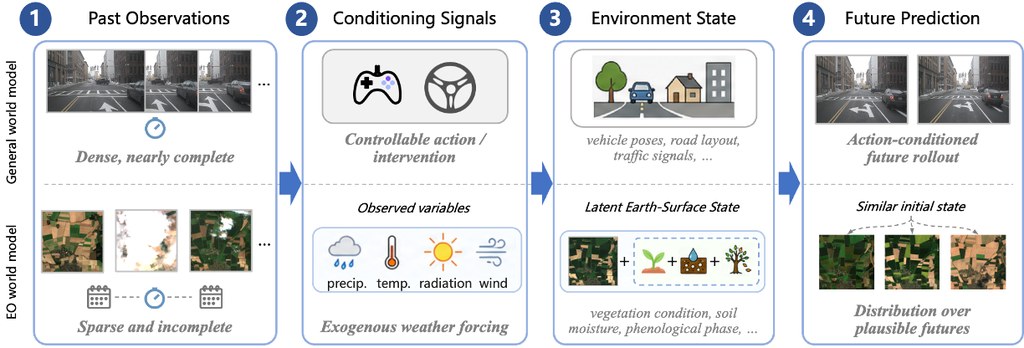
EO-WM:把衛星影像預報變成天氣驅動的世界模型

EO-WM 以物理引導的潛在影片擴散架構預測未來衛星觀測,並針對極端天氣下植被退化與天氣響應準確度提出全新基準。

EO-WM overview

這是一個結合物理知識的影片擴散世界模型(EO-WM),專門用於多光譜衛星影像的概率預測。整體目標是把地球觀測(Earth Observation, EO)預報重新定位為「部分可觀察、天氣驅動的世界建模」任務,在稀疏衛星上下文與未來氣象條件下預測地表動態,並支援災害監測、作物產量預估及植被變化追蹤等下游應用。

過去的 EO 預測方法分為兩類:決定式模型把不確定性壓縮成單一未來影像,擴散式方法則往往把天氣變量當成籠統的條件輸入。這兩種做法都難以正確反映「氣象條件如何改變地表狀態」這個核心問題,而且現有 benchmark 多聚焦於像素重建準確度,未能衡量模型在改變天氣條件時是否會產生方向正確的響應。EO-WM 為了解決這個落差,引入一個 EO 專屬 VAE 把稀疏衛星觀測編碼為潛在影片 token,再用擴散 Transformer(diffusion transformer)經由獨立條件路徑同時處理三種信號:氣候基線(climatological baseline)、天氣異常(weather anomaly)與累積物理壓力(cumulative stress),並持續將空間上下文重新注入影片 token 流。

在評測方面,作者提出兩個以 EarthNet2021 為基礎的診斷式 benchmark:Extreme Summer Benchmark 衡量極端熱浪與乾旱下植被退化的嚴重程度感知能力,引入 TN-MAE 與 Drop Amplitude Error;Seasonal Matched-Pair Benchmark 則衡量當天氣條件改變時預測方向與幅度是否正確,以 Divergence Reproduction Ratio、Directional Hit Rate 與 Paired Divergence Correlation 為指標。報告結果顯示 NDVI 下降幅度的預測誤差相對減少 5.63%,方向命中率相對提升 7.80%,同時在像素級 ENS、P-MAE、N-MAE 等指標上仍具競爭力。

這個項目對遙感研究者、農業監測團隊及氣候風險分析團隊特別有價值,因為它同時提供模型與基準資料,讓外界可在統一的評測框架下比較不同方法的天氣響應能力。從工程角度來看,架構設計強調物理分離條件與空間重注入,而非單純堆疊參數,這種取捨有助於提高極端情境下的可解釋性。需留意的是,目前 GitHub 倉庫主要釋出 benchmark CSV 與 Earthformer 參考評測腳本,模型權重與完整訓練流程屬於配套資源,重現完整結果仍需自行準備 EarthNet2021 的 extreme 與 seasonal 切分資料。

重點摘要:

  • 重新定義 EO 預報範式:把衛星影像預測視為天氣驅動的世界建模,而非純粹的影像重建。
  • 物理分離條件:天氣信號被拆分為基線、異常與累積壓力三條獨立條件路徑。
  • 診斷式 benchmark:Extreme Summer 與 Seasonal Matched-Pair 兩個基準專門檢驗模型在天氣改變下的響應正確性。
  • 可量化的天氣敏感度:NDVI 下降誤差降低 5.63%,方向命中率提升 7.80%,標準指標仍具競爭力。
  • 目前釋出內容:以 benchmark CSV 與評測腳本為主,完整訓練流程需搭配 EarthNet2021 資料集。

GitHub · Paper

Categories: 開源, 香港大學, 香港理工大學, 模型, 世界模型, Stable Diffusion, 框架, 香港, , 深度學習

LLM 組合唔一定勝過最佳單模

呢個 Hugging Face Space重點唔係新模型,而係用統計上限分析多模型編排何時無明顯收益。

Og image

這是一個 Hugging Face Space,用來展示多個大型語言模型組合策略的分析結果,而不是可下載微調模型;頁面亦無提供 base model,因為它本身並非基於某個基礎模型微調而成。它主要回答一個很實際的問題:把多個 LLM 放入 routing、voting、cascade 或 mixture-of-agents(MoA)之後,是否真能穩定超越單一最佳模型。

核心結論圍繞 β = P(all wrong),即所有模型在同一題一起答錯的機率。文中指出,凡是輸出仍然只能選自成員模型答案的策略,理論上準確率上限就是 1 − β;常見的 pairwise error correlation ρ 即使相同,亦未必能反映 β,所以只看模型之間「錯得是否相似」並不足以估算可提升空間。

這個項目的價值,在於它把模型編排問題由「多加幾個模型會否更準」轉成「這些模型是否在不同題目上出錯」。作者用 67 個 frontier models、21 個供應商資料說明:就算是多樣化模型池,all-wrong tail 仍比單靠相關性模型估算更高;在 open-ended mathematics、execution-graded code 這類可檢查任務,多模型通常難以大幅勝過最強單模,除非有很強的 query-level routing signal。

  • 這不是生成模型權重頁,沒有參數規模、context length、GGUF、mmproj 或量化檔案清單
  • 不涉及 llama.cpp、Ollama、LM Studio 部署,亦無 Q4_K_M 一類量化建議
  • 方法重點是用 Clopper–Pearson bound 先估計 β 上限,再判斷是否值得訓練 router
  • 與 Self-MoA 類做法相比,低 ρ 且真正「錯題互補」的模型組合更有機會帶來收益

對技術決策者而言,這個 Space 更像一個模型編排可行性檢查工具。它提醒人不要把 orchestration 當成免費性能加成:當共同失敗率高,多模型系統增加的可能只是成本、延遲與系統複雜度,而非可觀準確率提升。

項目主頁 · Paper

Categories: Agentic, Qwen, OpenAI, DeepSeek, Gemini, 工具, LLaMa, Ollama, Anthropic

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

ShutterMuse:拍照當下即時引導構圖與姿勢的多模態模型

ShutterMuse 是統一多模態大型語言模型,針對拍照瞬間提供構圖決策與人物姿勢推薦,並隨附 CaptureGuide 資料集與評測基準。

ShutterMuse logo

ShutterMuse 是一個統一的多模態大型語言模型(MLLM),專門用於拍照瞬間的攝影引導,解決「按下快門前該怎麼構圖、被攝者該擺什麼姿勢」這個長期被忽略的問題。傳統做法多以「事後美學裁剪」為主,只評估模型能否從既有照片中挑出最佳裁切區域,卻沒有涵蓋拍攝當下的構圖決策,更完全不處理被攝者的姿勢推薦;通用型 MLLM 雖然能給出構圖建議,卻難以精準定位需要調整的區域,而專門的美學裁剪模型雖然定位能力強,卻只能處理裁切這一項任務,兩者皆無法提供結構化、可即時執行的姿勢指引。ShutterMuse 透過同時輸出「保留/微調/重拍」三類構圖決策,搭配 COCO-17 關鍵點與可見度資訊的姿勢骨架,把拍攝引導整合成單一模型。

CaptureGuide-BenchCaptureGuide-Dataset 是這個項目的兩大支柱:前者涵蓋構圖決策/微調與姿勢推薦兩類互補任務,後者包含約 13 萬筆樣本,附帶文字推理與結構化視覺標註,供監督式微調與強化學習微調使用。從評測結果來看,ShutterMuse 在攝影師端引導的 IoU 達到 74.30、BDE 降至 0.054、MLLM-Score 為 0.64,皆優於 Gemini-3.0-Pro、GPT-5.5 與 Venus 等對照組;在被攝者端姿勢推薦方面,平均分數與互動性指標亦具競爭力,且推論時間與 token 消耗明顯低於 Nano-Banana-Pro 與 GPT-Image-2。

這個項目由復旦大學與 StepFun 共同開發,模型權重、評測腳本與範例已於 Hugging Face 與 GitHub 同步釋出。原始資料提供了模型下載連結與項目頁面的示範影片,部署細節需參考項目頁面或模型卡片的後續說明。

重點摘要

  • 統一處理構圖決策(保留/微調/重拍)與姿勢推薦兩類拍攝引導任務
  • 隨附 CaptureGuide-Dataset(13 萬樣本)與 CaptureGuide-Bench 兩項資源
  • 在 CaptureGuide-Bench 多項指標上超越 Gemini-3.0-Pro、GPT-5.5 與 Venus
  • 姿勢推薦推論成本低於 Nano-Banana-Pro 與 GPT-Image-2
  • 適合攝影教學、智慧相機助理、AR 拍攝引導等需要即時回饋的場景

對攝影 App 開發者、相機廠商研究團隊,或任何想把「構圖教練」與「姿勢教練」整合進拍攝流程的產品而言,ShutterMuse 提供了一個可直接微調與評測的起點;至於一般使用者,則可先透過 Hugging Face 上的模型權重與項目頁面示範影片了解其能力,再依官方後續釋出的腳本進行本地部署。

GitHub: https://github.com/lijayuTnT/ShutterMuse

項目主頁: https://lijayutnt.github.io/ShutterMuse/

模型: https://huggingface.co/ShutterMuse/ShutterMuse

Categories: 開源, 模型, 視覺模型, OpenAI, Image, 影像處理, 教學, 工具, Dataset 數據集

DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

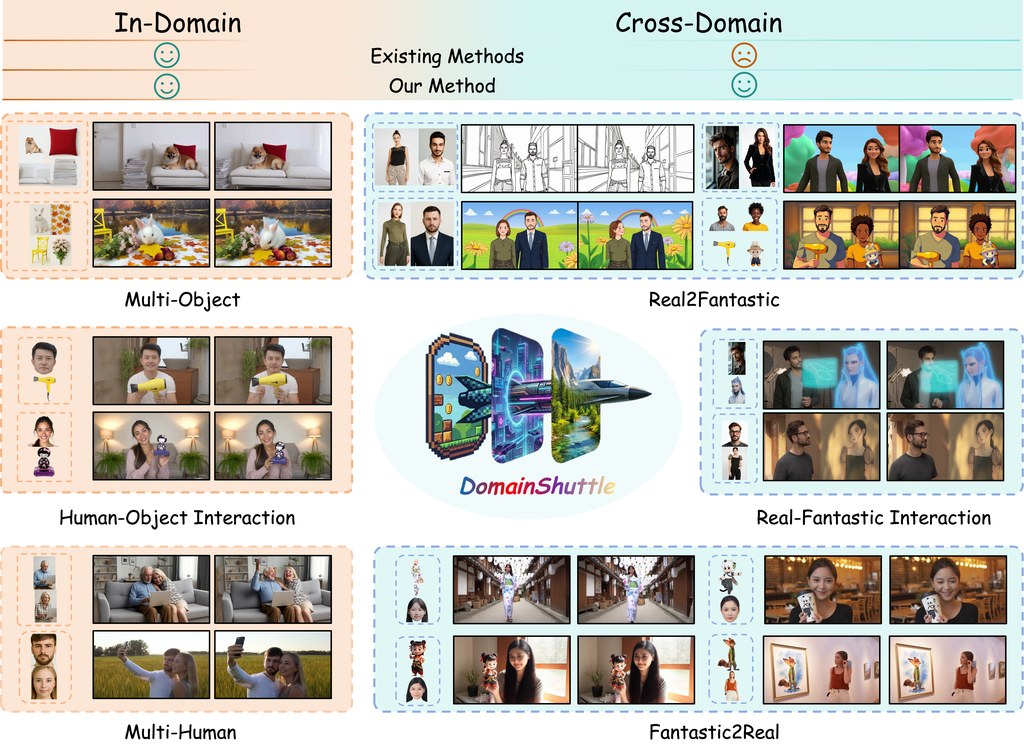
teaser

DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

Semantic Browsing:用樹狀圖掌控 AI 生圖的多樣性

Tel Aviv 大學團隊提出 Semantic Browsing,以多智能體流程把單一文字提示展開成可瀏覽的語意樹,讓圖像生成的多樣性變得可控且可解讀。

Og image

Semantic Browsing 是一篇發表於 ECCV 2026 的學術項目,由 Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or 共同開發。它針對文字生成圖像模型在重複取樣時容易「語意塌縮」、產出過於雷同的問題,提出一套可控多樣性的工作流程。

這套方法的核心做法,是把多樣性從像素層級搬到文字層級。系統會先用多智能體(multi-agent)流程把使用者的提示擴寫成結構化的場景 JSON,記錄物件、屬性、互動與整體場景設定,再從中找出提示中未明確指定、但合理的變化軸心。每一次分支都對應一個明確的語意決定,例如角色、構圖或風格的差異,最終形成一棵可瀏覽的場景樹。

與一般常見做法相比,這個項目最值得留意的差異在於:變化不是來自隨機噪聲,而是來自可解讀的語意約束。樹狀結構讓使用者可以沿著特定分支往下探索,同時保留先前已固定的條件,方便在設計空間中做有意識的導覽。

重點摘要:

  • 開發團隊:Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or。
  • 核心方法:以多智能體流程把提示展開為結構化 JSON 場景樹。
  • 可控多樣性:每個分支對應一個明確的語意決定,而非隨機變化。
  • 適用情境:概念設計、視覺探索、需要比較多個語意詮釋的創作流程。
  • 目前狀態:程式碼尚未公開,僅釋出 arXiv 論文與項目頁。

使用方法詳細教學:

  1. 準備提示:先寫好一段文字提示,例如「A poster featuring animals」,提示中可以刻意留白部分細節,讓系統有空間展開變化。
  2. 進入項目頁:前往 Semantic Browsing 的官方網頁(saradorfman1.github.io/SemanticBrowsing-webpage/),等待互動介面載入。
  3. 送出提示並生成根節點:系統會先推論出一個初始場景詮釋,作為場景樹的根節點。
  4. 瀏覽與選擇變化軸心:介面會列出可變化的語意面向,例如角色、構圖、風格等,每個面向都會顯示目前值與替代選項。
  5. 展開分支:選定一個面向並挑選替代值後,系統會呼叫多智能體流程,在保留先前約束的前提下產生新的子節點與對應圖像。
  6. 沿著分支深入探索:可以重複步驟四與五,沿著感興趣的路徑繼續往下展開,逐步建立一棵專屬的設計樹。
  7. 匯出或記錄結果:若需要保留特定分支,可記下該節點的場景 JSON 或截圖,作為後續迭代或團隊溝通的依據。

由於程式碼尚未釋出,目前只能透過項目頁的示範介面體驗流程;待官方開源後,便能整合進 ComfyUI、Stable Diffusion 等本地生圖工作流。對於從事概念設計、視覺探索,或需要比較多個語意詮釋的創作者與研究人員來說,這套方法提供了一條比隨機抽樣更可控的探索路徑。

項目主頁: https://saradorfman1.github.io/SemanticBrowsing-webpage/

Paper: https://arxiv.org/pdf/2606.23679

Categories: 開源, ComfyUI, Agentic, 模型, 視覺模型, Stable Diffusion, Image, 影像處理, 教學

ReMMDBench-Agent 驗證多模態假資訊

這是一組重現論文結果的研究代碼,集中比較三種多模態 misinformation detection agent 系統。重點不只看分數,亦看證據如何被拆解、檢索與重用。

Repository image for DANG-ai/ReMMDBench-Agent

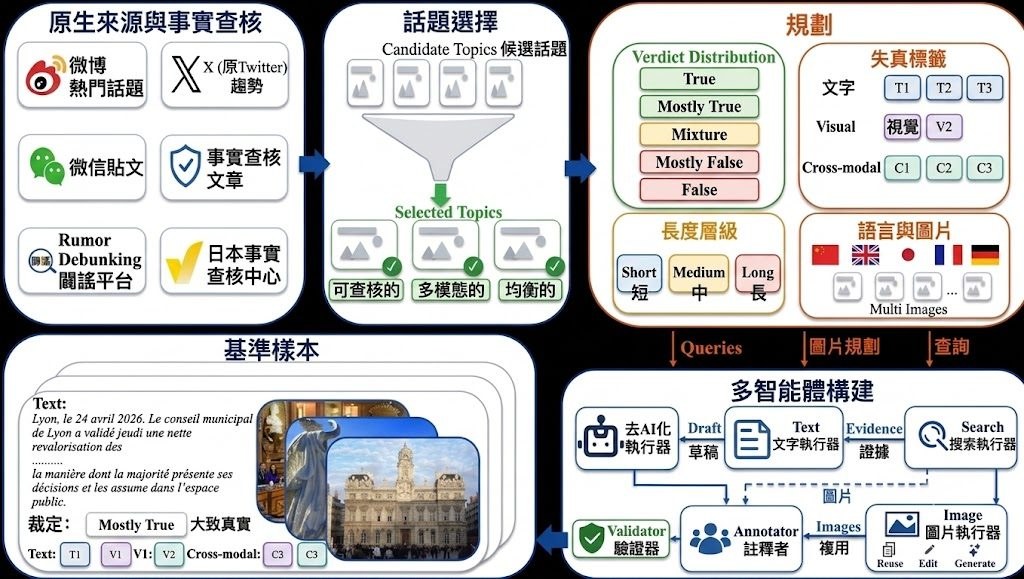
開發團隊來自上海交通大學、上海人工智慧實驗室、清華大學、中南大學,以及中國電子科技集團第十五研究所,核心作者把 ReMMDBench 同 ReMMD-Agent 一起公開,方向很明確:用較接近真實網絡帖文的方式,檢查圖文混合內容中的 misinformation。這個 GitHub 項目屬於研究原型加評測代碼集合,主要用來重現三個 multimodal misinformation detection agent 系統在 ReMMDBench 上的結果,並比較它們怎樣做判斷。

現有做法常把多模態假資訊檢測收窄成單圖、二分類,或者一次過把整段文字與圖片丟給模型判斷;作者認為這種 fixed-pass 判斷方式難以處理長敘事、多張圖片、跨語言與部分真實內容。這個項目因此提出一套以 ReMMDBench 為核心的 agentic 驗證路線:Baseline 1 是 3-stage MMD-Agent,Baseline 2 是 MCTS-based 5-verdict + 8-taxonomy agent,而主系統 ReMMD-Agent 則用 atomic decomposition、RAG(Retrieval-Augmented Generation)與 multi-expert judge,把結論建立在可追蹤的證據狀態上。

跟同類方法相比,ReMMD-Agent 的取向不是只追求一次答中,而是先把帖文拆成 atomic claims、image observations、text-image bindings,再檢索 multimodal evidence,之後重用 persistent memory,減少重複工具呼叫。這種設計的取捨很清楚:流程更長、配置更多,但換來較好的可解釋性,也更適合處理 five-way L1 veracity labels、8 個 L2 distortion labels,以及 multilingual multi-image 場景。

安裝與測試思路也相當具體。三個子項目各自有 requirements.txt、設定檔與啟動腳本;要先把資料根目錄指向 ReMMDBench,再在 .yaml.env 內填入模型端點與金鑰佔位內容,之後可先用 mmd-agent/test_qwen.py 這類健康檢查確認後端可回應,再跑各自的 evaluation scripts。倉庫已附上 Qwen-family 後端的保存結果與 artifacts,包含 Qwen 4B、9B、27B,亦明確標示 temperature = 0.0、LLM caching 與預建 RAG index,方便重現 headline numbers,而不必由零開始建立整套流程。

  • 主系統:ReMMD-Agent,核心結構是 atomic decomposition + RAG + multi-expert judge
  • 對照系統:3-stage MMD-Agent 與 MCTS-based t2-agent,方便看不同 agent 設計的取捨
  • 資料與標註:ReMMDBench 有 500 samples、2,756 images、5-way L1 與 8 類 L2 標籤
  • 相關模型:Qwen-family 4B / 9B / 27B;首頁亦提到 GPT-5.2 曾用於 leaderboard
  • 較適合的情境:研究團隊、事實查核流程設計者、多語內容審核與 agent benchmark 比較

性能方面,倉庫重點是重現論文中三套系統在 500-sample ReMMDBench 的結果,而不是提供一個即裝即用的線上服務。它較適合拿來做 benchmark 驗證、分析不同 agent pipeline 的表現,或者研究 evidence reuse 對多模態判斷有幾大幫助;要直接放進產品,仍要自行補回資料接入、服務封裝與更穩定的推理基建。

GitHub: https://github.com/DANG-ai/ReMMDBench-Agent

項目主頁: https://dang-ai.github.io/ReMMD/

Categories: 清華大學, 上海人工智慧實驗室, Agentic, RAG, 視覺模型, 多模態模型, Qwen, API, Image, 框架, 工具, 線上服務, Python, , 安全, 深度學習, 中國

Page 7 of 21
1 5 6 7 8 9 21