XR Blocks:把構想變成可互動空間

先在電腦試玩,甚至可戴上頭戴裝置驗證互動,空間應用原型不必一開始就靠硬件測試。

Og image

想製作可伸手操作的立體教材或遊戲原型,XR Blocks 可配合 Gemini,把文字描述轉成延展實境(Extended Reality,XR)應用;它是開源框架,不是獨立模型。

框架以 WebXR、three.js 及 LiteRT.js 為基礎,整合環境感知、手部互動與物理效果。配套工作流把程式範本和專用系統提示交給 Gemini,減少模型自行猜測介面。

Build XR without code: XR Blocks is now in Google AI Studio
  • 教學:製作可操作的幾何模型與物理實驗。
  • 設計:快速測試空間介面及手勢互動。
  • 遊戲:驗證物件與雙手、環境碰撞的玩法。

Google AI Studio 支援在瀏覽器內建立及預覽應用,毋須先安裝本地開發工具。電腦可用 Chrome 執行模擬器;沉浸式測試則需要 Android XR 頭戴裝置,例如 Samsung Galaxy XR,以及支援 WebXR 的 Chrome 136 或以上版本。

原連結未能讀取完整內文,本文以官方文件補充;文件沒有列出最低記憶體或顯示卡要求,不能據此保證所有電腦都能流暢運行。
項目主頁

Categories: 開源, 模型, Google, Gemini, 框架, 教學, 工具

oMLX:高效能推論伺服器

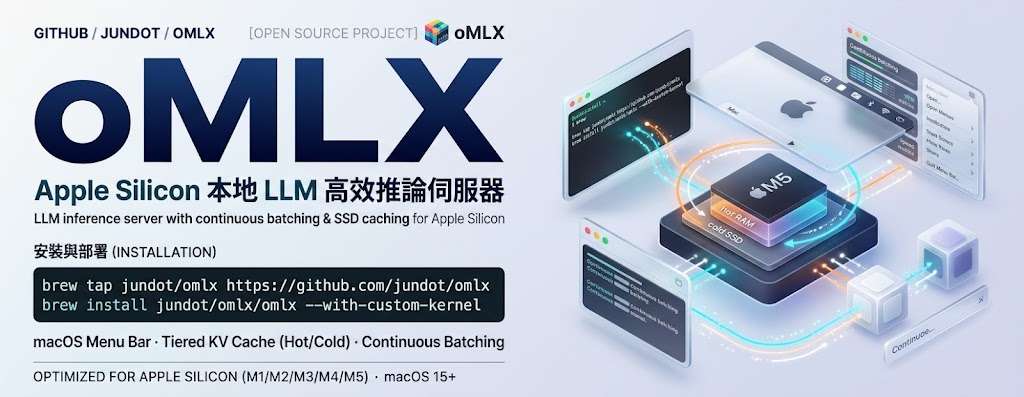
當搭配如 Claude Code、OpenClaw、Hermes Agent 這類每輪都發送巨大 Context / Tool Transcript 的 Coding Agent 時,oMLX 能直接命中快取,大幅縮短每輪等待時間。

oMLX

在 Mac 跑編程助手,oMLX 可讓常用模型常駐記憶體,並從選單列管理服務。能使用 Mac 原生 MLX 的吞吐與批次處理。

它以連續批次處理(Continuous batching)配合分層鍵值快取(Key-Value cache,KV cache):常用區塊留在記憶體,冷資料以 safetensors 格式存入固態硬碟(SSD)。後續請求的前綴吻合便可重用,伺服器重啟後亦能恢復,但不代表任意改寫上下文都能免除重算。

  • 可設定上下文長度限制。
  • 記憶體不足時,按最近最少使用(Least Recently Used,LRU)策略移出模型。
  • 管理介面支援手動載入及卸載模型。

硬件需 Apple Silicon Mac,並為模型及快取預留記憶體與 SSD 空間;來源未列最低容量、模型清單或具體測速,不能據此保證大型模型的速度。

安裝可從 Releases 下載 .dmg,拖入 Applications,並支援程式內更新。需要反覆處理相同上下文的編程工作較能受惠;SSD 快取節省重算,卻不能取代模型推理所需的記憶體。

GitHub

Categories: 開源, 模型, 工具, Mac, 編程, Anthropic, 蘋果

Work Agents 將數碼工作拆成可驗證成果

跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。

Work Agents: Systems, Capabilities, and Optimization

當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。

研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。

你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。

  • 整理代理系統、訓練方法、環境與記憶研究
  • 涵蓋五類數碼工作及相關評測資源
  • 比較模型、執行框架及兩者的協同優化
  • 以可驗證、能供下游使用的成果作評估焦點

產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫

Continual Learning Exam:測試 AI 能否把工作經驗帶到下一項任務

AI 助理完成一項工作後,能否記住檔案、工具、規則和偏好,並在後續任務派上用場?Continual Learning Exam 以跨五個階段的專業工作流程測試這種能力。

Continual Learning Exam — CLE

完成眼前任務不代表 AI 助理學會了經驗:它還要在後續工作中找回先前接觸過的檔案、工具、規則或使用者偏好。Continual Learning Exam(CLE)是一套持續學習評測基準,透過相連的專業任務,檢驗代理能否累積並重用這些資訊。

每項任務分成五個相連階段,後續階段可能需要運用先前累積的知識。完整基準涵蓋 12 個領域、89 種專業角色及 120 項由 50 多位領域專家撰寫的任務,共有 600 個階段;CLE Lite 則提供 20 項任務及 100 個階段,並公開任務卡、輸入檔案和執行環境,方便研究團隊先行測試。

CLE 提供兩種評測方式:Direct 讓代理直接執行全部五個階段;CLE Trial 1 和 Trial 2 則要求代理通過當前階段,才繼續前進,Trial 2 另加入診斷回饋及一次修訂。這個安排能比較代理在不同流程下的完成情況,也能觀察回饋是否改善結果,但不應把單次任務得分直接視為代理已具備穩定、通用的長期學習能力。

公開結果中,最佳配置完成了 47.7% 的階段;加入診斷回饋和一次修訂後,完成分數的中位增幅為 5.3 個百分點。這些數字反映任務完成度仍有明顯提升空間,也提醒使用者把評測結果視為比較代理配置的依據,而非對日常工作成效的保證。

CLE 適合研究代理記憶、工具使用與跨任務學習的團隊,也適合評估專業工作流程的開發者。可以先用 CLE Lite 的任務套件和 Harbor 執行環境測試代理,再按需要比較 Direct、Trial 1 與 Trial 2;完整基準、排行榜及研究論文則可用來進一步查看任務分布和評測結果。

  • 以五個相連階段檢驗經驗能否在後續工作中重用。
  • 完整基準涵蓋 120 項任務、12 個領域及 89 種專業角色。
  • CLE Lite 提供 20 項任務與 100 個階段,可先行測試。
  • Trial 2 加入診斷回饋和一次修訂,最佳配置完成 47.7% 的階段。

項目主頁 · GitHub

Categories: 開源, 工具, Dataset 數據集

Continual Learning Exam:測試 AI 能否把工作經驗帶到下一項任務

AI 助理完成一項工作後,能否記住檔案、工具、規則和偏好,並在後續任務派上用場?Continual Learning Exam 以跨五個階段的專業工作流程測試這種能力。

Continual Learning Exam — CLE

完成眼前任務不代表 AI 助理學會了經驗:它還要在後續工作中找回先前接觸過的檔案、工具、規則或使用者偏好。Continual Learning Exam(CLE)是一套持續學習評測基準,透過相連的專業任務,檢驗代理能否累積並重用這些資訊。

每項任務分成五個相連階段,後續階段可能需要運用先前累積的知識。完整基準涵蓋 12 個領域、89 種專業角色及 120 項由 50 多位領域專家撰寫的任務,共有 600 個階段;CLE Lite 則提供 20 項任務及 100 個階段,並公開任務卡、輸入檔案和執行環境,方便研究團隊先行測試。

CLE 提供兩種評測方式:Direct 讓代理直接執行全部五個階段;CLE Trial 1 和 Trial 2 則要求代理通過當前階段,才繼續前進,Trial 2 另加入診斷回饋及一次修訂。這個安排能比較代理在不同流程下的完成情況,也能觀察回饋是否改善結果,但不應把單次任務得分直接視為代理已具備穩定、通用的長期學習能力。

公開結果中,最佳配置完成了 47.7% 的階段;加入診斷回饋和一次修訂後,完成分數的中位增幅為 5.3 個百分點。這些數字反映任務完成度仍有明顯提升空間,也提醒使用者把評測結果視為比較代理配置的依據,而非對日常工作成效的保證。

CLE 適合研究代理記憶、工具使用與跨任務學習的團隊,也適合評估專業工作流程的開發者。可以先用 CLE Lite 的任務套件和 Harbor 執行環境測試代理,再按需要比較 Direct、Trial 1 與 Trial 2;完整基準、排行榜及研究論文則可用來進一步查看任務分布和評測結果。

  • 以五個相連階段檢驗經驗能否在後續工作中重用。
  • 完整基準涵蓋 120 項任務、12 個領域及 89 種專業角色。
  • CLE Lite 提供 20 項任務與 100 個階段,可先行測試。
  • Trial 2 加入診斷回饋和一次修訂,最佳配置完成 47.7% 的階段。

項目主頁 · GitHub

Categories: 開源, 工具, Dataset 數據集

Iching 64 Motion:《易經》六十四卦結構動畫

想看懂六十四卦如何生成、相互轉換,這部約三分鐘的動畫把卦象、數學關係與經典次序串成一條視覺線索。畫面和配樂均由程式生成,亦可自行預覽及渲染。

shot 8

由陰陽爻逐步生成六十四卦,再看卦象如何倒轉、互換和變化,iching-64-motion 把《易經》的符號關係整理成一部約三分鐘的知識動畫。它是以程式製作的動畫項目,處理的是如何把抽象卦序和結構轉成可觀看的畫面;內容聚焦符號系統,不提供占卜解讀。

全片分成七章,從邵雍「加一倍法」帶出六十四卦的生成,再以方圓圖、錯卦與綜卦、互卦、變卦、文王卦序、十二消息卦和京房八宮呈現不同關係。陰爻記作 0、陽爻記作 1,六爻卦可讀成六位二進制數;改變一爻,則可視為在六維立方體的頂點之間移動。這些呈現方式讓讀者能從圖像理解卦與卦之間的連結,而非只看靜態卦名。

畫面由 React、SVG 和 three.js 生成,Remotion 負責把場景渲染成影片;六十四卦、卦序等資料由程式推導,配樂則以 Python、numpy 和 scipy 合成,並按畫面事件安排聲音。項目沒有使用外部圖片、影片或音訊素材,視覺與音樂都能納入同一條可重現的製作流程。這對製作資料驅動動畫、教學影片或展覽內容的創作者,提供了可參考的做法。

本機預覽需要 Node.js 18 或以上;可在 Remotion Studio 預覽,再渲染 MP4;不生成配樂仍可預覽畫面。

  • 資料由定義推導生成,涵蓋 384 爻及本卦、之卦的 4096 種組合。
  • 可預覽並渲染影片;生成配樂需要額外安裝 Python 科學運算套件。

GitHub

Categories: 開源, AI productions, Video, Image, Audio, 教學, 工具, Content Creator, Python, 動畫, 音樂

magpie:通過本機閘道,把不同 AI 編程代接上同一模型

Claude Code、Codex、Gemini CLI 等代理可以各自改用其他模型或訂閱帳戶;配額用完時,Magpie 亦可按設定切換帳戶或路由到其他服務。

magpie

想讓 Claude Code 用 Kimi、Codex 用 DeepSeek,或者讓 OpenCode 使用 ChatGPT 訂閱模型,不必逐個代理手動改一堆設定。Magpie 是一款跨平台工具,透過本機閘道統一管理模型與供應商,並從選單列切換代理設定;它改動的是各代理自己的關鍵設定,並非把不同代理合併成同一個程式。

它支援 API key、本機模型,以及 Claude、ChatGPT、Copilot、Gemini、Grok 等已登入帳戶。Claude 整合會呼叫本機的 Claude CLI,並透過 MCP(Model Context Protocol)橋接代理工具;ChatGPT 訂閱模型則可供其他代理使用。這讓使用者能沿用熟悉的代理工作流程,同時更換背後的模型來源。

配額耗盡時,Magpie 可改用同一供應商的另一個帳戶;若設定了路由群組,也可轉往其他模型或供應商。沒有備用帳戶或路由群組時,錯誤仍會傳回代理,因此不中斷並非無條件保證。隱私遮罩則須在設定中手動開啟,啟用後會在請求離開本機前遮蔽提示中的金鑰、密碼和電郵地址,再把內容還原到回覆。

  • 從同一份清單為不同代理選擇模型,減少逐個修改設定的工作。
  • 可混用雲端 API、本機模型和已登入的訂閱帳戶。
  • 帳戶或路由備援可降低配額用盡造成的中斷,但須先配置可用的後備路徑。
  • 隱私遮罩預設關閉,敏感資料保護需自行啟用。

對同時使用多個 AI 編程代理、需要管理不同供應商帳戶的個人或團隊,Magpie 可集中處理切換與備援;若只用單一帳戶,或不希望工具改寫代理設定,收益會較有限。項目支援 macOS、Windows、Linux、Docker 和 Termux;提供下載與文件,但所給資料未列出效能測試或延遲數據,選用前宜確認所需代理、模型與登入方式均在支援範圍內。

GitHub

Categories: 開源, MCP, 模型, 微軟, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Linux, 編程, Anthropic, Kimi, MiniMax

AstrBot:把聊天平台接入大模型

AstrBot 將聊天平台、模型服務與插件串成一個可管理的 AI 助手項目,適合想自建聊天機械人的團隊。

Featured|HelloGitHub

想在 QQ 等聊天平台加入 AI 對話、插件功能和自訂服務,AstrBot 提供的是一套可自行運行的開源框架,而不是單一模型。項目以 Python 3.12+ 為基礎,將訊息接收、模型呼叫及擴充功能放進同一個工作流,減少團隊自行黏合多個服務的工作量。

簡單講係一個「將 AI 接入通訊軟件」嘅開源平台:你可以將雲端或本機大模型,接駁 Telegram、Discord、LINE、Slack、企業微信等平台,變成可以聊天、查知識庫、使用工具同執行任務嘅 AI 助理。佢本身唔係大模型,而係負責整合模型、訊息平台、插件同 Agent 功能。

  • 適合建立個人助理、社群機械人及內部聊天工具
  • Python 生態方便加入自訂插件與外部 API
  • 支援多語言文件,方便跨地區協作
  • 需要自行處理模型服務、平台帳戶及運行環境

相比直接使用封閉式聊天服務,AstrBot 把控制權交回管理者,換來較高的設定彈性和維護成本。它較適合有基本 Python 能力、需要掌握資料流向,或希望按團隊需求改造聊天機械人的使用者;只想即時開啟對話服務的人,則要先考慮環境配置和平台整合工作。

項目本身屬於聊天機械人框架,實際解決的是訊息平台與大型語言模型之間的整合問題。項目提供版本、文件、路線圖及 Issue Tracker 等入口。

GitHub

Categories: 開源, 模型, API, 框架, 工具, Python

detectorscope:DeepMind AI 文字偵測器,逐句交代判斷依據

AI 文字偵測常被質疑只給標籤、看不到理由;DetectorScope 會列出影響判斷的文字特徵,並標示它們出現的位置。

DetectorScope demo

當文字被判定為 AI 生成,DetectorScope 會進一步指出哪些字詞或句式推高了判斷分數,並讓使用者在文字上查看相關片語。這個開源工具把黑箱 AI 文字偵測器轉成可檢視特徵的系統,也能用來分析不同語言模型的寫作習慣。

它先在偵測器的 residual stream 上訓練稀疏自編碼器(SAEs),為特徵產生描述和驗證分數,再篩選合格特徵,交由稀疏分類頭作出預測。結果會列出 AI 機率、特徵描述及各特徵的影響方向;示例中,「about」作介詞和重複語句提高 AI 分數,而口語填充語則降低分數。

你可以先到 Hugging Face Space 試用示範,開發者則可透過 Python 套件載入預訓練的 liamdugan/detector-scope 模型,提交文字並讀取特徵結果。亦把自有黑箱偵測器轉成可審核版本的流程,但沒有提供可據以比較準確率或誤判率的評測數據。

  • 判斷結果附有可讀特徵,並可定位相關文字片段。
  • 特徵描述及驗證分數用來篩選分類器採用的訊號。
  • 可用於檢視模型文字傾向,或研究偵測器如何作出判斷。
  • 特徵解釋有助審查結果,但不能單憑解釋證明偵測準確或公平。

對研究文字偵測、模型行為或內容審核的團隊而言,DetectorScope 提供了比單一 AI 標籤更可追查的分析線索。由於資料未列出不同領域、語言或改寫文本上的可靠度,涉及學術紀律或其他高風險決策時,仍應配合人工審核,避免把偵測分數當成定論。

GitHub

Categories: 開源, 模型, 模型訓練, Google, 工具, Python

DirCast-code:AI 同時導播與解說,直播一手包辦

DirCast 每秒查看 Dota 2 十名英雄的鏡頭,自行選擇播出畫面並配上解說。它把導播與主播工作交給同一個模型,但目前評估仍集中於有限的職業賽事。

DirCast

直播觀眾看到的畫面和聽到的解說,通常由導播與主播共同決定;DirCast 嘗試讓 AI 每秒查看十名英雄的原始鏡頭,選出播出畫面,再按該畫面決定何時發言及說甚麼。這個研究型工具以 Dota 2 賽事為場景,處理的是如何在比賽仍在進行時,同步完成選鏡和解說,而非只替已剪好的直播影片配音。

DirCast 使用單一串流影片語言模型 Qwen3-VL-8B,並以 LoRA 微調。模型先低解像度掃描各英雄鏡頭及遊戲狀態,再由導播模組決定維持現有畫面或切換;選中的鏡頭會再以高解像度讀取,供發言判斷和文字生成。這種安排把全場掃描與播出畫面的細節理解分開,也讓模型的解說跟隨自己選出的畫面。

模型不會永久保留所有低解像度鏡頭:這些畫面只在設定的時間窗內留在上下文,播出畫面、事件和已生成的說話則會保留,令處理長賽事時的上下文成本受控。訓練時加入受擾動的播出流程,讓模型練習從自己選錯鏡頭後恢復;事件標記則協助它把擊殺等值得呈現的時刻納入選鏡考量。控制切鏡與發言的門檻亦會按頻率調節,避免節奏過密。

研究資料集包含 27 場職業 Dota 2 比賽,記錄每名英雄的鏡頭、人類導播選擇及主播解說。示範涵蓋兩場留出比賽,展示模型切到鏡頭外發生的交戰並作出評論;但這些例子不足以證明它已能應付不同遊戲、直播延遲或長期穩定運作,現階段較適合研究團隊測試自動化直播製作,而非直接取代真人轉播團隊。

  • 每秒掃描十路英雄鏡頭,並自行選擇播出畫面。
  • 同一模型負責導播決策、發言時機及解說文字。
  • 低解像度畫面會過期,播出內容與事件記錄則留在上下文。
  • 訓練資料來自 27 場職業 Dota 2 比賽,公開示範展示兩場留出賽事。

GitHub 儲存庫提供模型、資料處理與賽事狀態相關程式碼;研究人員可據此檢視流程或測試模型。儲存庫資訊未列出完整安裝步驟、硬件需求或可直接重現的評估指標,因此部署成本與相對真人導播、主播的穩定差距,仍需更多測試才能判斷。

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, 模型, 模型訓練, Qwen, OpenAI, Video, 工具, 庫, Dataset 數據集, LoRA

Page 3 of 28
1 2 3 4 5 … 28