答對鼻咽癌知識題,未必代表模型能制定合適方案,或隨病情變化修正判斷。NPCBench 是一套醫療 AI 評測基準,涵蓋指引知識、影像判讀、臨床決策及專科諮詢,嘗試檢驗模型能否把這些能力連接到病人的診療流程中。
不少醫療基準把能力拆成知識問答、單張影像判讀或靜態病例題,逐題計分;這種方式較難看出模型能否整合多模態證據,或在病程改變時更新決策。NPCBench 改以近似專科培訓測試,並加入縱向病例與 CarePath 評估,要求同一病人的病理、MRI T 分期及各項照護決策全部正確,才算聯合成功。
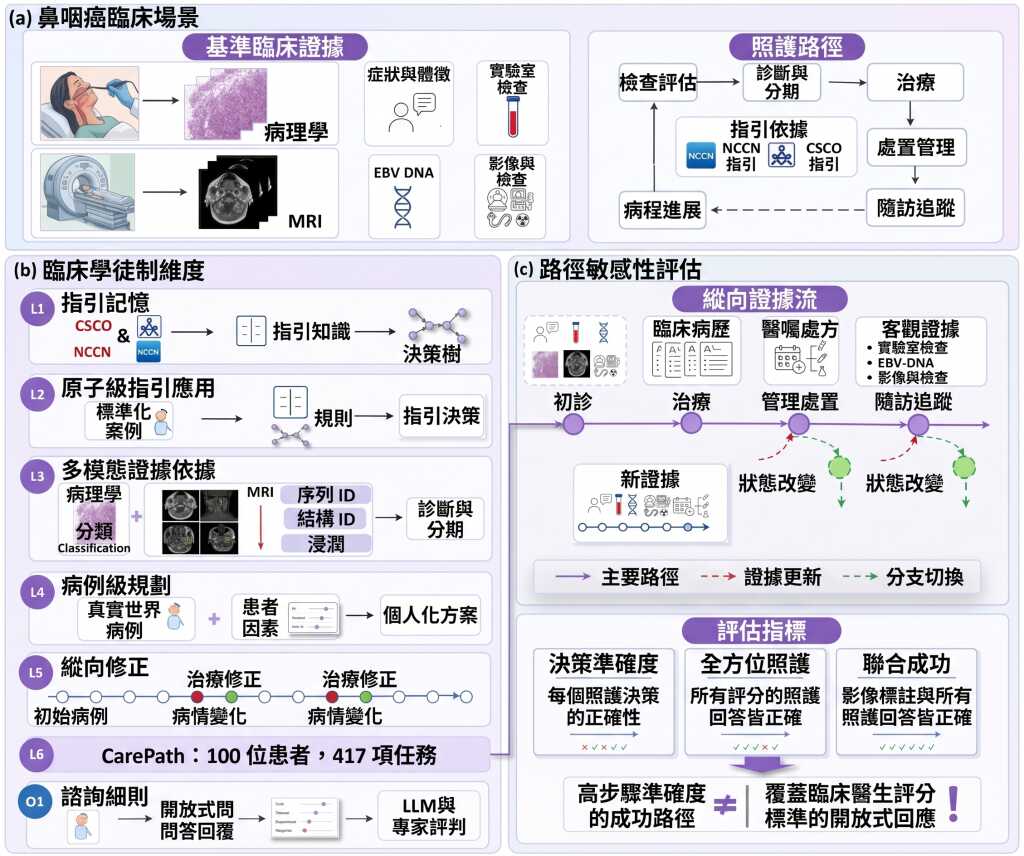
資料集包含 4,777 項分階段及諮詢題目,另有 100 名病人的 CarePath 病例,共 417 項診斷與照護評分任務。項目亦提供 MRI 延伸評測指南、醫師一致性校準,以及可用已發布預測結果重現主要結果表的 CPU 指令;研究比較了 30 個模型,並以配對控制檢視證據依據、病程中的判斷修正及諮詢評分。
結果反映單項能力與完整診療流程之間存在落差:在 21 個多模態模型中,嚴格 CarePath 聯合成功率最高為 23%。這令 NPCBench 適合研究醫療模型評測、腫瘤照護工作流程及多模態臨床推理的團隊;但它聚焦鼻咽癌,分數不能直接推廣至其他疾病或真實臨床成效。
- 評測範圍由指引知識延伸至影像、決策、病程追蹤及專科諮詢。
- CarePath 以病人為單位,要求多項診斷與照護答案同時正確。
- 研究比較 30 個模型,並納入配對控制與醫師一致性校準。
- 嚴格 CarePath 評估中,多模態模型最高成功率為 23%。
使用者可按任務下載相應題目,為每題提交模型答案,再以提供的評分工具輸出分數;Python 3.10 或更新版本即可執行。多選題需要提交完整選項集合,L1、L2、L4 等任務有各自的題目檔與評分命令,MRI 延伸測試則另有資料處理及推理設定指南。