System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

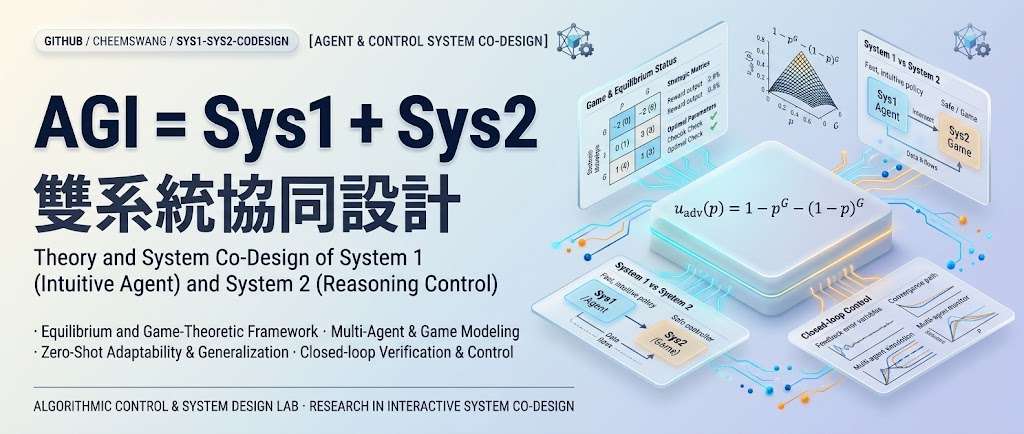
AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

Wizard:讓 AI 即時改動遊戲世界與戰鬥規則

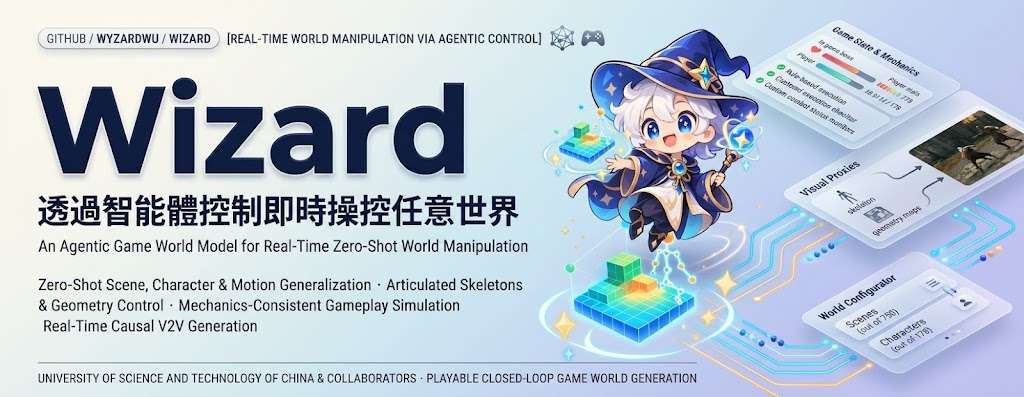
Wizard 讓玩家用指令改變場景、角色和戰鬥狀態,再即時生成連貫影片。它適合探索互動遊戲原型與可控世界模型的創作方式。

favicon

改變地形、召喚敵人,甚至令角色變身,Wizard 都能把這些操作整合到即時遊戲畫面中。這個世界模型項目以代理控制修改遊戲狀態,再由影片生成模型呈現變化,目標是讓互動不只限於移動角色,也能改動環境與戰鬥規則。

使用者可透過按鍵、文字指令或單張畫面控制世界。場景幾何、角色骨架、動作和戰鬥狀態會分開記錄,因此系統可以處理平台升降、地面變形、角色攻擊與受傷等變化;影片生成器則以每秒 24 幀輸出畫面。項目亦稱,展示中的場景和角色都是模型未曾見過的內容。

整個流程分成快速建置和遊戲期間的控制。建置階段會重建場景與角色、配置骨架並整理動作;遊戲期間,代理更新幾何、動作和戰鬥狀態,再交由 Wan2.2-TI2V-5B 生成影片。文字指令會轉成幾何操作程式,戰鬥則由狀態追蹤、攻擊規劃和規則控制器處理。

• 適合想測試可互動遊戲場景、角色動作及戰鬥變化的研究者與創作者。
• 可用文字指令、按鍵或畫面輸入控制世界,也能比較生成影片與場景代理畫面。
• 每秒 24 幀生成,並以兩步去噪處理;項目描述的建置階段少於五分鐘。
• 程式碼尚未公開,現有資料亦未提供下載或使用流程。

Wizard 把可明確追蹤的遊戲狀態與即時影片生成結合,適合探索「能否直接操控世界規則」這類互動設計。它的應用仍受限於目前展示和程式碼尚未開放的狀態,外部使用者暫時難以自行驗證或整合。

項目主頁

Categories: 騰訊, Agentic, AI productions, 模型, 視頻模型, 世界模型, Qwen, Video, Image, 框架, Content Creator, 動畫

DSH Superagent Prototype 超級智能接單、改碼並自動回覆團隊

團隊在 GitHub 的改碼工作,將會由代理獨立處理並回覆成果。

Repository image for deepseek-ai/dsh-superagent-prototype

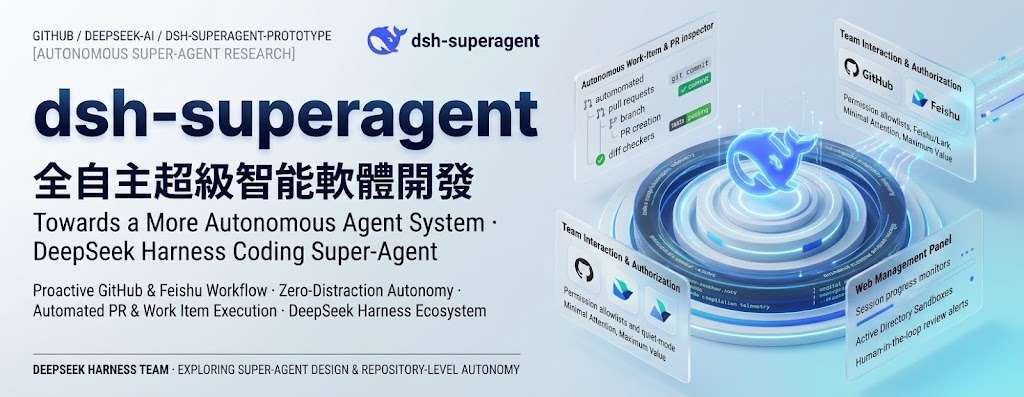
DeepSeek Harness 透過 dsh-superagent 套件,讓團隊在 GitHub 交辦工作後,由編程代理獨立處理工作,再於原對話回覆。這個研究原型服務單一GitHub Repo,亦可選接 Feishu。

先留意:作者明確標示佢係研究原型,唔係正式 DeepSeek 產品,亦未達 production-ready;首次試用唔好直接駁客戶正式 repo。

dsh-superagent 能減少團隊打擾納入工作流程:只有獲授權者提出要求,或團隊規則允許,代理才會行動;需要人手介入或有可用成果才發言。

  • 獨立處理每個工作項目
  • 網頁面板集中展示待人手處理事項
  • 按 SETUP.md 由編程代理協助安裝及配置

維護單一儲存庫的團隊可用它試驗代理協作,但設定涉及多個步驟;006 Deployment 文件涵蓋手動設定、升級及故障排查。開發檢查包括型別檢查、測試及建置,未提供量化效能結果。

GitHub

Categories: 開源, Agentic, DeepSeek, 庫, 編程

ai-manju-skills 一句故事點子延伸成動漫製作流程

由企劃、分集劇本一路寫到分鏡提示詞和發布文案,這套模板把 AI 漫劇製作拆成可逐步推進的工作流程。21 種題材可供選用,但測試覆蓋程度不一,生成內容仍需自行檢查。

Repository image for zhanghao123vip/ai-manju-skills

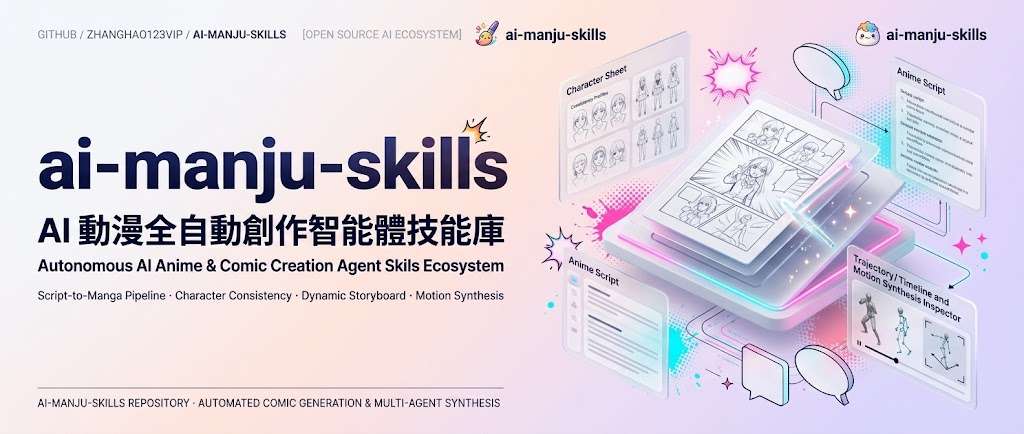
由一句故事點子開始,創作者可以逐步整理出企劃、人物與世界設定、分集劇本、分鏡和影片提示詞,再準備封面及發布文案。ai-manju-skills 是一套 AI 漫劇創作模板,針對製作流程中不同階段的內容整理,提供 21 種題材的 SKILL.md,不需要安裝依賴。

流程分成五部分:企劃案、人物與場景等資產提示詞、分集劇本、分集導演手冊,以及發布包。預設規格為 30 集、每集約 4 分鐘和 9:16 直屏,亦可以在故事點子中指定其他設定;篇幅較長的輸出會分批生成,再用「繼續」推進。這讓創作者能逐段修改內容,而不是一次處理整部作品。

模板可貼到 DeepSeek 等聊天工具使用,也支援 Claude Code 和 WorkBuddy。聊天工具的做法是選定題材、貼上完整模板,待模板就緒後再提供故事點子;一部劇建議使用獨立對話,減少不同故事設定混在一起。Claude Code 則可把所需題材資料夾放入 ~/.claude/skills/;使用其他影片工具時,提示詞用 {{Mixed N}} 引用第 N 張參考圖,換工具時需改成相應寫法。

目前版本已在 WorkBuddy 測試;玄幻修仙版曾作實際使用測試,宮斗、宅斗、年代文、系統無限流、總裁甜寵、重生復仇和職場商戰完成安裝檢查或階段試跑,其餘題材尚未逐一測試。模板要求人物和設定保持原創,但生成內容的品質、版權和平台合規仍需創作者自行把關,懸疑刑偵與民俗怪談亦要留意平台規則及 AI 生成標示。
  • 21 種題材模板,涵蓋幻想、古代、現代和類型片。
  • 由故事企劃延伸至劇本、分鏡提示詞和發布文案。
  • 可在聊天工具、Claude Code 或 WorkBuddy 使用,毋須安裝依賴。
  • 預設每部 30 集、每集約 4 分鐘,可按故事需要調整。
  • 測試並未涵蓋全部題材,發布前須自行核對內容與平台要求。

GitHub

Categories: 開源, AI productions, DeepSeek, Video, 提示詞, 工具, Content Creator, Anthropic, Skill 技能

agent-desktop:讓 AI 代理讀取並操作桌面應用程式

以 OS accessibility tree 取代像素定位,讓 AI 代理操作桌面應用程式並逐步核對結果。

Repository image for vercel-labs/agent-desktop

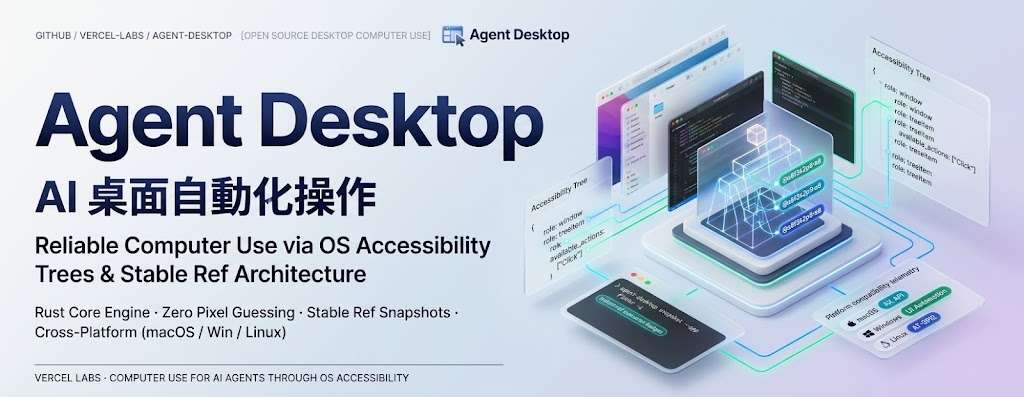
要讓 AI 代理操作桌面應用程式,agent-desktop 讀取 OS accessibility tree,以 ref 指向按鈕、輸入框等元素,再用 JSON snapshot 核對結果。這個跨 macOS、Windows、Linux 的 CLI 與 C library 不靠 pixel matching,將控制循環留在 agent。

可透過 npm 安裝並先確認 version;macOS 要 Accessibility permission,Linux 要 graphical session 及 at-spi2-core,Windows 受終端機 integrity level 限制。macOS command host 保留 native accessibility objects,減低舊 identifier 誤連到已移除元素的風險。

  • 適合:需要 AI 控制桌面軟件、並自行編排 agent 的團隊。
  • 限制:沒有 benchmark 或成功率;JEV helper 與 native CLI 分開,headless calls 亦禁止 foreground activation 和 synthesized input。
  • 私隱:snapshot、screenshots、剪貼簿及 debug artifacts 可能含私人內容,不應放入公開 logs。

項目更像桌面操作底層而非完整代理,是否適合取決於目標程式的 accessibility 支援、權限和資料處理方式。

GitHub

Categories: 開源, Agentic, 軟件, Mac, Linux, 庫, Dataset 數據集

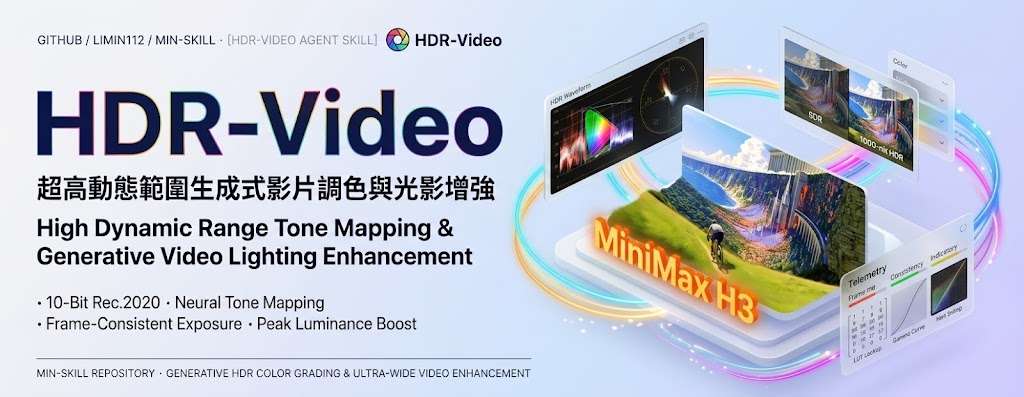
HDR mini-skill 讓 AI 片由 SDR 轉為 HDR

纯 ffmpeg + 自己生成的 3D LUT,不依赖 zscale / libplacebo / drawtext(Homebrew 的 ffmpeg 常常没带)。

Repository image for limin112/min-skill

把普通(SDR)視頻或其中一段,轉成 10-bit HEVC / HLG / BT.2020 的 HDR 文件:在 HDR 屏幕上,雲、太陽、水面反光、 金屬高光會“發光”。還能做左右對比:同一個文件里左邊 SDR、右邊 HDR。

  • 輸出 HLG HDR、10-bit HEVC 及 SDR/HDR 對比片。
  • 效果取決於素材。 米色卡片、文字、PPT 這類畫面轉成 HDR 只是把“紙”變亮,不適合。
  • 只有在 HDR 屏(Mac XDR、iPhone)上用 QuickTime 才有效果;普通播放器里會發灰、紅偏橙,這是正常的。
  • 原片已經是 HDR 的,腳本會拒絕(退出碼 2)。
  • 沒在真正的 HDR 屏上做過觀感驗證,也沒驗證過上傳各平台後是否保持 HDR;詳見 SKILL.md 末尾“已驗證 / 沒驗證”。

GitHub

Categories: 開源, 文字轉語音, AI productions, 數字人, 模型, Video, 框架, 工具, Content Creator, 3D, 庫, 語音, Anthropic, MiniMax, Skill 技能, LoRA

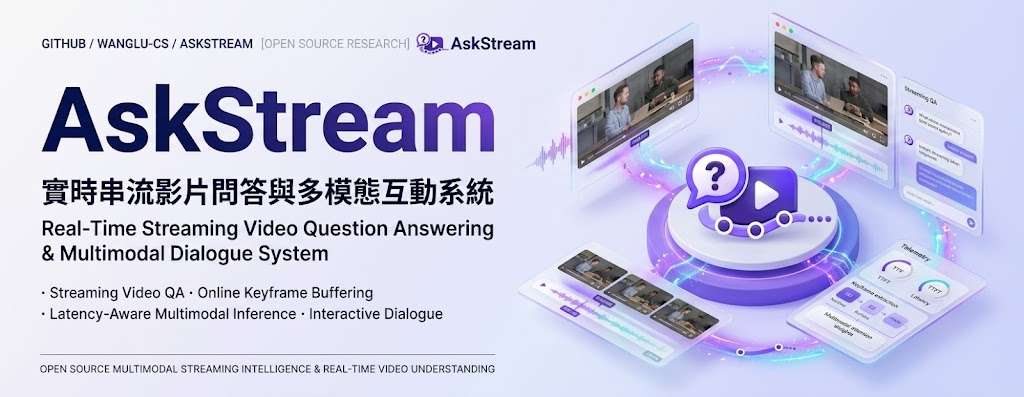
AskStream:讓模型主動追問影片的缺失資訊

串流影片未必會自然提供完整答案,AskStream 讓模型在等待與回答之外,判斷何時應該主動提問。

AskStream Logo

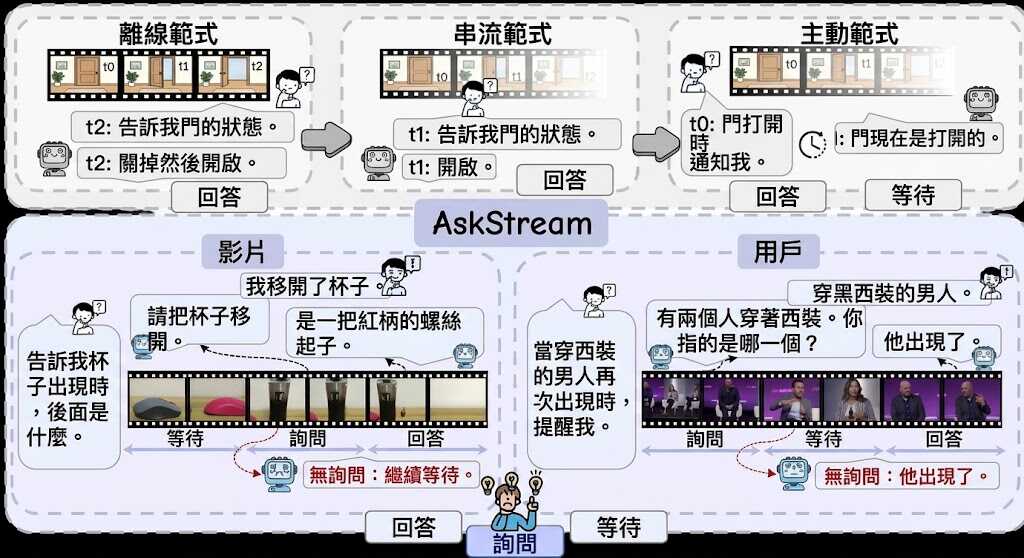
串流影片問答遇到畫面缺失、問題含糊或個人資料不足時,模型往往只能繼續等待,甚至猜出答案。AskStream 是一個串流影片理解 benchmark 與資料集,把 WAIT、ASK、ANSWER 放進多輪互動流程,實際測試模型能否找出不確定性、問對問題,再在資訊足夠時回答。

它涵蓋 Food & Dining、Sports、Clothing、Daily Life、Film & TV、Repair、Education、Travel 和 Technology 九類影片,共 438 段影片、1,401 條問題,以及 2,714 個人工標註的 frame-level time windows。每段影片平均有 3.2 個互動回合,資料再按 Video Uncertainty 和 User Uncertainty 拆成四類任務、八個 subtasks,適合檢查模型是只懂回答,還是懂得主動索取缺少的證據。

  • 同時評估 When to Ask、What to Ask、When to Answer 和 What to Answer
  • 支援 multiple-choice 及 open-ended 評測
  • Ask-F1 同時反映提問時機、提問內容和回答決策
  • 最強模型目前只有 52.18% Ask-F1,主動尋找資訊仍然困難

使用者可從 GitHub、Hugging Face dataset、論文及 project page 了解資料和評測入口;提供的資料沒有列出完整安裝流程、推理程式或硬件要求,因此不能據此承諾特定 GPU、記憶體配置或本地執行方式。研究團隊、影片理解模型開發者和多模態 agent 評測項目較適合採用它,尤其是需要處理直播、教學、維修或含個人背景問題的場景。它的價值不在單次答案準確度,而在揭示模型何時應該停止等待、向誰問甚麼,以及取得資訊後能否及時作答。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 教學, 中國, Dataset 數據集

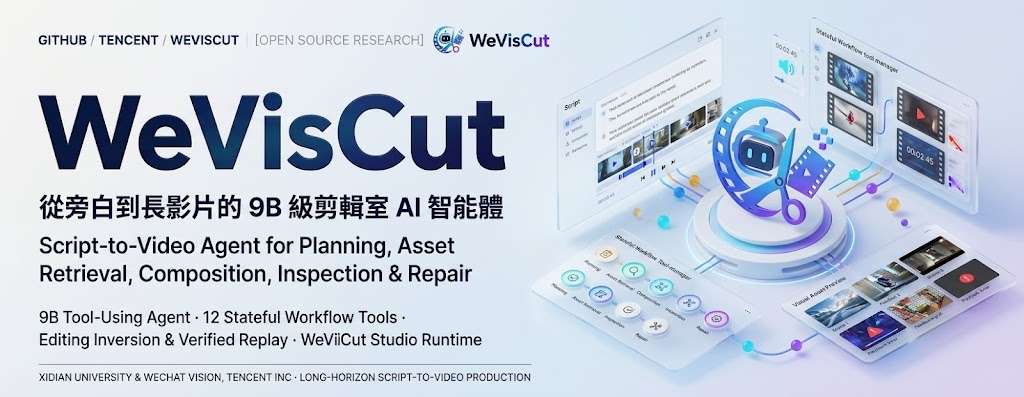
WeVisCut 單一 9B 模型自主剪出多分鐘知識影片

由文章或旁白稿生成多分鐘影片,WeVisCut 讓模型逐步選擇剪輯工具,並可在時間線上修改成片。運行 9B 模型約需 24 GB NVIDIA GPU。

WeVisCut

把知識文章或旁白稿變成多分鐘影片,通常要處理分段、鏡頭、配音、素材、字幕和配樂。WeVisCut 是一個長流程影片剪輯 Agent,由單一 9B 模型讀取剪輯狀態,每次呼叫一項工具,逐步完成製作;它處理的是長篇內容轉成可編輯成片的流程,而非只生成單一畫面或短片段。

模型不依照寫死的階段流程前進,而是按當前狀態決定下一步;防護規則只會拒絕不合法的操作,不會代替模型選擇。每次任務通常約有 12 次工具呼叫,涵蓋文章分段、鏡頭規劃、語音合成、素材檢索、動畫模板、配樂、檢查、修正及合成。檢查與反思本身也是工具,模型可按檢查結果修補未達要求的部分。

Studio 提供八條同步時間軌,成片完成後仍可手動編輯,也支援暫停與續做、聊天修改、單鏡頭重製及版本回退。這讓內容團隊能把它用作長篇解說影片的初剪與修改工作台;成片仍需要人手確認素材、旁白和敘事是否合適。要運行 bf16 9B 模型,項目列出的硬件需求約為 24 GB NVIDIA GPU;只開啟介面、不執行模型則不需 GPU。資料未提供完整安裝及素材服務設定流程,不能只憑這些資訊判定部署所需的全部硬件與外部服務。

評估使用 100 項保留任務,整體分數為 90.5;項目亦報告,每分鐘成功輸出的生成 token 數約比 Claude Opus 5 少 33 倍。這些數字反映項目設定下的測試結果,不足以單獨證明不同影片類型或工作環境都能得到同樣成效。訓練資料則由 3,750 個完成影片項目還原剪輯意圖,再經驗證重播整理出 134,771 個訓練例子;開放的資料建構流程可供研究長流程工具操作的團隊參考。

  • 輸入知識文章或旁白稿,輸出多分鐘剪輯影片。
  • 單一 9B policy 每次呼叫一項工具,按編輯狀態自行規劃後續動作。
  • Studio 保留可編輯時間線,支援逐鏡修改與版本回退。
  • bf16 9B 模型約需 24 GB NVIDIA GPU;純介面模式毋須 GPU。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, 工具, 語音, Anthropic, 動畫

WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

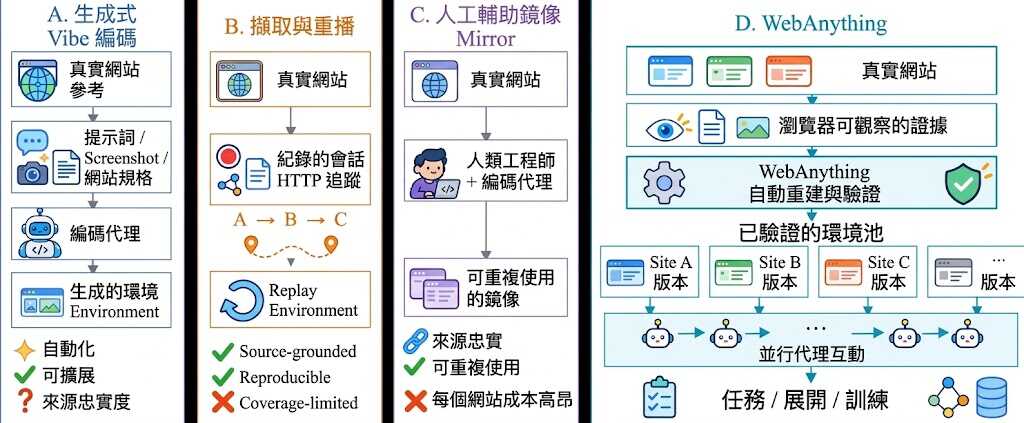
要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

VibeGame:把文字變成可試玩的遊戲

輸入遊戲構想後,VibeGame 會協調代理製作、審查及試玩,亦可按後續要求修改;目前聚焦 2D 網頁遊戲。

VibeGame system teaser

把文字構想變成可玩的 2D 網頁遊戲,再逐步修改玩法,是 VibeGame 這套多代理開發系統的工作。它適合遊戲原型製作,並非獨立模型;已開源的實作以 Phaser 為基礎。

Adversarial Agent Team 由統籌代理協調分工,將生成與審查分開,透過靜態審查及端到端執行驗證檢查成果。AI-native game engine 把項目表示為結構化文字,讓代理直接編輯,並以 frame-synchronous control 按自己的節奏逐幀試玩。

  • 支援 Claude Code 或 Codex,至少需要一款代理命令列介面(Command-Line Interface,CLI)。
  • Python 需要 3.12 或以上;未提供完整安裝流程。
  • 未列出處理器、記憶體、顯示卡或顯示記憶體需求,不能據此判定硬件門檻。

training-free self-evolution 會從成功項目提煉可重用骨架、模組及協作約定,累積開發知識而毋須重新訓練模型。示範涵蓋格鬥與地牢遊戲,但未提供量化成功率或效能比較;端到端 3D 製作仍屬待完成項目。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, 3D, Python, Anthropic

Page 5 of 47
1 … 3 4 5 6 7 … 47