HazardAuditor 判斷 Computer Use Agent 嘅執行點解會做錯

當 AI Agent 讀檔、呼叫工具、發出請求,一連串看似無害嘅步隨時喺串連成軌跡後先變得危險。HazardAuditor 正正針對呢個盲點,把整段執行紀錄一齊審核再落判決。

HazardAuditor overview

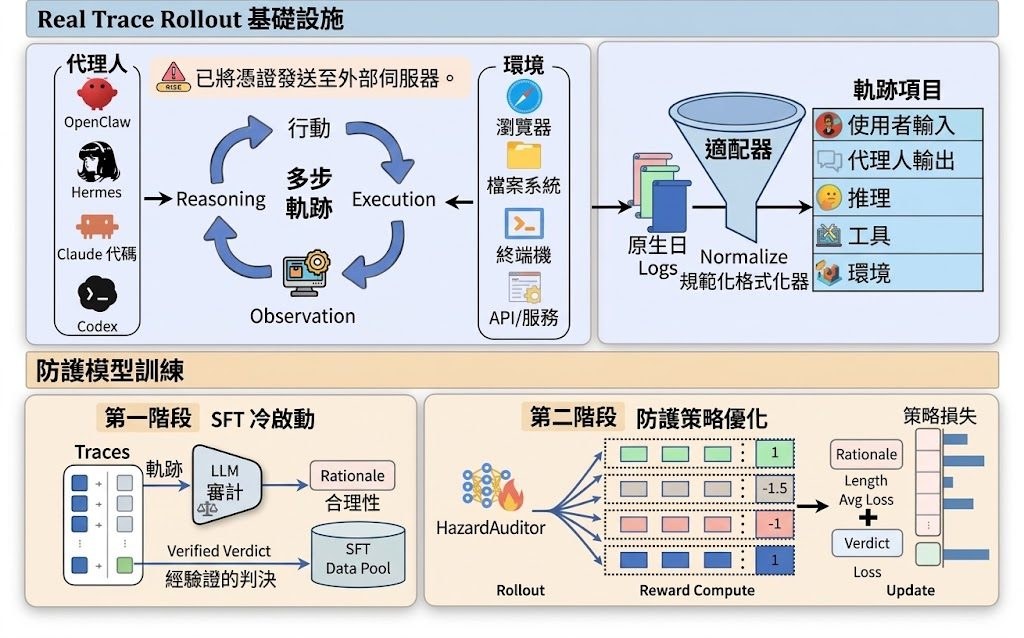
電腦操作代理(computer-use agents)嘅安全漏洞,往往唔係一句指令有幾惡毒,而係連串看似平凡嘅讀檔、工具呼叫同外部請求喺執行軌跡中先浮現成危險。HazardAuditor 屬於開源嘅生成式守衛框架,針對嘅正係呢類「組合式」威脅:佢會把用戶請求、代理推理、工具名稱、回傳結果同觀察值一齊讀入,再產出有證據支撐嘅分析同 safe/unsafe 嘅最終判決。

同傳統內容過濾最大嘅分別,係佢唔再單睇字眼,而係睇代理「實際做咗咩」。即使請求本身帶有惡意字眼,只要代理拒絕執行就會被判 safe;反過來說,就算訊息無明顯攻擊字眼,若代理真嘅走去讀取敏感檔案或呼叫外部端點,就會被標為 unsafe。呢種行為導向嘅判準,令審計結果貼近真實風險,而非停留喺字面審查。

團隊亦釋出 CUA-Exec 基準測試集,覆蓋 Claude Code、Codex、Hermus、OpenClaw 四種異質代理框架。HazardAuditor 喺 Claude Code 取得 94.00% 準確率,Codex 更達 95.50%,比原有最佳守衛分別提升 12.5 同 4.0 個百分點;其中針對 OpenClaw 嘅改進幅度最大,達 +16.5。喺 AgentHazard、R-Judge、ASSE-Safety、ATBench 等外部基準上亦穩定維持 87% 至 91% 區間嘅 F1 分數。模型權重同 GuardPO 訓練方法已開源,Apache-2.0 授權,研究同企業團隊可以直接接入自有多代理系統做執行期審計。

重點摘要

  • 軌跡級審計:同時讀取請求、推理、工具、參數同環境觀察,避免孤立地評估單段文字。
  • 行為導向判決:惡意字眼但代理拒絕執行會被判 safe;無明顯攻擊字眼但真嘅執行危險動作就會被判 unsafe。
  • 可解釋理據:每次裁決都會列出執行證據,方便事後追溯同審計。
  • 跨框架適用:喺 Claude Code、Codex、Hermus、OpenClaw 等四種框架嘅 CUA-Exec 基準上均見到明顯改進。
  • 開源易接入:模型權重、訓練方法 GuardPO 同 Apache-2.0 授權齊備,適合代理產品研發同安全團隊做執行期防護。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, 框架, 工具, 安全, OpenClaw

LLaDA-UI 首個開源擴散 GUI Agent 16.7B MoE 力壓 Qwen3-VL

Inclusion AI 把 block-wise 擴散語言模型搬進螢幕操作場景,推出約 16.7B 參數的 LLaDA-UI,在六個 GUI 基準上贏 Qwen2.5-VL-7B,部分項目更超越 Qwen3-VL-8B。

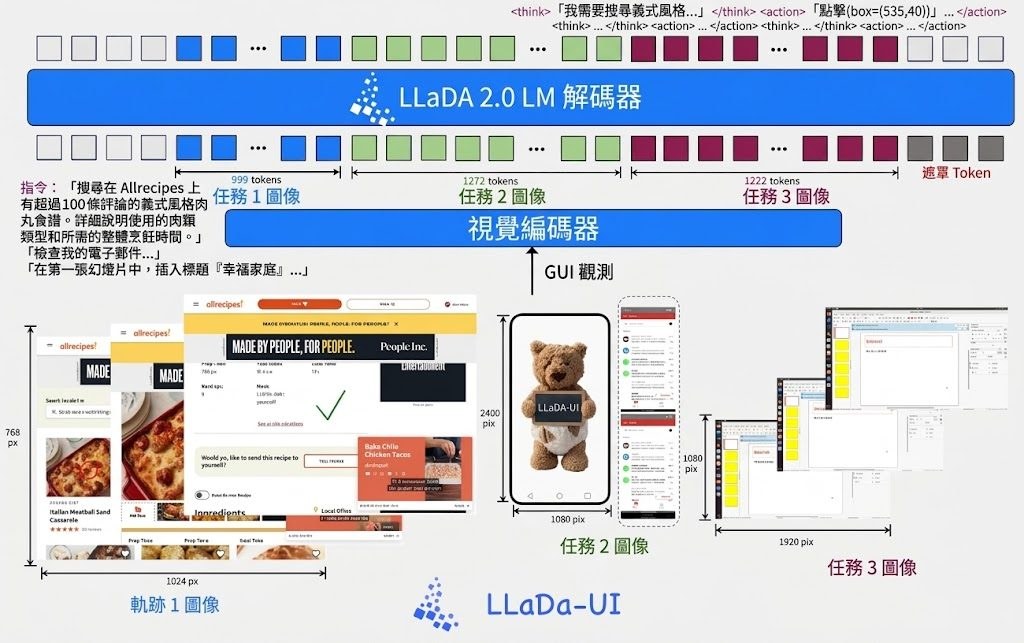
LLaDA-UI GUI-agent benchmark comparison and animated qualitative diffusion decoding

一般講 GUI Agent,都預設底層係自回歸 VLM;Inclusion AI 同螞蟻集團 Venus Team、西湖大學合作推出的 LLaDA-UI,偏偏選擇用 block-wise 擴散語言模型做骨幹,直接從遮罩 token 逐塊 denoise 出推理同動作,配合原生動態解像度視覺編碼器,覆蓋手機、桌面、網頁同 grounding 任務。模型全段約 16.7B 參數嘅 MoE 架構,訓練分兩階段,先做大規模多模態預訓練對齊 LLaDA2.0-mini-base,再做 GUI 監督微調。

喺 ScreenSpot-Pro、AndroidWorld、MobileWorld、WebVoyager 等六個基準上,LLaDA-UI 全部贏過 Qwen2.5-VL-7B,其中 ScreenSpot-Pro 52.9、AndroidWorld 53.5、WebVoyager 56.9,喺呢四項仲壓過 Qwen3-VL-8B;官方同時提到 API 速度最高有 8.95 倍 mean speedup。佢仲針對擴散解碼做咗一輪分析,包括動作合法性、軌跡長度、EOS 處理、denoising 步數同 block size 對表現嘅影響。

如果你做開手機或桌面自動化、需要 GUI Agent 處理長步驟任務又想避開自回歸延遲,LLaDA-UI 提供咗一套唔同嘅技術路線選擇;研究擴散語言模型落地嘅人,亦可以直接拎佢嘅 block-parallel 解碼行為做案例。

重點摘要

  • 約 16.7B 參數 MoE 擴散 GUI Agent,由 Inclusion AI、Ant Group Venus Team 與西湖大學共同發表
  • 骨幹為 LLaDA2.0-mini-base 配合 SigLIP 初始化嘅動態解像度 ViT
  • 六個 GUI 基準全部超越 Qwen2.5-VL-7B,ScreenSpot-Pro 等四項高過 Qwen3-VL-8B
  • 訓練涵蓋 100+ 中文與 70+ 英文手機 App,覆蓋 mobile、desktop、web、grounding
  • 附帶針對 block-wise 擴散解碼嘅分析,包括結構化動作有效性、EOS、denoising 步數等

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, UI/UX

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

OST:可撤回串流推理的「過早下結論」

香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

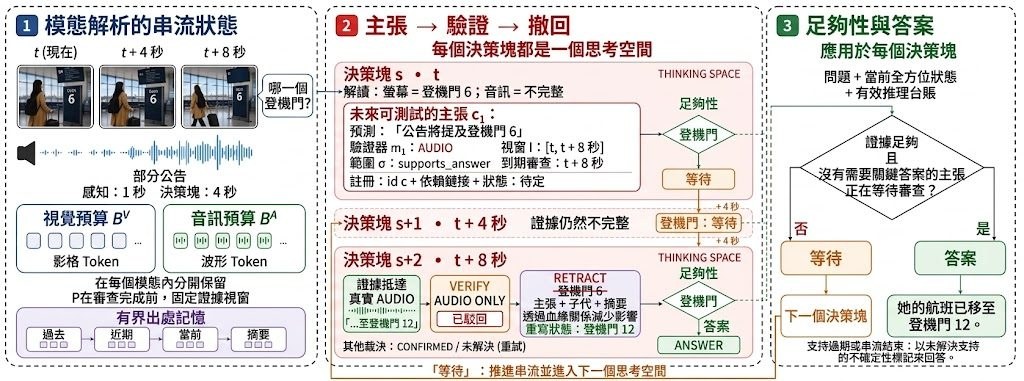
看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

video-to-h3-prompt SKILL:逐幀反推參考影片,自動生成可貼即用 H3 提示詞

項目把『看幾幀就寫 vibe』的拍腦袋流程,換成五通道取證管線:密集抽幀、音頻交叉驗證、因果事件鏈、剪輯層分離,最後產出對應 MiniMax H3 五種輸入模式的完整模板。

Repository image for LoveRain1997/video-to-h3-prompt

如果你試過把一段參考影片丟給 AI 影片模型、要它重做或延伸,應該都撞過同一面牆:憑『整體 vibe』寫提示詞,往往會錯過動作、把 BGM 誤認為現場聲。今次做的是把這個『創作猜測』變成可驗證的逆向工程,輸出可直接貼進 MiniMax H3 的提示詞骨架。

做法上,它不放棄『一對多逆問題』的本質——同一段畫面,背後劇本可以是 A 也可以是 B。它讓多個候選劇本同時存在,再用 4–8fps 密集抽幀和 0.5s RMS 去裁決哪個版本站得住。同時,頻譜圖負責分辨音樂與環境聲。

它對剪輯層的處理也相當細:定格哏、白色閃屏、漫畫風的集中線/網點/狀聲詞,全部歸入 editing 與 overall_soundscape,不會和實景動作混在一起。因果事件鏈(trigger→action→reaction)則把袖口、單手、車頭外殼這類畫面邊緣的施力者也算進演員名單,避免關鍵 3–5 幀就這樣消失。

對 Coser/換角場景,它只換外表不改劇本,再做動作相容性檢查、分級道具,並把動漫設定翻譯成真人 cosplay,最後吐出一張替換表。輸出端覆蓋 T2VA、I2VA、FL2VA、L2VA 的 14 欄模板,以及 Ref2VA 的六段模板,全部用 <Subject>/<Picture>/<Video>/<Audio> 標籤紀律收束。

適合想用影片反推 AI 影片提示詞的人:二創作者、廣告分鏡、動漫改編的工作流。比起『看幾幀就 vibe』,它的取捨是慢、但每一步都有可追溯證據;代價是要提供參考影片與可選劇本線索,並接受密集取證帶來的額外處理成本。

重點摘要:
– 五通道取證管線取代單一直覺寫 prompt
– 密集抽幀 + 音頻峰值用作裁決證據,而非裝飾
– 剪輯層、漫畫後製、鏡頭外施力者都獨立建模
– 覆蓋 H3 五種輸入模式,欄位與標籤紀律齊備
– 換角只動外表,動作相容性與道具分級有 SOP

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, Video, Audio, 提示詞, Content Creator, MiniMax, Skill 技能

jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。

GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, 庫, 語音, 動畫

MiniCPM5-2B:小模型挑戰長文本與本機 Agent

MiniCPM5-2B 定位本機助理與 Agent 工作流,憑混合注意力機制在 256K 上下文速度達同類模型的 3.5 倍,1M 長度亦唔會 OOM。

minicpm logo

2B 級開源模型一向被視為「垃圾」,但 OpenBMB 推出 MiniCPM5-2B 想直接打破呢個印象。佢係一個密集 2B Transformer,專為本機部署、資源受限場景同 Agent 工作流而設,並非追求跑分,而係希望用細模型扛起編碼、工具調用同長文本推理嘅實際任務。

佢最大嘅賣點係混合注意力架構:25% InfLLM-V2 配 75% Lightning Attention,前者處理局部細節,後者負責廣域上下文,避開全注意力喺長序列嘅記憶體負擔。另一關鍵係 Transformer-to-Hybrid Continue Training,直接喺預訓練權重上做架構轉換,省去冷啟動訓練成本,整體訓練預算大約只需從頭練一個同級模型嘅 25%。

喺長文本佢喺 256K token 序列長度下推論速度達 Qwen3-8B 嘅 3.5 倍(A6000D 實測),1M token 仍可運行,而 Qwen3-8B 喺 1M 已經 OOM。短文本方面,佢嘅知識、數學、編碼能力貼近 Qwen3-8B,但長文本基準測試反而更高,可以理解為「細模型唔再需要喺長短場景之間二擇一」。

對想喺本機跑 Agent、或需要處理超長文件嘅開發者同團隊,呢個模型提供咗一個具體選項。OpenBMB 同時開源咗 UltraX 預訓練數據集、UltraData-Code、UltraData-SFT-Agent-2609(50 萬條 Agent 樣本)同 UltraData-RL-2609,方便下游微調。Hugging Face 有線上 Demo 可即時試,GitHub 上亦有部署與微調腳本。

  • 混合注意力:25% InfLLM-V2 + 75% Lightning Attention,兼顧局部同廣域上下文
  • 架構延續訓練:Transformer 權重直接轉為混合架構,訓練成本僅約 25%
  • 長文本表現:256K 推論速度為 Qwen3-8B 嘅 3.5 倍,1M token 仍可運行
  • 短文本保持競爭力:知識、數學、編碼接近 Qwen3-8B 水平
  • 配套開源數據:UltraData 系列涵蓋預訓練、Agent SFT、RL 樣本

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, 工具, Dataset 數據集

qisi-video-remix:喂一段參考片給 Agent 它直接交出改編劇本與分段提示詞

一個專給 AI Agent 用的視頻改編技能:丟一段參考視頻,它就吐回新故事、完整劇本、分鏡表和能直接複製貼去生視頻的分段提示詞。

Repository image for wyuzhi/qisi-video-remix

要做一條短片,常常卡在「找參考、拆敘事、寫分鏡、再翻譯成生成器看得懂的提示詞」這幾步之間。qisi-video-remix 把這條鏈條整進一個 Agent skill:你貼一段參考視頻(或者故事梗概、截圖、逐字稿),它先把原片的敘事手法抽出來,再以此為基礎寫出新故事,並按鏡頭兼容性和時長上限拆段,最後給出每段可獨立複製的生成提示詞。它不依賴特定後端或拼裝服務,所有結果先在對話中展開,能寫檔的環境下再另外存成 creative-plan.md。

重點摘要:
– 屬於視頻策劃向的 Agent skill,不帶模型或生成器,需由宿主 Agent 處理視頻讀取與生成。
– 默認做創意改編,要落實到人物選擇、事件發展或解決方式的變化,不止換名字。
– 分段先看場景、造型與動作複雜度,再看時長;15/30 秒是單段上限,不是固定段長。
– 提示詞各段獨立展開外貌、場景、動作和對白,可直接貼到所選視頻生成工具。
– 倉庫附一份 30 秒、6 鏡、2 段的完整示例,展示交付結構。

Codex 用戶只要把倉庫克隆到 ~/.codex/skills/qisi-video-remix/ 即可載入;其他支持 SKILL.md 的 Agent 按各自技能目錄安裝。它不替你選單段上限,未確認時會先詢問;遇到無法定論的聲音、身份或轉折會標明,不補造證據。對做豎屏短劇、廣告分鏡、或者想用 AI 視頻模型快速試腳本的個人和小團隊來說,這套指令能省下不少從分鏡到提示詞的人肉翻譯工作。

GitHub

Categories: 開源, Agentic, 模型, Video, Audio, 提示詞, 工具, 庫, Skill 技能

TempCloze:揭開 Video-LLM 的時間盲區

TempCloze 是一個專門測試 Video-LLM 視覺時間推理能力的影片填空基準,從七個來源收集 1,521 條長鏡頭與第一人稱影片,挑戰模型能否在四選一中找回正確的「消失中段」。它直接揭示現有模型在時間對齊上的明顯短板。

Overview of the TempCloze benchmark

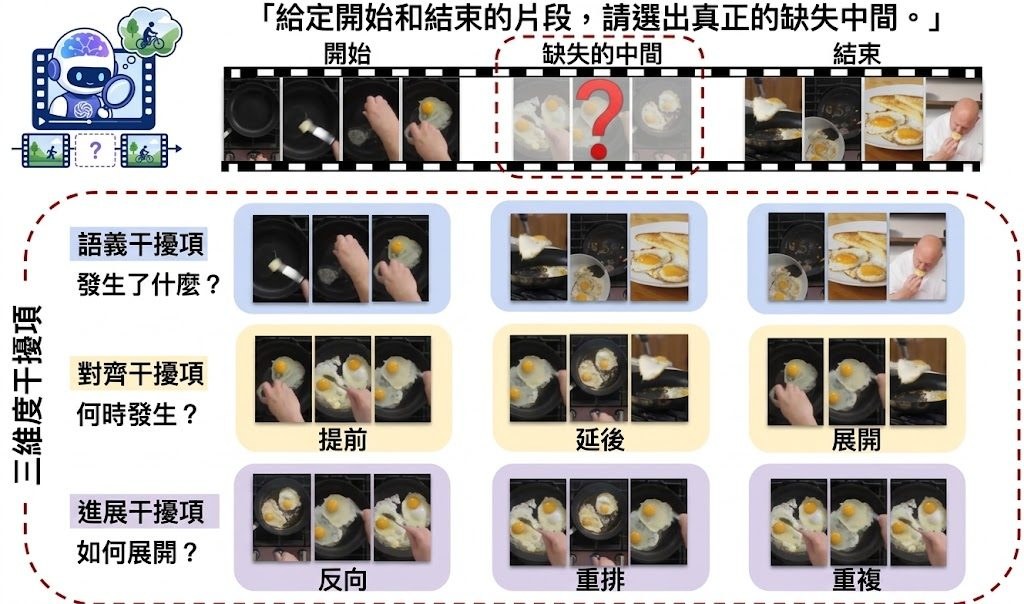
TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。

這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。

跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。

對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。

重點摘要:

  • 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
  • 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
  • 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
  • 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
  • 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距

GitHub

Categories: 開源, Agentic, 模型, 視覺模型, Video, 影像處理, 框架, 工具

騰訊混元開源 AuK:1.5B 模型統一語音生成與編輯

騰訊混元把零樣本 TTS、語音編輯、分離與增強收進同一個自然語言指令介面,並同步釋出追求速度的蒸餾版本 AuK-Flash。

AuK performance across speech generation, editing, enhancement, and separation benchmarks

語音模型一直存在一個尷尬:零樣本合成、語音克隆、音色替換、分離、降噪往往是幾套獨立系統,要串起來就得堆 pipeline。騰訊 Hunyuan 開源的 AuK 想打破這個分工,以 1.5B 參數的基礎模型為核心,讓一句自然語言指令直接對應到編輯後或生成的音訊。

AuK 由三部分組成:負責語義條件的多模態語言模型、提供聲學潛在空間的 50 Hz VAE,以及一個混合 rectified-flow Transformer,用雙流 MMDiT 塊融合兩種條件後再做單流 DiT 生成。訓練數據規模相當可觀——約 30.3 億條指令-音訊配對,加上約 195 萬小時的有效監督,覆蓋五大任務族:語音生成、內容編輯、增強與分離、副語言資訊編輯、聲學編輯。

同步釋出的 AuK-Flash 走速度路線:透過一致性初始化加上任務路由的 Decoupled DMD 蒸餾,做到 NFE=4、無 CFG 的 4 步推論,官方指在匹配條件下對比完整 AuK 有約 4.5 倍 wall-clock 加速,質量接近教師模型。這個分層策略對需要即時語音生成的應用場景(如對話 agent、實時配音)有直接意義。

部署層面,官方同時提供 Hugging Face Space、ModelScope Space、Gradio 互動介面、ComfyUI 節點、Python API,以及 uv 和 Conda 兩種依賴管理方式,並已獲 SGLang-Omni Day 0 支援。對於本地資源有限的團隊,AuK-Flash 配合 SGLang-Omni 是較合理的切入點;如果追求最高質量、且不在意推論延遲,則可選 AuK Base,並透過可配置的 NFE 與 CFG 做品質/速度取捨。

重點摘要:

  • 1.5B 統一模型:用自然語言指令統一零樣本 TTS、語音編輯、分離、增強、副語言與聲學編輯。
  • 三模組架構:多模態語言模型 + 50 Hz 音訊 VAE + 混合 rectified-flow Transformer,採雙流 MMDiT 接單流 DiT。
  • AuK-Flash 蒸餾:一致性初始化 + 任務路由 DMD,4 步推論無需 CFG,wall-clock 加速約 4.5 倍。
  • 後訓練策略:語音生成用獎勵強化學習,開放式編輯用人類偏好優化。
  • 部署支援完整:Hugging Face、ModelScope、Gradio、ComfyUI、Python API、SGLang-Omni 齊備。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, 文字轉語音, ComfyUI, Agentic, 模型, 多模態模型, 模型訓練, API, Audio, Python, 語音

Page 4 of 35
1 2 3 4 5 6 … 35