Arete-27B:後訓練調整政治敏感議題

模型怎樣回答政治問題,也可以透過訓練改變。Nous Research 嘗試強化西方價值觀,但未證明偏差已消除。

Og image

Nous Research (Hermes Agent 開發團隊) 針對模型回答政治敏感問題時的拒答、迴避與敘事立場,推出 Arete-27B。這個模型以阿里巴巴的 Qwen3.8-27B 為基礎,透過後訓練強化團隊所稱的「西方價值觀」。

團隊表示,曾觀察到原模型以中國共產黨(Chinese Communist Party,CCP)的框架作答。其做法是調整模型權重中的行為,而非只在對話中加入提示詞;這代表改變價值取向,不等於令模型變得中立。

  • 以 803 條提示詞、七個價值類別量度變化。
  • 列出模型權重 Arete-27B。
  • 列出評測 Propaganda_Eval 與訓練數據 arete-data-pairs。

「中國開源模型的意識形態偏見層,其實非常薄,而且是在最後階段才被強行貼上去的(The bias layer is shallow. It is applied late, it is applied thin)。」

只要 5,000 萬 tokens 的精準數據,就能把原廠花大代價做的政治對齊剝離得一乾二淨。

這對整個開源世界來說是個極具象徵意義的信號:只要權重是開源的(Open-weight),價值觀的主導權就永遠在使用者手裡。
項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 提示詞, 框架, 中國, Dataset 數據集

Viggle Remake 讓 H3 換掉影片人物並保留原有動作

想換掉影片人物、服裝或場景,又不想重拍整段素材?Viggle Remake 可按文字指令重製影片,保留原有動作、鏡頭、節奏與配樂。

Og image

要把影片人物換成其他角色,或改變服裝、天氣和場景,Viggle Remake 可以逐個鏡頭處理整段影片,並保留原有動作、鏡頭運動、時間節奏及配樂。項目屬於 20B 參數的 Video-to-Video 模型,基於 MiniMaxAI/MiniMax-H3,採用 LoRA;亦提供 Viggle app,毋須自行設定 GPU 即可使用。

它不只替換人物,亦能新增或移除物件、調整光線與風格。操作方式有兩種:交由支援 MCP 的 agent 根據影片和一句指令,自動找出剪接點、處理關鍵影格、逐段渲染並檢查結果;或自行撰寫提示詞、繪製一至四張影格,再用 sample.py 渲染鏡頭。前者適合整段影片的自動化製作,後者提供較直接的手動控制。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型規模:20B 參數,採用 LoRA。
  • 主要能力:人物重塑、服裝替換、物件增刪,以及場景、天氣、光線和風格變更。
  • 自動流程可處理多個鏡頭;示例包括 116 秒、69 個剪接點的影片,以及 101 秒影片。
  • 亦可透過 Viggle app 使用,毋須自行準備 GPU;自行執行則提供 sample.py 手動流程。
  • 頁面未列出 GGUF 檔名、量化級別、檔案大小、上下文長度、硬件需求或 llama.cpp、Ollama、LM Studio 支援資訊。

相較於只替換角色的 Viggle-Animate,Remake 擴展至物件增刪和環境變更,目標由角色動畫延伸至整段影片重製。示例展示多種改動及長片段處理能力,但項目文件沒有提供量化基準、硬件效能數據或不同量化版本,不能據此判斷本地執行所需資源或成品品質上限。

模型採用 MiniMax H3 Community License,使用前應先查看授權條款;示例亦註明,片中人物並未參與、批准或認可相關 AI 生成內容。這些限制對涉及真實人物、商業素材及公開發布的影片尤其重要。

模型

Categories: Agentic, AI productions, MCP, 模型, Video, 提示詞, Ollama, 動畫, MiniMax, LoRA

Terminal Mac:讓 AI Agent 操作虛擬 macOS 電腦

代理可在獨立的 macOS 桌面操作應用程式,不必移動實體 Mac 的滑鼠或改動剪貼簿。terminal-mac 把虛擬機畫面帶到終端機,並提供 MCP 工具供代理控制。

Repository image for govijr/terminal-mac

讓電腦操作代理在另一個 macOS 桌面開啟應用程式、輸入文字和檢查畫面,同時保留實體 Mac 的滑鼠與剪貼簿不受代理操作影響。terminal-mac 是為 Computer-use agents(CUAs)提供獨立 macOS 虛擬機的工具,透過終端機檢視畫面及下達操作。

它使用 Apple Virtualization 執行真正的 macOS guest,guest 有自己的應用程式、檔案、帳戶和權限,不會沿用主機已登入的工作階段。代理透過 MCP 工具截圖、點擊、拖曳、捲動、輸入文字及按鍵,並可依照「觀察、操作、確認」的流程檢查結果。

首次啟動會從 Apple 下載並快取相容的還原映像,也可使用既有的 .ipsw;之後會重用已建立的虛擬機。項目面向 Apple silicon、macOS 14 或更新版本,預設虛擬磁碟邏輯容量為 64 GiB,主機亦須預留還原映像和虛擬機所需的資源。Ghostty、Kitty 或 iTerm2 可顯示終端機內嵌畫面,其他終端機則可改用原生虛擬機視窗及代理命令列工具。

主機輸入與螢幕 API 不會用來執行代理操作;guest 內的 helper 會檢查硬件型號是否以 VirtualMac 開頭,避免操作意外落到主機。這項檢查不是硬件認證,也不能防範已遭入侵的主機。項目仍屬早期候選版本,乾淨 Mac 上的 guest 驗收尚未完成,發行版本亦未經 Apple 公證;tmux passthrough 和自動分割終端機目前不支援。

  • 適合需要隔離代理操作與個人桌面、帳戶及剪貼簿的測試工作。
  • Claude Code 可透過 MCP server 和 skill 接入代理工作流程。
  • 首次建立虛擬機需要網絡下載 macOS,或自行提供相容的還原映像。
  • 虛擬機會佔用主機 CPU、記憶體和儲存空間,預設磁碟邏輯容量為 64 GiB。

GitHub

Categories: 開源, Agentic, MCP, API, 工具, Mac, Anthropic, 蘋果, Skill 技能

Route Anything:按輸入選模型,兼顧品質與成本

面對文字、影像、影片、語音和機械人任務,Route Anything 研究路由器如何按輸入挑選候選模型或策略,並在品質容許範圍內減少成本。

Repository image for InfRec-Cardinal/route-anything

處理不同類型任務時,系統未必要每次都交給同一個模型或機械人策略。Route Anything 是一套研究實驗程式碼,探討路由器如何按輸入選擇候選方案,並在品質下降有限的前提下控制成本,涵蓋語言模型、影像、影片、語音生成器及機械人策略。

選擇與固定候選方案:在 24 個基準、19,814 個測試輸入上,理想路由得分為 87.98,固定方案為 82.60;但這個差距代表潛在上限,不等於訓練出的路由器已能達成同等收益。實際訓練的能力樹路由器在 16 個基準上只高 0.3 分,影片生成則高 2.1 分。

成本實驗顯示,四個測試環境平均效率提升 8.82 倍,品質損失低於 0.5 分;程式碼任務提升 25.5 倍,文字問答提升 7.1 倍。機械人測試中,結果路由器提升 1.1 分並減少 24% 策略執行時間;以勝出標籤預測結果的成功率為 42.8%,結果回歸則為 71.55%,反映訓練目標會左右路由效果。

  • 路由依據是路由器可觀察的輸入資訊,並按預期價值扣除成本選擇候選方案。
  • 參考策略與品質容忍度用來設定成本價格,適合比較省成本幅度與品質底線。
  • 程式碼提供路由實作、離線重播及品質底線認證工具,可按實驗指南重現部分測試。

研究團隊或需要在多種模型、生成器與機械人策略間分配任務的工程團隊,可用這套工具檢驗路由是否值得加入工作流程。限制是全模態實驗所用的軌跡矩陣並未公開,因此相關結果未必能完整重現;公開的程式碼與文字測試資料目前只支援部分實驗。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, Video, Image, 工具, 語音

WebHarbor:把真實網站變成可重現的 GUI Agent 測試場

WebHarbor 將 153 個網站還原成可重複使用的本地環境,讓 GUI web agents 能測試登入、購物及資料操作。

Repository image for aiming-lab/WebHarbor

要測試 GUI web agents 是否真的懂得操作網站,單靠會變動的公開網頁往往難以重現結果。WebHarbor 把 153 個流行網站製成 Docker 化本地鏡像,連同完整登入流程、資料庫和多模態圖片內容,屬於面向訓練與評估的環境及資料集項目。

它處理的不只是點擊連結,3,518 個 tasks 涵蓋購物車、結帳、帳戶操作等較深層流程;資料庫可在不到一秒內重設,適合反覆進行強化學習 rollout。沒有網絡噪音、內容漂移或地區封鎖,測試結果較容易比較,但建立鏡像和維護網站功能亦帶來不小工程成本。

• 153 個可執行的 Docker 網站環境
• 3,518 個評估及訓練 tasks
• 支援登入、資料庫和圖片內容
• 環境可按 agents 能力增加難度
• WebHarbor-4B 在 WebVoyager 及 Online-Mind2Web 平均取得 75.8 分

WebHarbor-4B 是建基於這些合成環境和 tasks 訓練的 GUI web agent,並非與環境分開提供的獨立示範模型。項目聲稱它在 4B 規模開源 GUI web agent 中取得最佳成績,但這個比較仍取決於所選基準和評測設定,不能直接代表所有真實網站任務。

研究 GUI agents、建立強化學習流程,或需要可重現瀏覽器測試的團隊較容易受益。使用者可從 Docker 鏡像、Hugging Face 環境及 tasks 開始組建測試流程;項目文件未列出完整硬件需求及每個網站鏡像的維護策略,正式採用前仍要核對資源成本和環境覆蓋範圍。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 模型訓練, Image, 庫, Dataset 數據集, 強化學習

Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

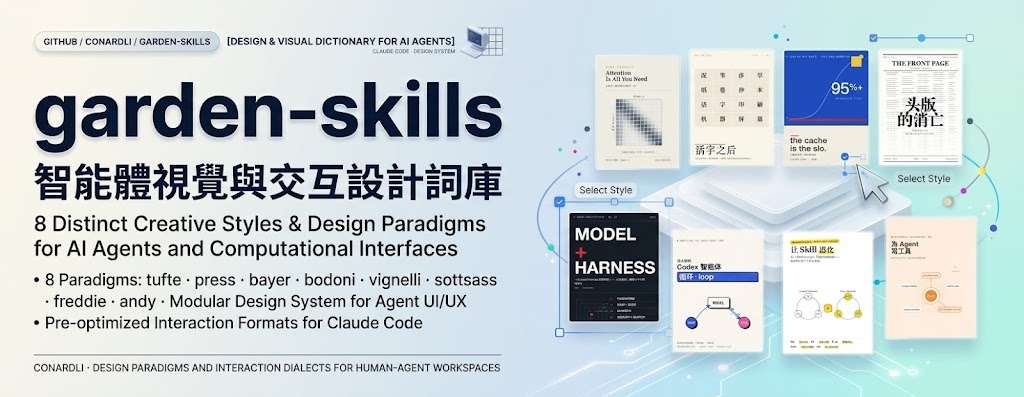
Garden Skills:讓 AI coding agents 承接影片、設計與寫作流程

從程式生成短片、網頁設計到整理知識庫,Garden Skills 把多種工作流程包成可供 AI coding agents 使用的技能。創作型工作尤其著重分階段確認與一致的輸出控制。

Motion Showreel Skill

想用 AI coding agent 製作短片、網頁簡報或整理本地知識庫,Garden Skills 提供一組可加入工作流程的 Agent Skills,適用於 Claude Code、Cursor、Codex 等工具。它不是單一模型,而是涵蓋影片製作、前端設計、影像提示、文章生成與知識檢索的技能集合;各技能如何安裝可按 項目文件提供的方式處理,但這份資料未列出完整操作步驟。

影片相關技能的重點,是把畫面與聲音放進同一條時間軸,並由同一個頁面產生不同階段的輸出,包括靜態畫面、聯絡表、預覽代理檔及成品。創作者可以選擇多種視覺風格,調整動態、鏡頭語法和聲音方向;配樂可由內置合成器或 Tone.js 產生,也可以配合自備音軌及節拍、段落變化剪輯。

創作流程設有兩個確認點:先確認需求,再確認風格畫面;若未指定風格,會提供三個方向供選擇,之後才進入自主製作。長片支援分章製作,最長可達 20 分鐘;Gemini 或 MiniMax TTS 只會朗讀使用者提供的稿件,錄音則以實際時間戳記對齊,音樂與音效亦會為旁白讓位。這些安排適合需要反覆檢視視覺方向、又希望聲畫時間一致的內容團隊,但資料沒有提供效能測試或品質評分,成品仍需自行檢查。

其他技能分別處理網頁影片簡報、前端設計、GPT Image 2 提示與影像生成、美化文章,以及本地知識檢索。對需要把重複創作步驟交由 AI coding agent 執行的設計師、影片製作者及內容團隊,這種技能集合比只提供單一功能的工具涵蓋更廣;取捨是各項工作的品質和適用程度,仍取決於所選技能、模型與輸入內容。

【经验开源】AI 做动画视频完全指南:原理、技巧、Skill 一次给全
  • 六種技能涵蓋影片、網頁、影像、文章及本地知識檢索。
  • 影片輸出由同一頁面生成,畫面與聲音共用時間軸。
  • 風格確認後才開始自主製作,未指定時可先比較三個方向。
  • 長片支援分章製作至 20 分鐘,旁白須使用者提供稿件。
  • 項目文件列出多種安裝途徑,但目前提供的資料未包含完整安裝流程或評測結果。

GitHub

Categories: 開源, Agentic, AI productions, Gemini, Video, Image, Audio, Vibe Coding, Content Creator, IDE, 庫, 編程, 音樂, MiniMax, Skill 技能

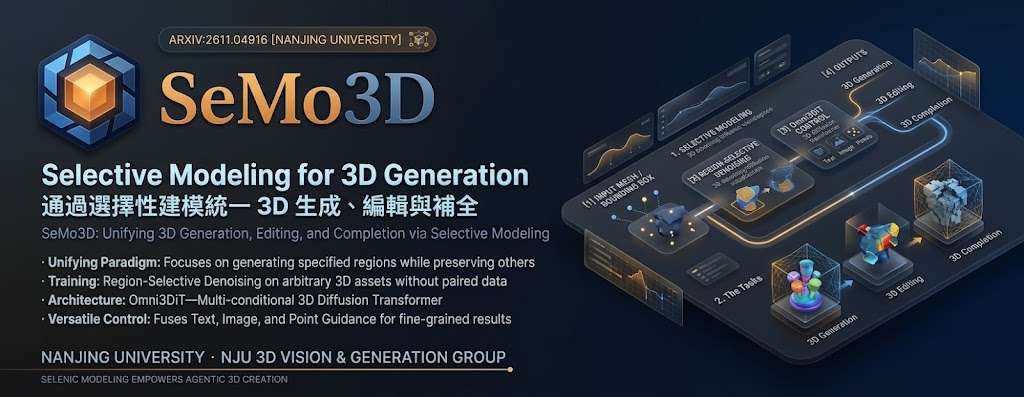
SeMo3D:只重建指定區域,統一 3D 生成、編輯

修改 3D 模型時,保留不需要改動的部分,可以減少整件資產重新生成造成的不一致。SeMo3D 將生成、編輯和補全整合到同一套選擇性建模流程,並支援文字、圖像與點雲引導。

SeMo3D logo

修改模型的局部區域時,整件資產重新生成可能令原本不需更動的內容也走樣。SeMo3D 是一個 3D 生成與編輯模型項目,透過只合成指定區域、保留其餘部分,統一處理生成、編輯和缺失區域補全,適合需要維持模型其他部分一致的創作者及 3D 工作流程團隊。

它把三種任務視為同一個問題:選出要建立或修改的區域,並沿用其餘內容。生成時選取完整區域,編輯時選取目標區域,補全時則選取缺失區域;因此,模型不必為每項任務各自重新生成整件資產。訓練亦毋須成對的編輯或補全資料,研究團隊可從一般 3D 資源切分出選取區域與周邊內容來訓練。

訓練方法稱為 region-selective denoising,只在隨機選取、大小各異的區域加上雜訊並計算損失,讓同一模型共同學習三項任務。架構 Omni3DiT 是多條件 3D diffusion transformer,負責分辨需要建立與保留的區域,並融合圖像、文字和點雲引導,提供較細緻的控制。

SeMo3D 在三個基準測試中,於生成、編輯和補全各項任務均勝過當時的先進方法;生成支援多模態控制,編輯與補全則著重一致性及準確度。

  • 一套模型統一 3D 生成、編輯與補全。
  • 只合成指定區域,保留其餘內容。
  • 以 region-selective denoising 從一般 3D 資源訓練,毋須成對編輯或補全資料。
  • Omni3DiT 融合圖像、文字與點雲引導。
  • 支援以自然語言互動的 agentic 3D 建模。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, Image, Content Creator, 3D

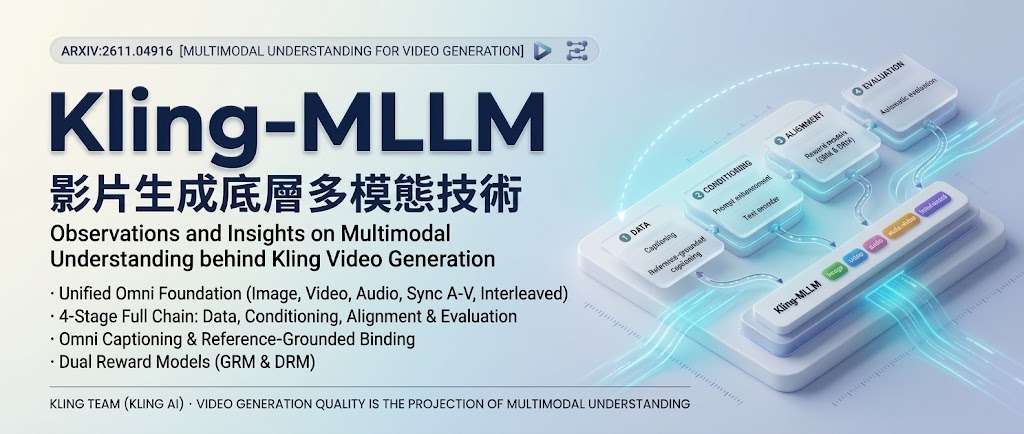
[技術文章] 影片生成的背後故事:Kling 的多模態理解觀察與見解

影片生成的瓶頸正由畫面渲染轉向語意控制。Kling 團隊拆解資料、提示、對齊與評估環節,說明如何令生成結果更貼合使用者意圖。

Hero image preview

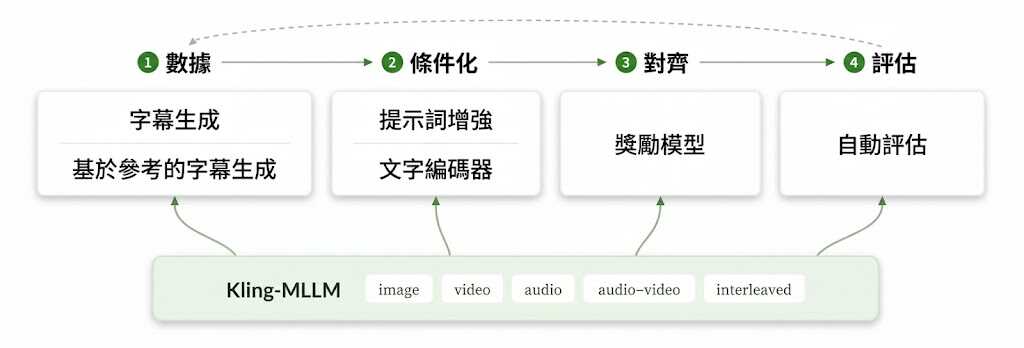
當影片生成要跟從複雜描述、維持人物與物件一致,單靠提升畫面品質並不足夠。Kling 團隊的技術報告聚焦多模態理解,分析資料、條件輸入、對齊和評估如何共同影響生成結果,適合關注可控影片生成的研究者與產品團隊參考。

研究以 Kling-MLLM 為共用基礎模型,處理圖片、影片、音訊、同步影音及交錯輸入,再按不同下游任務作專門調整。團隊指出,DiT 的訓練樣本遠少於語言模型,因此字幕不能只求流暢,而要作為高密度的語意契約;延伸出的 reference-grounded captioning,亦會明確標示描述與參考內容的對應關係。

提示詞增強負責把使用者意圖轉成生成模型較能處理的描述分佈。基本方法由優質影片字幕整理而成,再配合文字層面的強化學習及生成器迴圈微調;agentic prompt enhancement 則會進一步整理故事,並檢索具參考價值的例子。報告亦指出,可靠的 text encoder 需要感知訓練,單純提升語言能力並不足夠。

報告涵蓋的技術重點包括:
– 以共享多模態模型支援不同輸入形式及下游模組。
– 用高密度字幕和明確參考綁定,補足訓練語意與素材之間的連結。
– 以可解釋、能定位問題的通用 reward model,配合快速多維評分的 decision reward model。
– 設計任務專用自動評估,揭露評分捷徑,並協助追查上游失誤。

這套思路適合用於影片生成系統的資料整理、提示處理、模型對齊和品質診斷;團隊也強調,感知能力、描述品質與評估協定需要一併設計。內容屬於 Kling 團隊對其多代系統經驗的整理;提供的資料亦未列出可供外部讀者直接重現的完整流程。

Paper

Categories: Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, Video, Image, Audio, 提示詞, 強化學習

vibe-knowledge:把知識點做成可查證短片

vibe-knowledge 將查證、旁白、逐幀渲染和質檢串成一套對話式短片製作流程,亦把生成成本攤開給你核准。

风格快闪片

把一個知識點變成有旁白、逐句附來源的 1080p60 短片,vibe-knowledge 以 Claude Code skill 串起選題、查證、寫稿、配音、程式渲染、OCR 質檢和發布包;它屬於 AI 內容製作工作流項目,處理的是知識內容由文字走到可觀看影片時的流程分散問題。

vibe-knowledge 需與 ai-teardown 一併安裝,後者提供 cine 渲染引擎、工作區及配音腳本。渲染環境需要 Python、NumPy、SciPy、Pillow、Playwright、Chromium headless shell 和 ffmpeg;macOS 的 OCR 質檢則依賴 Vision 及 swiftc。

每次提交生成前,流程會列出鏡頭、模型、提示詞和 estimate cost,等使用者在對話中明確同意才繼續。基礎檔可用 0 積分完成程式插畫版;增強檔加入 Renoise 生成的配圖與 Wan 動態鏡頭,示例《商鞅立木》使用 246 積分,常見檔次約為 25–40、250–300 及 600–700 積分。

  • Claude Opus 負責編排,畫面由程式逐幀渲染
  • 早期提供古風、星空、像素、字幕新聞等多套風格
  • 基礎檔與增強檔可保留同一旁白及腳本作比較
  • Release v1.0.0 已提供多段樣片,但未有獨立準確率或品質基準

適合需要持續製作歷史、科普或解釋型短片的內容團隊,尤其重視來源標註、成本審批和可重複流程的工作情境。Renoise 增強檔能擴充視覺效果,代價是積分及外部模型依賴增加;片中亦會標示「AI 示意」,不能當作史實畫面或紀錄片素材直接使用。

GitHub

Categories: 開源, AI productions, 模型, Video, 提示詞, Mac, Python, 新聞, Anthropic, Skill 技能

Page 3 of 47
1 2 3 4 5 … 47